垃圾分类是生态文明建设的基础民生工程,也是全民践行绿色低碳生活的核心举措。但在日常落地过程中,大众分类认知不足、人工分拣效率低、精准度差、监管成本高等问题始终难以根治。随着人工智能计算机视觉技术的飞速发展,基于 AI 的智能垃圾分类识别技术,为传统垃圾分类痛点提供了高效、自动化、智能化的解决方案。
今天这篇文章,将带大家从零拆解 AI 垃圾分类识别技术全流程——从项目背景价值、AI 技术开发逻辑、核心数据集选型、模型训练方案,到前端 HTML5 应用搭建、多场景落地用途,全方位讲解可落地、可复用、可学习的智能垃圾分类系统搭建方案。无论你是新手学习、科研实验还是小型生产落地,都能直接参考复用。
项目背景与现实意义
背景
近年来,国内垃圾分类政策全面常态化推进,城市生活垃圾强制分类覆盖全国绝大多数省市。生活垃圾总量逐年递增,垃圾成分愈发复杂,塑料、金属、玻璃、厨余、有害垃圾等品类混杂投放现象普遍存在。
普通大众对细分垃圾品类认知模糊,易混淆相似垃圾,错投、混投问题频发。依托计算机视觉、深度学习技术的 AI 智能垃圾分类识别系统应运而生,成为垃圾分类智能化升级的核心突破口。
意义
AI 智能分类技术能够有效提升垃圾分类准确率,减少可回收资源浪费、有害垃圾污染,助力生活垃圾闭环处理,推动城市生态环境治理精细化、智能化升级,践行绿色低碳发展理念。可视化的 AI 识别应用,以"拍照识别、即时反馈"的互动形式,让大众直观学习垃圾分类知识,沉浸式提升全民分类意识与分类能力。
整体技术架构
本项目构建"目标检测 + 精准分类 + 前端部署"的完整工程化体系,解决复杂场景下多垃圾混杂、漏识别、误分类的行业痛点。
整体技术链路分为四大核心模块,层层递进、闭环落地:
数据层:针对垃圾检测、垃圾分类任务分别选取高质量数据集,为模型训练提供支撑。
模型层:采用 YOLO11 模型完成垃圾目标检测,精准定位画面中的所有垃圾目标;再通过 ResNet50 模型对检测出的单体垃圾进行精细化品类分类,实现"定位 + 细分"双能力。
推理层:搭建双模型联动推理逻辑,先执行检测任务截取垃圾有效区域,再输入分类模型完成品类判定,规避背景干扰、多目标干扰问题,提升识别精准度。
应用层:基于 HTML5 技术搭建轻量化网页应用,无需安装客户端,支持浏览器实时拍照、上传图片识别,实现跨设备、跨终端便捷使用。
数据集
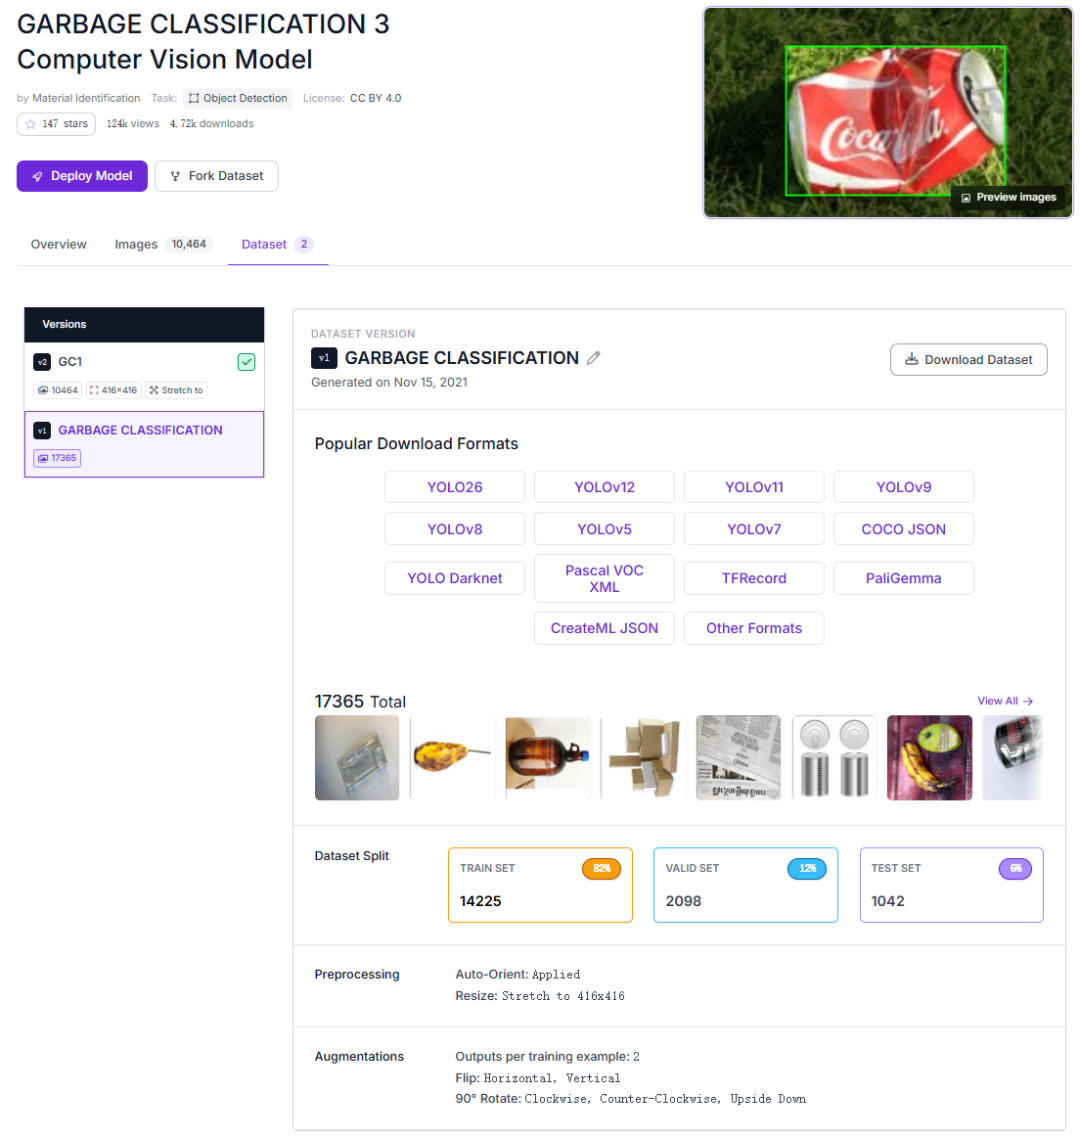
垃圾检测数据集:garbage-classification-3
garbage-classification-3 数据集来自 Roboflow Universe 平台,专门针对智能垃圾分类场景构建,涵盖厨余/湿垃圾、硬纸板、玻璃、金属、纸张、塑料 6 大类生活垃圾的检测识别。该数据集包含各类垃圾物品在不同角度、不同光照、不同背景下的图像,具有较强的实际应用价值。数据集包含 14225 张训练图像、2098 张验证图像、1042 张测试图像。适配 YOLO 系列模型训练的标准数据格式,支持 YOLO、COCO、VOC 等主流格式导出,兼容性极强。采用 CC BY 4.0 许可协议。
垃圾分类数据集:garbage265
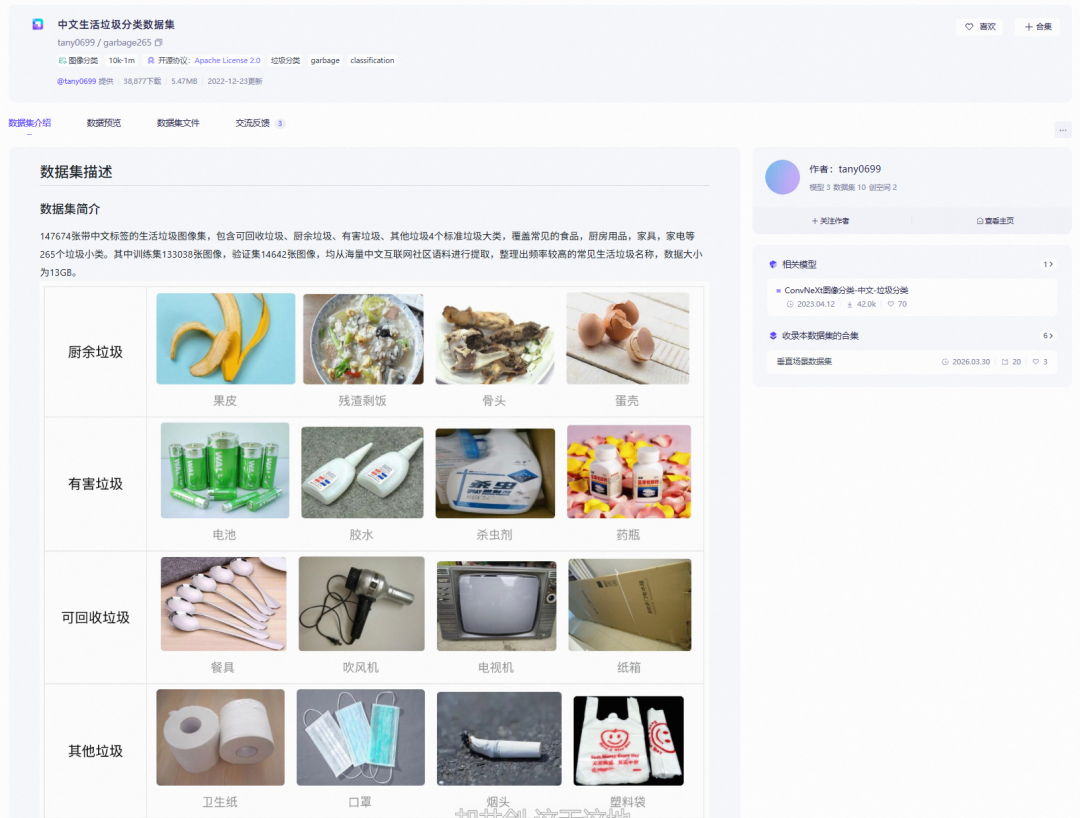
garbage265 是国内开源的精细化垃圾分类专用数据集,主打海量细分垃圾品类,是目前民用垃圾分类领域品类最全、样本量最大、适配性最高的数据集之一,专门用于垃圾精细化分类模型训练。
该数据集总计包含 147674 张生活垃圾图像,数据集总容量约 13GB,严格按照训练集、验证集科学划分,其中训练集 133038 张图像、验证集 14642 张图像,数据量充足。
数据集严格遵循国内官方垃圾分类标准,涵盖可回收垃圾、厨余垃圾、有害垃圾、其他垃圾四大核心大类,向下细分 265 个生活垃圾小类,覆盖食品残渣、厨房用具、塑料制品、金属制品、玻璃制品、家电小件、废旧纸张、有害化学品等日常生活中所有常见垃圾品类。
模型:YOLO11 垃圾检测 + ResNet50 垃圾分类
垃圾检测:YOLO11
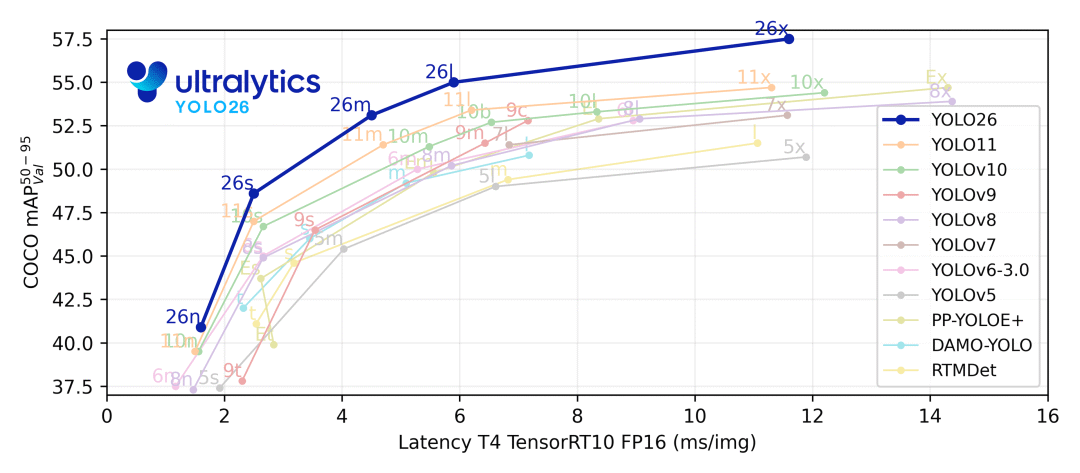
YOLO11 是 Ultralytics 团队在 2024 年 9 月发布的新一代 YOLO 实时多任务视觉模型,是 YOLOv8 的迭代升级版本,延续 YOLO 系列单阶段、端到端、兼顾速度与精度的设计,同时大幅优化网络模块,小目标检测、参数量、推理效率全面提升。
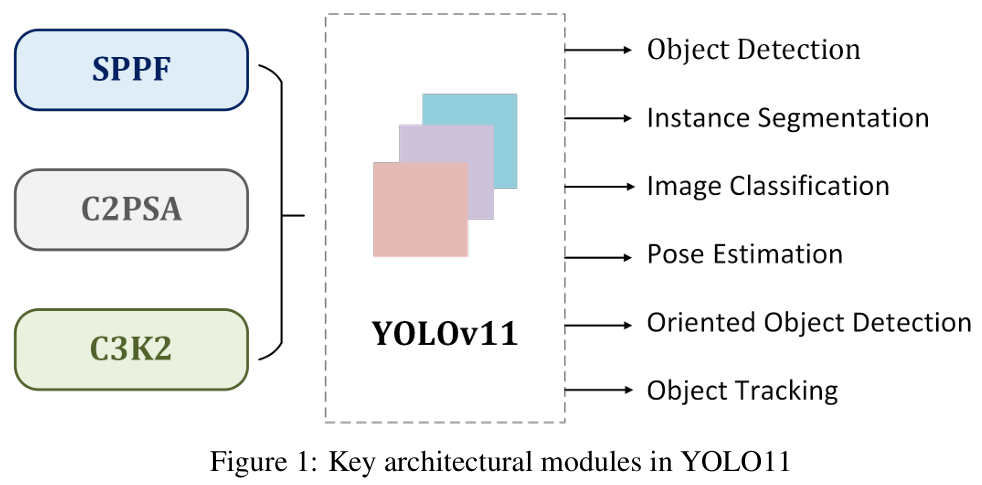
整体依然是 Backbone(骨干)+ Neck(颈部特征融合)+ Head(检测头)三段式结构,无锚框(Anchor-Free)+ DFL 分布焦点损失检测头不变,主要改动三处:
- C3k2 模块替换 C2f:骨干与 Neck 中的 C2f 换成 C3k2 跨阶段模块,更轻量化,降低 FLOPs 和参数量,同时保留更强特征提取能力。
- 新增 C2PSA 空间注意力模块:在 SPPF 后加入 C2PSA(CSP Parallel Spatial Attention)并行空间注意力,显著提升小目标、遮挡目标的检测效果,只增加少量计算开销。
- 检测头轻量化:分类分支改用深度可分离卷积,进一步减少参数量。
YOLO11 的主要特性包括:
- 增强的特征提取:采用改进的骨干网络和颈部架构,增强了特征提取能力,从而实现更精准的目标检测和更复杂的任务处理。
- 针对效率和速度进行优化:引入了经过改进的架构设计和优化的训练流水线,在保持准确率与性能最佳平衡的同时,提供更快的处理速度。
- 更少的参数带来更高的准确率:借助模型设计方面的改进,YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),同时比 YOLOv8m 少使用 22% 的参数,在不牺牲准确率的情况下提高了计算效率。
- 适用于多种环境:YOLO11 可以无缝部署到各种环境中,包括边缘设备、云平台以及支持 NVIDIA GPU 的系统,确保最大的灵活性。
- 支持广泛的任务:无论是目标检测、实例分割、图像分类、姿态估计还是定向目标检测(OBB),YOLO11 都旨在应对多样化的计算机视觉挑战。
YOLO11 训练过程:
- 数据预处理:首先完成数据集格式校验,统一转换为 YOLO 标准训练格式,核对标注框精度,剔除模糊、无标注、错误标注样本。同时开启离线数据增强,通过随机翻转、缩放、平移、亮度对比度调整、高斯模糊等方式扩充样本,提升模型抗干扰能力。按照官方划分比例固定训练集、验证集、测试集,保证数据分布均匀。
- 模型参数配置:选用初始化模型 YOLO11n/YOLO11s/YOLO11m/YOLO11l/YOLO11x,设置迭代轮次、批次大小、学习率等核心参数,采用自适应学习率衰减策略,避免训练后期梯度爆炸。
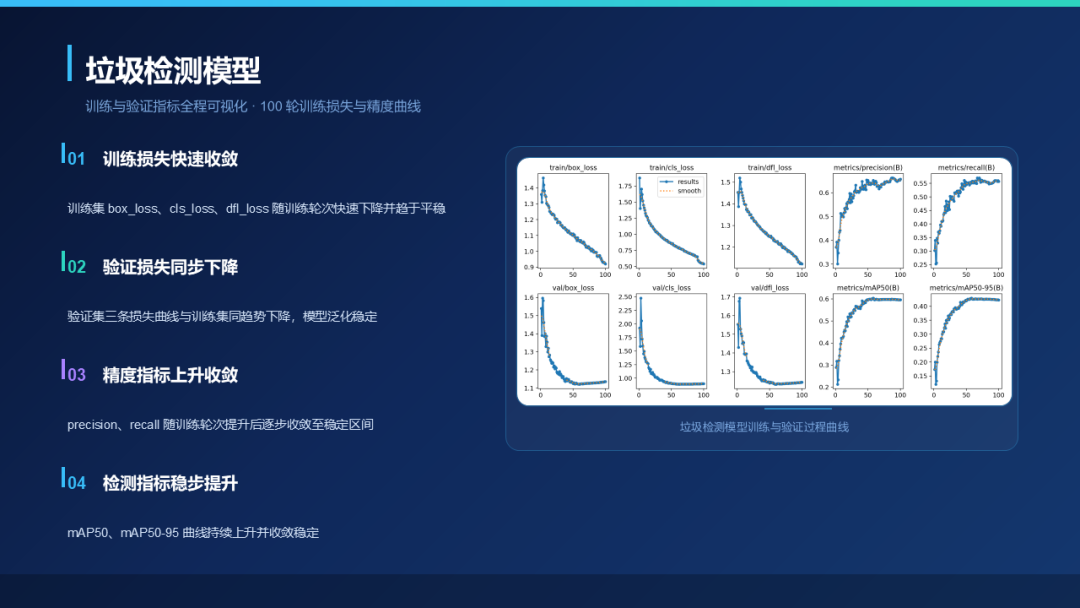
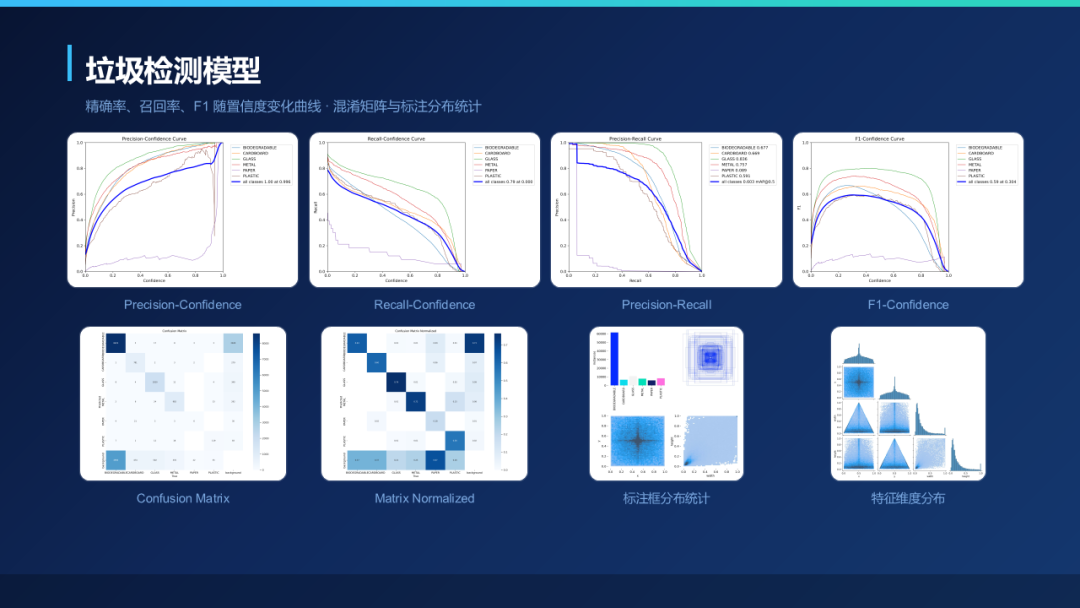
- 训练与迭代调优:基于预处理后的数据集完成模型训练,全程监控精确率、召回率、mAP 值等核心指标。针对垃圾小目标漏检、堆叠目标误检等问题,通过调整锚框尺寸、优化损失函数、微调超参数完成迭代优化,最终得到高精度、高泛化性的模型。
垃圾分类:ResNet50
ResNet 由微软研究院的 Kaiming He 等四名华人研究员在 2015 年提出,拿下 ILSVRC 2015 图像分类任务冠军,是深度学习计算机视觉里程碑式的网络,几乎所有后续 CV 模型(检测、分割、识别)都会用到残差思想。
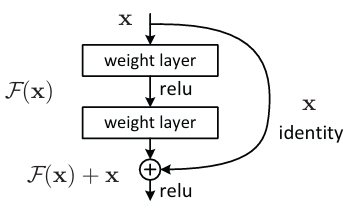
在 ResNet 之前,大家普遍认为网络越深效果越好,但实际训练中遇到了一个难题:网络层数增加后,训练集准确率反而下降,深层网络很难学习到恒等映射(输入 = 输出),梯度在多层反向传播时不断衰减,出现梯度消失。ResNet 的核心创新是残差跳跃连接(Shortcut Connection),解决了深度 CNN 训练时的梯度消失、网络退化问题。
ResNet 模型核心特色包括:
- 残差跳跃连接,支持深层网络训练:解决深层 CNN 退化问题,网络可以稳定训练。
- Bottleneck 瓶颈结构:压缩通道减少计算开销,平衡分类精度与计算量,便于模型轻量化后在网页端推理。
- 迁移学习能力极强:基于 ImageNet 百万图像预训练权重,只需要微调最后几层,在少样本数据集上快速收敛,大幅降低训练成本。
- 通用性强:是 CV 领域经典基准模型,可方便做模型剪枝、量化。
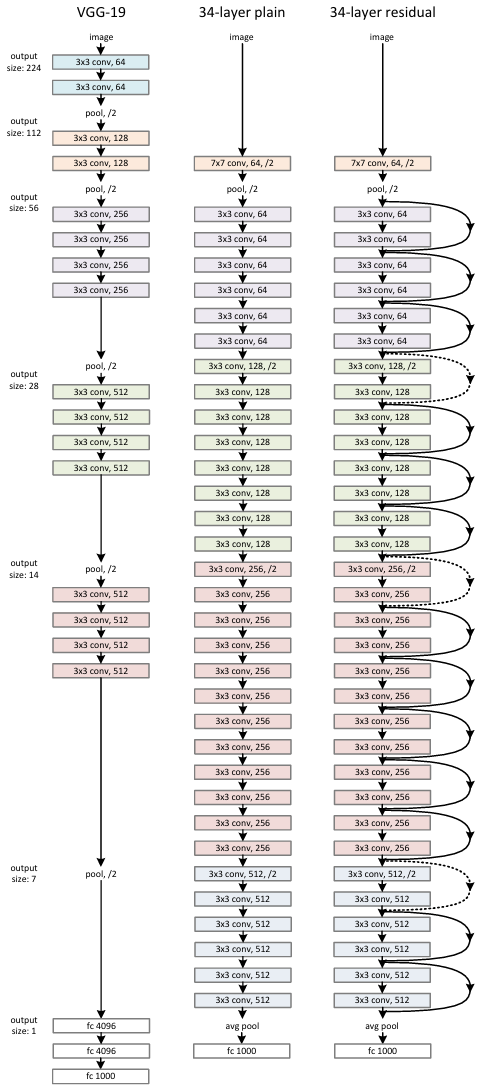
ResNet50 训练过程:
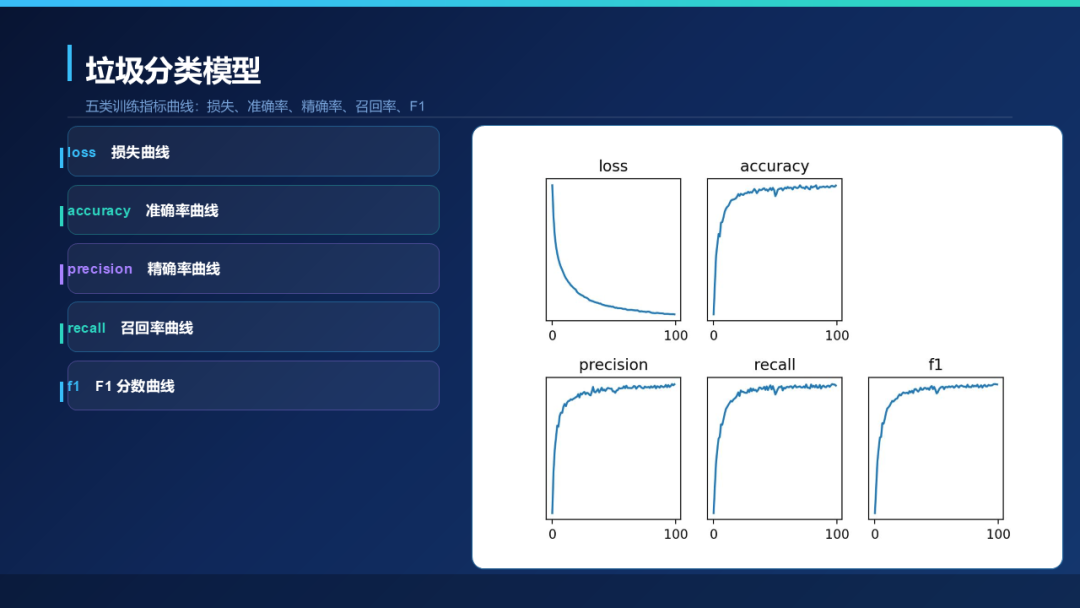
- 数据预处理与标准化:对 garbage265 数据集进行标准化处理,统一图像分辨率、归一化像素值,过滤模糊、破损、无效样本。同时采用随机裁剪、翻转、色域变换等数据增强方式,提升样本多样性,增强模型泛化能力。
- 迁移学习训练配置:加载 ImageNet 预训练 ResNet50 权重,基于预训练模型进行迁移学习,无需从零训练,大幅提升训练效率与模型精度。调整模型全连接层,适配 265 类垃圾分类输出,设置合理的批次大小、学习率与迭代次数,采用交叉熵损失函数适配多分类任务。
- 模型迭代优化:训练过程中持续监控训练集、验证集准确率与损失值。通过正则化、dropout 机制抑制过拟合,反复迭代调优,最终得到高精准度的精细化垃圾分类模型。
完整工作流程
基于 YOLO11 检测 + ResNet50 分类的双模型级联架构,解决单一分类模型无法处理多垃圾混杂、背景干扰强、目标堆叠的痛点,大幅提升复杂场景下的识别准确率。具体分为四大步骤:
第一步:图像输入与预处理
对原始输入图片完成图像压缩、尺寸标准化、像素归一化处理,为后续推理做好准备。
第二步:YOLO11 全局垃圾目标检测
将预处理后的完整图像输入 YOLO11 检测模型,模型自动遍历整张图像,识别所有存在的垃圾目标,输出每个垃圾的坐标检测框、置信度评分,过滤置信度低于阈值的无效目标,精准定位画面中所有垃圾单体,剔除空白背景、杂物干扰区域。
第三步:区域截取与单体图像提取
系统根据 YOLO11 输出的检测框坐标,自动裁剪原图,单独提取每一个垃圾单体的局部图像,生成无背景干扰、单一目标的垃圾图像。这一步的核心作用是规避多垃圾互相干扰、背景复杂导致的分类误差,为精细化分类提供纯净输入。
第四步:ResNet50 精细化分类与结果输出
将提取的单体垃圾图像逐一输入 ResNet50 分类模型,模型通过深层特征提取,判定垃圾的 265 类细分品类,同时输出分类置信度、分类说明。
双模型架构优势
单一分类模型直接识别整张图片,极易受背景、多目标干扰,错判、漏判率极高;而先检测后分类的联动模式,先定位、再细分,层层过滤干扰,实用性大幅增强。
应用:基于 Flask + HTML5 搭建轻量化前端应用
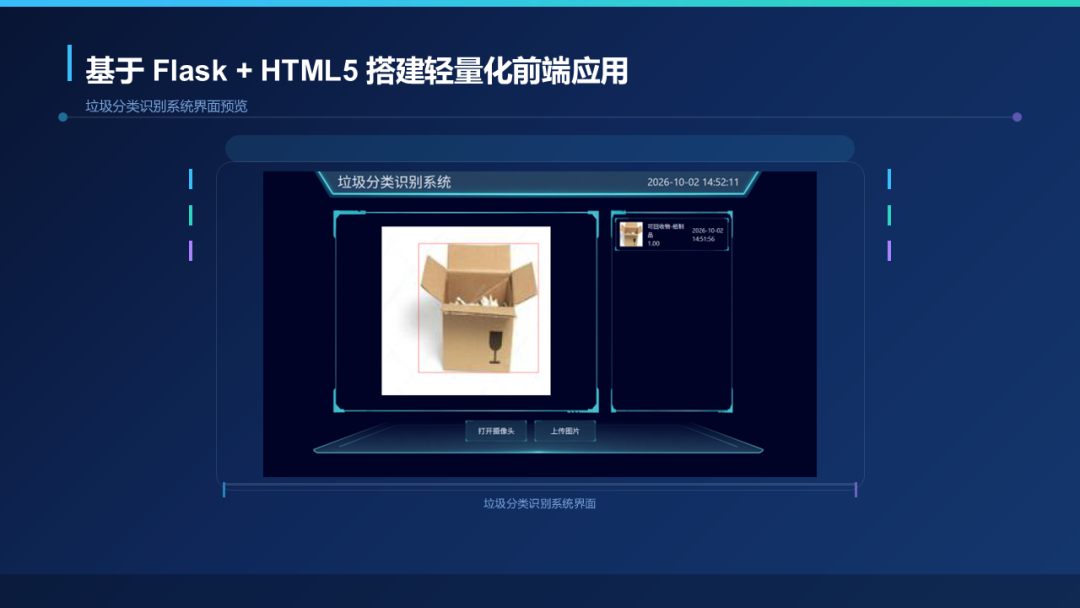
本项目采用 Flask + HTML5 的 BS 架构搭建前端交互应用,适配电脑、手机、平板全终端,无需下载安装,浏览器直接打开即可使用。
HTML5 开发核心优势
- 跨终端适配:HTML5 具备极强的跨平台特性,适配 Windows、安卓、iOS 等所有系统,兼容各类浏览器,实现多设备无缝使用;
- 轻量化免安装:无需部署客户端、无需配置复杂环境,云端部署后即可全网访问,降低使用门槛,适配大众用户;
- 原生多媒体支持:自带拍照、图片上传、图像预览功能,无需额外插件,完美匹配垃圾分类图像识别的核心交互需求;
- 低延迟交互:前端轻量化渲染,模型推理结果快速回显,操作流畅无卡顿,用户体验极佳;
- 易迭代、易维护:代码结构清晰,后续可快速新增功能、优化界面、升级模型,适配长期使用需求。
前端应用核心功能模块
- 交互功能模块:支持实时摄像头拍照识别、本地图片上传识别两种核心模式,满足即时拍摄识别、旧图识别等不同使用场景,操作简单,一键触发识别。
- 可视化展示模块:识别完成后,页面实时展示原图、YOLO11 检测框效果图、分类结果详情,清晰标注每一个垃圾的品类、所属大类、置信度。
- 数据记录模块:自动记录识别历史、分类结果,支持用户查看过往识别记录,方便学习复盘与科研数据统计。
- 适配优化模块:页面自适应屏幕尺寸,手机端、电脑端自动适配布局,图像自动压缩优化,保证识别精度的同时提升加载速度。
前后端联动逻辑
前端 HTML5 页面负责用户交互、图像采集、结果展示,后端负责模型推理、数据处理。用户上传/拍摄图像后,前端将图像数据传输至后端,后端调用训练完成的 YOLO11+ResNet50 双模型完成推理,将分类结果、可视化图像回传至前端,完成交互闭环。整套流程响应速度快、稳定性强。
项目落地用途:学习、科研、生产
学习场景:零基础 AI 与垃圾分类科普学习
- 大众垃圾分类学习:普通用户可通过拍照识别日常垃圾,即时获取精准分类结果,快速纠正分类误区,沉浸式学习垃圾分类知识,解决日常投放困惑;
- 学生 AI 实战学习:计算机专业、人工智能专业学生可通过本项目完整学习数据集选型、模型训练、双模型联动、前端部署全流程,掌握计算机视觉实战开发技巧,积累 CV 项目实战经验;
- 校园科普教学:可作为中小学垃圾分类科普、AI 科创教学工具,直观展示人工智能落地应用,助力科创教育与环保教育融合。
科研场景:CV 算法研究与垃圾分类课题实验
- 模型对比实验:科研人员可基于本项目基准架构,替换不同数据集、不同检测/分类模型,对比算法精度、速度差异,开展轻量化 CV 算法研究;
- 细分场景研究:依托 garbage265 的 265 类细分品类,可开展精细化垃圾分类、相似物体识别、复杂场景目标检测等专项科研实验;
- 课题落地支撑:可作为垃圾分类智能化、计算机视觉轻量化部署、AI 环保应用等本科、研究生课题的核心落地项目,提供完整的实验数据与技术架构。
生产场景:商业化、工程化落地应用
- 民用垃圾分类辅助:部署于小区、校园、商超垃圾站,作为智能分类指引设备,辅助居民精准投放垃圾,降低物业督导成本;
- 工业分拣辅助:对接智能分拣设备,用于小型垃圾分拣车间,自动识别垃圾品类,辅助设备完成自动化分拣,提升分拣效率;
- 城市环卫监管:可接入城市环卫监管系统,实时监测公共区域垃圾投放情况,自动统计错投数据,为垃圾分类监管、政策优化提供数据支撑;
- 智能硬件适配:可移植至智能垃圾桶、环卫机器人、巡检机器人等硬件设备,实现硬件端实时垃圾分类识别,赋能智能环卫硬件升级。
核心代码
垃圾检测
from ultralytics import YOLO
from utils import data_utils

MODEL = None
ID_TO_LABEL = None

def init(model_path, label_path):
    global MODEL
    global ID_TO_LABEL
    _, ID_TO_LABEL = data_utils.load_label(label_path)
    MODEL = YOLO(model_path)

def detect(image):
    result = []
    model_resp = MODEL.predict(image, imgsz=640, save=False, verbose=False)
    for res in model_resp:
        for box in res.boxes:
            cls = box.cls.cpu().numpy()[0]
            xyxy = box.xyxy.cpu().numpy()[0]
            conf = box.conf.cpu().numpy()[0]
            result.append({
                "cls": int(cls),
                "name": ID_TO_LABEL[int(cls)],
                "left": int(xyxy[0]),
                "top": int(xyxy[1]),
                "width": int(xyxy[2] - xyxy[0]),
                "height": int(xyxy[3] - xyxy[1]),
                "conf": float(conf),
            })
    return result
垃圾分类
import torch
import torch.nn.functional as F
from utils import data_utils
from resnet.model import resnet

MODEL = None
ID_TO_LABEL = None

def init(base_model_path, model_path, resnet_size, label_path, use_cpu=False):
    global MODEL
    global ID_TO_LABEL
    _, ID_TO_LABEL = data_utils.load_label(label_path)
    MODEL = resnet(resnet_size, len(ID_TO_LABEL), base_model_path)
    MODEL.load_state_dict(torch.load(model_path))
    MODEL = MODEL.cpu() if use_cpu else MODEL.cuda()
    MODEL.eval()

def classify(image, image_size=224, use_cpu=False):
    image_inp = data_utils.get_inp([image], image_size, resize_type="")
    image_inp = image_inp.cpu() if use_cpu else image_inp.cuda()
    with torch.no_grad():
        logits = MODEL(image_inp)
        probs = F.softmax(logits, dim=1)
        preds = torch.argmax(probs, dim=1)
        probs = probs.cpu().detach().numpy()
        preds = preds.cpu().detach().numpy()
    pred = int(preds[0])
    prob = probs[0]
    result = {
        "cls": pred,
        "name": ID_TO_LABEL[pred],
        "conf": float(prob[pred])
    }
    return result
完整垃圾识别流程
import logging
from service import det_service, cla_service

THRESHOLD = 0.8

def init(
        det_model_path,
        det_label_path,
        cla_base_model_path,
        cla_model_path,
        cla_model_size,
        cla_label_path,
        use_cpu=False
):
    logging.info("初始化模型")
    det_service.init(
        model_path=det_model_path,
        label_path=det_label_path)
    cla_service.init(
        base_model_path=cla_base_model_path,
        model_path=cla_model_path,
        resnet_size=cla_model_size,
        label_path=cla_label_path,
        use_cpu=use_cpu)

def predict(image, use_cpu=False):
    result = []
    det_resp = det_service.detect(image)
    if len(det_resp) > 0:
        for box in det_resp:
            if box["conf"] < THRESHOLD:
                continue
            image_crop = image[box["top"]:box["top"] + box["height"], box["left"]:box["left"] + box["width"]]
            cla_resp = cla_service.classify(image_crop, use_cpu=use_cpu)
            if cla_resp["conf"] >= THRESHOLD:
                cla_resp["left"] = box["left"]
                cla_resp["top"] = box["top"]
                cla_resp["width"] = box["width"]
                cla_resp["height"] = box["height"]
                result.append(cla_resp)
    if len(result) == 0:
        height, width, _ = image.shape
        cla_resp = cla_service.classify(image, use_cpu=use_cpu)
        if cla_resp["conf"] >= THRESHOLD:
            cla_resp["left"] = 0
            cla_resp["top"] = 0
            cla_resp["width"] = width
            cla_resp["height"] = height
            result.append(cla_resp)
    return result
后端 Flask 代码
import io
import cv2
import json
import copy
import base64
import logging
import numpy as np
from PIL import Image
from datetime import datetime
from flask import Flask, request, render_template, jsonify
from service import pipline_service
from utils import image_utils

logging.basicConfig(
    format="%(asctime)s - %(levelname)s - %(name)s - %(message)s",
    datefmt="%m/%d/%Y %H:%M:%S",
    level=logging.INFO,
)

APP = Flask(__name__)
APP_LOG_PATH = "./app.log"
pipline_service.init(
    det_model_path="./assets/model/yolo/best.pt",
    det_label_path="./assets/model/yolo/classname.txt",
    cla_base_model_path="./assets/model/resnet/resnet50-19c8e357.pth",
    cla_model_path="./assets/model/resnet/best.pth",
    cla_model_size=50,
    cla_label_path="./assets/model/resnet/classname.txt",
    use_cpu=False)

@APP.route("/")
def index():
    return render_template("index.html")

@APP.route("/upload", methods=["POST"])
def upload():
    try:
        upload_file = request.files["upload"]
        file_type = upload_file.filename.split(".")[-1]
        image = Image.open(upload_file).convert("RGBA")
        image_inp = np.array(image)
        image_inp = cv2.cvtColor(image_inp, cv2.COLOR_RGB2BGR)
        result = pipline_service.predict(image_inp)
        now = datetime.now()
        width, height = image.size
        image_byte_arr = io.BytesIO()
        image.save(image_byte_arr, format="PNG")
        image_byte_arr = image_byte_arr.getvalue()
        encoded_str = base64.b64encode(image_byte_arr).decode()
        for item in result:
            crop = image_utils.crop_and_pad_transparent(
                image,
                (item["left"], item["top"], item["left"] + item["width"], item["top"] + item["height"]),
                int(max(item["width"], item["height"])),
                int(max(item["width"], item["height"]))
            )
            crop_byte_arr = io.BytesIO()
            crop.save(crop_byte_arr, format="PNG")
            crop_byte_arr = crop_byte_arr.getvalue()
            crop_encoded_str = base64.b64encode(crop_byte_arr).decode()
            item["image"] = crop_encoded_str
            item["time"] = now.timestamp()
        response = {
            "success": True,
            "status": 0,
            "reason": "",
            "url": "",
            "image": {
                "value": encoded_str,
                "type": file_type,
                'width': width,
                'height': height
            },
            "result": result
        }
        # 保存结果
        with open(APP_LOG_PATH, "a", encoding="utf-8") as fout:
            for item in result:
                item_record = copy.deepcopy(item)
                del item_record["image"]
                fout.write(json.dumps(item_record, ensure_ascii=False) + "\n")
    except Exception as e:
        logging.error(e)
        response = {"success": False, "status": 0, "reason": "服务异常,请联系管理员", "url": "", "result": ""}
    return jsonify(response)

if __name__ == "__main__":
    APP.run(
        host="0.0.0.0",
        port=443,
        ssl_context=("static/certs/certificate.crt", "static/certs/private.key"),
        debug=True
    )
前端 HTML 代码
<!DOCTYPE html>
<htmllang="en">
<head>
    <metacharset="UTF-8">
    <metaname="viewport"content="width=device-width, initial-scale=1.0">
    <title>垃圾分类识别系统</title>
    <linkrel="icon"href="/static/image/sys/favicon.ico"type="image/x-icon">
    <linkrel="stylesheet"href="{{ url_for('static', filename='css/bootstrap.min.css') }}">
    <linkrel="stylesheet"href="{{ url_for('static', filename='css/index.css') }}">
    <style>
        #camera-wraper {
            float: left;
            position: relative;
            padding: 9px 7px 0 7px;
            background-image: linear-gradient(rgba(0, 2, 38, 0.1), rgba(0, 2, 38, 0.1)), url("/static/image/sys/container-wraper.png");
            background-size: 100% 100%;
        }
        #camera {
            width: 640px;
            height: 480px;
        }
        .camera-canvas {
            position: absolute;
            top: 9px;
            left: 7px;
            width: 640px;
            height: 480px;
        }
        .info-list {
            width: 300px;
            height: 500px;
            margin-left: 30px;
            padding: 20px 10px;
            background-image: linear-gradient(rgba(0, 2, 38, 0.1), rgba(0, 2, 38, 0.1)), url("/static/image/sys/list-wraper.png");
            background-size: 100% 100%;
            overflow-y: auto;
            overflow-x: hidden;
        }
        .info-list .item {
            display: flex;
            width: 280px;
            height: 80px;
            margin-bottom: 15px;
            background-image: linear-gradient(rgba(0, 2, 38, 0.1), rgba(0, 2, 38, 0.1)), url("/static/image/sys/list-wraper.png");
            background-size: 100% 100%;
        }
        .info-list .item .thumb {
            width: 80px;
            height: 80px;
            padding: 10px;
        }
        .info-list .item .thumb img {
            width: 60px;
            height: 60px;
        }
        .info-list .item .label {
            flex: 1;
            display: flex;
            flex-direction: column;
            width: 100%;
            height: 80px;
            padding-right: 10px;
            color: #D6DDE3;
        }
        .info-list .item .label .name {
            height: 50px;
            padding-top: 10px;
            font-size: 14px;
            white-space: normal;
            word-break: break-all;
            overflow-wrap: break-word;
        }
        .info-list .item .label .prob {
            height: 40px;
            font-size: 16px;
        }
        .info-list .item .datetime {
            width: 90px;
            height: 80px;
            color: #D6DDE3;
            font-size: 15px;
        }
        .info-list .item .datetime .date {
            height: 40px;
            line-height: 60px;
        }
        .info-list .item .datetime .time {
            height: 40px;
        }
        .button-group {
            width: 100%;
            height: 80px;
            padding-left: 33%;
        }
        .button-group .button {
            float: left;
            width: 150px;
            height: 50px;
            border: none;
            margin: 0 10px;
            background-image: url("/static/image/sys/list-wraper.png");
            background-size: 100% 100%;
            background-color: rgba(30, 63, 91, 0.6);
            color: #D6DDE3;
            font-size: 18px;
            cursor: pointer;
            line-height: 50px;
            text-align: center;
        }
    </style>
</head>
<body>
<divclass="container">
    <divid="header">
        <divclass="name">垃圾分类识别系统</div>
        <divid="time"class="time">0000-00-00 00:00:00</div>
    </div>
    <divclass="row main">
        <divid="camera-wraper">
            <videoid="camera"autoplay></video>
            <canvasid="canvas"class="camera-canvas"></canvas>
            <canvasid="canvas-resp"class="camera-canvas"></canvas>
        </div>
        <divid="info-list"class="info-list">
        </div>
    </div>
    <divclass="hidden">
        <formid="form-upload"method="post"enctype="multipart/form-data">
            <inputtype="file"id="input-upload"name="upload"/>
        </form>
        <formid="form-service">
            <inputtype="hidden"id="input-value"name="value"/>
            <inputtype="hidden"id="input-type"name="type"/>
        </form>
    </div>
    <divid="footer">
        <divclass="button-group">
            <divclass="button"onclick="openCamera()">打开摄像头</div>
            <divclass="button"onclick="clickUpload()">上传图片</div>
        </div>
    </div>
</div>
<scriptsrc="{{ url_for('static', filename='js/jquery-3.5.1.min.js') }}"></script>
<scriptsrc="{{ url_for('static', filename='js/index.js') }}"></script>
<script>
    let cameraStream = null;
    let cameraOpen = false;
    async function startCamera() {
        try {
            cameraStream = await navigator.mediaDevices.getUserMedia({
                video: true
            });
            document.getElementById("camera").srcObject = cameraStream;
            cameraOpen = true;
        } catch (err) {
            console.log("打开摄像头失败:" + err.message);
        }
    }
    function stopCamera() {
        if (!cameraStream) {
            return;
        }
        try {
            cameraStream.getTracks().forEach(track => track.stop());
            document.querySelector("#camera").srcObject = null;
            cameraOpen = false;
        } catch (err) {
            console.log("关闭摄像头失败:" + err.message);
        }
    }
    function clickUpload() {
        var ie = navigator.appName == "Microsoft Internet Explorer" ? true : false;
        if (ie) {
            document.getElementById("input-upload").click();
        } else {
            var eve = document.createEvent("MouseEvents");
            eve.initEvent("click", true, true);
            document.getElementById("input-upload").dispatchEvent(eve);
        }
    }
    document.getElementById("input-upload").onchange = function () {
        var input = document.getElementById("input-upload");
        var acceptedTypes = {
            "image/png": true,
            "image/jpeg": true
        };
        var maxSize = 10;
        if (!input.value) {
            return;
        }
        if (acceptedTypes[input.files[0].type] != true) {
            showMessage("请上传jpg、jpeg、png格式的图片");
            return;
        }
        if (maxSize && input.files[0].size > maxSize * 1024 * 1024) {
            showMessage("请上传小于" + maxSize + "M的图片");
            return;
        }
        uploadImage();
    }
    function showCanvas() {
        var canvas = document.getElementById("canvas");
        canvas.classList.remove("hidden");
    }
    function hideCanvas() {
        var canvas = document.getElementById("canvas");
        canvas.classList.add("hidden");
    }
    function showCanvasResp() {
        var canvas = document.getElementById("canvas-resp");
        canvas.classList.remove("hidden");
    }
    function hideCanvasResp() {
        var canvas = document.getElementById("canvas-resp");
        canvas.classList.add("hidden");
    }
    function openCamera() {
        startCamera();
        hideCanvas();
        hideCanvasResp();
    }
    async function recogCamera() {
        if (!cameraOpen) {
            return;
        }
        let data = await uploadCamera();
        drawResp(data.result, data.image.width, data.image.height);
        updateInfoList(data.result, 5, false);
        showCanvasResp();
    }
    function uploadCamera() {
        const video = document.getElementById("camera");
        const canvas = document.getElementById("canvas");
        const ctx = canvas.getContext("2d");
        canvas.width = video.videoWidth;
        canvas.height = video.videoHeight;
        ctx.drawImage(video, 0, 0);
        return new Promise((resolve, reject) => {
            canvas.toBlob((blob) => {
                if (!blob) {
                    return reject(new Error("canvas生成blob失败"));
                }
                const file = new File([blob], "canvas.png", {
                    type: "image/png"
                });
                const formData = new FormData();
                formData.append("upload", file);
                fetch("upload", {
                    method: "POST",
                    body: formData
                })
                    .then(res => {
                        if (!res.ok) throw new Error("请求失败");
                        return res.json();
                    })
                    .then(data => resolve(data))
                    .catch(err => reject(err));
            }, "image/png");
        });
    }
    function uploadImage() {
        showLoading();
        stopCamera();
        hideCanvasResp();
        var xhr = new XMLHttpRequest();
        var form = document.getElementById("form-upload");
        xhr.open("post", "upload");
        xhr.onreadystatechange = function () {
            if (xhr.status == 200) {
                if (xhr.readyState == 4) {
                    var data = JSON.parse(xhr.responseText);
                    if (data.success == true) {
                        document.getElementById("input-value").value = data.image.value;
                        document.getElementById("input-type").value = data.image.type;
                        drawImage("data:image/png;base64," + data.image.value, data.image.width, data.image.height);
                        drawResp(data.result, data.image.width, data.image.height);
                        updateInfoList(data.result, 0, true);
                        showCanvas();
                        showCanvasResp();
                    } else {
                        showMessage(data.message);
                    }
                }
            } else {
                hideLoading();
                showMessage("上传图片失败,请重新尝试");
            }
            hideLoading();
        }
        xhr.send(new FormData(form));
    }
    function drawImage(image, width, height) {
        var canvas = document.getElementById("canvas");
        var context = canvas.getContext("2d");
        canvas.width = 640;
        canvas.height = 480;
        var scaling = 1, left = 0, top = 0;
        if (width > canvas.width || height > canvas.height) {
            if ((canvas.width / width) < (canvas.height / height)) {
                scaling = canvas.width / width;
            } else {
                scaling = canvas.height / height;
            }
            width *= scaling;
            height *= scaling;
        }
        left = (canvas.width - width) / 2;
        top = (canvas.height - height) / 2;
        var img = new Image();
        img.onload = function () {
            context.drawImage(this, left, top, width, height);
        }
        img.src = image;
    }
    function drawResp(result, width, height) {
        var canvas = document.getElementById("canvas-resp");
        canvas.classList.add("hidden");
        const ctx = canvas.getContext("2d");
        canvas.width = 640;
        canvas.height = 480;
        ctx.strokeStyle = "#ff3333";   // 边框颜色
        ctx.lineWidth = 1;             // 边框粗细
        var scaling = 1, left = 0, top = 0;
        if (width > canvas.width || height > canvas.height) {
            if ((canvas.width / width) < (canvas.height / height)) {
                scaling = canvas.width / width;
            } else {
                scaling = canvas.height / height;
            }
            width *= scaling;
            height *= scaling;
        }
        left = (canvas.width - width) / 2;
        top = (canvas.height - height) / 2;
        for (var idx = 0; idx < result.length; idx++) {
            var obj = result[idx];
            ctx.strokeRect(
                obj.left * scaling + left,
                obj.top * scaling + top,
                obj.width * scaling,
                obj.height * scaling);  // 参数:x起点,y起点,宽度,高度
        }
    }
    function updateInfoList(data, limit, clear) {
        var infoList = document.getElementById("info-list");
        if (clear) {
            infoList.innerHTML = "";
        } else if (limit > 0) {
            var childCount = infoList.children.length;
            var deleteNum = data.length + childCount - limit;
            deleteNum = deleteNum >= 0 ? deleteNum : 0;
            for (var i = 0; i < deleteNum; i++) {
                if (infoList.firstElementChild) {
                    infoList.removeChild(infoList.firstElementChild);
                }
            }
        }
        for (var idx = 0; idx < data.length; idx++) {
            var obj = data[idx];
            let now = new Date(obj["time"] * 1000);
            let dateStr = now.getFullYear() + "-" +
                String(now.getMonth() + 1).padStart(2, "0") + "-" +
                String(now.getDate()).padStart(2, "0");
            let timeStr = String(now.getHours()).padStart(2, "0") + ":" +
                String(now.getMinutes()).padStart(2, "0") + ":" +
                String(now.getSeconds()).padStart(2, "0");
            var itemHTML = "<div class='item'>" +
                "<div class='thumb'><img src='data:image/png;base64," + obj["image"] + "'></div>" +
                "<div class='label'>" +
                "<div class='name'>" + obj["name"] + "</div>" +
                "<div class='prob'>" + obj["conf"].toFixed(2) + "</div>" +
                "</div>" +
                "<div class='datetime'>" +
                "<div class='date'>" + dateStr + "</div>" +
                "<div class='time'>" + timeStr + "</div>" +
                "</div></div>";
            infoList.innerHTML = infoList.innerHTML + itemHTML;
        }
    }
    openCamera();
    updateTime();
    setInterval(updateTime, 500);
    setInterval(recogCamera, 500);
</script>
</body>
</html>
总结
本文完整拆解了一套基于 YOLO11+ResNet50 双模型联动、HTML5 轻量化部署的 AI 智能垃圾分类识别系统,从项目背景价值、AI 开发逻辑、两大核心数据集解析、双模型专项训练、级联推理流程,到前端应用搭建、全场景落地用途,实现了从理论到实战的完整闭环。
项目创新性地采用"先检测、后分类"的双模型架构,结合 garbage-classification-3 检测数据集与 garbage265 精细化分类数据集,解决了传统单一模型识别精度低、场景适配性差的痛点;依托 HTML5 轻量化部署,打破了 AI 应用的设备壁垒,实现全民便捷使用。
整套系统兼具科普价值、科研价值与产业价值,既适合 AI 初学者入门实战、学生科研创新,也可直接轻量化落地于民生、环卫、工业生产场景。如果你对这类 AI 实战项目感兴趣,欢迎到云栈社区获取更多技术资源与项目源码,和开发者们一起交流学习。
 发表于 昨天 05:49
|
查看: 5|
回复: 0


