说个我自己的习惯:看到社区里有人分享 Claude Code 的 skill,觉得有用,git clone 下来就装。从来没有打开看过里面写了什么。
直到今天看到一组研究数据,后背发凉:一项收集了 42,447 个 agent skill 的学术研究,对其中 31,132 个做了分析——26.1% 至少含一个漏洞,5.2% 表现出高度疑似恶意的行为模式。还有一个更扎眼的数字:带可执行脚本的 skill,中招概率是纯指令型 skill 的 2.12 倍。
skill 不是文档。它是一段以你的身份、你的凭据、你的工具权限运行的第三方代码。一个被投毒的 npm 包,跑在构建机的权限里;一个被投毒的 agent skill,跑在你 agent 能触达的一切——它读得到的文件、握着的密钥、被允许执行的操作。而 prompt 注入,正好是驱动它的一条通道。
GitHub 上,NVIDIA 把这道缺失的安检做成了开源工具:SkillSpector,2026 年 3 月开源,Star 冲到 18,852,最近提交也很活跃。
一句话简介
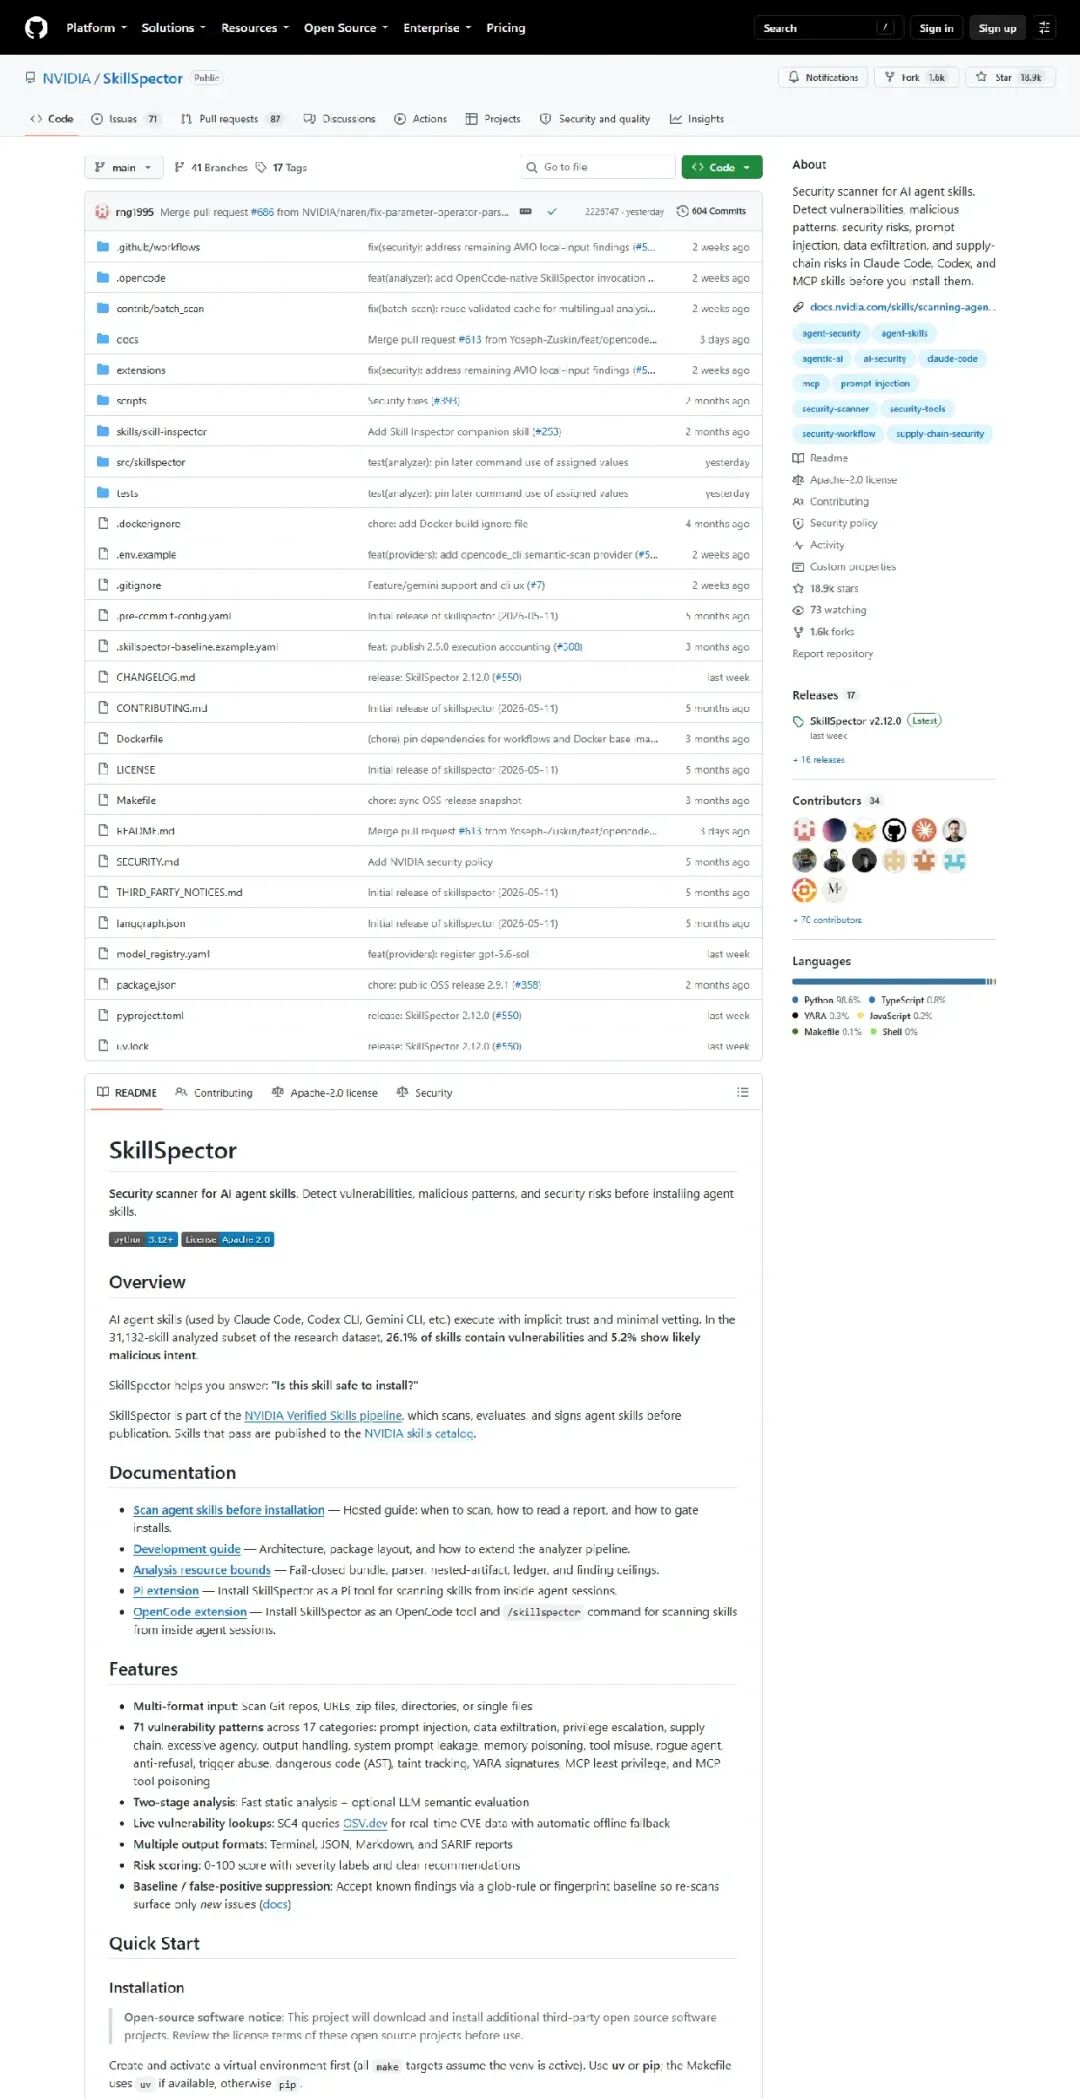
SkillSpector 是给 AI agent skill 做的安装前安检机:输入一个 Git 仓库、URL、zip 或单个 SKILL.md,它用 71 条规则扫 17 类风险(prompt 注入、数据外泄、权限提升、MCP 工具投毒……),输出 0-100 风险分和处置建议,回答一个问题——这个 skill 到底能不能装。
它不是研究原型:SkillSpector 是 NVIDIA Verified Skills pipeline 的安全层,NVIDIA 官方 skill 目录里的每个 skill,都是经它扫描、评估、签名之后才发布的。Apache-2.0 开源,Python 实现(占代码库 98.5%)。
三大核心亮点
亮点 1、71 条规则、17 大类,一张 agent 风险分类学
覆盖面读起来像一份 agent 时代犯罪名录:prompt 注入、数据外泄、权限提升、供应链、过度授权、输出处理、系统提示泄露、内存投毒、工具滥用、rogue agent、触发词滥用、危险代码模式(AST)、污点追踪、YARA 签名、MCP 最小权限、MCP 工具投毒。
几个设计很见功力:
- P2 隐藏指令:藏在注释或不可见文本里的恶意指令——人眼 review skill 文档时最容易漏的就是这个;
- SC8 随包 Python 字节码:skill 里夹带
__pycache__ / .pyc,让扫描器跳过源码发现、直接执行预编译字节码的绕过手法;
- 通配符权限:skill 声明
* / all / full / any 这种什么都要的权限,直接标记;
- 权限声明缺失:没写权限字段却带着明显有能力的代码——沉默的权限索取。
亮点 2:两阶段分析——确定性打底,语义补盲
- 静态层(默认,可离线):AST 走读 + YARA 特征签名 + 污点追踪,快速、确定、不花钱,
--no-llm 一个参数就能跑;
- 语义层(可选,接 LLM):让模型对比 skill 说自己干什么和代码看起来在干什么,专抓描述与行为不符、模糊触发词这类签名规则抓不到的软性风险。
语义层支持 openai / anthropic / bedrock / nv_build / ollama / azure 等 provider,也能接本地 Ollama / vLLM。还有一个容易被忽略的细节:LLM 分析的 prompt 内置了防越狱保护——防止恶意 skill 在自己的代码里写话,反过来操纵来扫描它的模型。
亮点 3:为自动化流水线而生,不是命令行玩具
- 四种输出:Terminal(人看)、JSON(机器)、Markdown(评审包)、SARIF(直连 CI/CD 和 IDE 安全工具)——skill 安检可以嵌进和依赖扫描相同的流水线闸门;
- 基线抑制:
skillspector baseline 把已接受的发现存成基线(支持 glob 规则或指纹),重扫只报新增问题,解决模式扫描器被误报淹死的经典死法。指纹基线还是证据绑定的:源码一改或版本一升级,对应发现自动重新激活等人复核;
- 实时 CVE + 防弹输入:SC4 分析器实时查 OSV.dev 的 CVE 库(断网自动离线回退);输入侧 100MiB 下载上限、10,000 zip 成员上限、单文件 1MB 上限,超限直接报错拒绝分析(fail-closed)——对一个吃不可信输入的扫描器,宁可拒绝也不猜,这是正确的默认。
为什么提醒用户看清 skill 是句空话
社区过去一年的建议是只装你信任的 skill。这话在 npm 生态已经被证伪过一次:流行的包恰恰是投毒者的头号目标。skill 的传播方式又和浏览器插件一样——同事装了个好用的,你跟着装,没有评审、没有清单、没有责任人。
更根本的问题:SKILL.md 本身就是可执行指令面。它看起来是文档,实际是驱动 agent 的程序。让人看一眼再装防不住藏在注释里的指令、伪装成示例代码的 payload、描述与行为不符的偷换。
SkillSpector 的架构:一条确定性优先的分析流水线
- 入口层:五种输入(Git 仓库 / URL / zip / 目录 / 单文件)统一进 ingest,立刻套上资源上限,超限 fail-closed;
- 静态分析层:AST + YARA + 污点追踪并行跑,全部确定性规则,离线可用、结果可复现——这是安检的底座;
- 语义分析层(可选):LLM 拿到静态层结论后做意图比对,抓说一套做一套;
- 评分与处置层:0-100 风险分 + 严重性标签 + 处置建议,按 SARIF/JSON/Markdown/终端四格式输出。
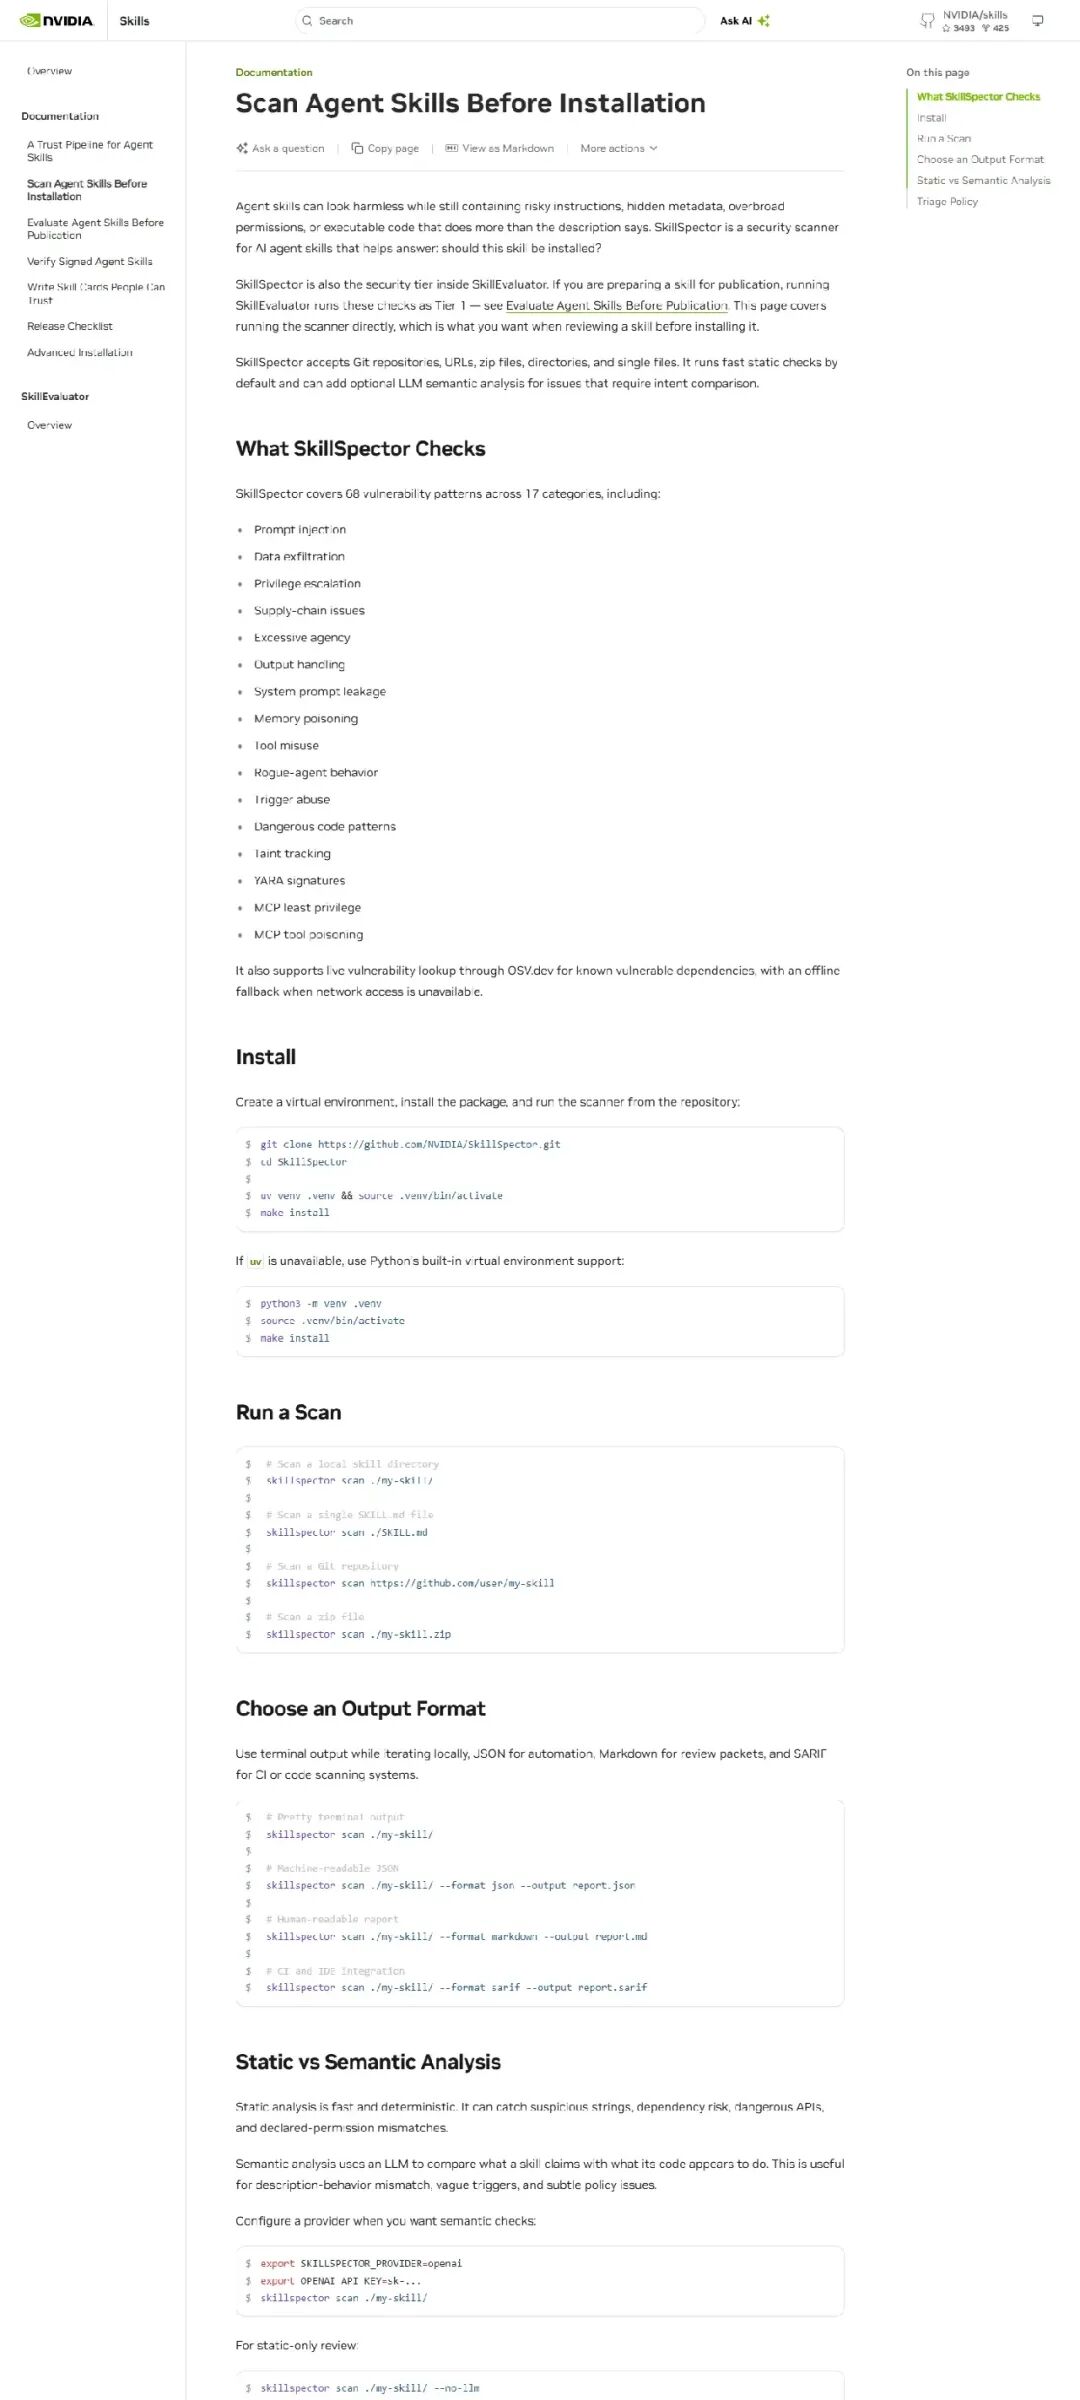
官方文档站还给了明确的处置政策:Critical/high 阻断发布;隐藏指令先移除再评;权限声明与行为不符就改权限或删行为;已知漏洞依赖升级或钉版本。目标不是报告干净,而是声明的用途、声明的权限、实际代码三者一致。
一个值得单独说的设计判断:扫描器对自己的输入也不信任。zip 炸弹、超大仓库、预编译字节码,全部在 ingest 层被上限卡死——安全工具自己先做好自身的攻击面管理,这个自觉不多见。
安装与配置
安装需 Python 3.12+:
# 用 uv 最快(仅 CLI)
uv tool install git+https://github.com/NVIDIA/SkillSpector.git

# 或从源码
git clone https://github.com/NVIDIA/SkillSpector.git
cd SkillSpector
uv venv .venv && source .venv/bin/activate
make install
不想装 Python 就用 Docker:
docker build -t skillspector .
docker run --rm -v "$PWD:/scan" skillspector scan ./my-skill/ --no-llm
基础扫描四连:
skillspector scan ./my-skill/                       # 本地目录
skillspector scan ./SKILL.md                         # 单文件
skillspector scan https://github.com/user/my-skill   # Git 仓库
skillspector scan ./my-skill.zip                     # zip 包
接 LLM 语义分析(可选):
export SKILLSPECTOR_PROVIDER=openai
export OPENAI_API_KEY=sk-...
skillspector scan ./my-skill/
批量扫一个 skill 目录(并行 20 workers,支持中日韩多语言检测):
python -m contrib.batch_scan.batch_scan ./my-skills/ --workers 20 -f json -o report.json
还有两个装进 agent 身上的形态:MCP 服务模式(skillspector mcp,装 [mcp] extra)和 Pi / OpenCode 扩展——后者在 agent 会话内直接用 /skillspector 命令扫,装前安检变成 agent 工作流的一部分。
团队落地方案
1. 团队改造思路
把 skill 安检定义为准入闸门而非事后审计:任何第三方 skill 进开发环境前必须过扫,Critical/high 阻断,其余按官方 triage 表处置。边界也清楚:扫描管装之前,运行时隔离(沙箱、出口管控)是另一层,两者不互替。
2. 部署方案
安全团队用批量扫描器对内部 skill 库全量摸底(--workers 20 并行、JSON 出报告);开发者机器用 uv tool 统一装 CLI;用 Claude Code 的团队加挂 MCP 模式,agent 会话内即可自检。多 API key 池可提升 LLM 扫描吞吐。
3. 流水线集成
SARIF 输出直接喂 CI/CD 的 code scanning 通道,和依赖扫描(SCA)站在同一个闸门位:skill 报告进门槛 = 依赖扫描不通过不能合并。基线文件(.skillspector-baseline.yaml)随仓库提交,重扫只对新增发现报警,不淹没在历史误报里。
4. 团队规范定制
按官方 triage 政策落成内部制度:禁止通配符权限、禁止 skill 夹带 __pycache__、权限声明与行为一致性作为 code review 检查项;LLM 语义层默认走内部网关(注意 skill 内容会发往 provider 端点,敏感团队这是数据出境考量,接本地 Ollama/vLLM 可规避)。
真实适用场景
- 装第三方 skill 的 agent 用户:Claude Code / Codex / Gemini CLI 重度玩家,装前一条命令的事;
- 企业安全团队:把 agent skill 纳入软件供应链管理,批量扫描 + SARIF 进 CI 闸门;
- skill 开发者 / 发布方:发布前自扫,别让自己的 skill 成为那 26.1%;
- MCP 生态维护者:MCP 工具投毒、最小权限两类规则专为它准备。
不适合的也说清楚:不装第三方 skill、只用官方目录的用户,收益有限——它防的是外来代码,不是自己写的 bug。
优缺点与避坑
核心优势:NVIDIA 官方出品且是自家 skill 目录的发布闸门(生产验证,不是 demo);71 规则 17 类是同类里覆盖面拉满的;静态层离线确定、语义层可选可控;SARIF + 基线抑制是为流水线认真设计过的;Apache-2.0。
局限:
- 受众细分:不装第三方 skill 的开发者基本用不上,属于 agent 供应链这个垂直场景的工具;
- LLM 语义层有成本:需自配 API key,批量扫描是 token 消耗大户;另外 README 坦承默认 provider DeepSeek-Chat 预计停服,通用本地后端(Ollama/vLLM)还在征集 PR——接本地模型前先确认兼容;
- 扫描器不是免疫:检出后仍需人工判断处置;它管不了过审后被更新投毒和运行时被注入,运行时管控要另配(如 NVIDIA 自家 OpenShell 那类沙箱运行时);
- 同类重叠:与 cloudflare/security-audit-skill 定位部分重叠,但它更聚焦安装前的静态+语义扫描,后者偏运行时的审计技能,可按需组合。
数据出处要说清楚:开头那组 26.1% / 5.2% 的数据不是 NVIDIA 自家产的,它来自 2026 年 1 月的学术论文《Agent Skills in the Wild》(Liu 等,arXiv),NVIDIA 在 README 中引用。数字可信,但引用来源是第三方研究,这点别被营销号带偏。
落地避坑:
- 别把风险分当唯一判据:0-100 分是排序参考,隐藏指令类发现(P2)无论分数高低都该人工过目;
- 基线文件别放 skill 目录里:官方文档提醒,基线存在被扫描目录内可能被恶意篡改;
- 文档站写 68 条规则、README 写 71:版本迭代口径差,以主仓库 README 为准,规则数还在涨;
- Docker 扫描挂载当前目录:报告写回挂载目录才有持久化,忘了挂载就白扫。
最后说两句
skill 生态正在重演浏览器插件和 npm 的供应链故事,这次的区别是:skill 拿到的是你的凭据和工具权限。NVIDIA 把自家目录的安检闸门开源出来,让装前扫一遍从安全素养变成一条命令——这一步该早点来,但来了就好。
开源地址:https://github.com/NVIDIA/SkillSpector
如果你对 AI Agent 开发、技能系统与安全实践感兴趣,云栈社区 有更多深度内容与讨论。
 发表于 2 小时前
|
查看: 1|
回复: 0


