NVIDIA GPU 加速器如今仍是多数 AI 巨头的首选,但几乎没有谁愿意把所有筹码都押在同一家身上。各家一边持续加大对 AMD Instinct GPU 的采购,一边也在加速推进自研芯片。
以 OpenAI 为例,它正联合博通自研代号 “Jalapeno”(墨西哥哈雷派尼奥辣椒)的首款专用 ASIC 芯片,官方称其为智能处理器,主要面向大模型推理与智能体计算。
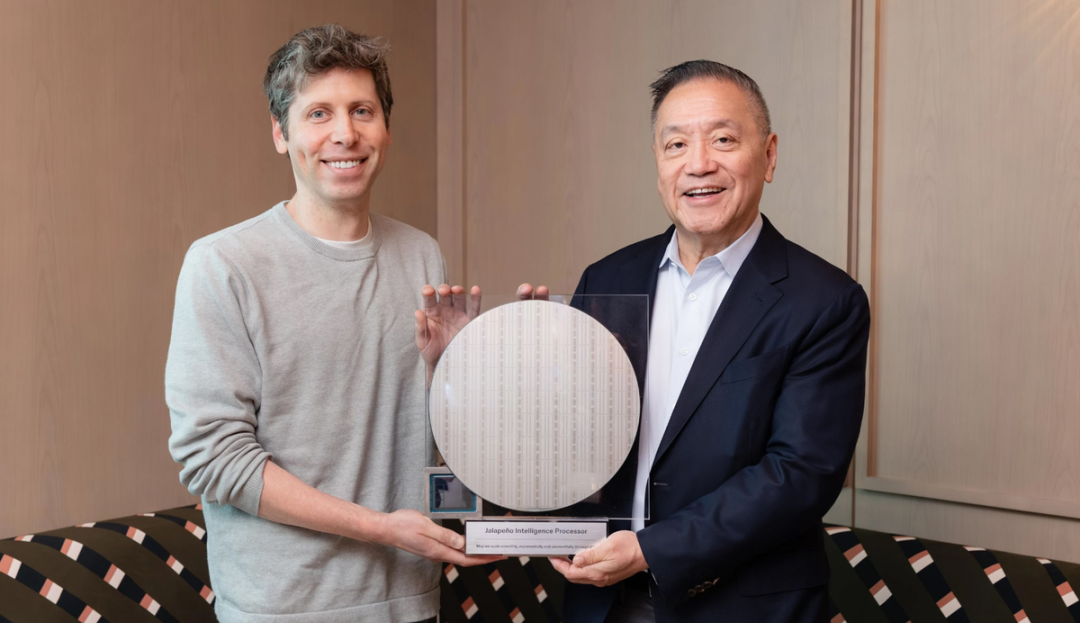
据芯硬件了解,Jalapeno 在 2024 年 10 月完成架构概念,2025 年 11 月成功流片,从项目启动到拿到成品芯片只用了约 16 个月。整个研发过程都使用 OpenAI 自有大模型进行辅助设计、验证与优化,开发周期被明显压缩。
配置方面,Jalapeno 采用当前流行的 Chiplet 芯粒设计,包含台积电 N3P 3nm 工艺的计算模块、台积电 N3E 3nm 工艺的 IO 模块,同时搭配 6 颗 36GB HBM4 内存,总容量 216GB,带宽 15.4TB/s。标称 TDP 为 700W,典型推理负载下的持续功耗不超过 550W。
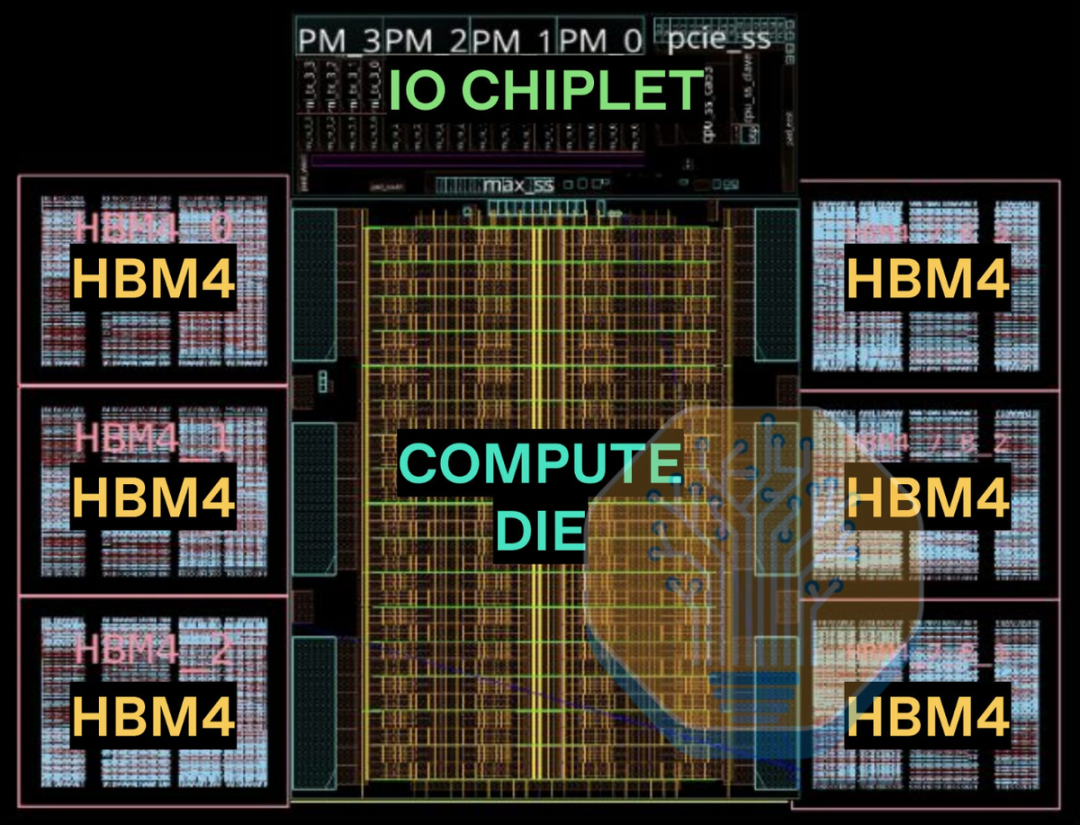
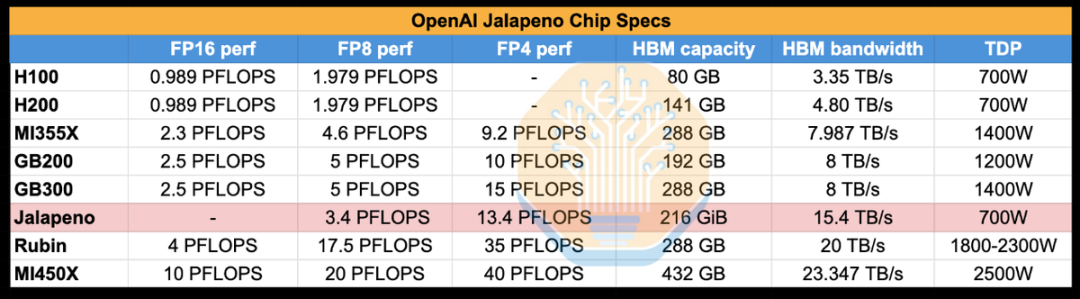
它原生支持 MXFP8、MXFP4 混合精度,正好适配 MoE 大模型“激活 FP8 + 权重 FP4”的主流计算路径。其中 MXFP4 精度算力为 13.4 PFLOPS(1.34 亿亿次计算每秒),MXFP8 精度算力为 3.4 PFLOPS(0.34 亿亿次计算每秒)。
从理论性能来看,它对比 NVIDIA GB300、AMD Instinct MI450X 仍然有较大差距,但它本来也不是为了取代这些产品,而是作为第一方算力补充,重点优化核心推理负载的成本与用户体验。
同时,基于第三方测试,OpenAI Jalapeno 在实际应用场景中相对 NVIDIA GB300 有多项优势:长上下文场景吞吐量高 8.6 倍,纯 Token 生成性能高 2.1 倍,峰值混合吞吐能效高 1.5 倍,同等性能下的端到端延迟低 2.2 倍。
作为一款通用推理加速芯片,Jalapeno 的目标是打破传统 GPU 在吞吐量与延迟之间“二选一”的瓶颈,同时实现更高能效、更低延迟和更高吞吐。它不但适配 OpenAI 自家大模型,也可以无缝运行第三方大模型。
目前,Jalapeno 已经开始在 OpenAI 内部部署,优先承载 ChatGPT、Codex、API 接口与智能体相关的核心推理负载。OpenAI 采用了 ASIC 加速柜与 CPU 主机柜分离的机架设计,而与之搭配的 CPU 处理器,正是 AMD 第五代 EPYC 9005 处理器,代号 Turin。
每个加速柜包含 16 个托盘,每个托盘 8 颗 Jalapeno、1.7TB HBM4,也就是说单个加速柜共有 128 颗 Jalapeno、27.6TB HBM4 内存。每个主机柜同样为 16 个托盘,每个托盘 2 颗 Turin EPYC、1.5TB 系统内存,合计 32 颗 EPYC、24TB 内存。
为什么 CPU 选择 AMD EPYC,而不是 NVIDIA Vera
对于主机侧 CPU 为何选择 AMD EPYC,OpenAI 硬件副总裁 Richard Ho 说得非常直白:这是务实的选择(pragmatic),同时他认为 NVIDIA Vera CPU 在成熟度上还稍有不足。
他说:“我们这套设计的核心思路就是降低风险、快速落地。NVIDIA Vera 作为独立产品,成熟度还差一些。AMD Turin 很强大,也很可靠,能满足我们的需求,而且我们的部分合作伙伴拥有丰富的使用经验。”
他进一步解释:“对于 Jalapeno 项目,我们一直坚持务实的选择。在性能、成本上,我们有着非常激进的目标,但不想冒不必要的风险。从我们的决策标准来看,AMD EPYC 是一个上佳的选择。”
数据中心 CPU 的路线之争
近几年,基于 Arm 架构的数据中心 CPU 非常活跃,多家超大规模云厂商都已开始部署,例如谷歌云 Axiom、AWS Graviton、微软 Azure Cobalt 等。在机柜级市场,Arm 架构的整体规模甚至已经开始超过 x86。
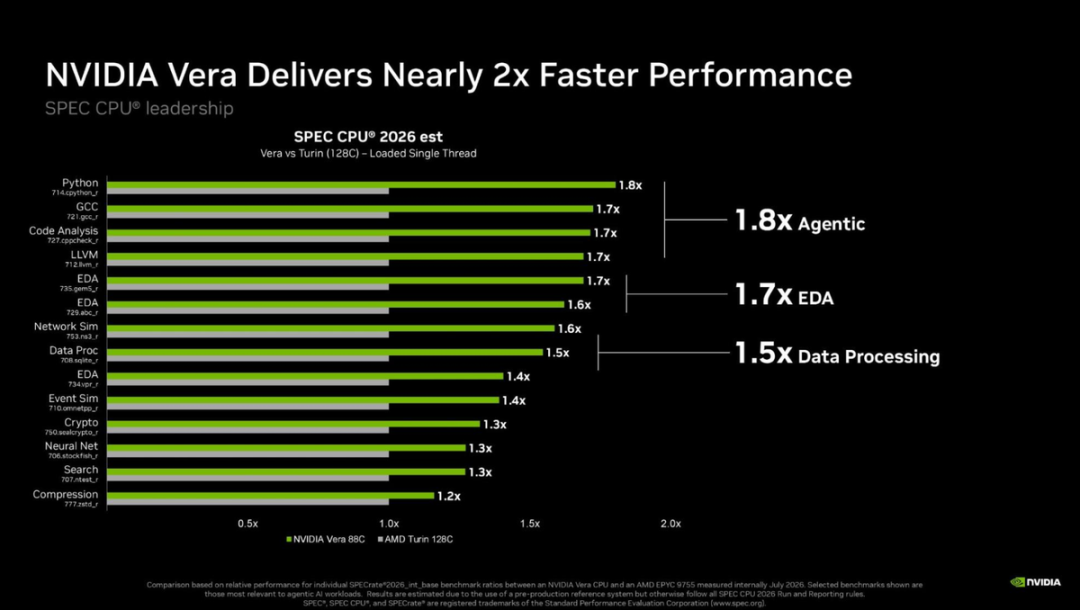
不久前,Arm 甚至亲自下场打造了 AGI CPU。NVIDIA Vera 也极为高调,被视作 NVIDIA 正式进军 CPU 市场的第一枪。官方宣称,以 88 核心对比 AMD Turin 128 核心,智能体性能最多可领先 80%。
不过,厂商宣传数字的水分大家心里都清楚。更何况 AMD 已经亮出了最新的第六代 Venice EPYC,专为智能体负载、宿主节点优化,性能再次跃升,并不是 NVIDIA Vera 能轻易比拟的。
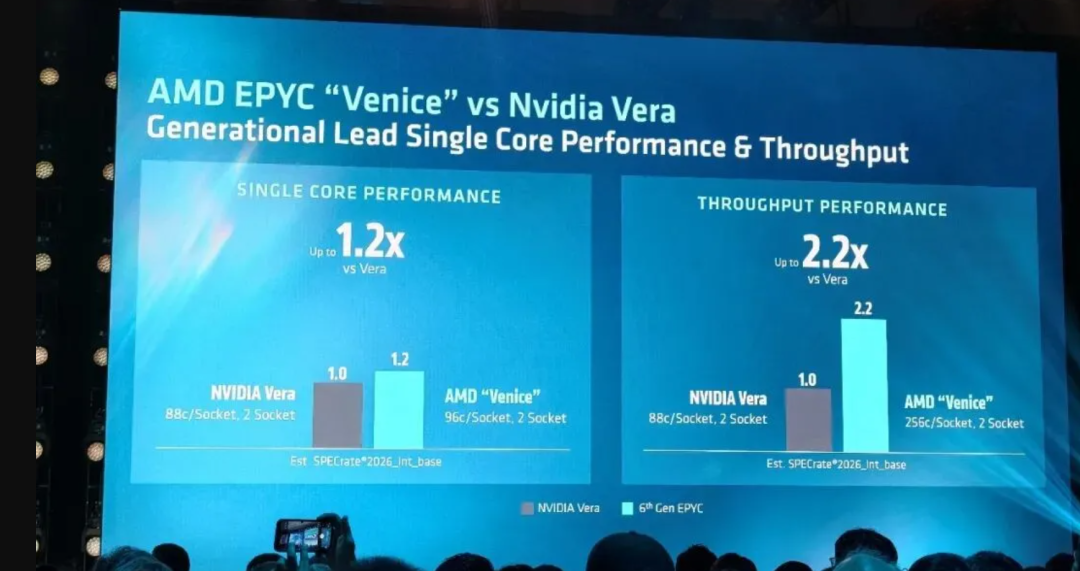
OpenAI 选择 AMD Turin 搭配自家 Jalapeno,这件事本身很值得玩味。要知道,OpenAI 本身也是 Arm AGI 的合作伙伴,同时还在 NVIDIA CPU 的合作伙伴名单里,属于“正在评估”的客户。可见 OpenAI 的做法是多方押注、谁都不排斥,具体项目采用哪种方案,主要看谁更匹配当下场景。
Richard Ho 的表态也说明,OpenAI 关注的并不是 x86 与 Arm 架构谁优谁劣,而是更现实的取舍与平衡。NVIDIA Vera 是 NVIDIA 首次面向数据中心自研的 CPU 产品,早期跑分虽然亮眼,但无论是生态适配广度,还是产品自身成熟度,对 Jalapeno 项目来说都意味着更多投入和额外风险。
AMD Turin 则正好相反:产品迭代成熟、性能和能效出色,更重要的是具备丰富的实战部署经验,生态支持也没有后顾之忧。还有一点容易被忽略,NVIDIA Vera 采用板载式焊死设计,而 AMD Turin 是插槽式独立设计,这为后续升级留出了极大空间,需要时可以直接切换到新一代 Venice。
OpenAI 拥有庞大的硬件集群,Jalapeno 未来也有可能适配更多宿主 CPU 平台,但现阶段 AMD Turin 显然是最合适的选择。
另外,OpenAI 与 AMD 在 AI 数据中心上的合作正变得越来越密切,无论是规模还是范围都在持续扩大。早在 2025 年 10 月,OpenAI 就宣布将部署多达 6GW 的 AMD GPU 算力,合作将延续多年,覆盖多代产品。今年 7 月底的 Advancing AI 大会上,双方又宣布达成全面深度合作,范围不止硬件,还包括软件。
OpenAI 为 AMD 提供未来大模型和真实负载需求的演进方向,AMD 则负责把这些转化为硬件芯片、系统方案和软件栈优化,双方互相反哺。例如在 GPU 上,从当下的 Instinct MI400 系列,到未来的 Instinct MI500 系列,都是这样的路径。2026 年下半年开始,OpenAI 将陆续部署 AMD Helios 机架级系统,其中包括 Instinct MI450 系列,首批算力规模达到 1GW,之后逐步扩容。
 发表于 2 小时前
|
查看: 8|
回复: 0


