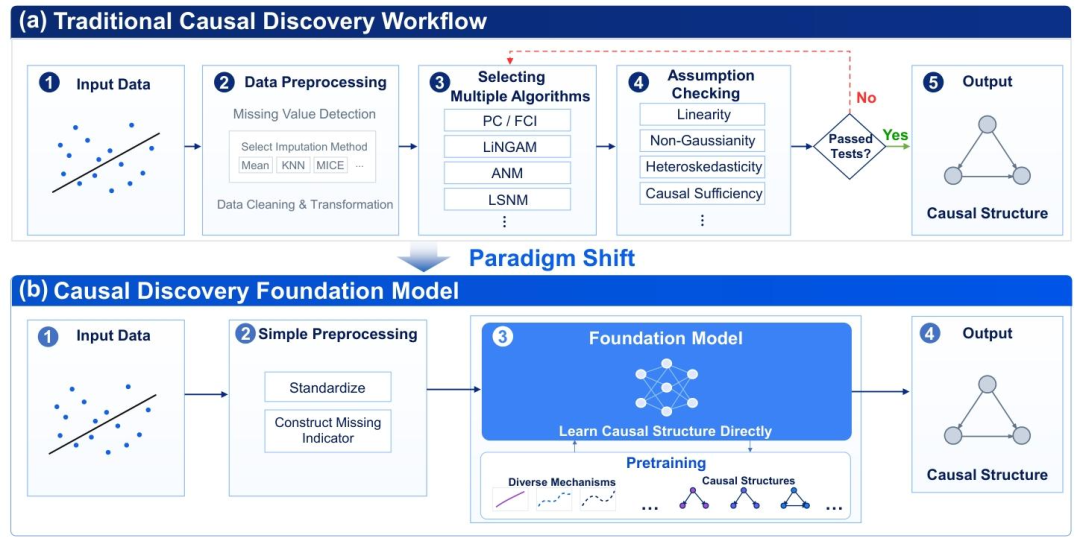
从观测数据中把变量之间的因果结构抠出来,这件事在经济学、生物学、社会科学里都称得上是一个棘手的基础难题。过去几十年的路子相当“手工耿”:先做数据清洗和缺失值处理,然后在 PC、FCI、LiNGAM、ANM、GES、NOTEARS 等一大堆算法里人工做选择,接着还得回过头去验证算法赖以为生的假设——线性与否?噪声是不是非高斯?有没有隐变量在捣乱?哪条不满足,就得推倒重来。
这套流程的真正痛点在于,每一种算法都只在特定机制下才具有可识别性保证,而现实数据往往是多种未知机制的杂糅体。这也引出了论文的核心发问:能不能做一个预训练模型,不预设具体机制,让它直接看数据就能吐因果结构?
2026年7月13日挂在 arXiv 上的文章《CDFM: Towards a General-Purpose Causal Discovery Foundation Model》给出了一个相当有意思的解法。论文提出 CDFM(因果发现基础模型),把未知机制当作潜在变量,在变分推断框架下做贝叶斯边缘化,把因果推断硬生生转化成了一个统一的学习任务。
论文题目:CDFM: Towards a General-Purpose Causal Discovery Foundation Model
论文链接:https://arxiv.org/abs/2607.11508
发表时间:2026年07月13日
论文来源:arXiv
传统因果发现的破碎工作流
论文首先一针见血地指出了问题的本质。在没有任何约束的情况下,仅凭观测数据的联合分布,你其实分不清到底是 X 导致 Y,还是 Y 导致 X。变量在观测意义上彼此对称,这就是 Theorem 1 的核心结论。
传统算法是怎么打破这种对称的?靠预先指定的机制。比如 LiNGAM 假设系统线性且噪声非高斯,ANM 假设结果是原因的非线性函数加上独立噪声。论文里的 Theorem 2 进一步证明:只要机制是已知的,真实因果图就能通过边际似然唯一地找出来。
听上去很美好,可现实中咱们哪能提前知道数据属于哪种机制?这正是传统方法在扩展性上卡壳的地方。CDFM 要做的,就是让模型自己把这些机制知识“学”进来,而不是靠人手工设定。
核心思路:把机制边缘化掉
CDFM 的解法相当优雅:不把数据限定在某一种已知机制里,而是把未知机制 M 当作一个潜在变量,在一个机制空间上进行贝叶斯边缘化。换句话说,它同时考虑数据可能符合的多种机制,然后反推出最合理的因果图。
直接算这个积分在数学上不太现实,所以论文采用了变分推断把它变成了可优化的证据下界(ELBO)。这个下界被拆成了三个部分:
- 机制推断 Q(M|X):从数据里提取噪声性质、非高斯性、非线性等机制信息;
- 数据重建 P(X|G,M):给定候选图和机制,尝试重建数据,给自己提供自监督信号;
- 图推断 P(G|M):在机制编码的基础上解码出因果结构。
Theorem 3 锁定了这个框架的可靠性:只要机制空间满足严格可识别性质,随着样本增大,最大化边际似然就会以概率 1 找回真实因果图。注意,变分下界里那三个数学项,恰好跟模型的三个架构组件一一对上——理论分解直接变成了网络结构的设计蓝图。
模型架构:三步从数据到因果图
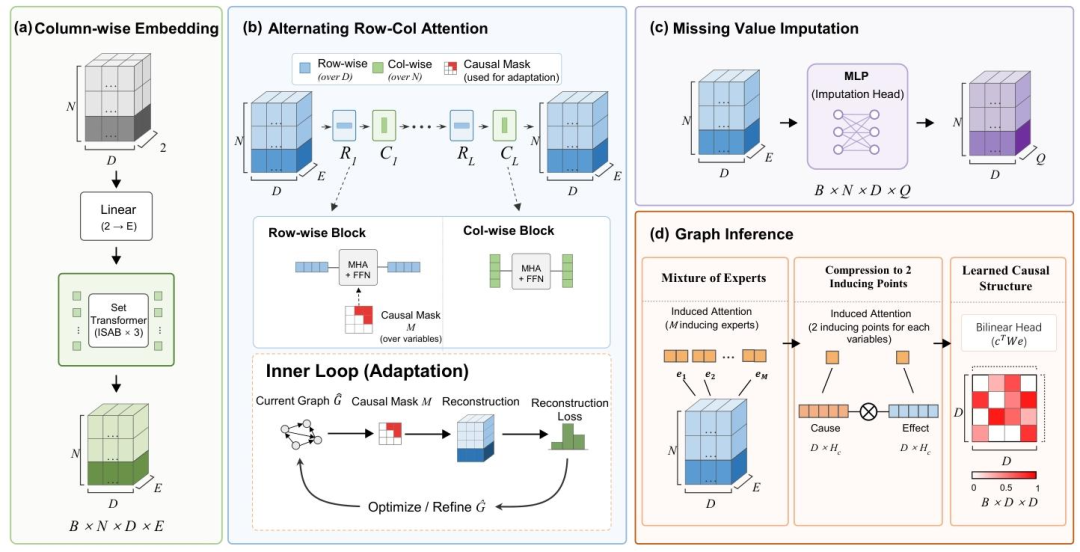
CDFM 接收一个 N×D 的观测矩阵(允许有缺失),输出一张邻接矩阵,有向边表示直接因果关系,双向边表示存在未观测的共同原因。
第一层:逐列嵌入 + 行列交替注意力。 这一步负责机制推断。每个观测值会跟一个缺失指示位拼在一起投成向量,然后用对分布敏感的 Set Transformer 处理每一列,捕捉边际分布的高阶统计特征。之后,注意力机制沿着行轴(同一样本内的变量关系)和列轴(变量自身分布)交替跑,把局部信息整合成全局机制编码。
第二层:因果掩码 + 缺失值插补。 这里对应数据重建。信息流被一个软因果掩码控制着:模型当前判断 j 对 i 有影响时,i 就能拿到 j 的信息,反过来信息流被掐掉。被掩掉的位置由一个分位数回归头来重建,插补误差充当结构学习的自监督梯度。推理阶段模型会跑几轮内环自适应,用重建误差来迭代修正图假设,全程不需要测试集的真值标签。
第三层:图推断。 模型用一组可学习的专家注意力头提取因果特征,聚合出每个变量的“因”向量和“果”向量,再用双线性运算生成连续的边概率,最后由一个在独立合成数据上拟合好的校准器把它变成二值邻接矩阵。
预训练数据:合成数据也能喂出泛化能力?
CDFM 完全在合成数据上预训练,但数据生成器的设计相当讲究。
图结构上,覆盖 Erdős–Rényi、无标度、Watts–Strogatz 小世界等六类模型,变量数从 2 到 100,样本量从 50 到 4096。机制上设计了约十五个族,线性异方差、随机傅里叶特征的强非线性、后非线性、物理启发模型、离散列联表齐上阵。噪声方面,高斯、拉普拉斯、柯西、Beta、指数、Student-t、对数正态、高斯混合全都撒进去,信噪比也随机变化。另外,大约 15% 的训练批次注入了潜在共同原因,约半数批次随机挖掉一些值来模拟缺失。
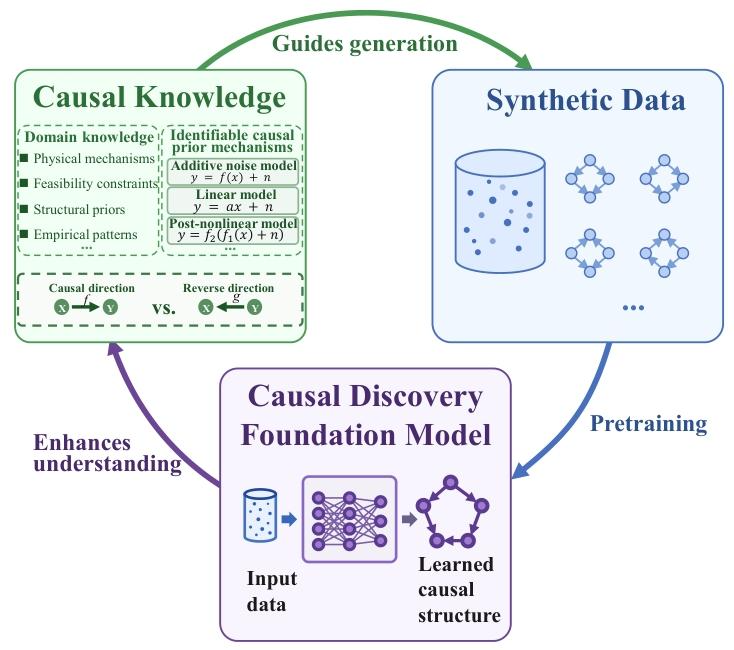
这种覆盖广度的目的很明确:让模型在预训练阶段就把非高斯性、非线性、分布不对称这些统计线索内化成可迁移的表征。论文里描述了一个自增强闭环:因果知识指导合成数据生成,预训练让模型掌握因果不对称性,零样本推理的结果又反过来推动机制库的扩展。
实验结果:零样本下全面领先
论文的所有基准测试都在零样本设定下进行:预训练完成后参数冻结,不访问测试集真值,也不做数据集级别的调优。
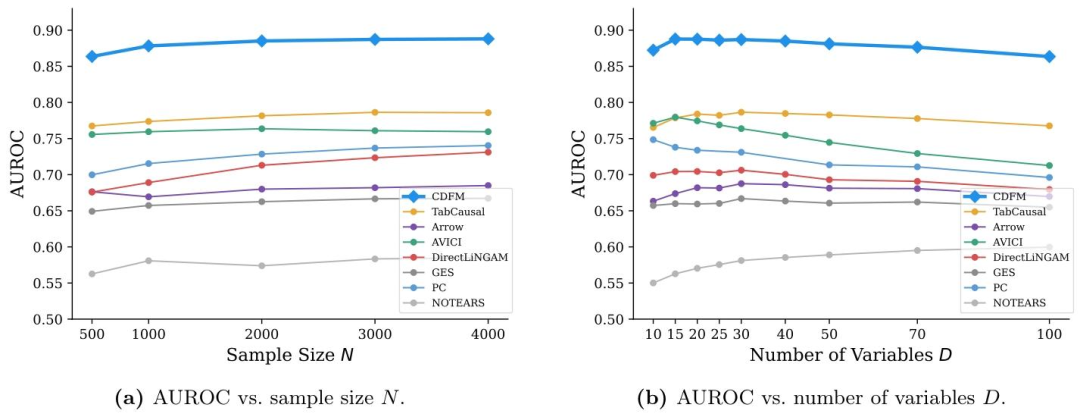
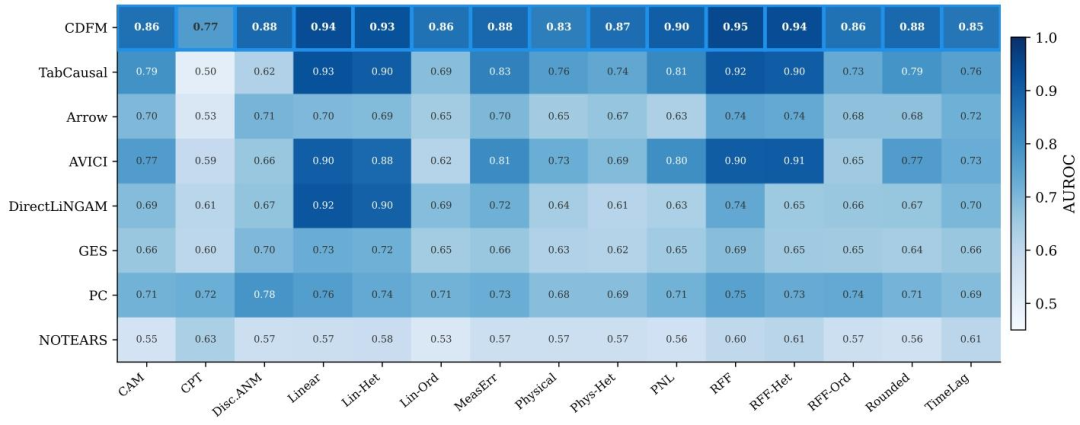
在合成基准上,CDFM 在各样本量下的 AUROC 都是最高,稳定在 0.86 到 0.89 之间,甩开第二名约 0.08 到 0.10。有意思的是,当变量数从 10 涨到 100,那些依赖条件独立检验的方法性能哐哐往下掉,而 CDFM 只从 0.88 微跌到 0.84。分机制看,CDFM 在全部十五个机制族上 AUROC 都是最高或并列最高,只有在线性非高斯这一个 LiNGAM 的主场上,DirectLiNGAM 的 F1 略胜一筹。
真实数据上的表现更值得玩味。CDFM 在 Causal Chamber 物理因果系统上分别拿到 0.952 和 0.965 的 AUROC,在 Tübingen 基准(95 对跨学科真实因果对)上方向判别准确率 0.671,全部高于对比方法。这说明从合成结构方程模型里学出来的因果表征,确实能迁移到真实物理系统和观测数据上。
可识别性边界的“诚实实验”
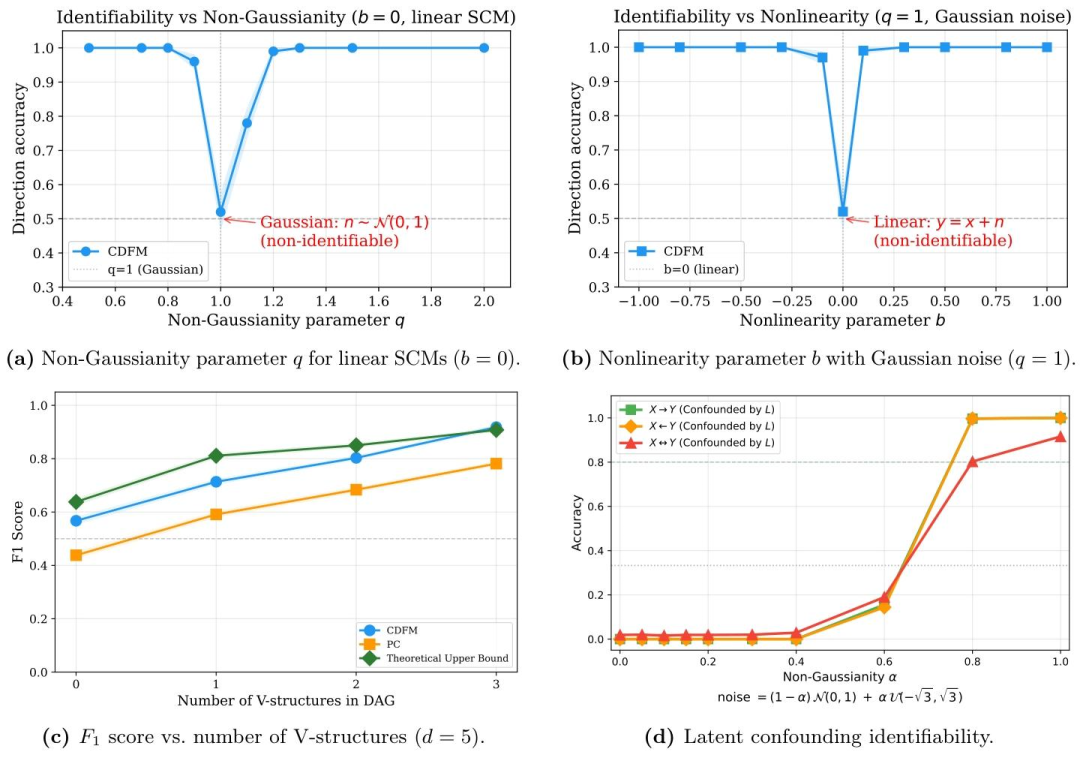
除了性能刷榜,论文里最让我欣赏的是一组诊断性实验。它专门检验模型行为是否跟经典可识别性理论划定的边界一致。
结果干干净净:在高斯噪声+线性模型这个理论上方向不可识别的点上,模型方向准确率掉到 0.5,就是瞎猜;噪声一旦偏离高斯,准确率立刻蹿到接近 1.0。高斯噪声+纯线性条件下同理,但只要引入一丁点非线性,准确率就超过 0.97。V 结构数量增加时,F1 稳步上升并逼近理论上界。隐混杂情形下,模型利用重尾分布的不对称性,把无混杂、X→Y、Y→X 三种关系分得清清楚楚。
这说明 CDFM 在“不该确定”的地方老老实实给出不确定,在“有信号”的地方才果断定方向。模型的行为跟理论如出一辙,这一点在深度学习模型里并不常见。顺带一提,由于插补本身就是训练任务,CDFM 在缺失值填补这个副业上也吊打了 MissForest、MICE、KNN 等八种传统方法。
意义、局限与未来观察
CDFM 的贡献可以拧成三件事来概括:
第一,把因果发现系统地表述成了一个基础模型问题。通过变分框架把未知机制变成可边缘化的潜在变量,还给了理论保证。
第二,架构设计跟变分下界三项完全对齐,引入推理阶段的内环自适应,让模型能像在做一场“用重建误差修正图结构”的在线优化。
第三,建立了覆盖多种图结构、机制、噪声、混杂和缺失模式的大规模合成预训练流程,实现了跨分布的零样本泛化。
局限当然也有。性能天花板还是由可识别性决定的,纯线性高斯场景下谁也救不了;跨域和极端分布外情形下的鲁棒性有待检验,Tübingen 上 0.671 的准确率也说明真实数据的挑战远比合成数据复杂。另外,目前实验集中在表格型变量数据,时间序列、图像、文本这些模态还没伸手进去。
一个比较公允的定位是:CDFM 把过去“选算法、验假设”的人工负担,转化成了一个可预训练、可泛化的推断问题。它输出的可疑边,仍然可以结合传统方法或干预实验来复核。未来如果因果基础模型能像调用模型API一样方便地嵌入到数据科学流程里,那传统的因果发现工具箱或许真的要迎来一轮洗牌。
在云栈社区,我们持续关注这类把理论、架构和工程实践拉通打透的前沿工作。CDFM 的后续进展——尤其是它在更广泛模态和更复杂真实环境中的表现——值得继续观察。
 发表于 昨天 21:23
|
查看: 6|
回复: 0


