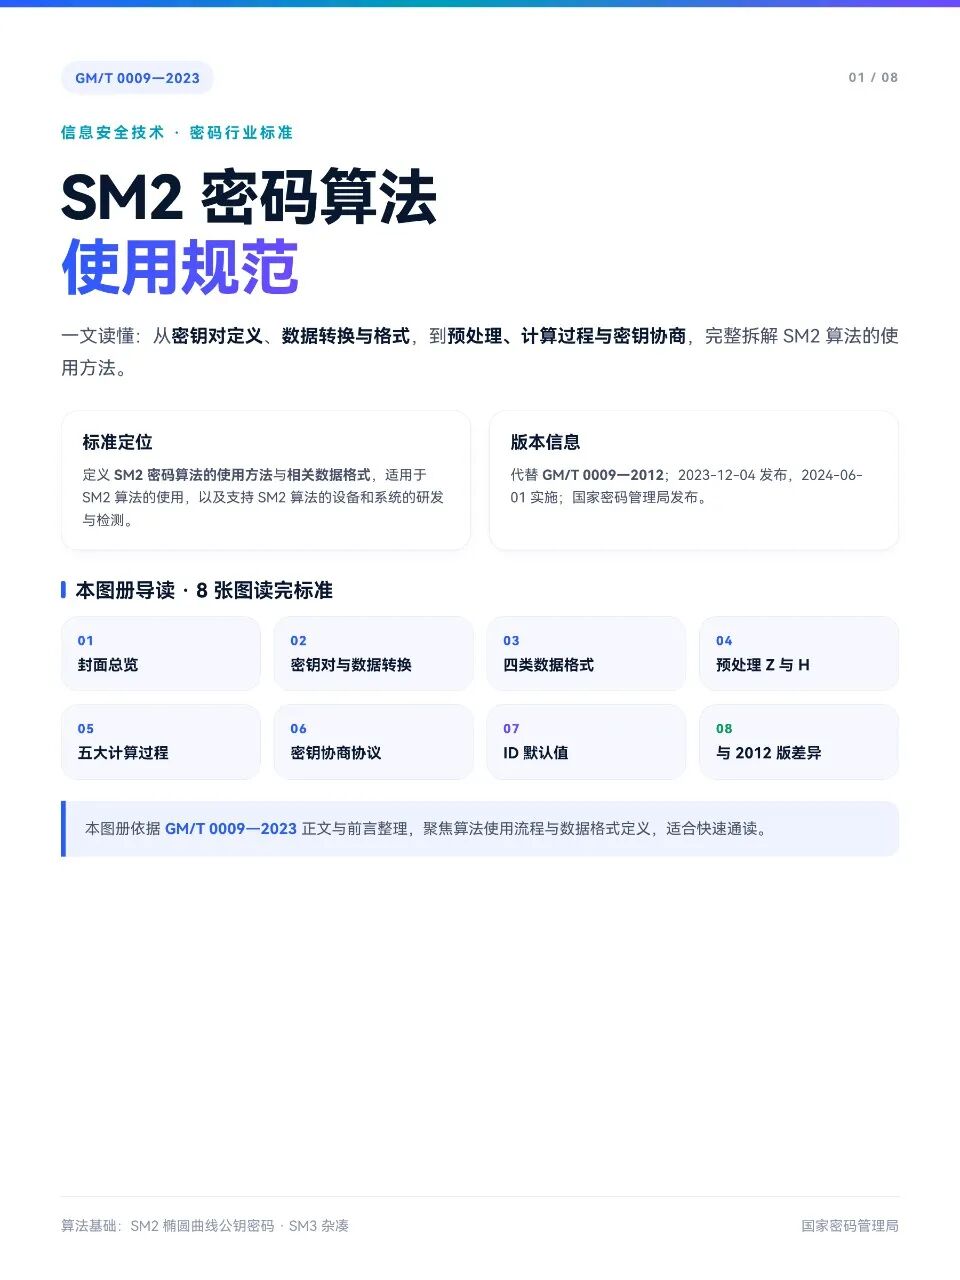
SM2 椭圆曲线公钥密码算法在国内商用密码体系中占据着核心位置,而 GM/T 0009-2023《SM2 密码算法使用规范》则把它的使用方法和数据格式讲透了。这份标准 2023 年 12 月 4 日发布,2024 年 6 月 1 日起正式实施,直接替代了 2012 年的旧版。对于做国密改造、设备研发或算法检测的工程师来说,理解这份规范是绕不开的一步。
从整体结构看,标准围绕密钥对、数据转换、数据格式、预处理、计算过程、ID 默认值这几个模块展开。下文按章节顺序逐一拆解。
密钥对定义与数据转换
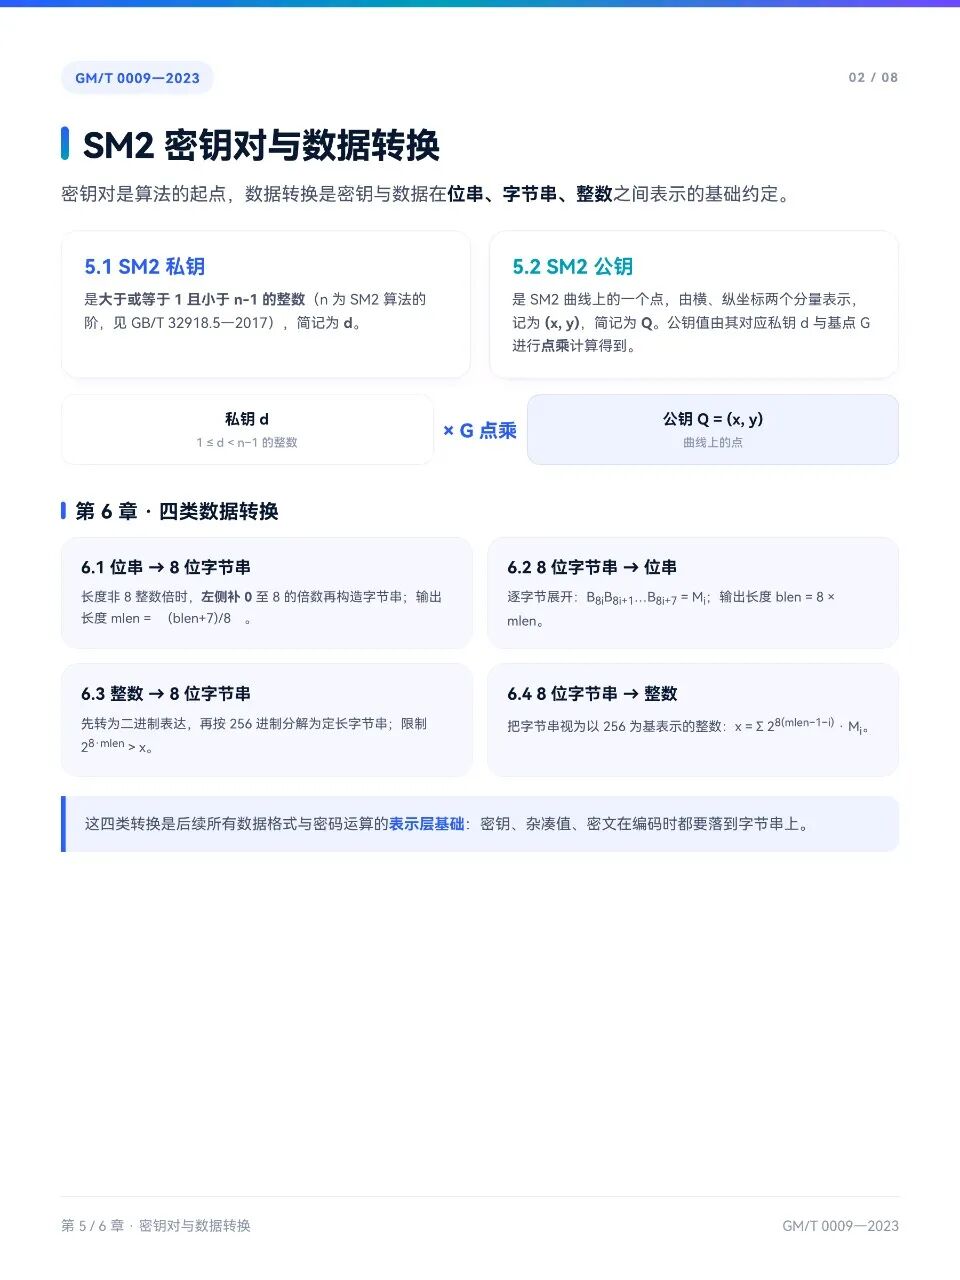
SM2 的密钥对是整套算法的起点。私钥 d 是一个满足 1 ≤ d < n-1 的整数,其中 n 是 SM2 曲线的阶,定义见 GB/T 32918.5-2017。公钥 Q 则是曲线上的一个点,由横纵坐标 (x, y) 表示,通过私钥 d 与基点 G 做点乘得到。这个关系决定了私钥一旦泄露,公钥对应的安全性就完全丧失。
标准第 6 章定义了四类基础数据转换,它们是后续所有数据格式和密码运算的表示层基础:
- 位串 → 8 位字节串:长度不是 8 的整数倍时,左侧补 0 至 8 的倍数,输出长度
mlen = (blen+7)/8。
- 8 位字节串 → 位串:逐字节展开,输出长度
blen = 8 × mlen。
- 整数 → 8 位字节串:先转二进制表达,再按 256 进制分解为定长字节串,限制条件为
2^(8·mlen) > x。
- 8 位字节串 → 整数:把字节串视为以 256 为基的整数,
x = Σ 2^(8(mlen-1-i)) · Mi。
这些转换规则看似基础,但在跨平台联调时,位序和字节序的理解偏差往往是导致互操作性失败的根源。对国密算法实现和 渗透测试 中密码模块的分析来说,这些编码细节同样是需要精确掌握的内容。
四类数据格式
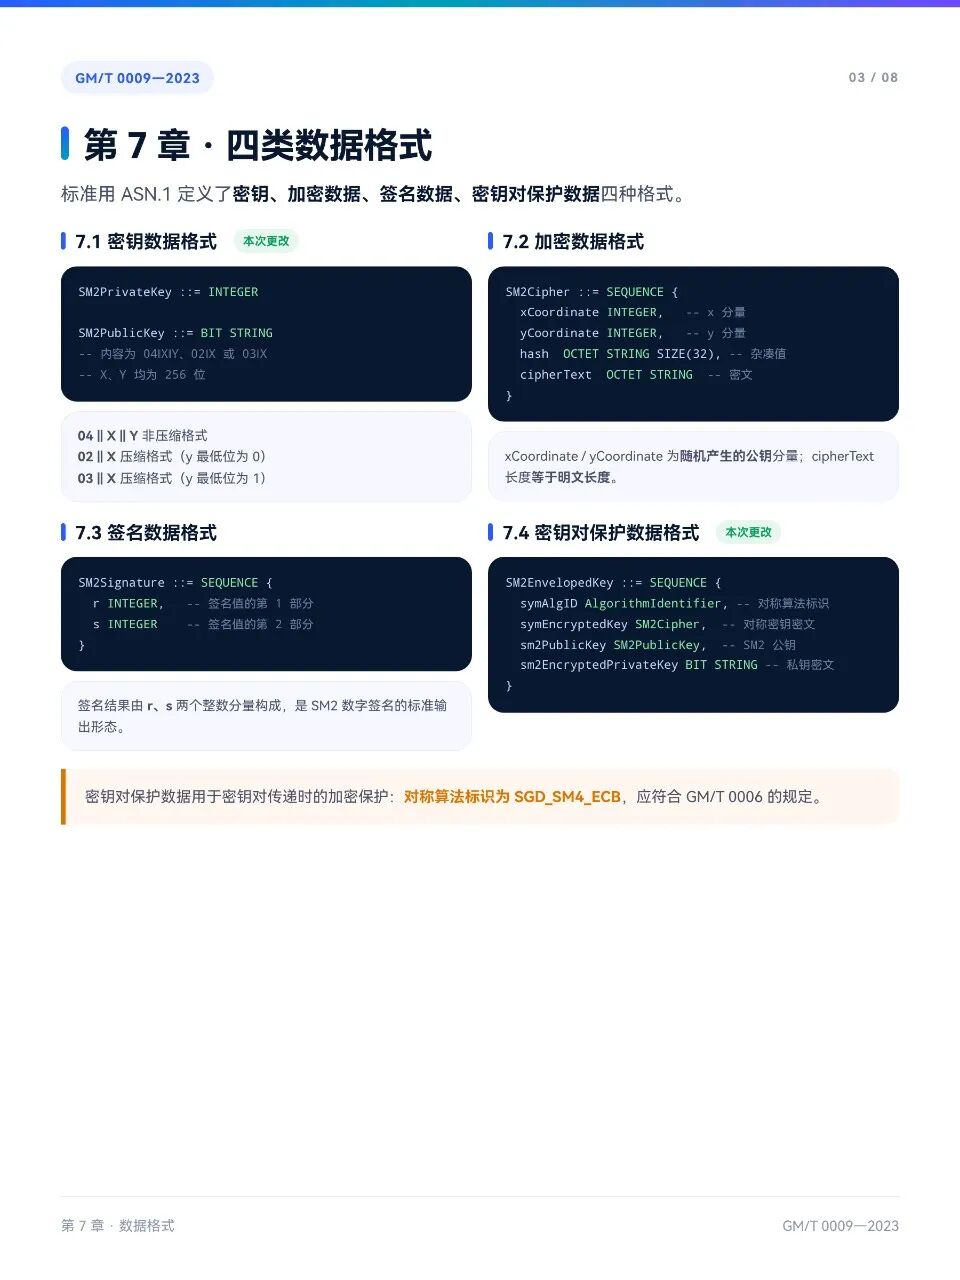
标准第 7 章用 ASN.1 定义了密钥、加密数据、签名数据、密钥对保护数据四种格式。这部分的修订是 2023 版的重要变化之一。
密钥数据格式中,私钥直接定义为整数:
SM2PrivateKey ::= INTEGER
公钥则用 BIT STRING 表示,内容为 04||X||Y、02||X 或 03||X,其中 X、Y 均为 256 位。04 开头表示非压缩格式,02 和 03 开头表示压缩格式,区别在于 y 坐标的最低位是 0 还是 1。
加密数据格式的定义如下:
SM2Cipher ::= SEQUENCE {
  xCoordinate INTEGER,      -- x 分量
  yCoordinate INTEGER,      -- y 分量
  hash OCTET STRING SIZE(32),  -- 杂凑值
  cipherText OCTET STRING      -- 密文
}
xCoordinate 和 yCoordinate 是随机产生的公钥分量,cipherText 的长度与明文长度相等。
签名数据格式由 r 和 s 两个整数分量构成:
SM2Signature ::= SEQUENCE {
  r INTEGER,  -- 签名值的第 1 部分
  s INTEGER   -- 签名值的第 2 部分
}
密钥对保护数据格式用于密钥对传递时的加密保护,结构如下:
SM2EnvelopedKey ::= SEQUENCE {
  symAlgID AlgorithmIdentifier,     -- 对称算法标识
  symEncryptedKey SM2Cipher,        -- 对称密钥密文
  sm2PublicKey SM2PublicKey,        -- SM2 公钥
  sm2EncryptedPrivateKey BIT STRING -- 私钥密文
}
这里的对称算法标识为 SGD_SM4_ECB,需符合 GM/T 0006 的规定。SM4 与 SM2 的组合使用,是国密体系中典型的"非对称加密保护对称密钥、对称加密保护数据"的混合加密思路。
预处理:Z 值与 H 值
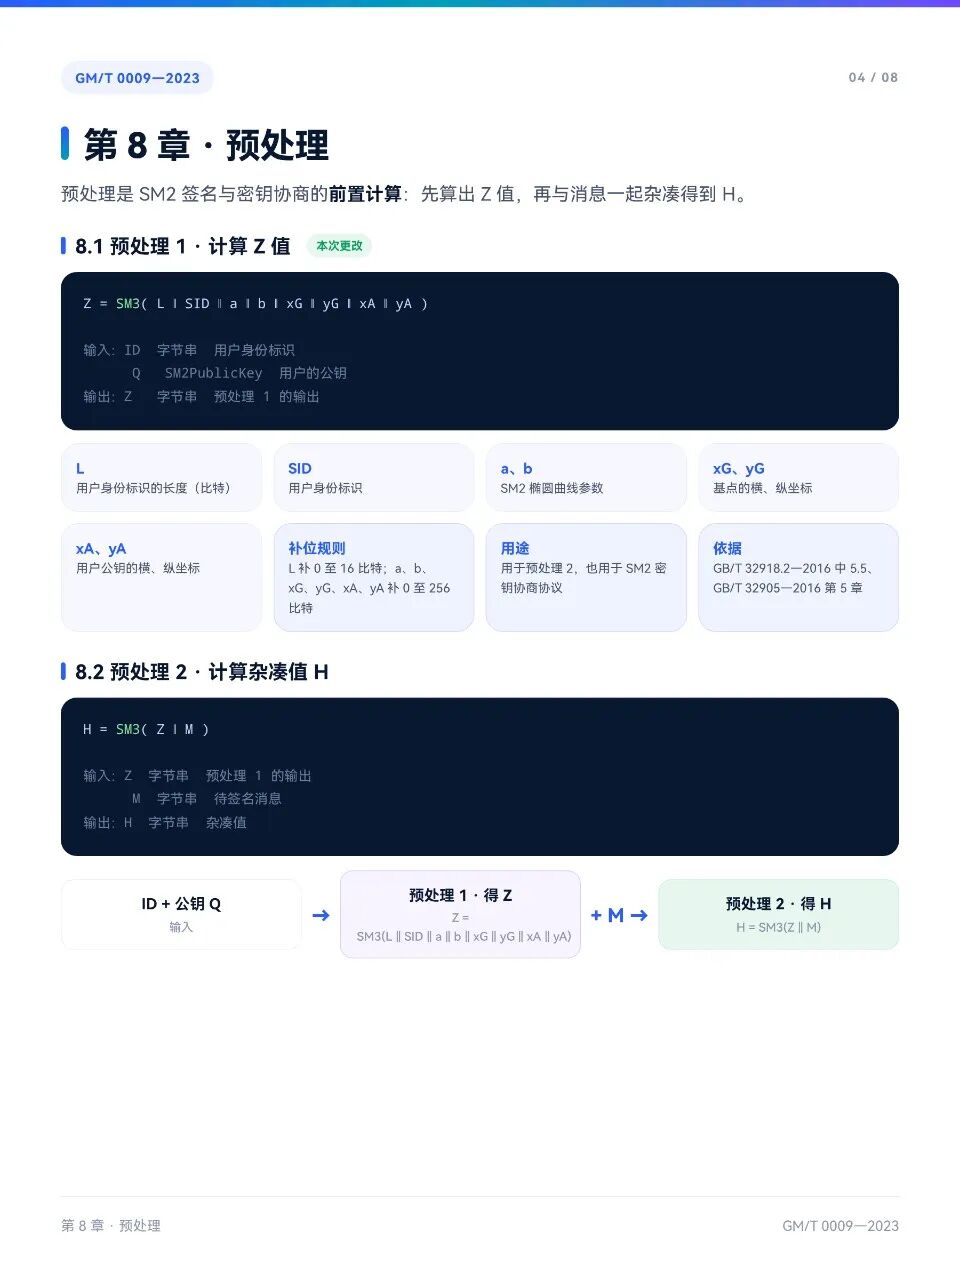
预处理是 SM2 签名与密钥协商的前置计算,直接决定了签名结果和协商密钥的一致性。流程分为两步。
预处理 1:计算 Z 值。计算公式为:
Z = SM3(L || SID || a || b || xG || yG || xA || yA)
其中 L 是用户身份标识的比特长度,补 0 至 16 比特;SID 是用户身份标识;a、b 是 SM2 椭圆曲线参数;xG、yG 是基点的横纵坐标;xA、yA 是用户公钥的横纵坐标。除 L 外,a、b、xG、yG、xA、yA 都补 0 至 256 比特。这个步骤的依据来自 GB/T 32918.2-2016 的 5.5 节和 GB/T 32905-2016 的第 5 章。
预处理 2:计算杂凑值 H。公式为:
H = SM3(Z || M)
M 是待签名消息的字节串。整个流程可以概括为:ID 与公钥 Q 进入预处理 1 得到 Z,Z 与消息 M 进入预处理 2 得到 H。之所以要先算 Z,本质上是把签名者(或协商方)的身份信息和公钥绑定进杂凑值,防止身份混淆攻击。
在工程实践中,很多 SM2 签名验签失败的案例,最后追溯原因都是 Z 值计算中 ID 或曲线参数不一致。如果你在排查 国密算法的互操作问题 ,建议先比对双方的 Z 值输出是否完全一致。
五大计算过程
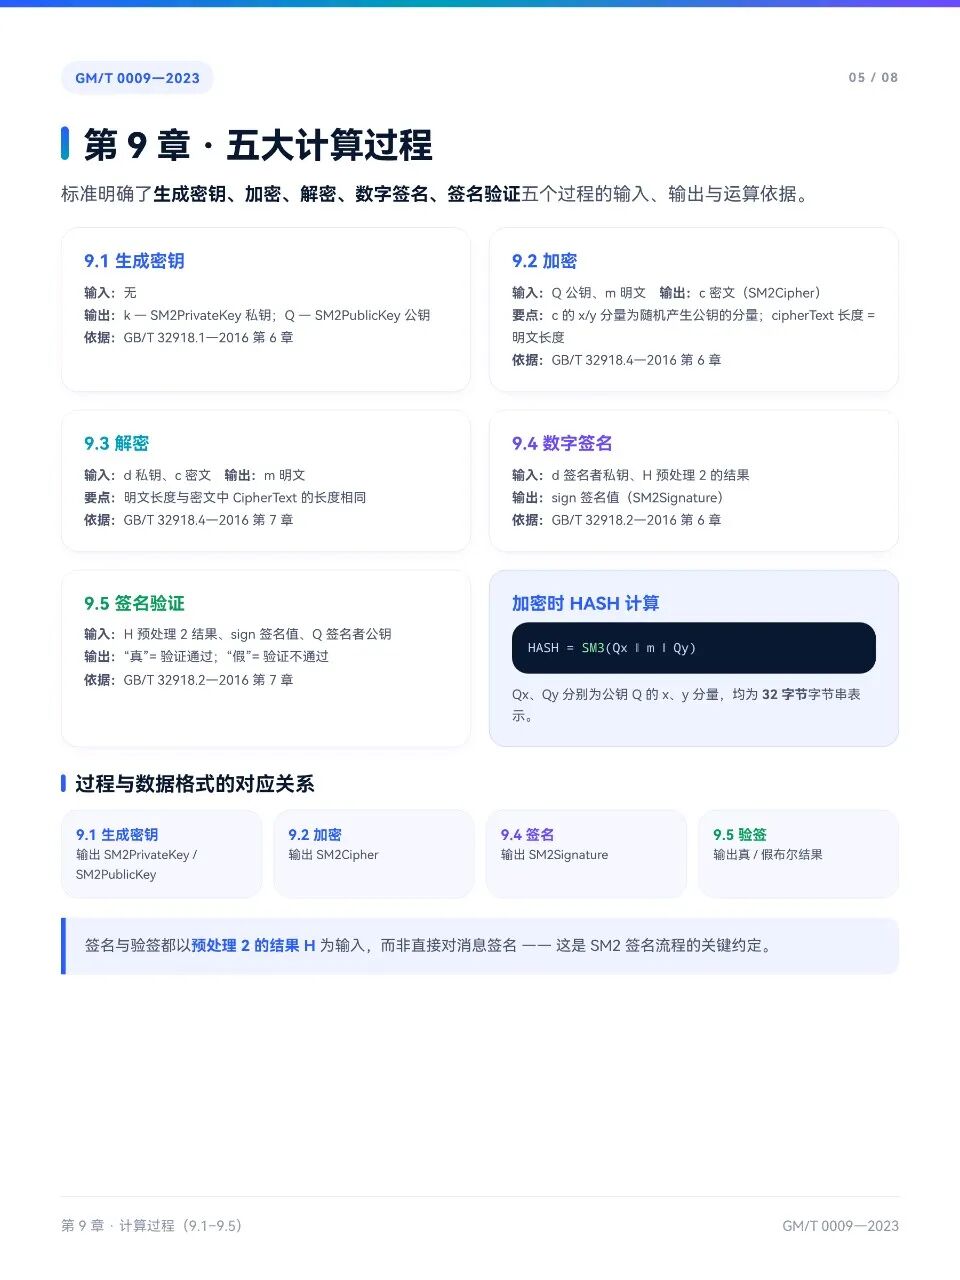
标准第 9 章明确了生成密钥、加密、解密、数字签名、签名验证五个过程的输入、输出与运算依据:
| 过程 |
输入 |
输出 |
依据 |
| 生成密钥 |
无 |
k(SM2PrivateKey 私钥)、Q(SM2PublicKey 公钥) |
GB/T 32918.1-2016 第 6 章 |
| 加密 |
Q 公钥、m 明文 |
c 密文(SM2Cipher) |
GB/T 32918.4-2016 第 6 章 |
| 解密 |
d 私钥、c 密文 |
m 明文 |
GB/T 32918.4-2016 第 7 章 |
| 数字签名 |
d 签名者私钥、H 预处理 2 结果 |
sign 签名值(SM2Signature) |
GB/T 32918.2-2016 第 6 章 |
| 签名验证 |
H、sign、Q 签名者公钥 |
"真" = 验证通过;"假" = 验证不通过 |
GB/T 32918.2-2016 第 7 章 |
加密时有一个需要注意的 HASH 计算公式:HASH = SM3(Qx | m | Qy),其中 Qx、Qy 分别为公钥 Q 的 x、y 分量,均为 32 字节的字节串表示。
一个关键约定是:签名与验签都以预处理 2 的结果 H 为输入,而非直接对消息签名。这意味着如果跳过预处理步骤直接对原文做签名,生成的签名值虽然格式正确,但在标准验签流程下会判为无效。
密钥协商协议
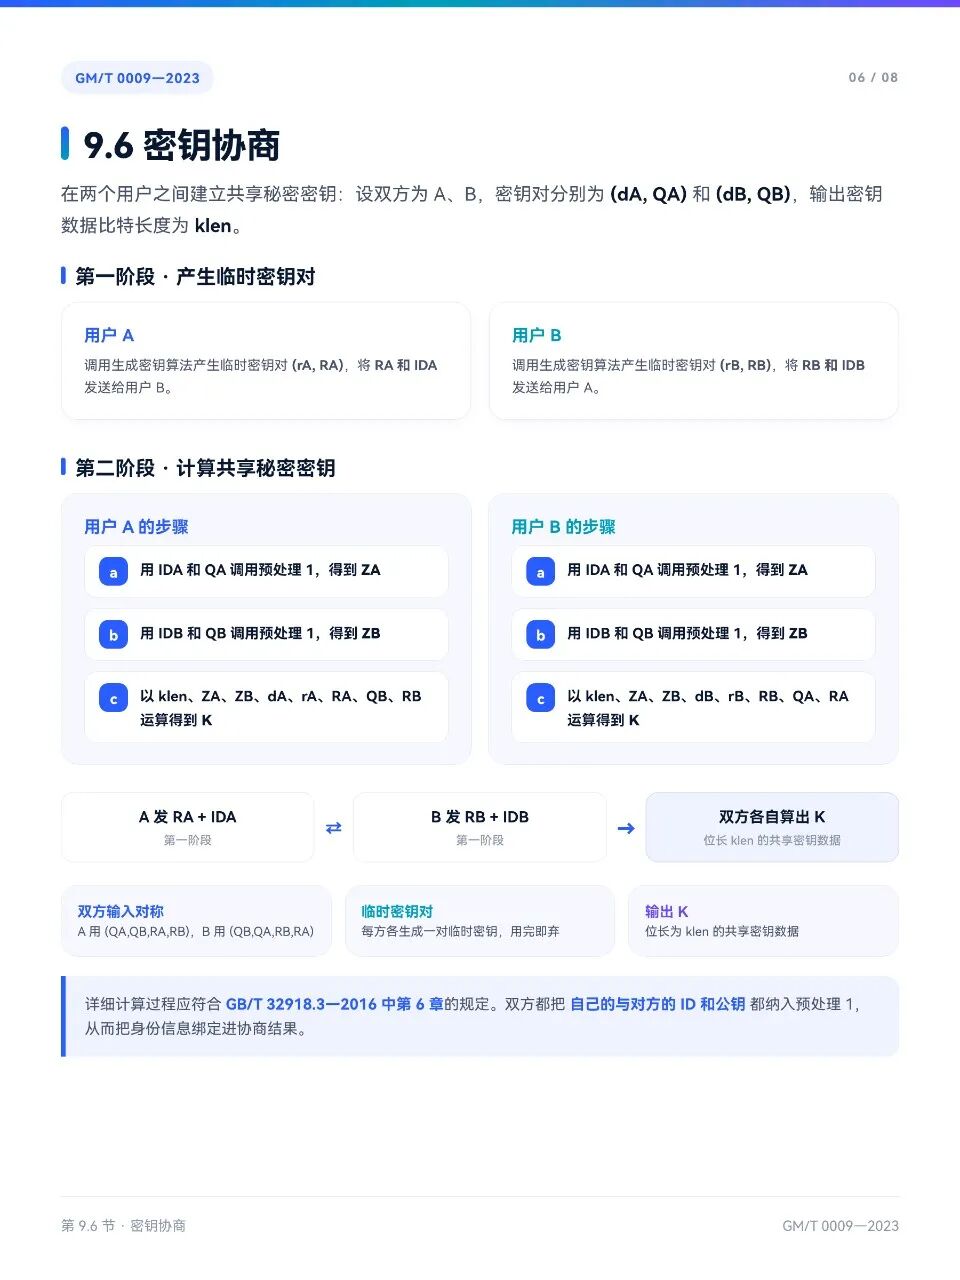
标准 9.6 节定义了 SM2 密钥协商流程。设双方为 A、B,密钥对分别为 (dA, QA) 和 (dB, QB),输出密钥数据比特长度为 klen。
第一阶段:产生临时密钥对。用户 A 调用生成密钥算法产生临时密钥对 (rA, RA),将 RA 和 IDA 发送给 B;用户 B 同样产生 (rB, RB),将 RB 和 IDB 发送给 A。临时密钥对用后即弃,每轮协商都要重新生成。
第二阶段:计算共享秘密密钥。用户 A 的步骤为:
- 用
IDA 和 QA 调用预处理 1,得到 ZA
- 用
IDB 和 QB 调用预处理 1,得到 ZB
- 以
klen、ZA、ZB、dA、rA、RA、QB、RB 运算得到 K
用户 B 的步骤对称,最终双方各自算出相同位长 klen 的共享密钥数据 K。详细计算过程应符合 GB/T 32918.3-2016 第 6 章的规定。
这个协议的设计要点在于:双方都把自己的与对方的 ID 和公钥纳入预处理 1,从而把身份信息绑定进协商结果。临时密钥对的使用则提供了前向安全性保障。
用户身份标识 ID 的默认值
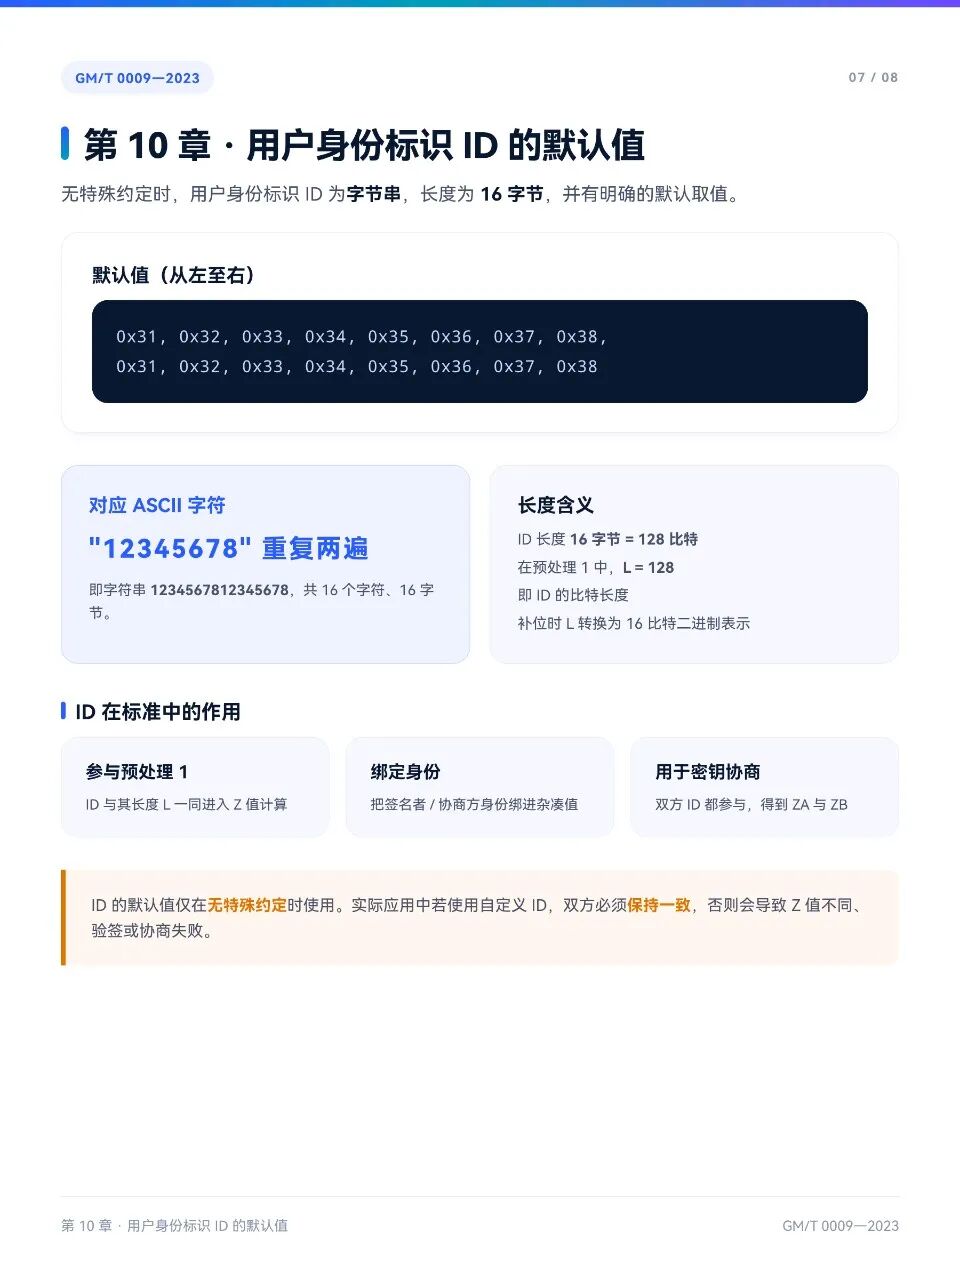
标准第 10 章给出了一个容易被忽略但影响重大的细节:无特殊约定时,用户身份标识 ID 的默认值。
默认 ID 是 16 字节的字符串,十六进制表示为:
0x31, 0x32, 0x33, 0x34, 0x35, 0x36, 0x37, 0x38,
0x31, 0x32, 0x33, 0x34, 0x35, 0x36, 0x37, 0x38
对应的 ASCII 字符就是字符串 1234567812345678,共 16 个字符、16 字节。长度含义上,ID 长度为 16 字节即 128 比特,在预处理 1 中 L = 128,补位时 L 转换为 16 比特的二进制表示。
ID 在标准中的作用贯穿始终:参与预处理 1 的 Z 值计算、把签名者或协商方身份绑进杂凑值、在密钥协商中双方 ID 都参与得到 ZA 与 ZB。实际应用中若使用自定义 ID,双方必须完全一致,否则 Z 值不同,验签或协商必然失败。这也是为什么跨系统对接时,ID 的约定需要提前写进接口文档。
与 GM/T 0009-2012 的主要差异
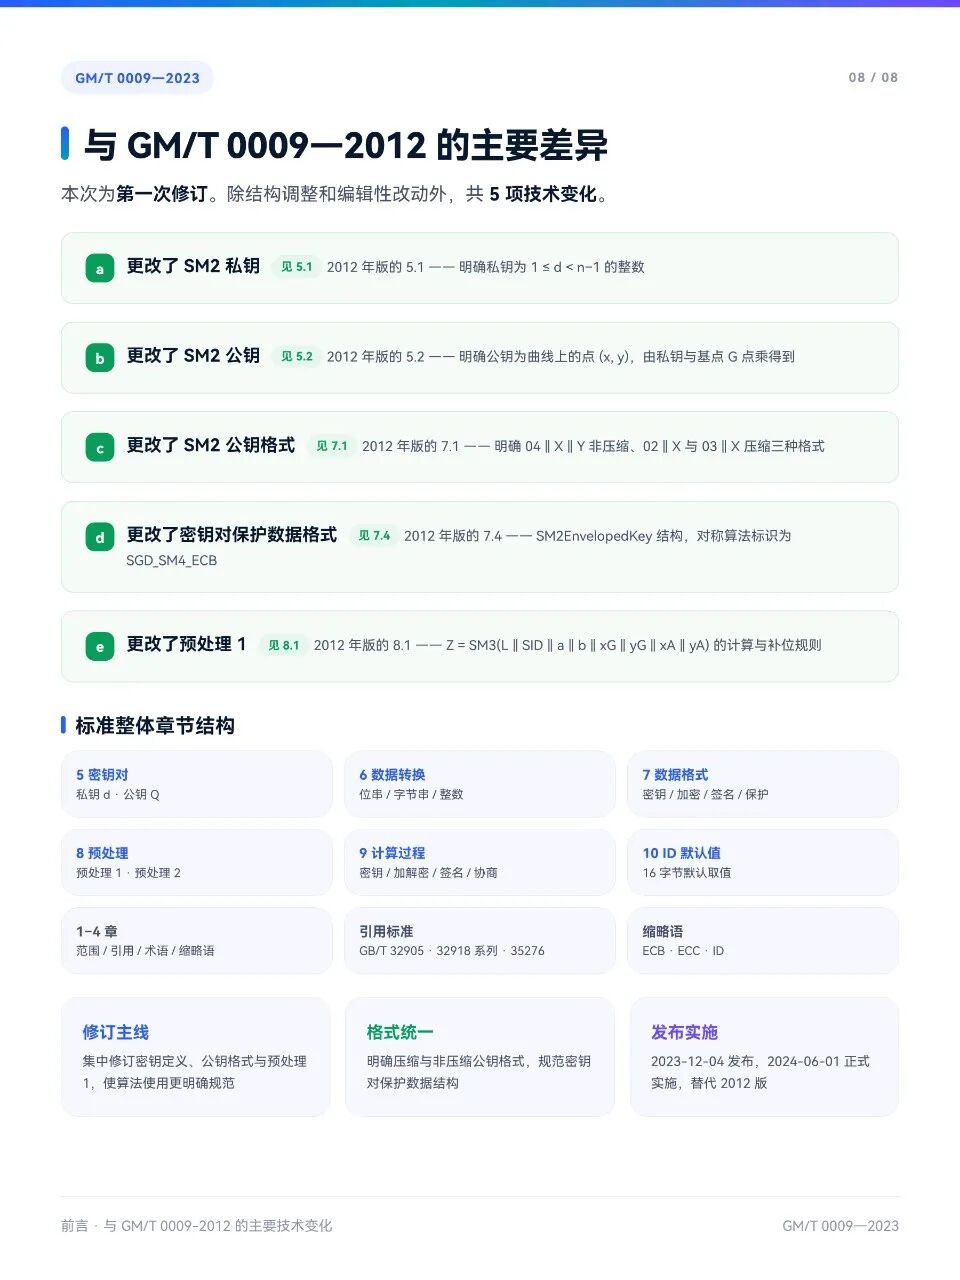
2023 版为第一次修订,除结构调整和编辑性改动外,共涉及 5 项技术变化:
- a. 更改了 SM2 私钥(5.1 节):明确私钥为满足
1 ≤ d < n-1 的整数。
- b. 更改了 SM2 公钥(5.2 节):明确公钥为曲线上的点
(x, y),由私钥与基点 G 点乘得到。
- c. 更改了 SM2 公钥格式(7.1 节):明确
04||X||Y 非压缩、02||X 与 03||X 压缩三种格式。
- d. 更改了密钥对保护数据格式(7.4 节):引入
SM2EnvelopedKey 结构,对称算法标识为 SGD_SM4_ECB。
- e. 更改了预处理 1(8.1 节):明确
Z = SM3(L || SID || a || b || xG || yG || xA || yA) 的计算与补位规则。
修订的主线是集中解决旧版中密钥定义模糊、公钥格式不统一、预处理规则不清晰的问题。对于从 2012 版迁移的系统,重点要核对公钥编码格式和预处理 1 的实现是否按新规调整。
整体来看,这份标准虽然篇幅不大,但每一章都对应着实操中的关键约定。密钥格式决定了互通性,预处理决定了签名的正确性,ID 默认值决定了跨系统的一致性。做国密开发时,把这三处吃透,能避开大多数联调阶段才会暴露的问题。
 发表于 2 小时前
|
查看: 3|
回复: 0


