经常和 Agent 打交道,或者重度使用 Claude Code、Cursor 的开发者,几乎都会撞上一道"膨胀棘轮":为了让模型记住团队规范和历史踩坑,我们在 CLAUDE.md 或 System Prompt 里越塞越多。几周过去,常驻指令膨胀到数千 Token——哪怕只改一个拼写错误,这笔账单都得原样照付。
比账单更麻烦的是注意力稀释。上下文窗口再大,模型的注意力也是稀缺资源。常驻指令堆积如山时,真正要处理的代码逻辑反而被挤到角落。新加一条规则,之前立下的规矩往往就被莫名其妙地忽略掉了。
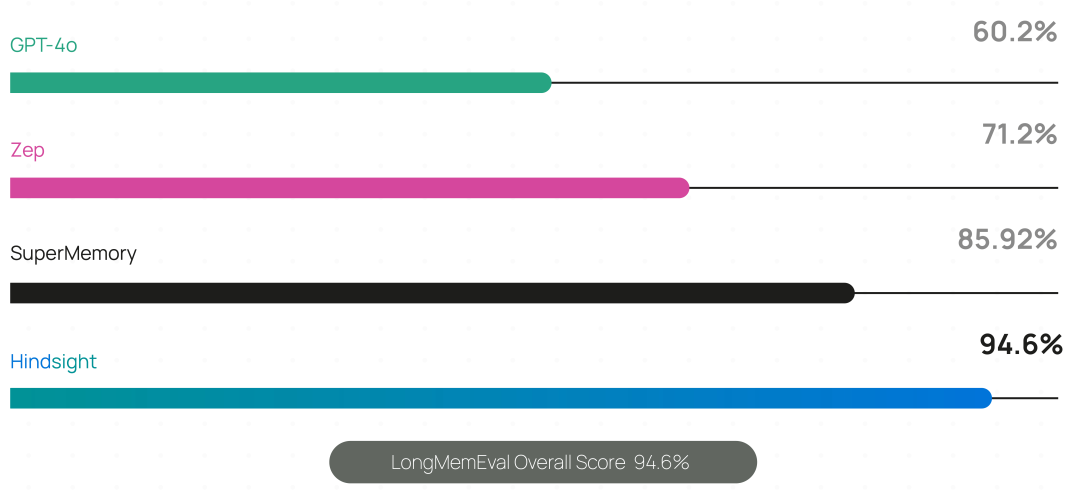
在 GitHub 突破 3.7 万 Star 的开源项目 Hindsight,核心就是为了击碎这个死局。它没有寄希望于"无限上下文",也没有走"把对话直接丢进向量库做粗暴检索"的老路,而是用一套仿生认知架构,把 Agent 的记忆机制重构了一遍。
项目卡片
- 项目:Hindsight[1]
- 状态:v0.10.1 / 37.8k Stars / MIT 开源 / LongMemEval SOTA
- 一句话判断:一套仿生认知架构的智能体长期记忆引擎,将动态项目知识从常驻 Prompt 中彻底解耦,兼具 4 路混合召回、信念自动进化与极低接入成本。
为什么不能把所有教训都塞进常驻指令?
我们在 Prompt 里堆积的内容,混杂了两种性质截然不同的东西。
第一种是指令(Instructions):无论执行什么任务都必须遵守的硬性红线,例如"禁止修改生产配置"。这类规则是无条件的,理应永远常驻在 Prompt 中。
第二种是知识(Knowledge):项目背景脉络、上周为何回退接口、两个月前踩过的网络重试坑。知识天然是场景化的——改前端样式时无需加载支付超时教训。把知识塞进常驻 Prompt,等于为了取用 5% 的细节,让每次调用都替剩下 95% 的部分买单。
Hindsight 将知识剥离至独立的记忆库(Bank),并在检索端引入了严格的预算约束(Token Budget)。它不搞"捞出多少算多少"的粗放返回,而是在调用时显式限定召回体量。开发者可按档位指定拉取预算,系统甚至能根据请求的 max_tokens 动态自适应调整。
更关键的是召回精度。传统向量搜索在面对时效和特定名词时极易失效,Hindsight 采用四路并行召回:语义向量抓概念、BM25 抓精确关键词、图谱网络顺着实体和因果链追踪、时间过滤器剔除过期区间。四路结果经过互易重排融合(RRF)与交叉编码器打分,最终裁剪出高密度的精准上下文。改变量名时只消耗极少检索量,遇到复杂系统重构才拉取大块背景,两者成本互不绑架。
为什么说传统向量 RAG 会把记忆变成垃圾场?
如果把对话记录原封不动存进向量数据库,用普通 RAG 做记忆,很快会遭遇更严重的崩塌:记忆缺乏状态演进与信念合并机制。
典型场景如成员状态变更:Alice 上个月是后端主力,这个月升职为架构师并转战海外业务。如果系统仅做向量切片存储,当被问及"Alice 当前负责什么"时,向量检索会同时把两段相似记录捞出丢给大模型。大模型在相互矛盾的切片面前,要么陷入逻辑混乱,要么随机产生幻觉。
Hindsight 在底层设立了四层认知结构,核心正是为了解决"信念进化"问题:
- 世界事实(World Facts):客观世界常识与通用规则;
- 亲身经历(Experiences):Agent 自身的交互轨迹与操作反馈;
- 沉淀观察(Observations):核心去重信念层。系统在后台将零散事实合并为带有证据链(包含精准引用与验证计数 proof count)的观察记录。新信息到来时,动态增强、修正或弱化既有信念,而非粗暴覆盖或堆积;
- 思维模型(Mental Models & Knowledge Pages):针对高频问题(如"用户偏好是什么")预先生成的自演进知识页。后台像维基百科一样自动更新答案,Agent 启动时只需单次常规数据库读取,零 LLM 消耗即可直接加载结论。
这种设计让 Agent 的记忆随着交互深入变得愈发精炼,而不是随着时间沦为碎片横飞的信息垃圾场。
开发者接入:极简包装与零配置试玩
架构看起来复杂,但 Hindsight 在工程落地上把门槛降得相当彻底。如果你正在维护基于 OpenAI、Anthropic 或 LiteLLM 的现有 Agent,接入只需两行代码:
from openai import OpenAI
from hindsight_litellm import wrap_openai

# 包装现有客户端,指定记忆库隔离 ID
client = wrap_openai(
    OpenAI(),
    bank_id="user-project-alpha",
    hindsight_api_url="http://localhost:8888",
)

# 正常调用:请求前自动并发 Recall 注入背景,完成后异步 Retain 沉淀记忆
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "梳理一下我们当前的重试策略"}],
)
对于使用终端编码助手的个人开发者,一条命令即可为本地环境中的 Claude Code、Cursor CLI、GitHub Copilot CLI 等 10 多款工具自动挂载记忆体系:
npx @vectorize-io/hindsight-coding-agents install all
安装后,它会根据 Git 提交历史与日常协作会话自动建立项目专属的 memory bank,无需手动写脚本同步。
如果是本地评测或不想常驻 Docker 和 PostgreSQL 服务,Hindsight 提供了基于内置嵌入式数据库 pg0 的整合包。直接执行 pip install hindsight-all,就能在纯 Python 上下文中通过 with HindsightServer(...) 启动即用即毁的自包含服务,上手摩擦极低。
此外,每个记忆库都原生暴露了一个标准的 MCP 端点(http://localhost:8888/mcp/{bank_id}/)。只要你的 IDE 或宿主支持 MCP,就能无缝挂载 retain、recall 与高阶综合推演的 reflect 工具。
诚实边界:什么场景千万不要用它?
在把 Hindsight 引入技术栈之前,必须对其边界保持清醒认知。
首先是静态问答场景不适用。如果只是做产品说明书或固定技术文档问答,老老实实用常规切片 RAG 即可。Hindsight 强在"动态演进、持续交互与多轮事实修正",跑静态数据既拖慢响应,又白白浪费后台抽取的 Token。
其次是写入链路的延迟与开销代价。每一次调用 retain 存入记忆,背后都要经过大模型对实体、因果关系和时间戳的严格解析与规范化。如果业务场景要求每秒数百次高并发毫秒级同步写入,直接把请求阻断在 retain 上会导致服务雪崩,必须使用异步任务队列解耦处理。
最后是本地小模型的推理能力门槛。虽然 Hindsight 允许对接 Ollama 等本地接口,但其四路召回重排与观察层事实提取,极度依赖底层 LLM 的结构化指令遵循能力。在实际测试中,如果使用 7B 以下弱模型充当提取引擎,经常会解析出残缺的关系图谱或误判实体,导致记忆质量严重退化。如果打算自建全本地集群,建议至少配置能力过硬的开源旗舰模型或专业提取端点。
引用链接
[1] Hindsight: https://github.com/vectorize-io/hindsight
 发表于 13 小时前
|
查看: 6|
回复: 0


