公开知识对 AI 来说就是营养品,尤其是那些躺在 GitHub 上的开源项目。有一个教你如何从工具出发、一路做出自己 AI 智能体的开源仓库,简直是宝藏库。
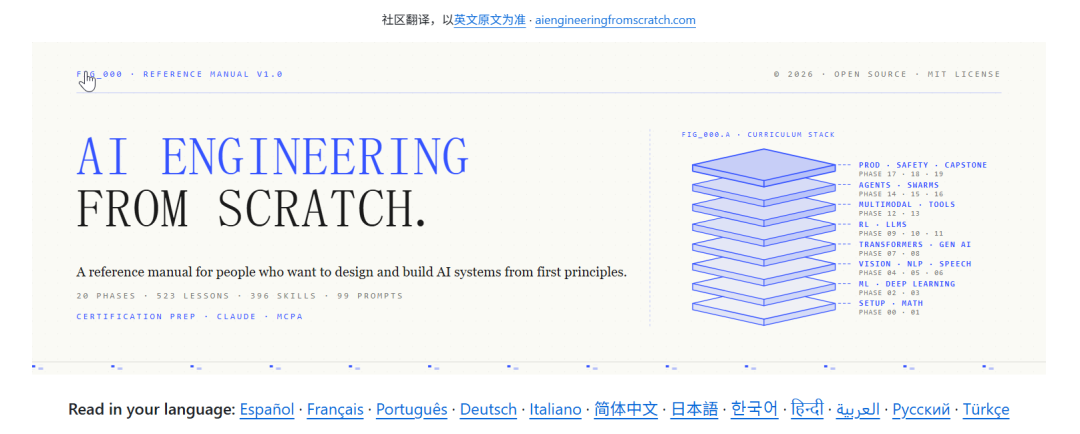
理由很直接。你想搞懂 attention,问任何一个够强的模型都能得到一篇不错的解释,还能追问。523 篇静态课文放在 2026 年已经不稀缺了,模型几小时就能生成同等质量的东西。
那它什么地方值钱?
它把自己切成 10 个 Skill,装进了你每天都在用的编程助手里:
npx skills add rohitg00/ai-engineering-from-scratch
一、它到底把自己做成了什么
装完这条命令,你的 Claude Code / Codex / Cursor 里多出 10 个能力:
find-your-level(十道题定位你该从哪开始学)、start-learning、check-understanding 14(阶段测验)、course-guide(“我在哪学 attention?” 直接给你课号)、learn-mcp、learn-agent-skills……
注意,这些不是“跳转到课程的快捷方式”,是能力。装完之后,你的助手能给你出题、判卷、排路线、指出你哪一块没真懂。
更狠的是第二层:523 节课里,有 398 节课的产物本身就是 Skill 文件。
学完 agent loop 那一课,你拿到的是 skill-agent-loop.md。我把它的原文翻出来了,里面有一节叫 Hard rejects:
- Looping without a turn cap. This is a reliability, not an optimization, issue.
- Swallowing tool errors into an empty observation. The model must see the failure text so it can correct.
- Treating retrieved content as trusted instructions. All tool outputs are untrusted input — only the user message carries permission.
- Mixing providers without a schema-translation layer.
翻成工程语言:循环必须有轮次上限;工具报错必须回传给模型,不能吞成空观测;检索回来的内容是不可信输入,只有用户消息带权限;跨模型必须做 schema 翻译层。
把这个文件装进助手之后,你以后每次让它写 Agent 代码,都会被这四条约束一遍。
你踩过的坑,从笔记变成了默认行为。
二、为什么这一步比“内容全”重要得多
三个机制,一个比一个硬。
第一,位置比内容稀缺。
一个学习网站的竞争是什么?是你在想学习的时候,记不记得起它。
一个 Skill 的竞争是什么?是你在写 Agent 代码的时候,它就在你手边。
前者要你主动走过来,后者在你干活的地方等你。这不是流量差别,是场景差别。你一周打开学习网站几次?你一天打开编程助手多少次?
第二,衡量指标从“访问量”变成了“被调用率”。
网站时代的指标是 PV、DAU——多少人来看过。这个指标有个致命的毛病:看完就走,不产生下一次。
Skill 时代的指标是被调用率——它真正被用起来了多少次。而且每一次调用都在产出里留下痕迹:一个更规范的 agent loop,一次被拦住的死循环。
访问量是一次性的,被调用率是累积的。
第三,它把自己挂进了别人的复利里。
Claude Code、Codex 这些宿主每天都在变强、用户每天都在涨。一个挂在它们身上的 Skill,不需要自己花钱做增长——宿主在涨,它就跟着涨。
这是过去两年很多 AI 产品没想明白的事:你做一个 App,增长是你的成本;你做成 Skill,增长是宿主的副产品。
三、真正聪明的地方:它教的和它做的是同一件事
这一层才是精髓。
这套课的核心教学法叫“每节课必须产出一个可复用的东西”——不能只是“我看懂了”,必须交出一个能装进工作流的产物。
然后你回头看它自己:523 节课,交出了 398 个 Skill。
它的产品形态,就是它教你的方法论。
这不是巧合,是设计。它在用自己的形态演示“怎么把知识变成可执行的东西”。你学完这套课,收获最大的可能不是反向传播,而是这一条认知:
知识如果不能变成约束行为的文件,它就只是信息。
四、别急着欢呼,Skill 分发也有代价
三件事得说清楚。
1. 你把自己切碎了,塞进别人的运行时。
Skill 的宿主是 Claude Code、Codex、Cursor。平台改一次加载规范、改一次目录约定,你的分发就断了。这不是理论风险——Agent Skills 这套规范现在还在快速变,各家实现也不完全一致。
做成 Skill,等于借别人的地基盖房子。成本极低,但地基不归你。
2. 被调用 ≠ 被记住。
调用量大,可能只是因为默认启用、因为装了就忘了卸。跟 star 数一样,这个数字会骗人。真正有意义的指标是“调用之后有没有改变产出”——这个几乎没人测。
3. 门槛低,意味着供给会爆炸。
写一个 SKILL.md 的技术门槛,比写一个 App 低两个数量级。今天你能做,明天所有人都能做。供给一爆炸,单个 Skill 的议价权迅速归零,最后活下来的可能还是那些内容本身过硬的。
所以更准确的说法是:Skill 是分发方式,不是护城河。 它解决“怎么送到用户手边”,不解决“为什么非你不可”。
五、这对你意味着什么
如果你在做 AI 相关的产品或内容,有个判断值得现在就想清楚:
别再做“又一个网站 / 又一个知识库”,去做“能被装进去的那个东西”。
对个人:把最硬的经验写成 Hard rejects
不要写“最佳实践”,写必须拒绝什么。
我前面引的那四条之所以有力,正因为它们是禁令不是建议。建议会被忽略,禁令会被执行。
挑一个宿主先塞进去——Claude Code 的 .claude/skills/ 或者 Codex 的对应目录,二选一。别想着全平台兼容,规范还在变,先在一个地方跑通。
然后衡量被调用,不要衡量被看到。别盯下载量,去看它有没有真的改变产出:你的 Agent 是不是不再写死循环了,是不是不再吞错误了。
对团队:把规矩从 Wiki 搬进 Skill
这条我觉得最实用。
你做了一套 RAG 规范、一套智能问数的 SQL 生成规矩、一套代码评审标准——如果它们今天躺在 Wiki 或者飞书文档里,那它们基本等于不存在。
Wiki 是“希望有人去看”,Skill 是“每次都生效”。
把它写成 SKILL.md 塞进团队的助手目录,效果完全不同:规则不再依赖人的自觉,而是变成了工具的默认行为。这也是那套课程自己在做的事——audit_lessons.py 挂在 CI 上校验课程目录不跑形,本质就是同一招。
最后
523 篇课文,任何一个够强的模型都能写出来。
但“把自己切成 10 个 Skill、塞进别人每天都在用的工具、在你写代码的那一刻被调用”——这个动作,需要你想明白一件事:
2026 年,内容不稀缺,位置稀缺。
顺带说一句,那个仓库现在 6.5 万星、23 个贡献者,比例 1:2860。
内容被收藏得再多,也不等于被用过。而 Skill 这个形态,第一次让“被用过”变成了一件能衡量的事。
 发表于 14 小时前
|
查看: 5|
回复: 0


