旧手机能跑模型之后,还得能放心地一直开着。
抽屉里大概都躺着一两部旧手机,卖二手不值几个钱,留着又占地方。前几年我也折腾过几轮,装个监控、当下载机、挂网盘,最后都回抽屉继续吃灰。
直到我看到一个叫 OlliteRT 的项目。它把安卓手机变成一个本地大模型服务器,在局域网里开一个和 OpenAI 一样的接口。电脑、NAS、智能家居系统,只要能填一个 API 地址,就能连上手机里的模型。不碰云服务,不要 API Key,数据不出家门。
它基于谷歌的 LiteRT-LM 运行时,代码前身是谷歌官方的 AI Edge Gallery,用 Kotlin 写的,Apache 2.0 协议。作者给它的定位就一句话:安卓上的 Ollama。
仓库首页实时截图,Star 与 Fork 计数同时可见
但我先不急着夸它能跑模型。手机跑大模型这事,两年前就有人在 Termux 里手搓过了。这篇我想聊的是另一个问题:它凭什么值得你一直开着。
能一直挂着,比能跑起来更难
README 头部,标语与三行兼容性徽标
先看它把什么当成目标。官方 README 的开篇是这么写的:把它想成安卓上的 Ollama,挑一个模型、点一下 Start,你的手机就成了一台服务器。
重点在后半句。Ollama 在电脑上受欢迎,不是因为能跑模型,是因为它把模型管理、端口、常驻、日志这些麻烦事收进了一条命令。OlliteRT 抄的是这一整套,只是把机器换成了抽屉里那台旧手机。
所以它做的事能拆成两层。第一层是能不能跑起来,这层由运行时决定。第二层是能不能被长期信任地挂着,这层要看它有没有开关、仪表、账本和门禁。
能跑起来只是门槛,敢让它 24 小时一直挂着才算个产品。
七款模型摆出来,其实是一张内存对照表
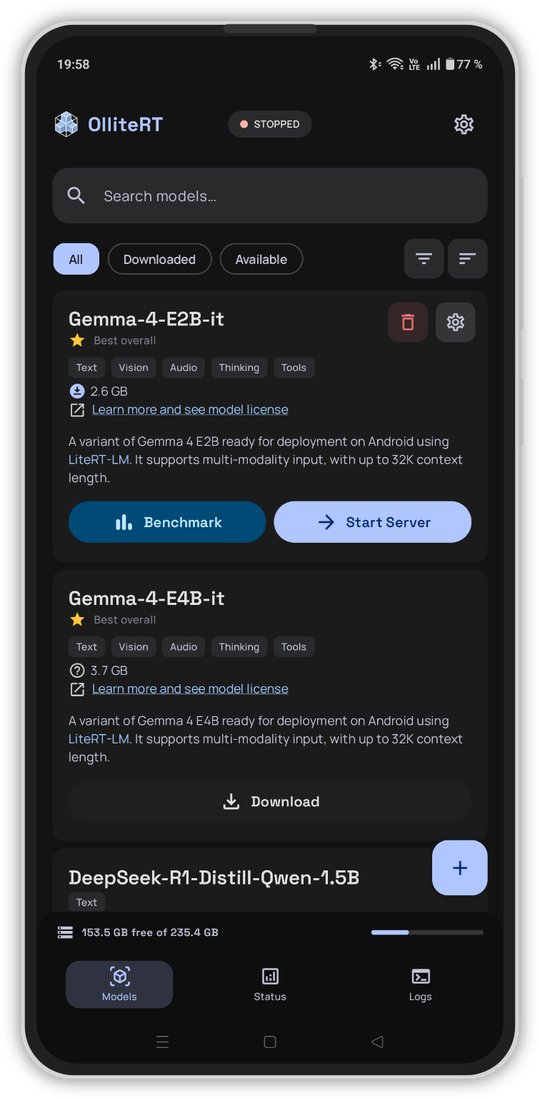
模型列表页,点一下就能下载
App 里内置了七款模型,点一下就能下载。也支持自己导入 .litertlm 文件,或者加一个自定义模型源,给个 JSON 文件或链接就行。
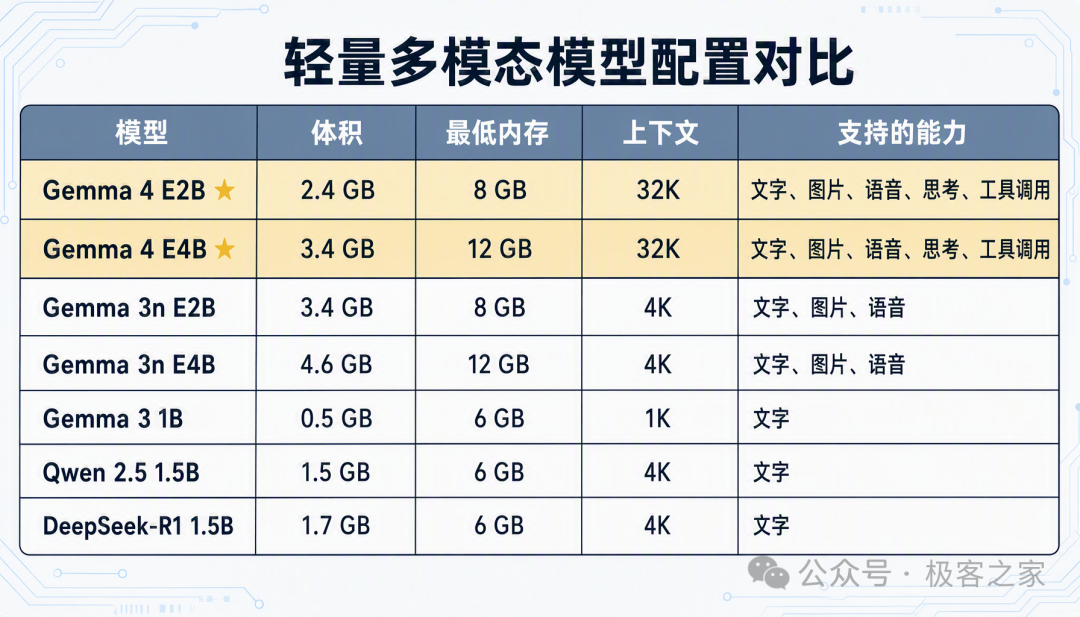
作者整理的七款模型配置对照表
| 模型 |
体积 |
最低内存 |
上下文 |
支持的能力 |
| Gemma 4 E2B |
2.4 GB |
8 GB |
32K |
文字、图片、语音、思考、工具调用 |
| Gemma 4 E4B |
3.4 GB |
12 GB |
32K |
文字、图片、语音、思考、工具调用 |
| Gemma 3n E2B |
3.4 GB |
8 GB |
4K |
文字、图片、语音 |
| Gemma 3n E4B |
4.6 GB |
12 GB |
4K |
文字、图片、语音 |
| Gemma 3 1B |
0.5 GB |
6 GB |
1K |
文字 |
| Qwen 2.5 1.5B |
1.5 GB |
6 GB |
4K |
文字 |
| DeepSeek-R1 1.5B |
1.7 GB |
6 GB |
4K |
文字 |
两列最值得看。一列是最低内存,官方推荐给普通手机的是 Gemma 4 E2B,但它要 8GB;系统本身的最低门槛是 6GB,那个数字只说明装得上,不等于跑得动推荐的那款。6GB 的机器该看底下那三款小模型。
另一列是上下文。Gemma 4 系列给到 32K,Gemma 3n 和三款小模型只有 1K 到 4K。日常聊天够用,塞长文档就吃力。
拿不准的话,App 里有个自带的 Benchmark,先跑一遍再决定下哪个。这个清单也不是死的,能自己导入,也能加模型源。
一条 API 地址背后,服务器该有的东西它都补了
装好以后你看到的是一条地址,形如 http://192.168.1.176:8000/v1。默认端口是 8000,在设置里能改。这条地址背后,是我觉得这个项目最不像玩具的地方。
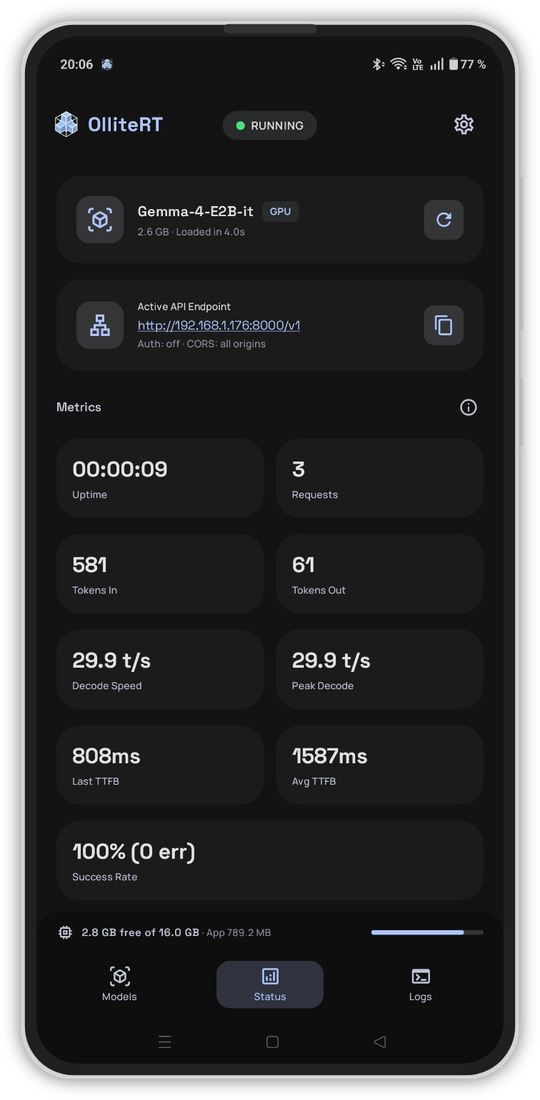
状态页,运行时长、吞吐与成功率实时刷新
状态页上,运行时长、请求数、tokens 吞吐、解码速度、成功率全是实时刷新的。官方截图里 Gemma 4 E2B 解码跑到 29.9 tokens/s,加载只要 4 秒。这组数字没标注机型,只能当参考。
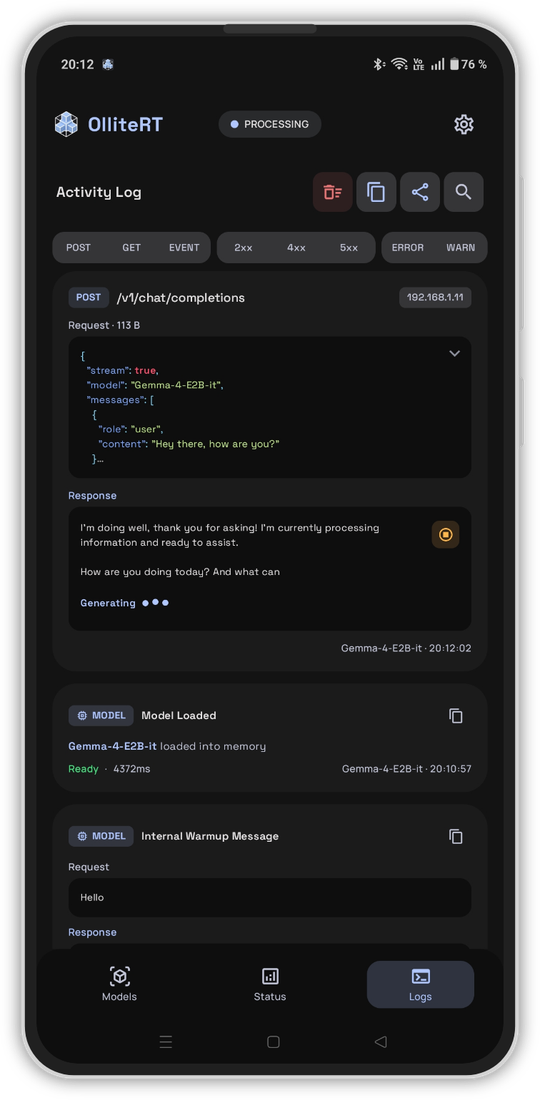
日志页,请求级记录带过滤与搜索
日志记到了请求级。每个请求的请求体和响应体都留下来,支持搜索、过滤、JSON 高亮。哪个客户端发了什么、模型回了什么,翻一遍就清楚。
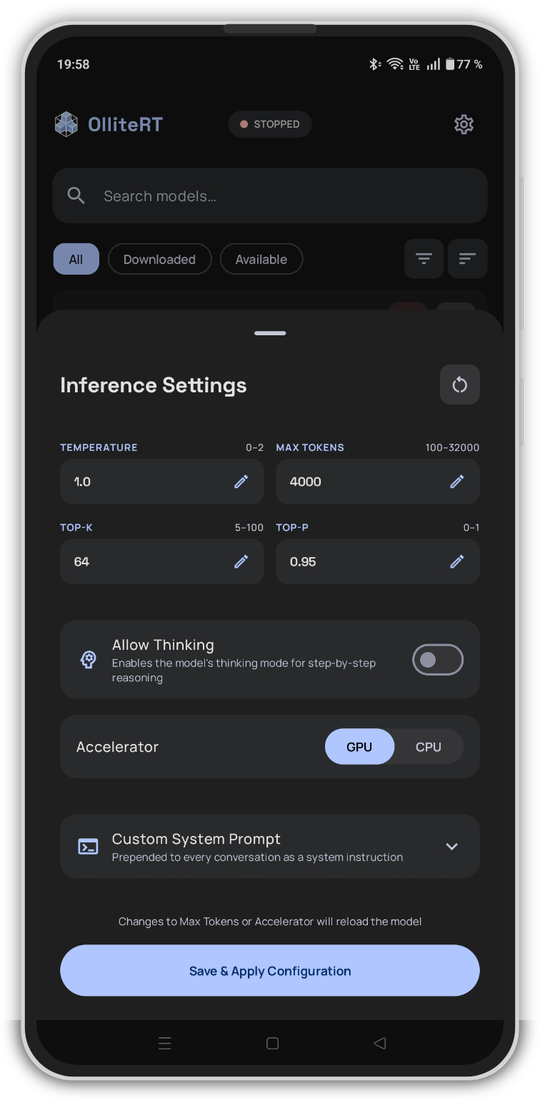
推理参数设置页,每个模型单独存一份
配置项分两组。推理那组,每个模型可单独设温度、最大输出长度、top-k、top-p,还能选跑在 GPU 还是 CPU 上。安全与生命周期那组,监听范围、客户端 IP 白名单、Bearer token 验证、闲置自动卸载模型,都能设。官方 README 专门提醒过,别把服务暴露到公网。
指标还往外开了口子,/metrics 是 29 个 Prometheus 指标,玩 Grafana 的能接进监控大盘。/health 与 /v1/server/config 这些也在,状态的读和写不用自己造轮子。
换客户端基本不用改代码
它对外是标准的 OpenAI 兼容接口,Open WebUI、Home Assistant、Python 脚本、curl,凡是能填 OpenAI 地址的地方基本都能接。它另外还兼容 Anthropic 的 Messages 接口,Claude Code 这类工具也能直连。
不改代码的价值在于迁移成本。你原来接的是哪家云端,把地址换一下就行,提示词、工作流、工具定义都能接着用。
从装 APK 到发出第一个请求
整个流程没什么门槛,花时间的只有等模型下载这一步。
第一步,去 GitHub 的 Releases 页面下 APK 装上。手机要求安卓 12 以上、arm64 架构,2017 年以后的机器基本都满足。内存至少 6GB,想跑多模态模型建议 8GB 往上。另外提醒一句,目前放出来的版本都还是 beta 包。
第二步,打开 App,在模型列表里挑一个点下载。官方推荐 Gemma 4 E2B,2.4GB,8GB 内存的机器就能跑。不想在 App 里下也行,自己准备好 .litertlm 文件导进去。
第三步,在模型卡片上点 Start Server,等几秒模型加载完,服务就起来了,默认监听 8000 端口。
接着把客户端接上。状态页会显示 API 地址,点一下就能复制。不管接什么客户端,要填的都是三样:地址填 http://手机IP:8000/v1,模型名从模型页上抄,API Key 在没开验证的时候随便填一个占位值就行。
拿 Open WebUI 举例,在它的 Settings 的 Connections 里加一条 OpenAI 连接,把地址填上,刷新一下模型就出来了。要注意 Open WebUI 默认不开工具调用,得手动把 Function Calling 打开。
Home Assistant 要多一步,得通过 HACS 装一个自定义集成,作者测下来最省心的是 Custom Conversation,填的还是那三样。接好之后除了对话,还能拿它做语音转文字。
Claude Code 也能直连,设两个环境变量指过去就行。不过作者在文档里提醒过,手机上的模型上下文窗口小,跑不动它那套重型工具调用,建议只当兼容性测试,别指望真拿它干活。
四条硬限制,先看完再决定挂不挂
第一条是并发。它一次只能加载一个模型,请求也是排队处理的,没有并发这回事。当个家庭小助手行,想替代正经的在线服务就别想了。
第二条是模型格式。它只认 .litertlm,不支持 GGUF,手里囤的那些模型一张都用不上。想自己转的话得在 Linux 上跑谷歌的 litert-torch,还要 32GB 以上内存。
第三条是工具调用。它确实做了,但还是实验性质,而且依赖模型本身有没有为函数调用训练过。模型不支持的时候,可以关掉工具 schema 注入,退回提示词兜底。
第四条是发热。手机长时间跑模型肯定会热,作者在 README 里写了句挺逗的话:别把跑着模型的手机塞枕头底下,电池鼓包了他不负责。玩笑归玩笑,旧手机电池老化的居多,打算常开还是留个心眼。
那点电费,和一台常年开着的旧手机
最后算一笔账。手机跑起来功耗大概 5 到 10 瓦,一台显卡服务器动不动 300 瓦往上,差出两个数量级。这就是它敢说自己能 24 小时挂着的底气。
它当然替代不了云端的大模型服务,速度和模型规模都在那摆着。但接进智能家居当本地语音助手,或者给相册打标签、每天汇总一次 RSS,这类一天跑几次、每次只要几秒的小活,它是够的。数据不出家门,对某些场景本身就是理由。
仓库地址是 https://github.com/NightMean/OlliteRT。它现在五百多 Star,四个多月前才建库,长期维护还得观察。最后交代一句,我没真机装过,性能数字来自官方截图且未标注机型,硬件门槛来自官方 README,想上手建议先拿抽屉里最不心疼的那台机器试。
 发表于 1 小时前
|
查看: 3|
回复: 0


