给音频接口接入 DMA,配置里经常会出现这样的两行:
.src_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES,
.src_maxburst   = 8,
一个是 4,一个是 8。它们到底表示一次搬 4 字节、8 字节,还是 32 字节?外设 FIFO 明明只有一个数据寄存器地址,为什么重复读取它,拿到的却是后续数据?设备树里写了 DMA 请求号,为什么实际分配到的通道编号又不一样?
这些问题不是 API 记忆问题,而是硬件模型还没有接起来。上一篇讨论软件怎样组织 DMA 任务;这一篇往下走一层,看看外设、控制器和总线之间,究竟怎样完成一次搬运。
本文仍以 drivers/dma/dw-axi-dmac/ 的实现为主线,在 Burst 配置处用 pl330.c 做一个小范围对照。示意图中的 FIFO 深度、请求编号和音频参数都是明确给出的教学假设,不对应某一块开发板。寄存器结论以文末列出的源码位置为边界。
一、先把五个名字放进同一条硬件链路
假设一个 I2S 接收接口不断收到音频数据,采用独立 DMA 控制器把数据写入 RAM。先不考虑描述符队列,只看硬件协作。
外设内部的接收逻辑把数据送进 FIFO。FIFO 积累到满足条件时,外设向 DMA 控制器提出请求;控制器中已经配置好的通道获得服务机会,通过总线读取 FIFO 数据端口,再把数据写到内存。
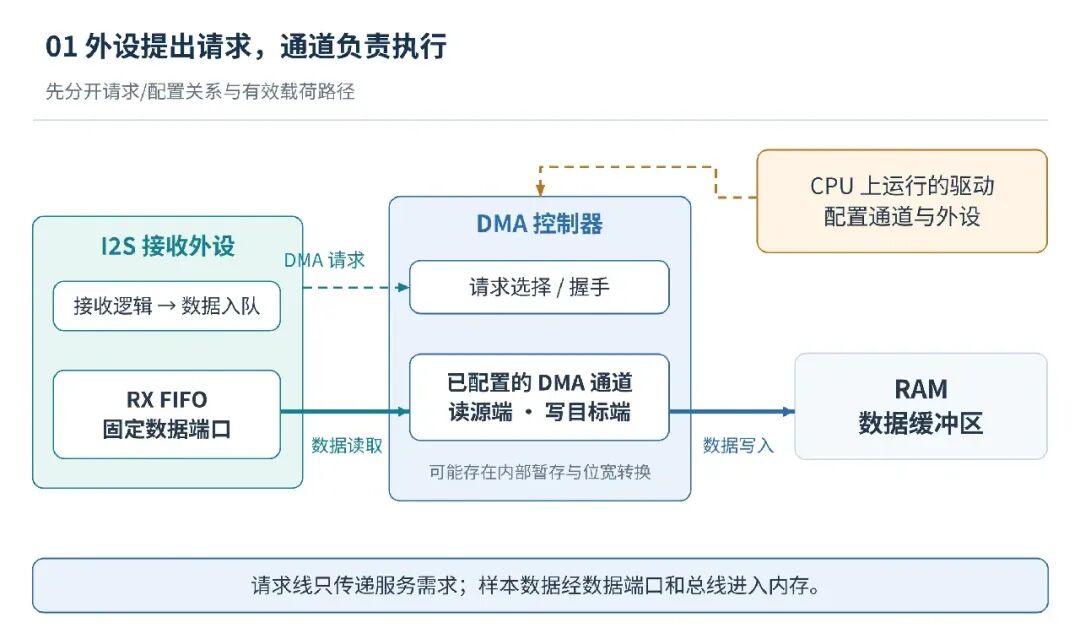
图 1:虚线是请求或配置关系,粗实线是有效载荷路径。控制器内的暂存说明只表示可能存在内部缓冲,不表示所有控制器都采用相同的独立 FIFO 实现。
这五个名词分别回答不同的问题:
| 名词 |
回答的问题 |
先记住的含义 |
| 通道 Channel |
由哪条执行资源承担传输? |
保存和执行一组传输状态,不是一根数据线 |
| 请求线 Request |
哪个外设端点现在需要服务? |
提供请求或握手信息,不承载音频样本 |
| FIFO |
数据为什么可以暂时等一等? |
先到先出的有限缓冲队列 |
| 位宽 Transfer width |
某一侧一次数据访问按多大单位进行? |
必须带单位,并区分源端和目标端 |
| Burst |
多次访问怎样成组组织? |
要说明是接口参数、控制器分组,还是总线事务 |
通道与请求的区分、传输位宽、地址递增方式,都属于 DMA 控制器驱动必须处理的基本硬件属性。但把几个术语放进表格还不够,下面逐个拆开。
二、通道是执行资源,请求线是服务对象
2.1 一条通道不是"一次只能搬一个字节的管子"
从驱动视角看,一条硬件通道至少需要维护当前传输使用的地址、控制参数、计数和运行状态;支持链表的控制器还需要知道去哪里读取下一项硬件描述符。
DW AXI DMAC 的私有通道结构中,下面几个成员就把这些关系分开了。代码摘录自 dw-axi-dmac.h,省略了其他成员:
struct axi_dma_chan {
    struct axi_dma_chip *chip;
    void __iomem *chan_regs;
    u8 id;
    u8 hw_handshake_num;
    /* 其他成员省略 */
    struct dma_slave_config config;
    enum dma_transfer_direction direction;
};
id 标识这里的硬件通道;chan_regs 指向这条通道的寄存器窗口;hw_handshake_num 记录外设握手请求编号。config 和 direction 则保存后续构造任务时需要使用的配置。
初始化时,dw_probe() 为通道设置 id = i,并按通道步长计算 chan_regs。这说明本实现确实有按硬件通道划分的寄存器窗口;不能把这个结论直接推广为所有 DMAEngine 驱动的软件通道都与物理通道一一对应。
2.2 请求号为什么不等于通道号?
可以把通道理解为可分配的执行席位,把请求号理解为外设端点的编号。假设一台控制器有 4 条通道,SoC 给它接入 8 路外设请求,并提供相应的选择或路由能力:请求 5 可以交给通道 1 服务,并不要求必须存在"通道 5"。
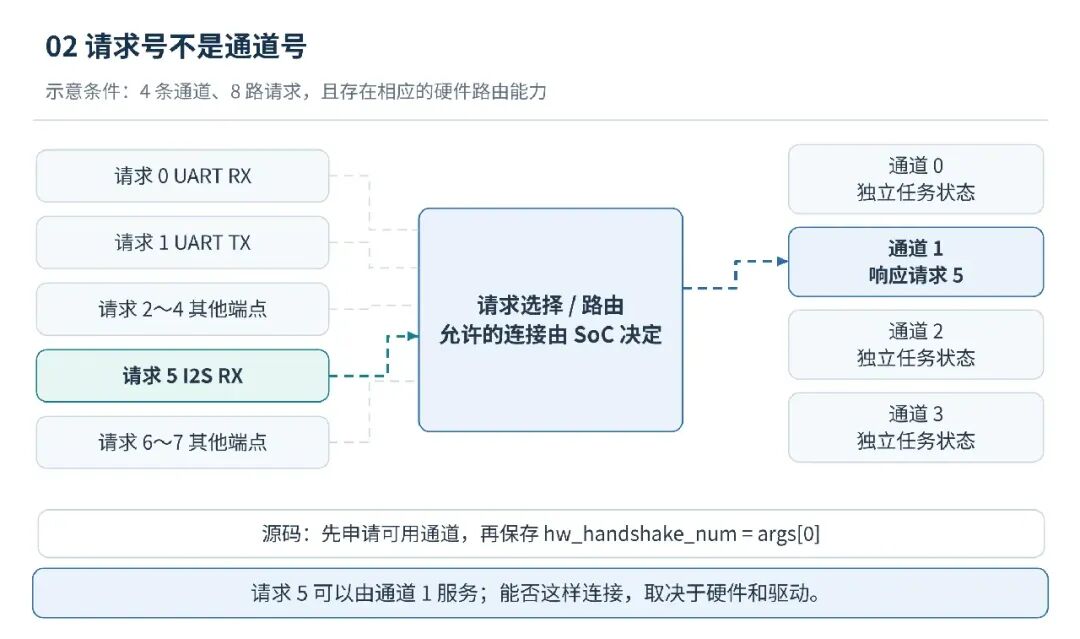
图 2:仅示意一种允许路由的控制器。哪些请求能连到哪些通道、是否存在固定连接,需要查目标 SoC 的连接关系,不能由此推断成任意全互连。
在本文的 dw_axi_dma_of_xlate() 中,先申请可用通道,再记录设备树参数:
dchan = dma_get_any_slave_channel(&dw->dma);
if (!dchan)
    return NULL;

chan = dchan_to_axi_dma_chan(dchan);
chan->hw_handshake_num = dma_spec->args[0];
return dchan;
例如,把 <&dmac 5> 当作一个纯示意配置:在这条转换路径中,5 被保存为握手请求号,不是"必须选择物理通道 5"。这与"先挑一个能工作的通道,再让它响应指定请求"的组织方式一致。
启动时还要继续跟踪请求号写到哪里。axi_chan_block_xfer_start() 在普通路径中,根据方向把 hw_handshake_num 放入 src_per 或 dst_per。带额外 APB 寄存器的分支有所不同:通道配置使用 chan->id,另由 dw_axi_dma_set_hw_channel() 把请求号写进握手选择寄存器。
因此,看到某个字段最终写了通道号,不能马上认定设备树参数就是通道号;中间可能还有一层硬件路由。
2.3 通道多,不等于带宽按数量翻倍
多条通道可以分别维护多组任务,但它们可能共享总线主接口、片上互连和内存控制器。执行资源的数量与最终可用带宽不是同一个量。
这里的硬件配置也把 nr_channels 和 nr_masters 分成了两个成员,分别解析 dma-channels 与 snps,dma-masters。即使请求分配到了不同通道,也仍需考虑共享路径上的仲裁。
对驱动开发来说,先回答"任务是否能分配到执行资源",再回答"这些任务同时工作时能否得到足够服务"。不要用通道数直接估算吞吐量。
三、FIFO:地址不动,数据为什么还能向前走?
3.1 数据端口是队列的入口或出口,不是整块队列的地址表
FIFO 是 First In, First Out,即先进先出。可以把它看成一个有限长度的排队区:最先进入的数据,最先被取走。
对采用单一数据端口的外设,DMA 看到的是一个固定寄存器地址。每次合法地读取 RX 数据端口,外设内部读指针向前推进,返回下一项数据;写入 TX 数据端口时,新数据则进入发送队列。
变化的是 FIFO 内部的队列状态,不是外部访问地址。 AXI 规范也把 FIFO 列为读访问可能产生副作用的设备:多读一次,就可能多取走一项,而不是"多读了也没关系"。
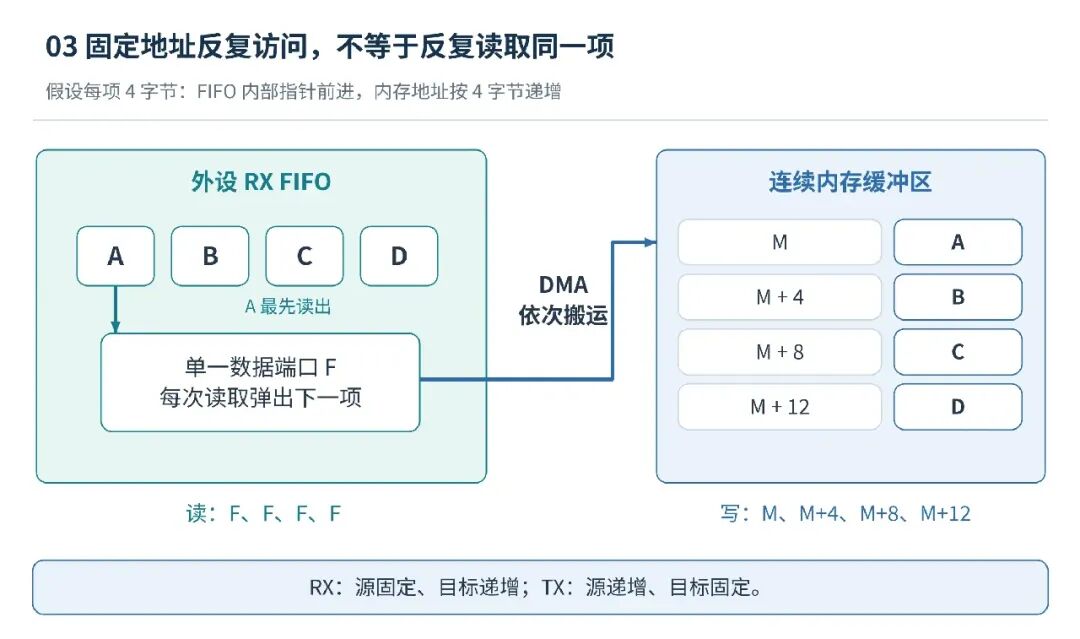
图 3:假设每次数据端口访问恰好取走一项 4 字节数据。F 表示固定的 FIFO 数据端口地址,M 表示已建立访问条件的内存起始地址;不是具体平台地址。
假设 RX FIFO 中依次是 A、B、C、D,每项 4 字节,传入内存时的逻辑效果为:
| 次数 |
读取地址 |
取出的数据 |
写入地址 |
| 1 |
F |
A |
M |
| 2 |
F |
B |
M + 4 |
| 3 |
F |
C |
M + 8 |
| 4 |
F |
D |
M + 12 |
若错误地让外设地址递增,下一次可能访问到状态寄存器、控制寄存器或保留地址;若错误地让目标内存地址固定,则多项数据可能反复写在同一位置。具体后果取决于外设寄存器布局,但两种配置都已经偏离了"把队列连续保存到内存"的目标。
3.2 三种常见方向,地址策略不同
| 传输方向 |
源地址 |
目标地址 |
典型任务 |
DMA_DEV_TO_MEM |
外设数据端口固定 |
内存递增 |
录音、串口接收 |
DMA_MEM_TO_DEV |
内存递增 |
外设数据端口固定 |
播放、串口发送 |
DMA_MEM_TO_MEM |
内存递增 |
内存递增 |
普通连续块复制 |
这是单数据端口、连续内存的常见模型,不覆盖带寄存器窗口、二维步长或其他特殊访问规则的设备。本文控制器的 Slave 和 memcpy 准备路径正好提供了这三种策略的实例。
其中,RX 分支在 dw_axi_dma_set_hw_desc() 中这样组织控制位:
case DMA_DEV_TO_MEM:
    reg_width = __ffs(chan->config.src_addr_width);
    device_addr = chan->config.src_addr;
    ctllo = reg_width << CH_CTL_L_SRC_WIDTH_POS |
        mem_width << CH_CTL_L_DST_WIDTH_POS |
        DWAXIDMAC_CH_CTL_L_INC << CH_CTL_L_DST_INC_POS |
        DWAXIDMAC_CH_CTL_L_NOINC << CH_CTL_L_SRC_INC_POS;
    block_ts = len >> reg_width;
    break;
这一段里,源端使用外设寄存器位宽并禁止递增,目标端使用内存侧位宽并允许递增。后续代码再把 device_addr 写入源地址字段,把 mem_addr 写入目标地址字段。
反向发送时,对应关系翻转:源内存递增,目标数据端口固定。并不是把 RX 配置里的地址对调一下就必然足够,源端与目标端的位宽、握手选择和流控方向也要一起核对。
3.3 FIFO 深度不等于数据寄存器宽度
"32 位数据端口"和"32 项 FIFO"描述的是两件事。前者说一次端口访问的宽度,后者说内部最多能存多少项。
若每项占 4 字节,16 项 FIFO 的容量就是 64 字节。深度也可能以字节、样本或其他单元给出,读取手册时必须确认单位,不能只记一个数字。
还要分开外设 FIFO、DMA 控制器内部暂存区、RAM 缓冲区与 CPU Cache。它们可能同时存在,但容量、访问方式和承担的任务不同。外设 FIFO 装不下的输入数据,不会因为 RAM 中分配了一个更大的缓冲区,就自动获得额外等待空间。
四、请求线与 FIFO 水位:什么时候该搬,来不来得及?
4.1 RX 等数据积累,TX 等空间腾出来
先采用一种常见的水位模型:RX FIFO 的数据项数达到门限时提出接收请求;TX FIFO 剩余数据降到门限时提出补数请求。门限的精确比较方式、是否使用"空闲项数"表示,以及请求的撤销条件,都由具体外设定义。
假设 FIFO 深度为 16 项,每项 4 字节。RX 在已有 8 项时请求搬出,TX 在剩余 8 项时请求补入。暂时忽略这段时间内新数据到达或旧数据消耗,一次搬 4 项后,RX 从 8 项降到 4 项,TX 从 8 项升到 12 项。
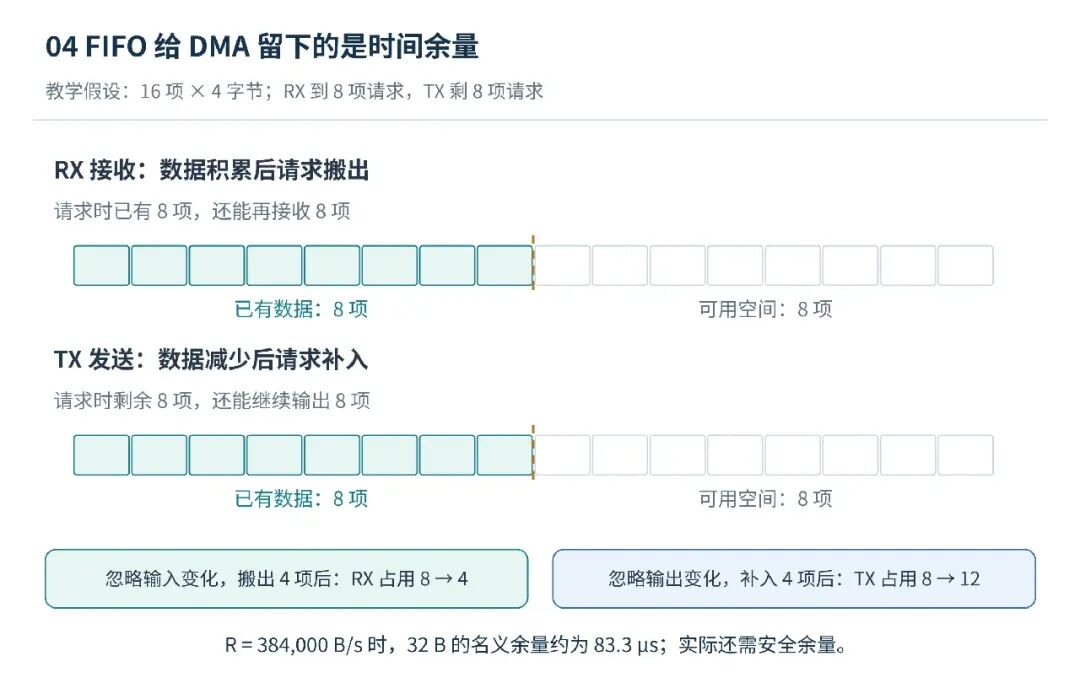
图 4:假定两种模式都在 8 项水位提出请求。图中瞬时搬动 4 项只是帮助计算占用变化,不代表真实传输没有时间开销。
FIFO 的价值不是把外设变成无限快,而是容纳短时间的服务延迟。接收端怕迟迟无人读取而溢出,发送端怕迟迟没有补数而耗尽。
4.2 请求不等于完成中断,也不是"CPU 收到通知才开始搬"
DMA 请求进入的是控制器的请求或握手机制;DMA 完成或出错中断进入 CPU 的中断处理路径。二者的对象和时机不同。
请求可能持续有效,也可能通过控制器规定的握手协议交互;不能把它统一画成"一个脉冲对应一个字节",更不能认为一次请求就是整笔任务已经完成。本文启动路径选择硬件握手,同时设置传输完成与错误中断掩码,这两类配置在代码中也是分开的。
这带来一个很实用的判断:降低 FIFO 请求门限可能增加 DMA 服务频次,却不一定按相同比例增加 CPU 完成中断次数。 中断粒度还要看块、描述符、循环周期以及具体驱动的设置,而不是只看请求线跳变。
4.3 用容量除以速率,先估算"还能等多久"
设 FIFO 总深度为 D 项,每项 W 字节;RX 请求时已有 H 项,输入速率为 R 字节/秒。忽略离散项边界、请求传播及已在途数据,若 DMA 暂时完全不读取,则到 FIFO 填满的名义时间为:
RX 名义等待窗口 = (D - H) × W / R
TX 请求时若还剩 L 项,输出速率为 R 字节/秒,且 DMA 暂时完全不补数,则到数据耗尽的名义时间为:
TX 名义等待窗口 = L × W / R
两式只是静态预算,工程上必须留余量;"第一次读写赶上了"也不够,后续持续服务还要跟得上。
沿用上面的假设,再设音频为 48 kHz、双声道,每个声道样本在 FIFO/内存中占 4 字节,则搬运速率为:
R = 48,000 × 2 × 4 = 384,000 B/s
RX 空闲空间 = (16 - 8) × 4 = 32 B
RX 名义等待窗口 = 32 / 384,000 ≈ 83.3 μs
TX 在剩余 8 项时也有相同的名义窗口。若把 RX 门限提高到 12 项,剩余空间只有 16 字节,名义窗口缩短为约 41.7 μs。
这个算例说明了一个容易与直觉相反的事实:接收门限设得更高,虽然每次可以积累更多数据,却压缩了 DMA 来不及服务时的缓冲余量。 这不是"门限越大越高效"就能决定的参数。
4.4 硬件握手不等于外设担任流控制器
在本文启动函数中,硬件握手选择与 device_fc 是不同配置:
config.hs_sel_dst = DWAXIDMAC_HS_SEL_HW;
config.hs_sel_src = DWAXIDMAC_HS_SEL_HW;
对于 RX,后面的代码还会根据 chan->config.device_fc 在 PER_TO_MEM_SRC 和 PER_TO_MEM_DMAC 两种模式之间选择。前者对应源外设控制,后者对应 DMA 控制器控制。device_fc 的通用含义也正是选择外设是否充当流控制器。
不要因此把 device_fc = false 解释成"不再响应外设请求"或"忽略 FIFO 水位"。它决定的是控制器提供的流控模式,不是外设 DMA 请求的总开关。
外设自身还需要正确配置数据端口、FIFO 门限与 DMA 请求使能;这些不由一次 dmaengine_slave_config() 自动代办。外设握手怎样表示最后一批、余数和结束条件,需要继续查对应硬件定义。
五、位宽:先问是哪一侧,再问单位是什么
5.1 24 位音频,不一定要求 3 字节 DMA 访问
"音频是 24 位"通常只说明有效采样精度。一个具体设计完全可能把 24 位有效样本放在 32 位容器中,通过 32 位 FIFO 数据端口访问,再连接到 64 位片上总线。
这几个数字可以同时成立,因为它们描述的对象不同。
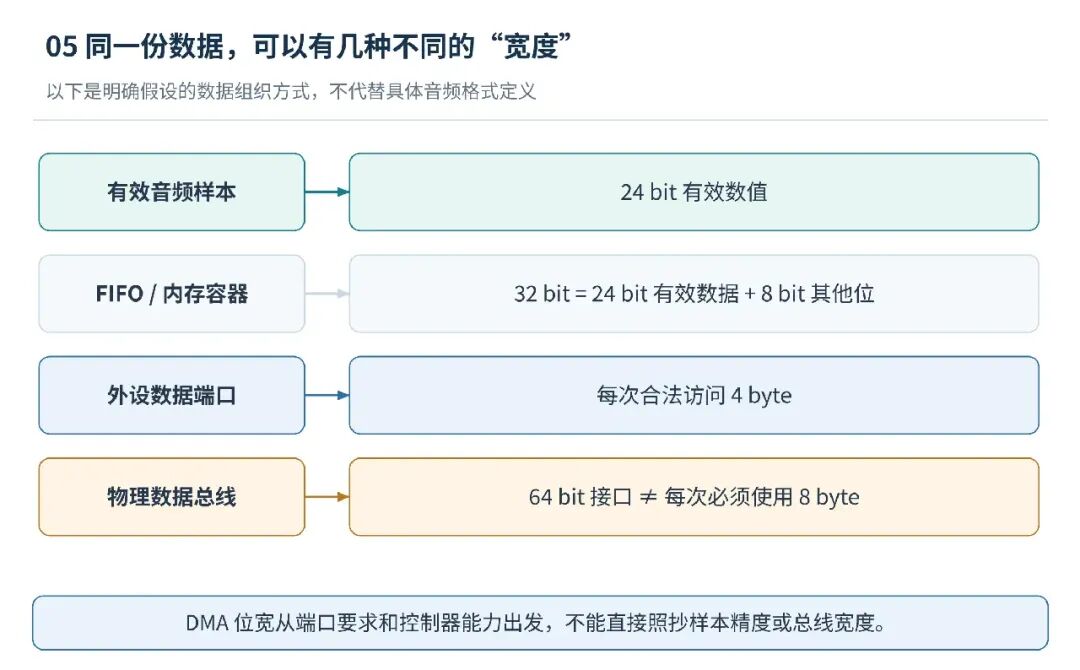
图 5:示例采用 24 位有效数据、32 位容器、4 字节端口访问和 64 位物理总线。填充或符号扩展的位置、左右对齐和字节序由音频格式及外设定义;图中不替代具体格式约定。
| 层次 |
示例 |
决定什么 |
| 有效样本精度 |
24 bit |
哪些位代表有效音频数值 |
| FIFO/内存容器 |
32 bit |
每项数据怎样排列、占多少空间 |
| 外设端口访问宽度 |
4 byte |
一次合法数据端口访问的单位 |
| 内存侧传输宽度 |
可能与外设侧相同,也可能不同 |
DMA 如何组织另一侧访问 |
| 物理数据总线宽度 |
64 bit |
接口具有多少数据位,不保证每次全部用满 |
因此不能直接按样本精度填 src_addr_width = 3,也不能因为总线是 64 位就填 8。应该从外设数据端口的合法访问方式和数据布局出发,再与控制器支持的位宽组合核对。
位宽转换、数据打包也不是免费的通用保证。控制器是否支持源窄目标宽、怎样处理尾部和字节顺序,需要看硬件能力及驱动路径。
5.2 API 用字节数,寄存器可能用编码
dma_slave_config.src_addr_width 和 dst_addr_width 的单位是字节。对采用 2 的幂字节宽度的这条 DW 路径,__ffs() 把字节数变成对应的位宽编码。
| 合法的幂次宽度示例 |
二进制字节数 |
__ffs() 结果 |
本控制器枚举含义 |
| 1 byte |
0001 |
0 |
8 bit |
| 2 byte |
0010 |
1 |
16 bit |
| 4 byte |
0100 |
2 |
32 bit |
| 8 byte |
1000 |
3 |
64 bit |
__ffs(4) = 2,所以把编码 2 写进宽度位域,表达的是每次 4 字节,不是 2 字节。这里的转换不是对任意整数都求数学对数:传入 3,最低置位的位置是 0,绝不等价于支持 24 位传输;零值也不能交给这段逻辑当作普通位宽。
API 参数、寄存器编码和最终硬件含义,需要分成三列来看。 位宽如此,后面的 Burst 长度和块计数也一样。
5.3 源码还会根据地址和长度选择内存侧位宽
dw_axi_dma_set_hw_desc() 的 Slave 路径先计算内存侧位宽:
mem_width = __ffs(data_width | mem_addr | len);
if (mem_width > DWAXIDMAC_TRANS_WIDTH_32)
    mem_width = DWAXIDMAC_TRANS_WIDTH_32;

if (!IS_ALIGNED(mem_addr, 4)) {
    dev_err(chan->chip->dev, "invalid buffer alignment\n");
    return -EINVAL;
}
这里的按位或把硬件上限、地址对齐和长度对齐一起纳入选择:只要其中一个因素要求较小的单位,就不能仅凭总线宽度采用更大的访问单位。
还应读出两条仅限这份实现的约束:这条 Slave 路径把内存侧传输宽度编码限制到 32 位,并显式要求内存起始地址按 4 字节对齐。不能据此声称所有 DMA 缓冲区都必须 4 字节对齐,也不能用"地址对齐了"替代对长度、端口访问宽度和尾部处理的检查。
相邻的 memcpy 路径使用另一套宽度选择过程,并在注释中说明为了简化而把源、目标位宽取成相同值。同一控制器的不同传输路径,也未必具有完全相同的位宽策略。
六、Burst:不是位宽,不是总长度,也不是时钟周期数
6.1 先定义 beat:一次被接受的数据传输
讨论总线时,beat 通常指一次数据传输。在 AXI 数据通道上,只有有效与就绪握手同时满足,才真正完成这一拍的数据交接;如果接收方暂时不接受,数据可以在若干周期内等待。
所以"4 beats"表示完成 4 次数据交接,不保证只用了 4 个时钟周期。图中用时钟边沿采样表表示一个带等待的例子,而不是把等待时重复呈现的数据算成新数据。
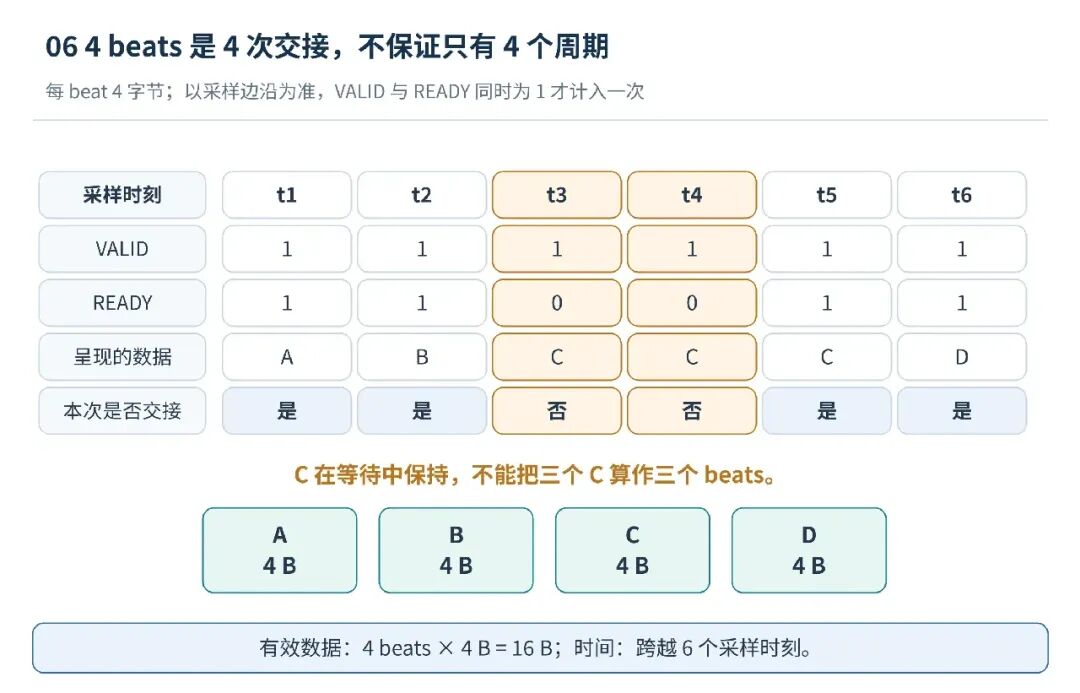
图 6:每 beat 4 字节,4 beats 共 16 字节;中间等待两个周期,总共跨越 6 个采样时刻。此图只讨论数据交接,省略地址阶段及响应。
在起始地址对齐、每拍各字节均有效等简化条件下,可以这样换算:
单个 burst 的数据量 = 每 beat 字节数 × beat 数
每 beat 4 字节、8 beats,对应 32 字节。它表示这一组的数据量,并不表示整笔 DMA 任务只有 32 字节,也不意味着每次都必须组织出同样大小的组。
遇到窄传输、非对齐访问或写字节使能时,实际有效字节数还要按对应总线规则计算,不能只拿物理总线宽度乘长度。
6.2 maxburst 的单位是"宽度单位的个数"
src_maxburst 与 dst_maxburst 的 API 语义是对应一侧的最大成组传输数量,计数单位取自对应的 addr_width,不是字节。
回到开头的例子:
.src_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES,
.src_maxburst   = 8,
它表达的是源端每个单位 4 字节,最多按 8 个这样的单位组织一次 burst,也就是上限按 32 字节理解。前提是控制器驱动确实支持并落实这个配置。
把 src_maxburst = 32 当作"我想每组搬 32 字节",在宽度为 4 字节时就把请求写成了 128 字节。这个单位错误经常比算法本身更难发现。
同时,maxburst 不是整笔任务长度。任务长度由准备接口及其缓冲区描述提供;一个较大的任务通常需要多组成组传输。
6.3 三种"Burst"不能直接画等号
| 所在层次 |
本文出现的字段 |
应该怎样理解 |
| DMAEngine 配置 |
src_maxburst、dst_maxburst |
客户端提出的端点成组传输限制 |
| DW 控制器配置 |
SRC_MSIZE、DST_MSIZE |
控制器源、目标侧的成组传输参数 |
| AXI 总线事务 |
ARLEN、AWLEN,以及 ARSIZE、AWSIZE |
总线读写事务的 beat 数与每 beat 字节数 |
这张表不是说它们彼此无关,而是说关系需要由具体控制器的实现建立。DMA 内部缓存、位宽转换、总线桥及长度限制,都可能让端点访问分组与内存侧看到的 AXI 事务边界不同。
还有一个命名陷阱:AXI 规范里的 AxSIZE 描述每个 beat 的字节数编码,不是一个 burst 里有多少 beats。AxLEN 才描述长度,标准编码是 beat 数 - 1。
6.4 Burst 大一些,为什么可能更高效,又为什么不能无限增大?
把多次访问放进同一组,有机会摊薄控制开销,减少过多的小事务。若把一次组传输简化为固定开销 C 加 N 次数据交接,且忽略等待,则控制开销占比为 C / (C + N)。在这个模型里,N 增大时占比下降。
但这只是解释"为什么有优化空间"的模型,不是实际带宽公式。真实传输会受到端点可接收量、总线竞争、转换桥、在途事务数量和尾部长度的影响。
尤其对于 FIFO:若某次服务只保证能读出 8 项或容纳 8 项,就不能在没有额外流控保证的情况下要求连续访问 16 项。也不能把硬件握手当成万能防护,假设它一定会替任何不合法的批量配置自动拆分。
AXI 的单个 burst 还不能跨越 4 KiB 地址边界。这是单个总线事务的约束,不表示 DMA 任务或硬件链表项最多只有 4 KiB。更大的搬运需要被组织成满足总线约束的事务;具体由控制器和互连怎样实现,不能脱离硬件推断。
七、回到源码:参数填写之后,真的生效了吗?
7.1 slave_config() 返回成功,不代表所有字段已经写入硬件
本文 DW AXI DMAC 的配置回调很短:
static int dw_axi_dma_chan_slave_config(struct dma_chan *dchan,
                                       struct dma_slave_config *config)
{
    struct axi_dma_chan *chan = dchan_to_axi_dma_chan(dchan);

    memcpy(&chan->config, config, sizeof(*config));
    return 0;
}
它先保存配置,后续准备任务、启动通道时才使用相关字段。这里没有为每个参数执行完整的合法性验证,也没有立即把每一项配置写进寄存器。
所以看到返回 0,只能按这段实现理解为配置结构已经保存,不能得出"传输一定支持""所有字段一定生效"或"硬件已经开始搬运"的结论。
7.2 这份 DW AXI DMAC 把 MSIZE 固定为 4 次传输
继续跟到 dw_axi_dma_set_hw_desc(),可以看到:
ctllo |= DWAXIDMAC_BURST_TRANS_LEN_4 << CH_CTL_L_DST_MSIZE_POS |
         DWAXIDMAC_BURST_TRANS_LEN_4 << CH_CTL_L_SRC_MSIZE_POS;
头文件对应的枚举从 0 起依次编码 1、4、8、16 等传输长度。也就是说,DWAXIDMAC_BURST_TRANS_LEN_4 的枚举值为 1,硬件含义却是 4 次传输,不是 1 次。
检查这份 dw-axi-dmac/ 的代码,没有发现直接读取 src_maxburst 或 dst_maxburst 的位置;配置被整体保存,但这里的源、目标 MSIZE 使用固定常量。memcpy 准备路径也采用相同的 MSIZE 常量。
因此,单独把客户端的 src_maxburst 从 4 改成 8,不能据此宣称这份 DW 驱动就会把 SRC_MSIZE 改成 8。 这是本实现的结论,不是 DMAEngine 的统一规则,也不是对所有版本 DW AXI DMAC 的断言。
7.3 PL330 给出了一条不同的落实路径
pl330_config_write() 对 RX 明确读取了端口位宽与 Burst 参数:
if (slave_config->src_addr_width)
    pch->burst_sz = __ffs(slave_config->src_addr_width);
pch->burst_len = fixup_burst_len(slave_config->src_maxburst,
                               pch->dmac->quirks);
在这份实现中,fixup_burst_len() 将输入限制到 1~16,后续 _prepare_ccr() 再把长度减一后编码进 CCR 的源、目标 Burst 长度字段。这说明客户端字段确实进入了这条控制器配置路径;但最终总线波形仍受任务剩余长度和控制器执行过程约束,不能只看一个字段就断言每笔总线事务的形态。
两种实现并排看,才容易形成正确的阅读习惯:
接口定义给出"参数想表达什么",控制器源码说明"这一版究竟怎样实现"。两者缺一不可。
7.4 AXI 长度还有一个需要单独复核的编码边界
这里的 parse_device_properties() 读取 snps,axi-max-burst-len,检查值在 1~256 之间,随后直接保存;准备描述符时,又把保存值直接移入 ARLEN/AWLEN 控制位域。
但头文件中的 DWAXIDMAC_ARWLEN_16 = 15 等枚举,以及 AXI 的长度编码,都采用"实际数量减一"的表达。外部 binding 也把这个属性描述为长度限制,而不是直接暴露寄存器编码。
这构成了源码里值得继续核对的长度值与编码值边界,不能在讲解中悄悄补上源码没有的减一操作。 如果对应硬件字段使用这些枚举所指示的编码,直接移位就存在偏一和上限位域风险;是否需要修正,应结合准确的 IP 手册、目标分支变更和寄存器验证确认。
本篇不把某个设备树数值当作已经验证的性能调优建议,也不把这个静态疑点写成已经复现的硬件故障。先把"配置值 → 内部值 → 位域编码 → 总线含义"逐段核对,才有资格判断实际行为。
八、把五个概念接起来:一次 1024 字节的接收
8.1 先列条件,不直接套用开发板参数
构造一个有限长度的 RX 示例:FIFO 每项 4 字节,深度 16 项,在 8 项水位提出请求;使用固定 RX 数据端口,目标内存满足映射、对齐和长度约束;源、目标传输宽度均为 4 字节,端点服务分组按 4 次访问考虑;本次搬运 1024 字节,且单个硬件块允许容纳这段数据。
若先写一个配置辅助函数,它只能负责描述端口访问条件,并不是完整的接收驱动:
#include <linux/dmaengine.h>
#include <linux/errno.h>
#include <linux/err.h>

/* 假设:硬件端口必须用 4 字节访问,服务分组允许 4 项。 */
static int configure_rx_dma(struct dma_chan *chan,
                            phys_addr_t rx_fifo_phys)
{
    struct dma_slave_config cfg = {
        .src_addr       = rx_fifo_phys,
        .src_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES,
        .src_maxburst   = 4,
        .device_fc      = false,
    };

    if (IS_ERR(chan))
        return PTR_ERR(chan);
    if (!chan)
        return -EINVAL;

    return dmaengine_slave_config(chan, &cfg);
}
这里的 rx_fifo_phys 是按平台资源及该驱动约定得到的外设数据端口地址,不是 ioremap() 返回的 CPU 虚拟指针。PL330 中还存在对这类端口资源调用 dma_map_resource() 的处理;不能假设所有地址域、所有控制器都可以直接套用同一地址数值。
外设门限和 DMA 请求使能要由外设驱动负责;内存的 DMA 映射、准备接口里的 DMA_DEV_TO_MEM、提交、启动和完成后的资源处理也都还没包含。尤其不应只填配置结构里的 direction 就认为后续准备方向已经自动确定。
8.2 1024 字节里有多少次访问、多少组?
在上面的对齐、完整数据单位和统一位宽假设下:
总数据量:             1024 B
源端每次访问:           4 B
源端访问次数:    1024 / 4 = 256
每组访问次数:           4
等量分组数:       256 / 4 = 64
每组数据量:          4 × 4 = 16 B
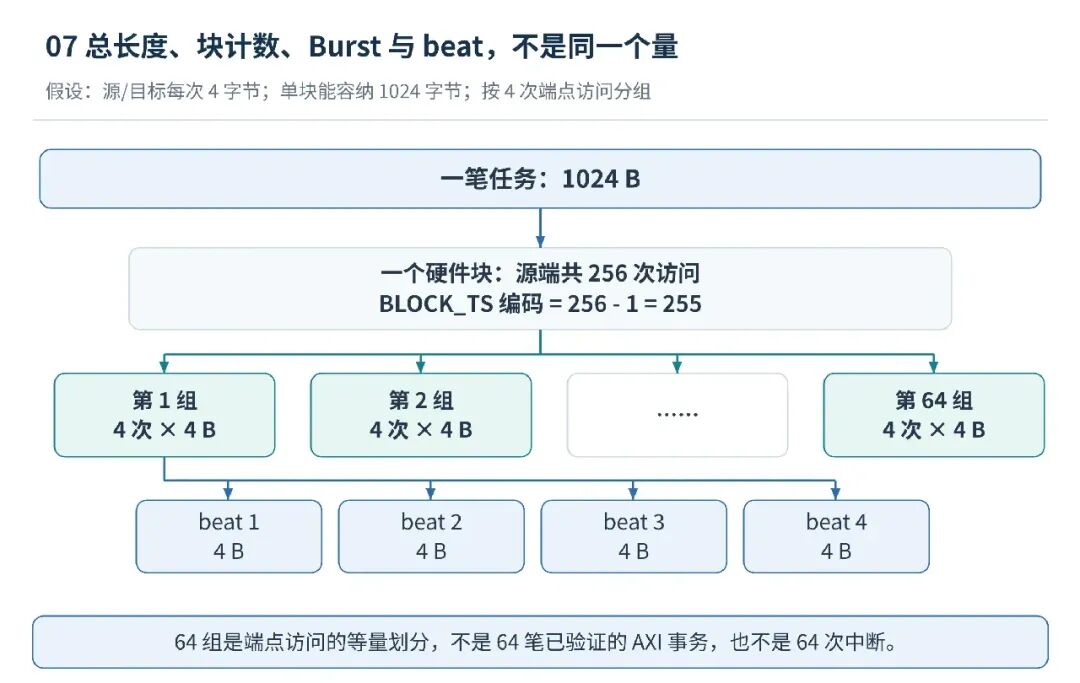
图 7:展示这个示例的源端计数关系。64 组是按 4 次端点访问分组的算术结果,不等于已经测得 64 笔 AXI 事务,更不等于 64 次 CPU 中断。一个任务也可以因硬件限制拆成多个块。
在本文 RX 描述符构造路径中,block_ts = len >> reg_width。4 字节对应宽度编码 2,因而 1024 >> 2 = 256;写入 block_ts_lo 的值是 256 - 1 = 255。
注意这个寄存器计数使用的是这里的源端传输单位,而不是字节,也不是 Burst 组数。把 1024、256、64、255 都叫"传输长度",调试时就很容易读错状态。
对于 TX,同一函数用 len >> mem_width 计算块传输次数,因为源端此时是内存。这进一步说明:当两侧位宽不同时,判断硬件块计数必须先明确按哪一侧计数,不能固定套用外设宽度。
8.3 运行时,不是请求一次就把全部 1024 字节强行读完
DMA 通道先持有足够执行任务的配置。外设不断接收数据,FIFO 满足请求条件;控制器结合握手、通道调度与总线条件推进读写;数据不足或暂时不能继续服务时,按硬件协议等待。任务计数与握手条件共同约束传输,而不是拿到第一次请求后就无条件读空整个目标长度。
如果整段音频按前面的 384,000 B/s 连续输入,1024 字节对应约 2.67 ms 的数据;它仍可能要求 DMA 在约 83.3 μs 的名义 FIFO 余量内开始并持续提供足够服务。任务总体持续多久,与 FIFO 每次最多能等多久,是两种不同的时间尺度。
九、调参前,先能解释这几种故障
9.1 通道已经启动,计数却不前进
先沿服务链检查:外设是否真的产生数据,DMA 请求是否使能,门限条件是否达到,请求号及路由是否正确,通道源目标方向是否匹配。然后再看控制器错误状态、访问地址及总线响应。
"申请通道成功"只说明资源申请完成;"配置返回 0"也不证明外设请求已经接通。尤其不应一看到没有完成中断,就立刻把问题归为 CPU 中断系统故障:也可能搬运根本没有推进到完成点。
9.2 数据总是重复、错位,或一组数据只有最后一项
固定 FIFO 地址本来就是正确的,不能为了让数据"向前走"而改成递增。应该分别核对端口访问的副作用、内存地址递增、源目标位宽,以及 24 位有效数据在 32 位容器中的排列。
若每一项都写到同一内存地址,结果可能只剩最后一次写入;若端口访问单位不匹配,可能出现采样错位或总线错误。这些现象只是定位线索,不是唯一诊断。修正配置后仍需用可预测数据验证,不能只凭波形"看起来像音频"。
9.3 单独运行正常,摄像头或编码器一忙就溢出
这时值得测量的是最坏服务间隔,而不仅是平均 MB/s。若其他主设备的访问让 DMA 在某个窗口内得不到足够服务,即使长期平均带宽看起来充足,小 FIFO 也可能先装满。
按顺序核对输入速率、FIFO 实际容量、门限、请求到服务的延迟分布和错误计数,再考虑平台支持的优先级、互连服务保证及 Burst 配置。降低 RX 门限可能换来更多等待余量;TX 则要注意在耗尽前提早补数。两者不能简单照抄同一个"调大门限"操作。
增加 RAM 缓冲区可以改善软件消费不及时的问题,但未必改变外设 FIFO 到 DMA 之间的硬件服务期限。先判断丢数据发生在哪一段,再决定扩大哪一个缓冲区。
9.4 把 Burst 改大,速度和寄存器却没变化
先验证参数有没有被使用。在本文 DW 路径中,客户端 maxburst 并没有直接控制 MSIZE;而 PL330 存在明确的读取、限制和编码过程。此时反复修改同一个字段,不如沿配置使用点追一遍。
性能记录至少需要同时保存:传输大小、两侧位宽、外设门限、实际写入的控制值、有效数据速率,以及溢出/欠载/总线错误计数。平均吞吐量改善但最坏服务间隔变差,不一定是实时音视频链路想要的结果。
十、留一个小练习:能算清楚,也要知道不能推断什么
假设仍使用 16 项 FIFO、每项 4 字节,48 kHz 双声道、每个声道样本占 4 字节。RX 门限为 12 项;准备搬运 1024 字节;客户端填写 src_maxburst = 8;目标控制器采用本文分析的 DW AXI DMAC 路径。
问题一:名义 RX 等待窗口是多少?
剩余空间是 (16 - 12) × 4 = 16 B,除以 384,000 B/s,结果约为 41.7 μs。这个数需要再扣除实际实现的延迟和安全余量,不能当作保证不会溢出的边界。
问题二:src_maxburst = 8 能不能证明 SRC_MSIZE 已经是 8?
不能。要看字段是否进入硬件配置;本文源码写入的仍是固定 DWAXIDMAC_BURST_TRANS_LEN_4。接口参数的意图与实际实现要分别核对。
问题三:这段数据对应多少次源端 4 字节访问?应该写多少块计数?
源端访问数为 256。若单块限制允许容纳整段,按本文 RX 路径写入的 block_ts_lo 为 255;如果硬件块限制更小,需要先拆块,再分别编码。不能把 maxburst、任务总长度或分组数直接写成块计数。
问题四:能不能据此算出 AXI 事务数量和 CPU 中断数量?
不能。前面的信息足够计算逻辑访问量,却不足以推导实际总线事务边界和通知粒度。还需要控制器的事务组织、AXI 长度限制及描述符/中断设置。
结语
读 DMA 硬件配置,最怕的不是寄存器多,而是几个数字混用了单位和层次。
通道决定由哪条资源执行,请求线决定响应哪个外设端点,FIFO 提供有限等待空间;位宽定义某一侧一次访问的单位,Burst 定义若干访问怎样组织,而任务总长度定义这次总共要搬多少。
落实到代码时,再加一道检查:参数有没有被这份驱动使用?从字节数、访问次数到寄存器编码,中间做了什么转换?
这几条关系理清之后,src_addr_width、SRC_MSIZE、ARLEN 和 BLOCK_TS 就不再是一堆相似的名字。下一篇进入地址与缓存,继续讨论:即使这些硬件参数都配对了,为什么一块普通 CPU 缓冲区仍不能直接交给 DMA。
 发表于 2 小时前
|
查看: 8|
回复: 0


