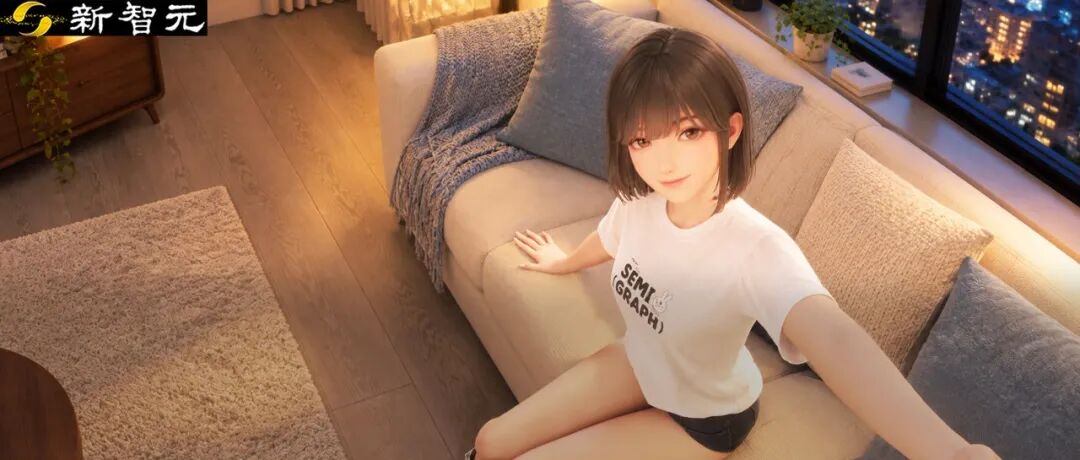
未来数字世界会是什么样?
在全球计算机图形学学术界顶级顶会 SIGGRAPH 上,已经透露了信号。
在前沿论文中,有极大比例都在死磕同一个主题——「人」。从身体关节的精确驱动、面部表情的微妙肌肉牵扯,到角色的骨骼建模与动画控制,甚至精细到头发的物理模拟。
为什么?因为图形学最大的落地场景是游戏和影视,其中「人」永远是最核心的元素,是受众产生情感连接的锚点,也是承载商业价值的载体。
最近两年,极具行业分量的 ACM SIGGRAPH「时间检验奖」,都重磅颁发给了动画方向研究。
这无疑释放了一个强烈的风向标:无论渲染技术多么花哨,环境多么逼真,让角色「动」得像个真正的人,依然是下一代体验的圣杯。
然而,当下行业却面临巨大的断层。
当生成式 AI 开始席卷游戏行业,由前米哈游「逆熵」AI 研究负责人带队,刚刚斩获超千万美元融资的半图科技,正在向行业最难的方向发起冲锋——他们要用一套前所未有的人类行为模型,把 AI 从聊天框里拽出来,让它们在 3D 世界里真正「活」过来!
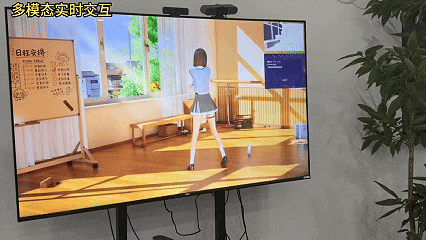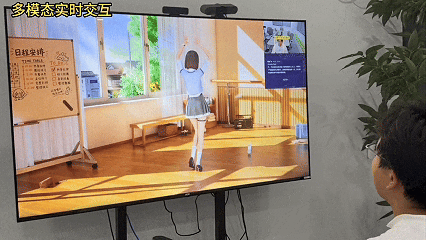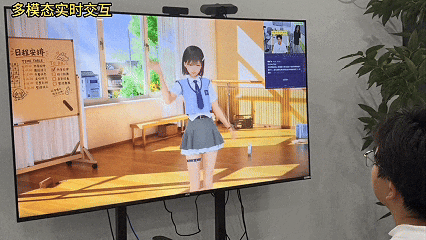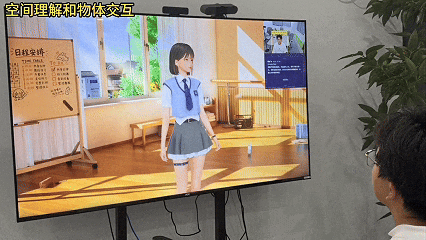
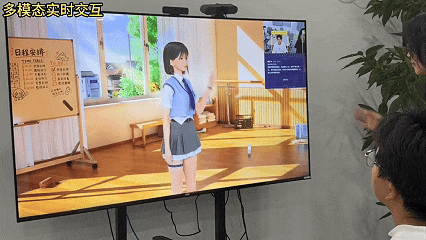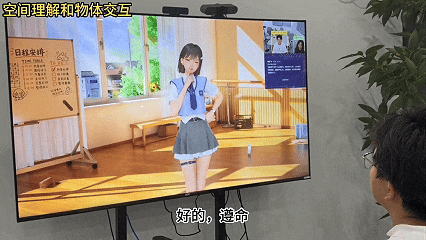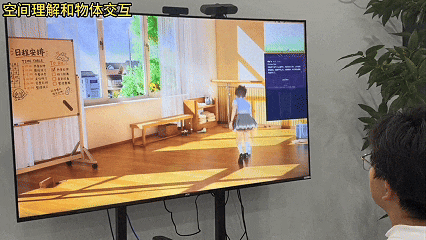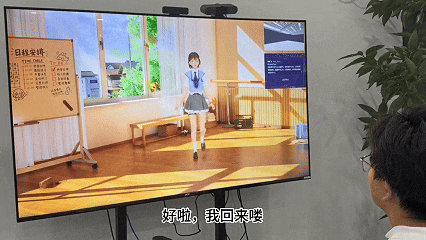
融合了空间理解、多模态实时交互、物体互动等能力的人类行为模型
世界生成已经跑在前面,角色行为成了最大瓶颈
今年 ChinaJoy 的主题直接定成了「与 AI 同游」,专门开辟了 AI NPC 互动体验区。
能明显感受到整个行业的急迫:所有人都知道,AI 角色的下一步不能只是「会聊天」,但怎么走到那一步,路径依然模糊。
问题卡在哪里?原因在于,大模型教会了角色「想说什么」,但没人教它「怎么行动」。
一个真正让人信服的 3D 角色,不只是嘴巴在动。当你走近它,它应该转身看你;当你递给它一杯咖啡,它应该伸手去接;当你们经历了一段共同的冒险,下次见面时它的态度、表情、甚至站位都该有所不同。
这些行为要在时间上连续,在空间上合理,在情绪上连贯。
听起来简单,但仔细想,这里面涉及的东西太多了。
反观当下市面上绝大多数主打「AI 互动」的游戏产品,体验往往在新鲜感褪去后迅速崩塌。为什么?因为它们没有解决以下几个核心痛点。
没有边界的自由,导致目标感迷失:开放的聊天框容易产生无限的分支,缺乏剧情、规则和情绪节奏的约束,玩家很快就会失去「接下来该干嘛」的动力。
角色只会「说」,不会「演」:大模型只能输出文字告诉你角色「很生气」,但眼前的 3D 模型依然僵硬得像个木桩。角色需要转身、走向玩家、甚至拿起桌上的水杯,这些都需要连续的「3D 行为」来塑造,而不仅仅是 Prompt 调用。
无法融入游戏工业管线,成本难以收敛:如果每次玩家的互动都依赖大模型实时推理,成本将随 DAU 呈指数级爆炸。更致命的是,只有文字的 AI 无法融入游戏引擎的数值、关卡和动画工作流,技术团队和美术团队无从下手。
行业解决了「怎么生成世界」,但还没真正解决「角色进入世界后要怎么行动」。
半图科技的答案:用「人类行为模型」重塑角色灵魂
面对这些行业沉疴,半图科技给出的答案极具颠覆性,却又非常务实:AI 不需要推翻传统的游戏制作管线,而是应该切入角色塑造中最具体验价值的环节。
开发者依然负责设计世界观、规则和戏剧冲突;而 AI 则在这些框架中,让角色保持记忆状态、理解环境关系,并以连续的「3D 行为」回应玩家。
这套杀手锏,被称为「人类行为模型」。
以往,大模型负责理解你说了什么、角色想做什么——这是「意图」。但意图到行为之间,还差着十万八千里。
你跟一个角色说「帮我倒杯水」,模型理解了语义,然后呢?角色要走到桌子前,伸出手,拿起杯子,走回来,递给你。
这一系列连续动作,涉及路径规划、物体交互、表情配合、时序协调,哪个环节断了,你看到的就不是「一个在倒水的人」,而是「一段抽搐的动画」。
半图科技构建的人类行为模型,干的正是这件事:接收意图,输出行为。
具体来说,这套模型能接收文本、语音、音乐等多模态输入,同时读取角色的历史状态、所处环境、周围人和物体的关系。然后把所有这些信息,转化成统一的 3D 行为表示。
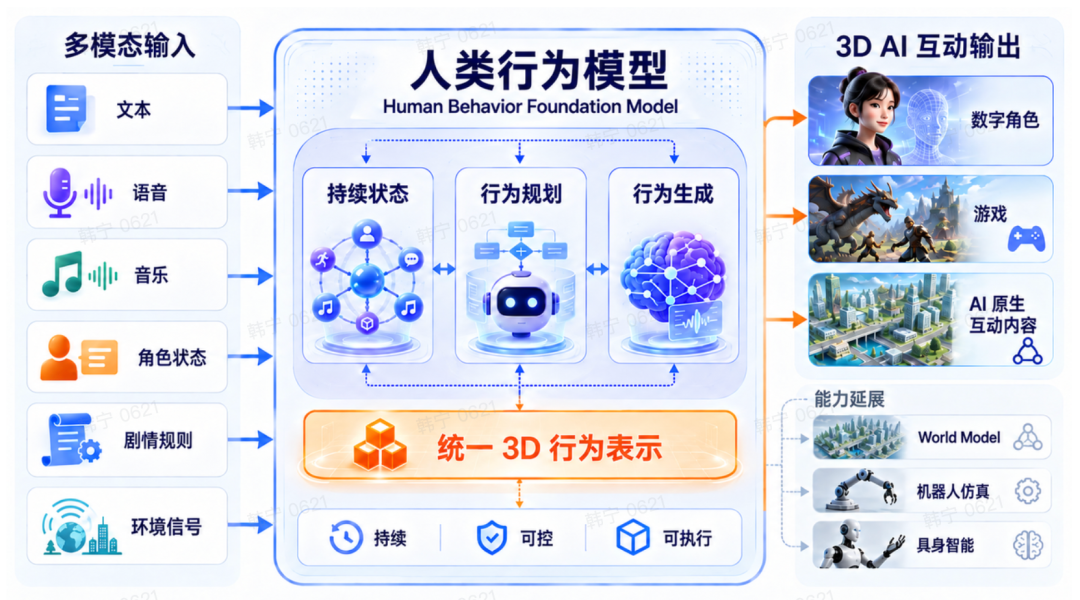
这种行为表示不是一段不可编辑的视频,而是结构化的、可拆解的、可组合的动作资产,能够被不同引擎、不同角色、不同场景复用。
通俗说就是:不是给 Chatbot 套个 3D 外壳,而是让角色真的能理解状态、规划行为、持续回应。
用视频大模型渲染 3D,实现精准的动作和镜头控制。
这个思路解决了行业的几个核心卡点:
第一,目标感。在开发者设计的世界观、任务和规则框架内,让角色做出有变化的、但合理可控的反馈。创作者依然掌握边界,AI 负责在边界内「即兴表演」。
第二,角色立体感。文字只能表达性格,行为才能塑造角色。一个角色的表情、动作、姿态、空间距离、互动反馈,这些加在一起,才是一个完整的「人」。
第三,成本可控。把状态管理、行为资产和实时生成环节解耦,不再每次互动都调用大模型做全量推理。该生成的地方用模型,该复用的地方用资产,该走规则的地方走引擎。
第四,能接入真实管线。输出的 3D 行为可编辑、可迁移,能进入现有的游戏引擎和动画制作流程,策划、美术和动画团队不会被晾在一边。
50 万小时行为数据:从「让 AI 动起来」到「让 AI 动得好看」
正如前文 SIGGRAPH 顶会所展示的那样,「人类行为模型」的建设,是一项极具门槛的美术与计算机图形学的复合工程。
模型再好,没数据也白搭。
训练一个能理解和生成人类行为的模型,需要的不是普通的视频素材。
模型要学的是动作背后的结构:一个人拿杯子时手指怎么弯、转身时重心怎么移、跟人聊天时身体距离怎么变化、不同情绪下走路节奏有什么区别。
这些信息,互联网上有海量的视频「画面」,但几乎没有对应的结构化 3D 数据。传统动捕能采集高质量数据,但成本高、产能低。
这也是为什么过去大部分「让角色动起来」的方案,看起来总差那么一口气。
为了让模型学会人类级别的「表演」,半图科技做了一件极具护城河价值的苦活——建立了一套面向人类行为的超大规模数据生产体系。
从专业表演采集、大规模视频处理、3D 空间重建,到自动标注、仿真与数据合成,把真实的人体动作、手部操作、面部表情、动作节奏、空间轨迹以及人与物体的交互关系,全部转化为结构化的行为数据。
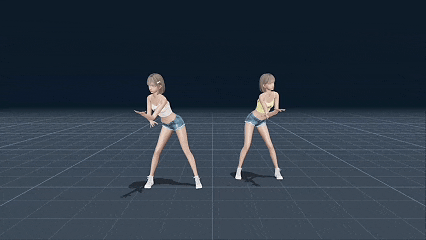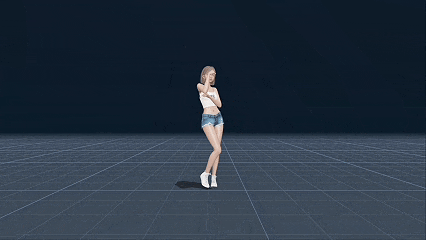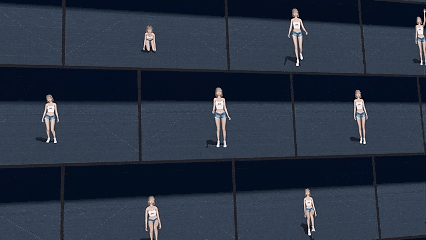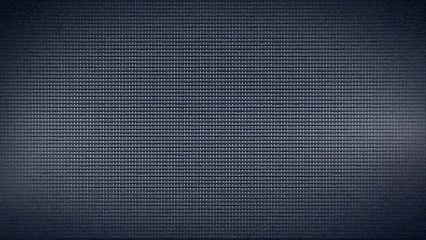
从海量视频与专业表演采集,到包含 3D 身体结构、细粒度动作和连续时序的结构化行为数据
截至目前,他们已经积累了 50 万小时级别的人类行为数据。
但更值得注意的是他们对「行为美学」的强调。
创始人邢骏的说法是,让 AI 动起来不难,难的是让它动得自然、情绪准确、姿态讨喜、细节富含信息。这不是纯算法能解决的,需要 AI、3D 美术、动画、内容设计等多个工种一起攻关。
用他的话来概括半图的技术哲学:AI begins with humans, and ultimately returns to humans。
邢骏的履历支撑得起这种野心:中国科学技术大学本科,香港大学博士,美国南加州大学 ICT 研究院博士后,回国后曾在米哈游担任逆熵 AI 研究负责人。
从好莱坞数字人研究到鹿鸣 AI 技术,他的职业主线始终围绕同一个命题:让数字角色从「像人」走向「是人」。
爆款初现:《代号 Live》达到 72% 的次日留存
技术故事讲得再漂亮,最终得靠产品说话。
为此,半图科技亲自下场,自研了一款 AI 互动产品《代号 Live》,定位全球二次元用户,主打互动养成。
在这款游戏中,用户化身为虚拟偶像「Ria」的运营者。这绝不是一个在屏幕里打字的 Chatbot,而是一个以完整 3D 身体参与互动的「生命」。
这不仅仅是用户为她安排日程、处理事件、帮她学习舞蹈和演唱这么简单。关键在于,用户的每一个选择,都会影响 Ria 的能力、情绪、关系和记忆,并在后续行为中持续体现。
Ria 不只回复文字,她会说话、做表情、跳舞、在空间中移动、跟物体互动。你跟她说的一句话、一次靠近、一个话题变化,都可能改变她后续的表演方式。
在今年 9 月完成的测试中,《代号 Live》交出了一份颇有说服力的数据:次日留存 72%,5 日留存 57%,用户日均互动轮次接近 200 次。
考虑到产品仍在早期迭代阶段,这些数字初步验证了一件事:用户确实愿意为持续、有温度的 3D AI 角色互动买单。
但半图科技自己对这款产品的定位很克制。他们强调,产品是有独立的用户体验和商业化目标的,同时也是模型接受真实需求检验的场景。
测试过程中产生的大量数据——哪些表情用户更容易接受、哪些动作出现频率更高、哪些状态变化最影响互动体验,会直接反哺模型训练和数据生产,形成「数据生产→模型训练→产品验证→反馈迭代」的闭环。
与此同时,半图科技已完成标准化 API 封装和容器化部署,正在与国内外知名游戏娱乐及数字内容企业推进技术接入。合作内容涵盖 3D 动作与表演资产生成、实时角色驱动、跨模态行为调度等。
用一句话概括就是,把自家验证过的行为能力,做成水电煤,接入别人的产品管线。
顶级战队与千万美元重注:从「数字躯体」到「物理世界」
驾驭如此庞大的跨学科系统,离不开一支能够横跨深度学习、图形学、3D 动画、实时引擎的顶尖团队。
半图科技创始人邢骏的履历堪称硬核:本科毕业于中科大,香港大学博士,后赴美国南加州大学 ICT 研究院(好莱坞早期数字人技术重镇)从事博士后研究。回国后,他曾担任米哈游「逆熵」AI 研究负责人。
团队核心成员几乎清一色来自米哈游、字节跳动、腾讯,并聚集了复旦、北大、上交大等顶尖科研人才。近期,前米哈游核心运营成员(曾负责《原神》0-1 海外运营)、前鹰角网络海外业务负责人黄承国也正式加盟出任运营合伙人,彻底补齐了商业落地与全球化的关键版图。
豪华的团队阵容和一条持续十余年的技术主线,让半图科技在近期成功完成了单轮超千万美元的融资。本轮由联想创投等多家国内及海外一线资本领投,老股东 IDG 资本持续加码。
但半图科技的野望,远不止于游戏屏幕之内。
无论载体是虚拟角色还是具身智能,一个能够与人持续互动的智能体,都需要理解环境、决定下一步行动,并将意图转化为自然可执行的物理行为。这两者的底层逻辑是完全相通的。
目前,半图科技的这套「人类行为模型」,正在自然地向物理世界延展。
公司已与国内外知名的游戏娱乐公司,以及国内头部具身智能企业推进技术接入与商业合作,将人类行为数据与模型能力接入合作方的仿真和训练体系中。
写在最后
回到最开始那个问题:当 AI 学会了造世界,谁来教角色怎么「活」?
整个 3D AI 赛道正在经历一次重心迁移。过去两年,所有人都在追「生成」——生成画面、生成场景、生成资产。
但当生成的门槛持续降低,真正拉开产品差距的,不再是谁能造出更精美的世界,而是这个世界里的角色,能不能让你觉得它是「活的」。
半图科技选择从人类行为数据出发,构建理解、生成和驱动行为的模型能力,再通过真实产品和产业合作持续验证。
他们在认真回答一个行业级的问题——AI 不只要能生成 3D 世界,还得让角色在这个世界里持续行动。
能把这件事做成的人,大概率正在定义下一代互动体验的底层基础设施。
正如半图科技团队所坚持的信仰:AI 始于人类,最终也将回归人类。而在云栈社区,围绕「人类行为模型」与 3D AI 角色的技术讨论,也刚刚开始升温。
 发表于 昨天 20:21
|
查看: 2|
回复: 0


