面试考察点
- 基础掌握度:别以为面试官只想听你背几个名词,他真正想看的是你能不能把 Broker、Topic、Partition、副本这些组件之间的关系讲清楚,串成一张完整的图。
- 架构演进认知:Kafka 这几年最大的变化就是去 ZooKeeper 化(KRaft 模式)。知不知道这个演进,是区分“用过 Kafka”和“持续关注 Kafka”的分水岭。
- 原理深度:分区副本机制、Leader/Follower、Controller 这些偏原理的东西,能不能在架构层面讲明白,决定了这道题是拿 70 分还是 95 分。
核心答案
先说结论:Kafka 是一个分布式发布-订阅消息系统,整体架构可以概括为“一横一纵一协调”:
- 一横(存储层):Broker 集群 + Topic 分区 + 多副本,负责存储和高可用
- 一纵(读写层):Producer 写入、Consumer Group 消费,负责数据流入流出
- 一协调(管控层):老版本靠 ZooKeeper 管元数据,新版本(KRaft 模式)Kafka 自己管理
| 组件 |
一句话说明 |
Producer |
生产者,往 Topic 里写消息,自带负载均衡 |
Broker |
一个 Kafka 服务器实例,负责存储和转发消息 |
Topic |
消息的逻辑分类,类似数据库里的表 |
Partition |
Topic 的物理分片,扩展性和顺序性的基本单位 |
Replica |
分区副本,Leader 负责读写、Follower 负责同步 |
Consumer Group |
消费者组,组内分摊分区,组间互不影响 |
ZooKeeper / KRaft |
协调层,管元数据和 Controller 选举(新版已去 ZK 化) |
深度解析
一、整体架构图
先上一张全局图,脑子里有这张图,后面聊什么都不慌:
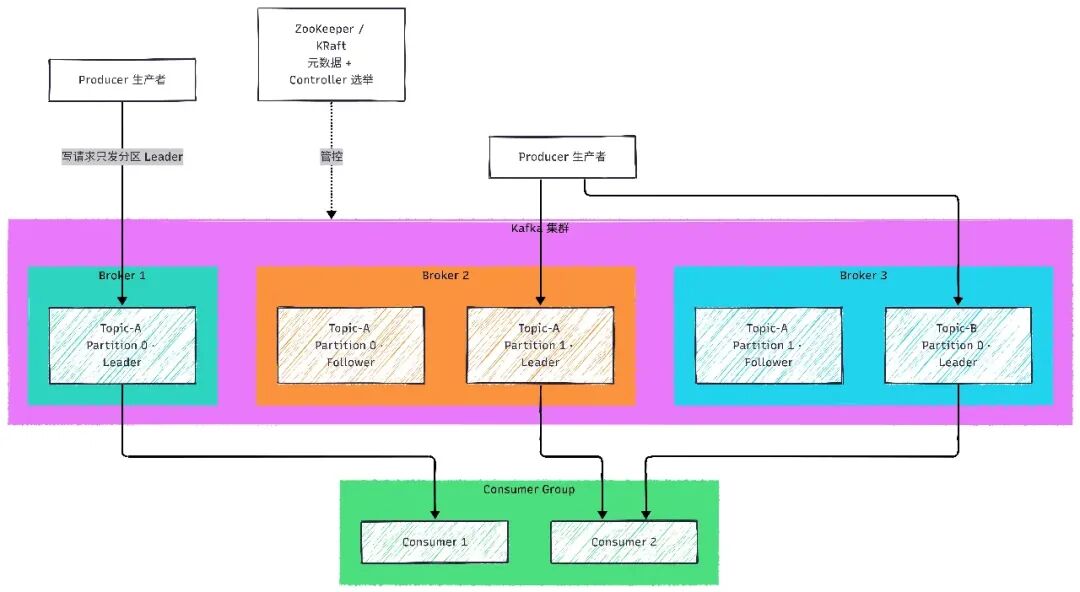
对照这张图,把几个关键点捋一遍:
- 写入只走 Leader:Producer 发消息,不管连的是哪个 Broker,消息最终都会路由到目标分区的 Leader 副本上,Follower 不接生产者的写请求
- 消费也只走 Leader:Consumer 拉消息同样只从 Leader 拉,Follower 是纯备份
- 分区打散在多个 Broker:Topic-A 的 Partition 0 和 Partition 1 分布在不同 Broker 上,写入压力就被分摊开了,这就是 Kafka 水平扩展的底气
- 消费者组内分摊分区:一个分区同一时刻只会被组内一个消费者消费,Consumer 2 一个人扛 Topic-A 的 Partition 1 和 Topic-B 的 Partition 0,这是消费端负载均衡的基本盘
- 协调层负责管“谁是老大”:集群元数据、Controller 选举这些全局性决策,交给 ZooKeeper(老版本)或 KRaft(新版本)
二、核心组件逐个拆
1. Broker:干活的节点
一个 Broker 就是一个 Kafka 服务实例,多个 Broker 组成集群。注意 Kafka 是对等架构,没有“主节点”这一说,每个 Broker 都能响应客户端请求,你连上任意一个都能拿到全集群的元数据。
2. Topic 与 Partition:逻辑与物理的分离
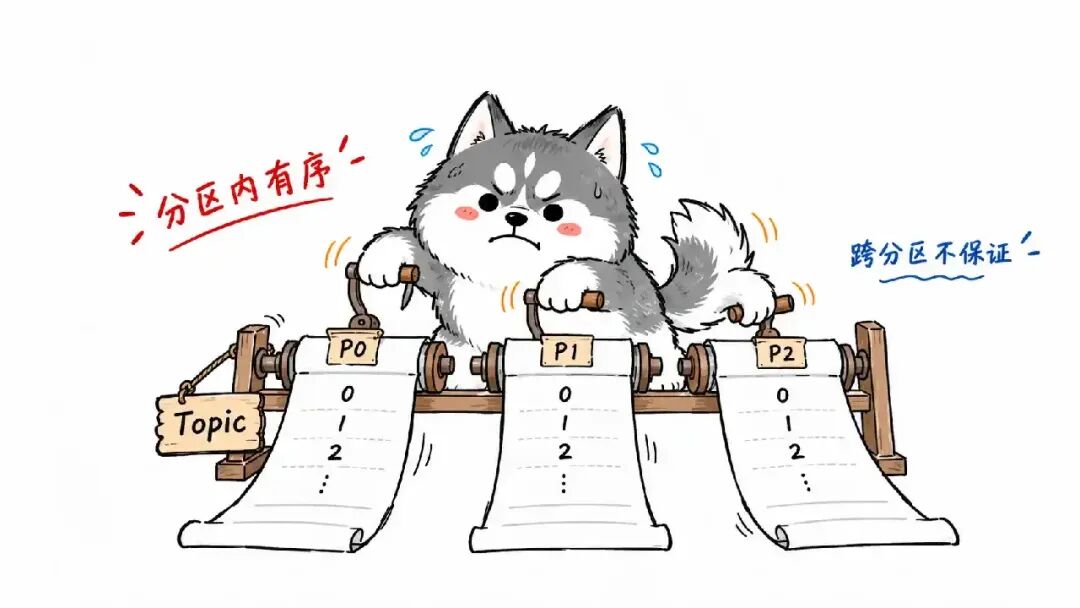
Topic 是逻辑概念,比如“订单消息”是一个 Topic,但真正存的时候会被切成多个 Partition,每个 Partition 是一个不可修改的日志文件(只能追加写入):
- 分区是水平扩展的基本单位,分区越多,能摊到的 Broker 越多,并行度越高
- 每条消息在分区内有个单调递增的 offset,所以分区内有序、全局无序
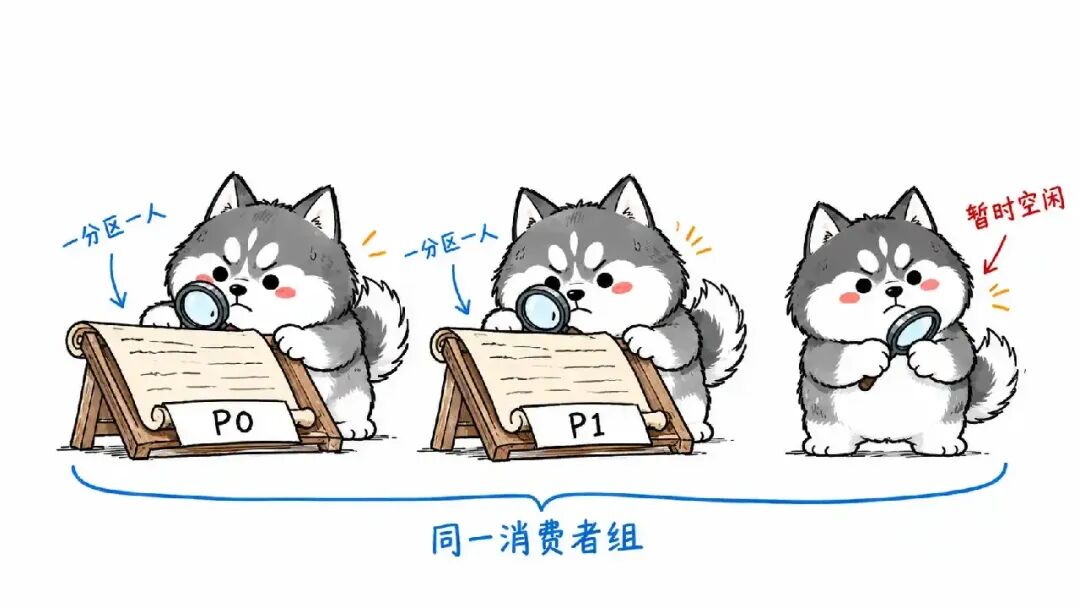
- 消费并行度的上限就是分区数:一个消费者组里消费者数量超过分区数,多出来的消费者闲着
3. Replica:高可用的根基
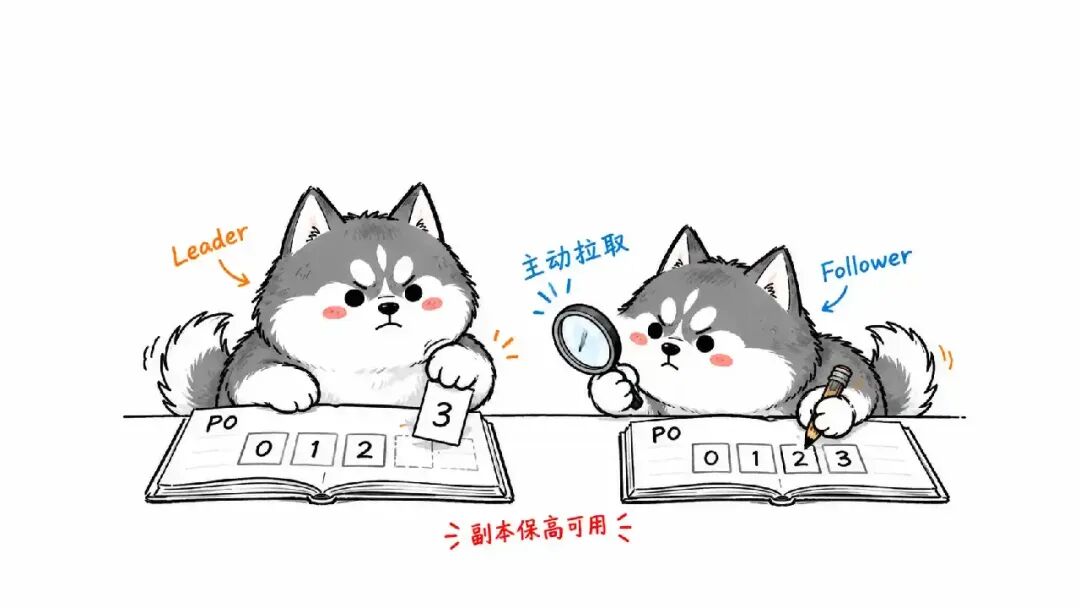
同一个分区可以配置多个副本,生产环境一般 3 个。副本分两种角色:
- Leader 副本:分区的“正主”,读写都走它
- Follower 副本:不停地从 Leader 拉数据同步。Follower 挂了不影响读写;Leader 挂了,Controller 会从 ISR 里挑一个 Follower 顶上,整个切换是秒级的
这里的ISR(In-Sync Replicas,同步副本集合)是个高频考点:只有跟 Leader 保持同步(默认超过 replica.lag.time.max.ms = 30 秒没跟上就会被踢出去)的副本才有资格被选为新 Leader。Kafka 用这套机制在“高吞吐”和“不丢消息”之间做了个漂亮的权衡。
4. Producer 与 Consumer Group
- Producer 发消息时自己算路由:指定分区就直发;指定了 key 就对 key 哈希取分区(同一个 key 永远进同一个分区,这就是按 key 保序的原理);都没指定就按批次轮询(粘性分区)
- Consumer Group 是 Kafka 消费模型的核心:组内消费者分摊分区(点对点模式),不同组各自独立消费同一份消息(发布-订阅模式)。一套机制同时支持两种消费语义,这个设计确实优雅
5. 协调层:从 ZooKeeper 到 KRaft
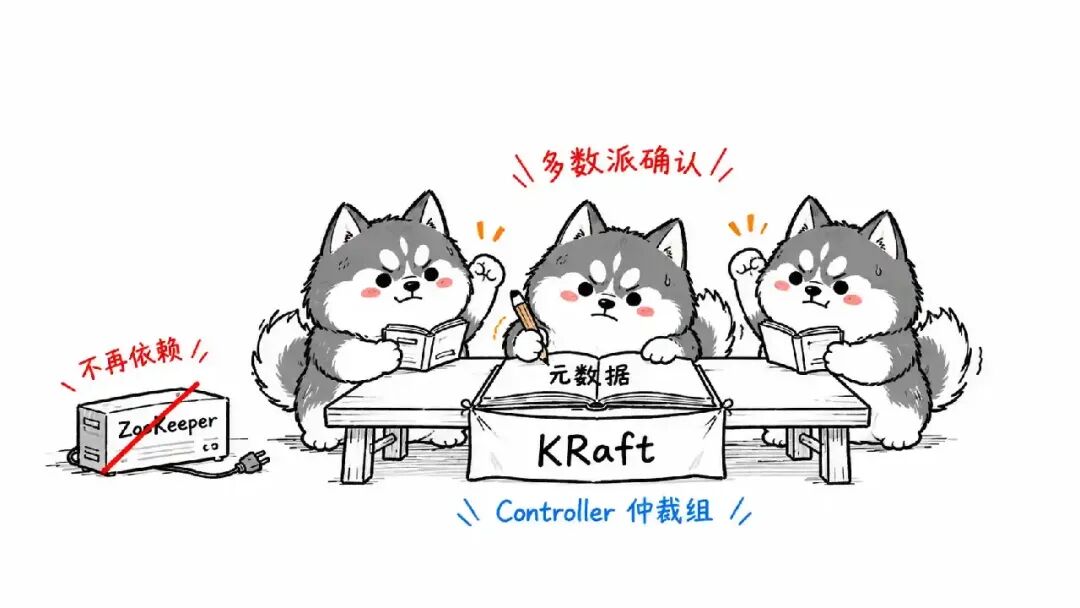
老版本里 ZooKeeper 承担了三件事:存元数据、选 Controller、协调消费者组。但 ZK 慢慢成了 Kafka 的瓶颈:元数据多了之后 Controller 故障切换要好几秒,大规模分区场景下更明显。于是有了去 ZK 化的演进:
- 2.8(2021.4):引入 KRaft 模式(Kafka Raft),早期试用
- 3.0:KRaft 预览版
- 3.3(2022.10):KRaft 对新集群生产可用
- 3.7:老集群从 ZK 迁移到 KRaft 生产可用
- 4.0(2025.3):彻底移除 ZooKeeper,KRaft 成为唯一模式,元数据存在一个叫
__cluster_metadata 的内部 Topic 里,靠 Raft 协议自己选主
面试的时候能主动带出 KRaft 这条演进线,说明你关注技术的发展,而不是抱着三年前的资料背书。这块很多老教程压根没提,反而成了新的信息差。
三、一条消息的完整旅程
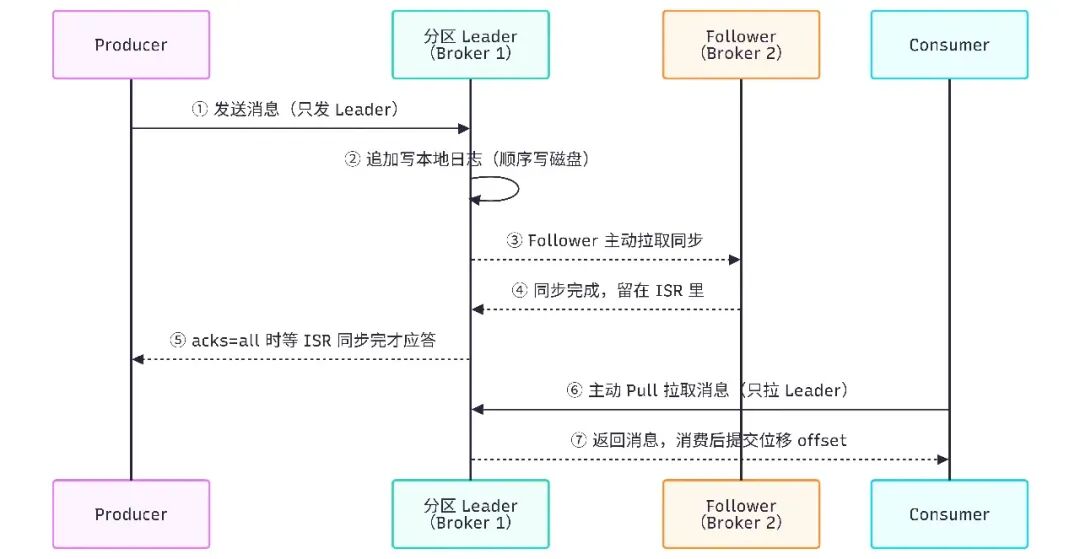
架构图是静态的,再把一条消息从生到死的动态过程串一遍:
几个细节单独说一下:
- 第 ③ 步是 Follower 拉而不是 Leader 推:Follower 主动去 Leader 那里同步数据,好处是每个 Follower 可以按自己的节奏来,慢一点的顶多被踢出 ISR,不会拖垮 Leader
- 第 ⑤ 步的 acks 是消息不丢的关键:
acks=all 表示 ISR 里的副本都同步完才认为写入成功,生产环境对可靠性有要求的场景都这么配
- 第 ⑥ 步消费是 Pull 模式:Kafka 不像传统 MQ 由 Broker 推消息,而是消费者自己来拉。消费能力强的拉快一点,能力弱的拉慢一点,Broker 完全不用操心每个消费者的节奏,这天然就是削峰
四、架构背后的设计思想(面试官真正想听的)
光背组件只能拿及格分,能讲出“为什么这么设计”才是拉开差距的地方:
- 为什么有分区? 单机的存储容量和写入吞吐有上限,分区让 Topic 的数据打散到多台机器,写入和消费都能并行
- 为什么有多副本? 机器说挂就挂,副本保证单点故障不丢数据;而 ISR 机制保证新 Leader 一定是数据最全的那批副本之一
- 为什么快? 顺序写磁盘 + 页缓存 + 零拷贝 + 批量压缩,这几个特性共同支撑了百万级 TPS,架构上体现为“消息只追加、消费靠 Pull”(追问 Kafka 为什么快时会单独展开)
- 为什么去 ZooKeeper? 外挂协调系统多了运维成本和性能瓶颈,元数据自治让 Kafka 更轻、故障恢复更快
面试高频追问
- Kafka 为什么这么快?——顺序写、页缓存、零拷贝、批量与压缩、分区并行,每一块都能单独展开聊十分钟
- ISR、HW、LEO 是什么关系?——ISR 是同步副本集合,LEO 是每个副本下一条待写入的 offset,HW(高水位)是所有 ISR 副本都同步到的位置,消费者只能消费到 HW 之前
- Rebalance 什么时候触发?——消费者组成员变化(加入/退出/挂掉)、订阅的 Topic 数量变化、Topic 分区数扩容
- 怎么保证消息不丢、不重、有序?——生产端
acks=all + 重试,Broker 端副本数 ≥ 3 + min.insync.replicas ≥ 2,消费端手动提交位移;有序靠“同 key 进同分区”;不重需要消费端幂等
常见面试变体
- “Kafka 的核心组件有哪些,分别干什么?”
- “Topic、Partition、Replica 三者是什么关系?”
- “Kafka 为什么要引入 KRaft?ZooKeeper 不是用得好好的吗?”
记忆口诀
“生产者写 Leader,消费者拉 Leader,Follower 只备份;分区管扩展,副本管高可用,ZK/KRaft 管协调。”
总结
一句话:Producer 把消息写到 Topic 的多个分区(只写 Leader),Follower 同步副本保高可用,Consumer Group 按组分摊分区消费,元数据由 ZooKeeper(老版本)或 KRaft(新版本)协调。把分区、副本、ISR 这条线讲清楚,再带上 KRaft 的演进视角,这道题就稳了。更多 Kafka 实战与分布式架构的深度内容,欢迎在 云栈社区 交流讨论。 |  发表于 昨天 23:02
|
查看: 3|
回复: 0


