上一篇我们拆解了 GPT-Live:全模态、全双工、端到端:GPT-Live 之后被用坏了。
当时留了个尾巴:能边听边说的模型,市面上到底有几个?为了选型,我在 云栈社区 翻了不少讨论,又逐家啃了一遍协议文档和源码,最后摆上桌的一共 11 个。今天就来盘一盘,希望对正在做语音模型选型的朋友有点帮助。
三类架构,11个模型
沿用上一篇的三类架构来分:级联 1 个、回合制端到端 2 个、全双工 8 个。比较时主要看五个维度:全双工、工具调用、视频输入、并发能力和数据出域情况。
| 方案 |
全双工 |
工具 |
视频 |
并发 |
出域 |
| GPT-Live / OpenAI Realtime |
✅ |
✅ |
✅ |
独占会话 |
境外 |
| Gemini Live |
✅ |
✅ |
✅ |
独占会话 |
境外 |
| Qwen3.8 Omni Realtime |
✅ |
✅ |
✅ |
独占会话 |
境内·出域给百炼 |
| StepAudio 3 |
✅ |
✅ |
❌ |
独占会话 |
境内·出域给阶跃 |
| Qwen Audio 3.0 Realtime |
✅ |
✅ |
❌ |
独占会话 |
境内·出域给百炼 |
| Doubao Seeduplex 3.0 |
✅ |
✅ |
❌ |
独占会话 |
境内·出域给火山 |
| Moshi |
✅ |
❌ |
❌ |
独占·约 24GB/路 |
自部署·不出域 |
| MiniCPM-o 4.5 |
✅ |
❌ |
✅ |
独占·一卡一路 |
官方云出域/自部署不出域 |
| Step-Audio 2 mini |
❌ 轮次 |
✅ |
❌ |
自部署 |
不出域 |
| Qwen3-Omni |
❌ 轮次 |
✅ |
✅ |
自部署 |
不出域 |
| HF speech-to-speech |
⚠️ 级联 |
✅ |
❌ |
池化·高一个量级 |
不出域 |
注:表中"视频 ✅"均指摄像头 JPEG 帧输入(非真视频流),各方案普遍约 1 帧/秒。
下面按三类架构逐个过一遍。
全双工架构
8 个全双工模型,按"闭源还是开源"来分。
云端(闭源)模型
云上的都是按分钟卖,闭源,会话独占。视频、工具、全双工同时在线,只有三家:
- Gemini Live:三全,但境外服务。
- Qwen3.8 Omni Realtime(百炼):境内唯一三全,官方文档明写 Function Calling,前端工具全量可用。
- GPT-Live / OpenAI Realtime:API 已于 2026-09-10 开放,前端语音层 $0.05/分钟,后端模型和 Agent 另算;视频靠
input_image 帧输入,消费端的视频通话仍在开发。
保留全双工、能原生调工具,但没有视觉输入的,也是三家:
- StepAudio 3(阶跃):自定义 function calling 经官方 live 实测,但官方自报两个瑕疵——打断偏频繁、有时口头请示却不调工具。
- Qwen Audio 3.0 Realtime(百炼):音频专精家族,无视觉。
- Doubao Seeduplex 3.0(火山):工具结果续行语义最完整,无视觉。
共同点很明显:都是云端按分钟卖的独占会话,想多开并发就得多占会话、成本线性往上走。
开源模型
开源能全双工的,就两个,而且各缺一块。
Moshi
Github 地址:https://github.com/kyutai-labs/moshi
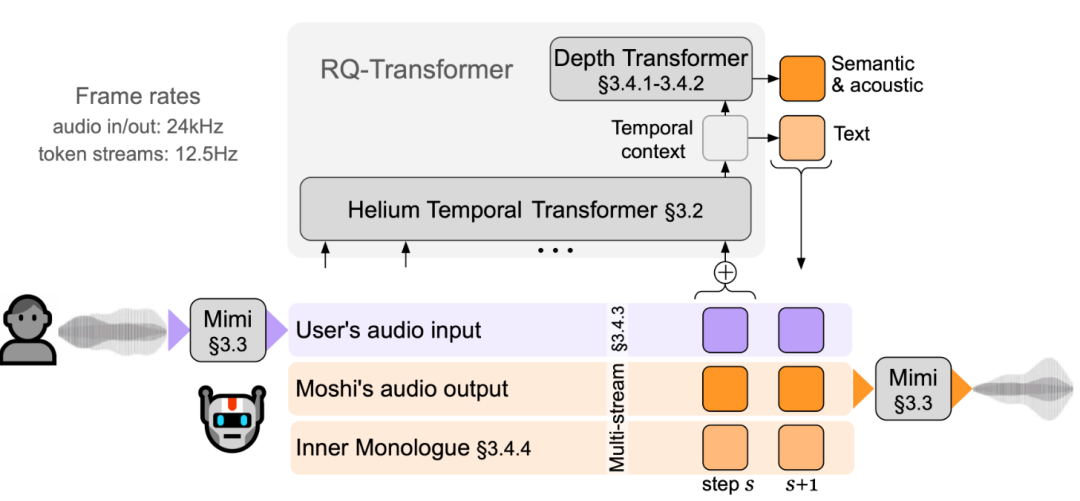
2024-07 开源:用户音与自身音双流并行建模 + inner monologue,架构上就没有说话人轮换,理论延迟 160ms、H100 实测约 200ms。
但它纯音频、无视觉、基座没有 function calling,且以英/法为主——中文场景不达标。
官方后来用 MoshiRAG 给它补外部知识:模型自预测一个 retrieval trigger token → 后端异步检索 → 参考文本经 reference encoder 注回条件路径,检索期间前端照常听说。不过这是加新 token、重新微调发布权重,是改模型,不是协议层工具调用。
MiniCPM-o 4.5
Github 地址:https://github.com/OpenBMB/MiniCPM-V
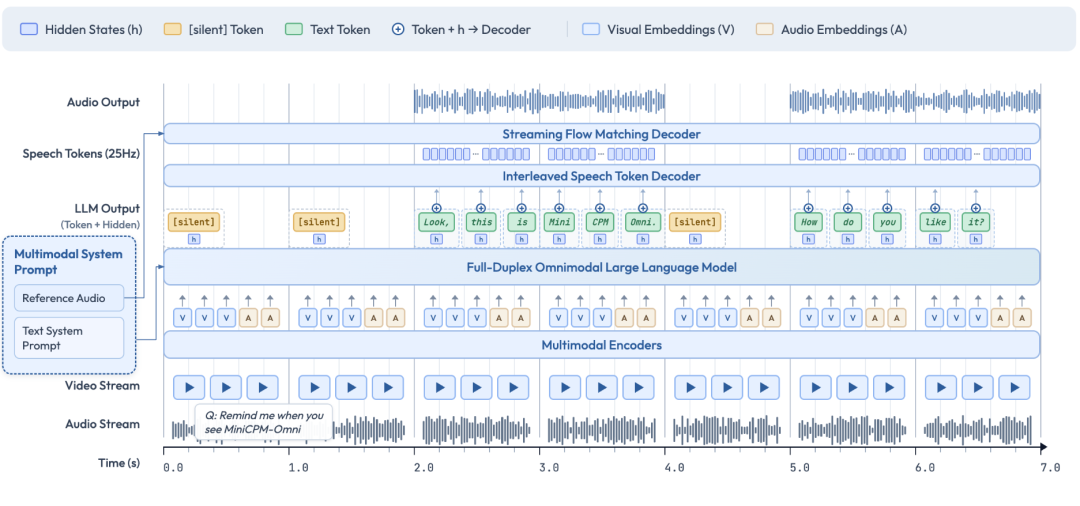
开源里唯一带视频帧、且中文可用的全双工。16k 进 24k 出,体验像打电话。
但公开 Realtime 协议没有定义结构化 function-call 事件——工具调用、文字输入、历史恢复、记忆写入、后台委派,在这个 provider 下整体不可用。
一句话:开源全双工两个,一个缺中文和眼睛,一个缺手。
回合制端到端架构
两个,都开源,都能原生调工具——但都要等你说完才接话。
- Step-Audio 2 mini(阶跃,~7B):原生 function calling 是官方主打卖点,带 toolcall 评测基准,vLLM 有专用 parser;纯音频 + 文本。
- Qwen3-Omni(Thinker-Talker MoE):全模态,文本、图像、音频通吃;工具调用走 Thinker 的文本路径。但它的全双工 Realtime 版只在百炼云上(就是 2.1 里的 Qwen3.8 Omni),开源版是回合制,得等你说完。
会调工具,但要等你说完——这就是它和全双工的分界。
级联架构
Github 地址:https://github.com/huggingface/speech-to-speech
VAD → STT → LLM → TTS 拼装,用 Silero VAD v5 判轮次。
好处是组件可替换、可池化批量,并发比全双工独占会话高一个量级;工具挂在透明的文字层,最容易接。
代价是语音样噪声(电视、旁人说话、音箱回授)会误触发打断,得调高检测阈值或播放期闭麦缓解。
结论与选型
三条结论
1. 视频、工具、全双工,只有三家云,开源一个都没有。
Gemini Live、Qwen3.8 Omni、GPT-Live——全在云上,全闭源。
2. 开源全双工只有两个,各缺一块。
Moshi 缺中文、缺视觉;MiniCPM-o 缺工具调用。
3. 体验和并发,只能二选一。
全双工是独占会话——自己部署时最直观:以 MiniCPM-o 为例,一个 Worker 独占一块 GPU,想并发就得堆卡、成本按卡时走。级联把 STT/TTS/LLM 拆开池化,并发能高一个量级。
怎么选
按场景挑架构:
- 陪练、陪伴、视觉辅助、硬件入口——对话本身就是产品,不需要查东西 → 全双工。
- 查资料、办业务、知识问答——要调工具、要并发 → 级联。
- 两边都要(既要全双工又要工具)→ 只有百炼 Qwen3.8 Omni,境内唯一三全,代价是出域 + 按分钟。
写在最后
本文盘点了 11 个能"边听边说"的语音模型。那个开源唯一带视频帧、中文可用的全双工——MiniCPM-o,我们也把它接上了,部署在 https://live.qlcloud.top ,感兴趣的可以去体验一下。
 发表于 半小时前
|
查看: 5|
回复: 0


