想用单一固定参数找出一个全市场通吃的因子,基本是件不可能完成的任务。
比如把 n=20 代入各大类因子跑一跑,结果往往非常一致地令人丧气:同一个因子在某一品种上可能表现尚可,换到另一品种就跟抛硬币差不多随机;或者在某些年份成绩亮眼,换一段行情就变成了一坨粑粑。
投研走到这一步就卡住了,人们会尝试各种办法解决问题。有人一条道走到黑,调参数、加过滤条件,逐渐遁入过拟合的境地。
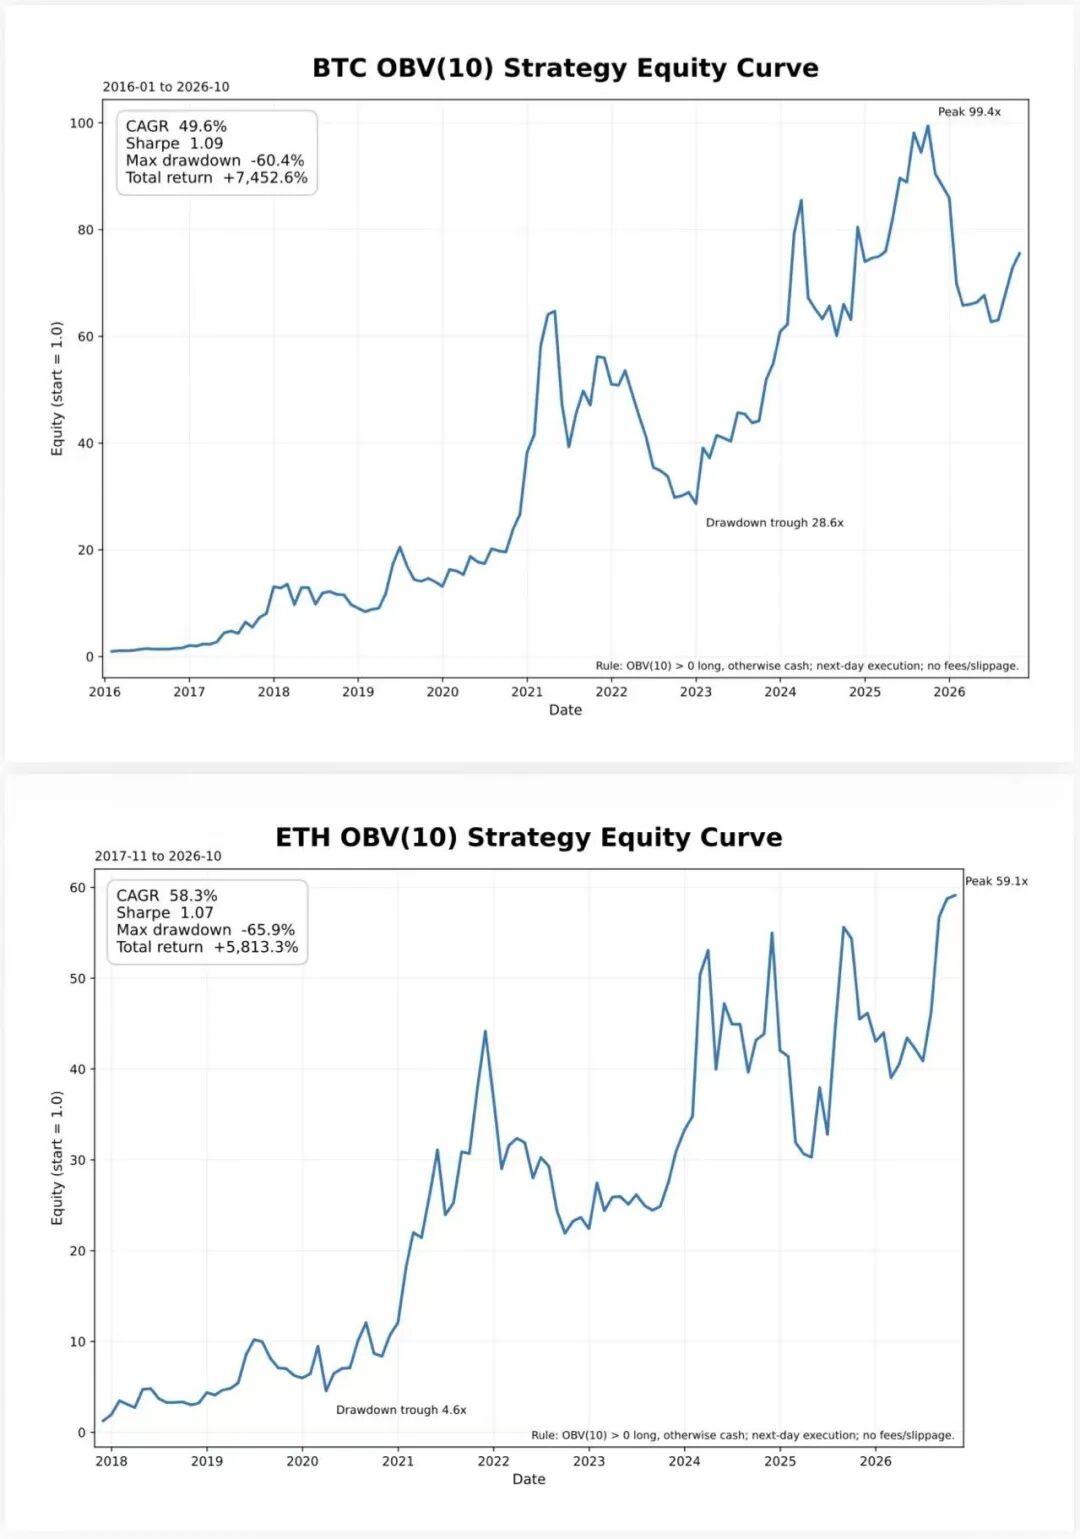
过拟合的路径通常是这么走出来的:先发现一个在若干品种上表现不错的因子,比如 OBV(n=10)。拿这个因子去做多品种回测,权益曲线看起来相当能打:
这个因子在商品期货上的表现同样可圈可点:
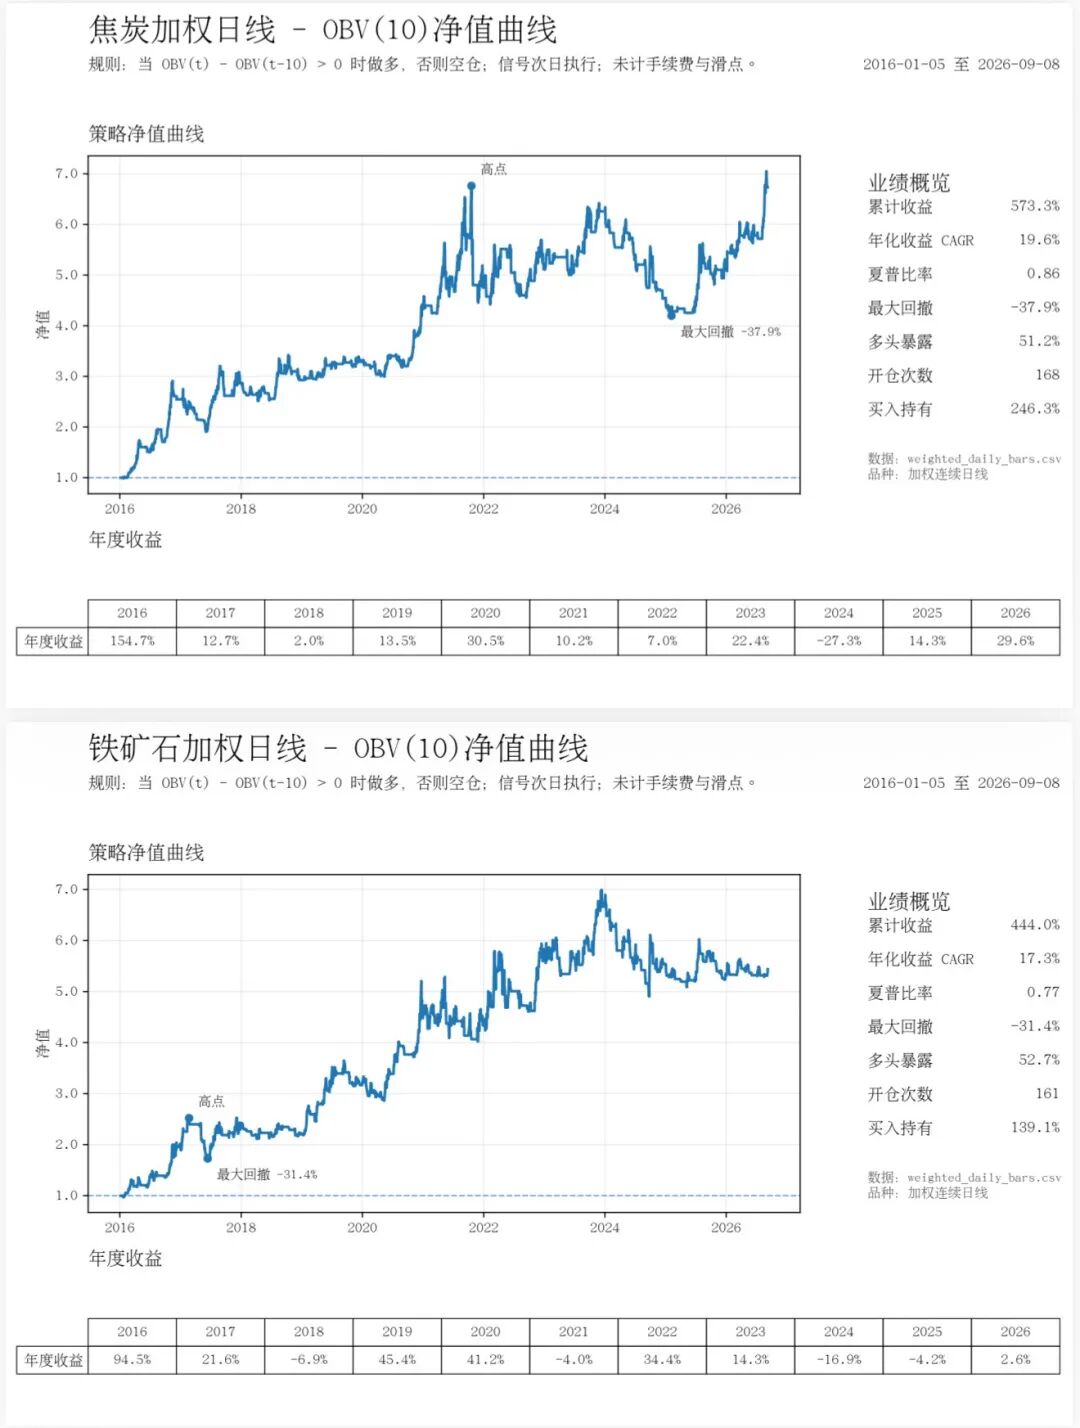
很自然的下一步就是:OBV 的收益虽然可观,但过程实在太颠了。怎么去平滑曲线、把回撤压下来?
于是各种过滤条件轮番登场。这里的过滤包括加入更多择时规则(比如用价格与 60 日均线的相对位置来约束开仓)、加入更短或更长周期的特征、加入 sigmoid、tanh 这类门控筛选、再纳入截面强弱与资金费率等更多市场维度。
最后得到的因子表达式可能是这样的:
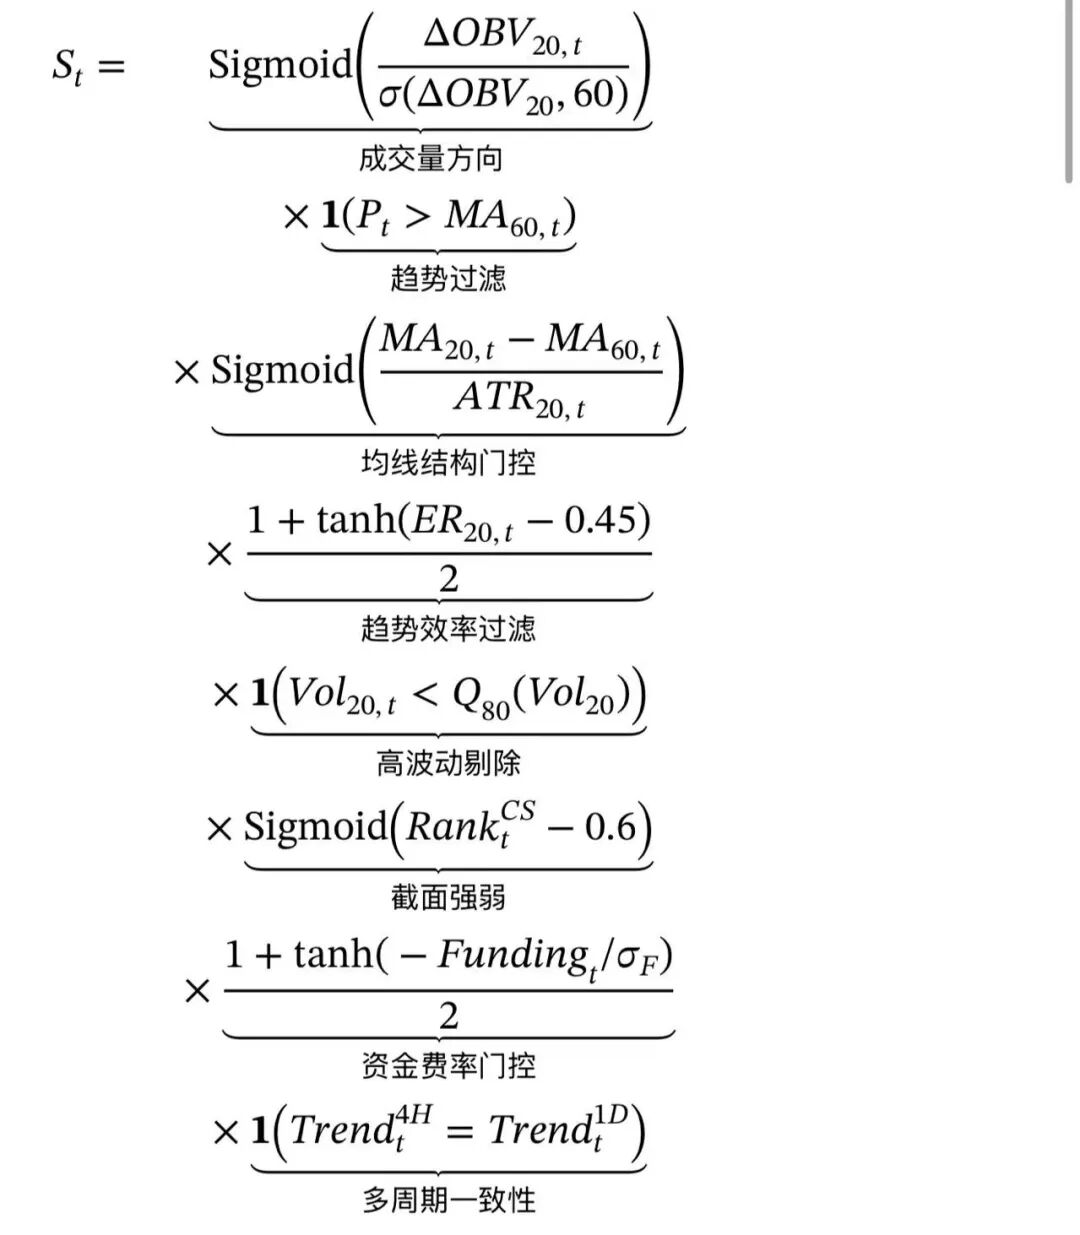
一个八条腿、参数全部写死的“缝合怪”,你敢拿着它上实盘吗?
也有人对参数自由度做了合理的设计。他们不再死磕“哪个 n 才是对的”,而是把多个参数组合起来再做加权处理。比如 n=10 抓短趋势不错,n=30 表现也还行,n=50 能捕捉长趋势,与其定死一个参数,不如“既要又要”。
最简单的做法是等权相加;复杂一点的,根据历史特征(稳定性、波动率等)给不同参数分配权重。复杂做法说到底还是一棵枝繁叶茂的决策树。
但以上两种都不是最优解,这道参数题其实有更好的破法。
不妨举个例子。假设把“连续 n 个交易日价格没有明显位移”定义为震荡,那么 n 到底取多少,范围极广——有些股票能横盘一年,有些磨五个交易日就又走出方向了。
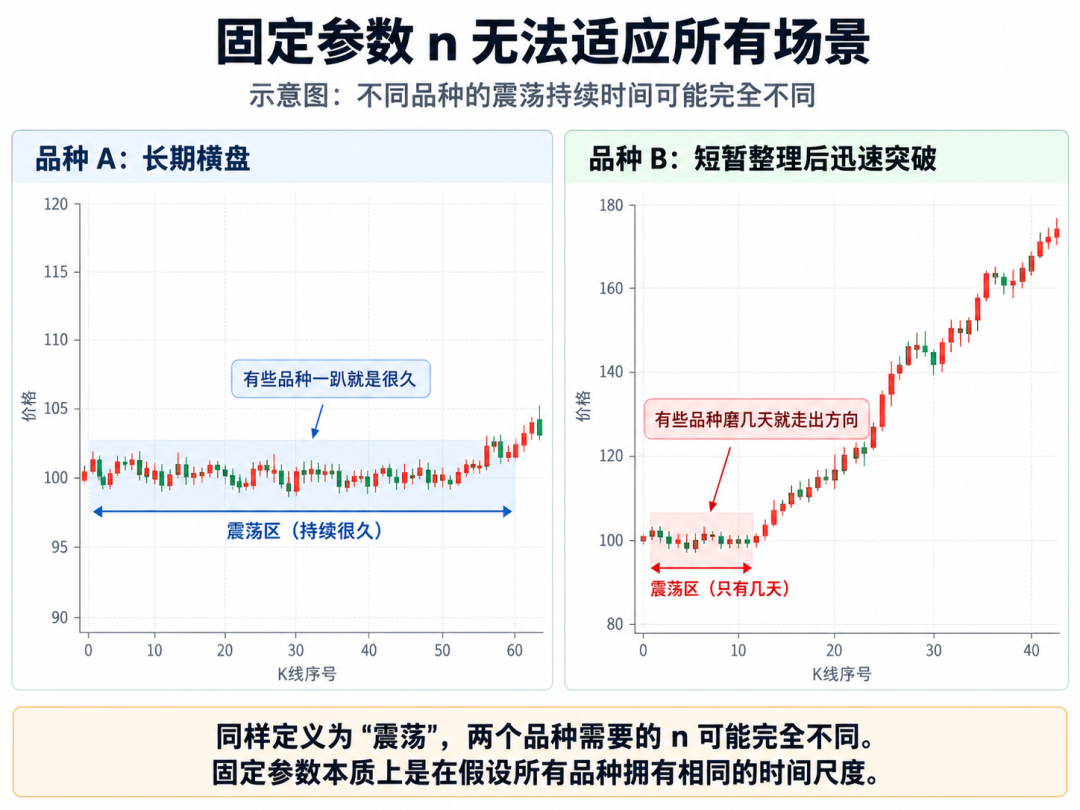
其他经典因子同样有这个毛病。传统动量因子在不同市场上的有效尺度就不一样:有些市场的动量只能维持几天,有些趋势能延续半年。黄金、股指、商品、加密货币各自的有效动量周期可能天差地别。
几乎所有技术因子都绕不开同一个问题:参数本质上是在规定“用多长的尺子量市场”,但不同品种、不同阶段的市场节奏根本不一样。
解法之一是做一把“自适应的尺子”。下面用震荡行情的定义来说明。
这里用 ER 路径效率系数来定义震荡,它的原始公式如下:
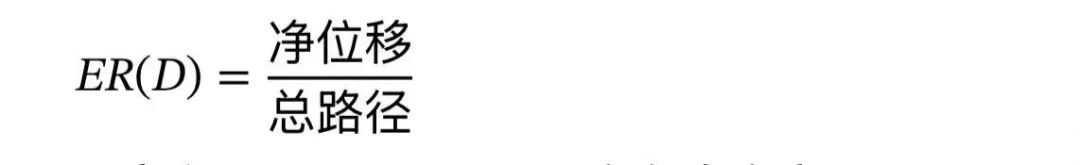
ER 越大,行情越偏向趋势;ER 越小,价格就越接近震荡。
如果你有足够多的市场观察,就会发现震荡在不同时间尺度上的定义是有差异的,这个差异可以用一句话概括:
时间尺度越短,对价格收敛程度的要求越严格。
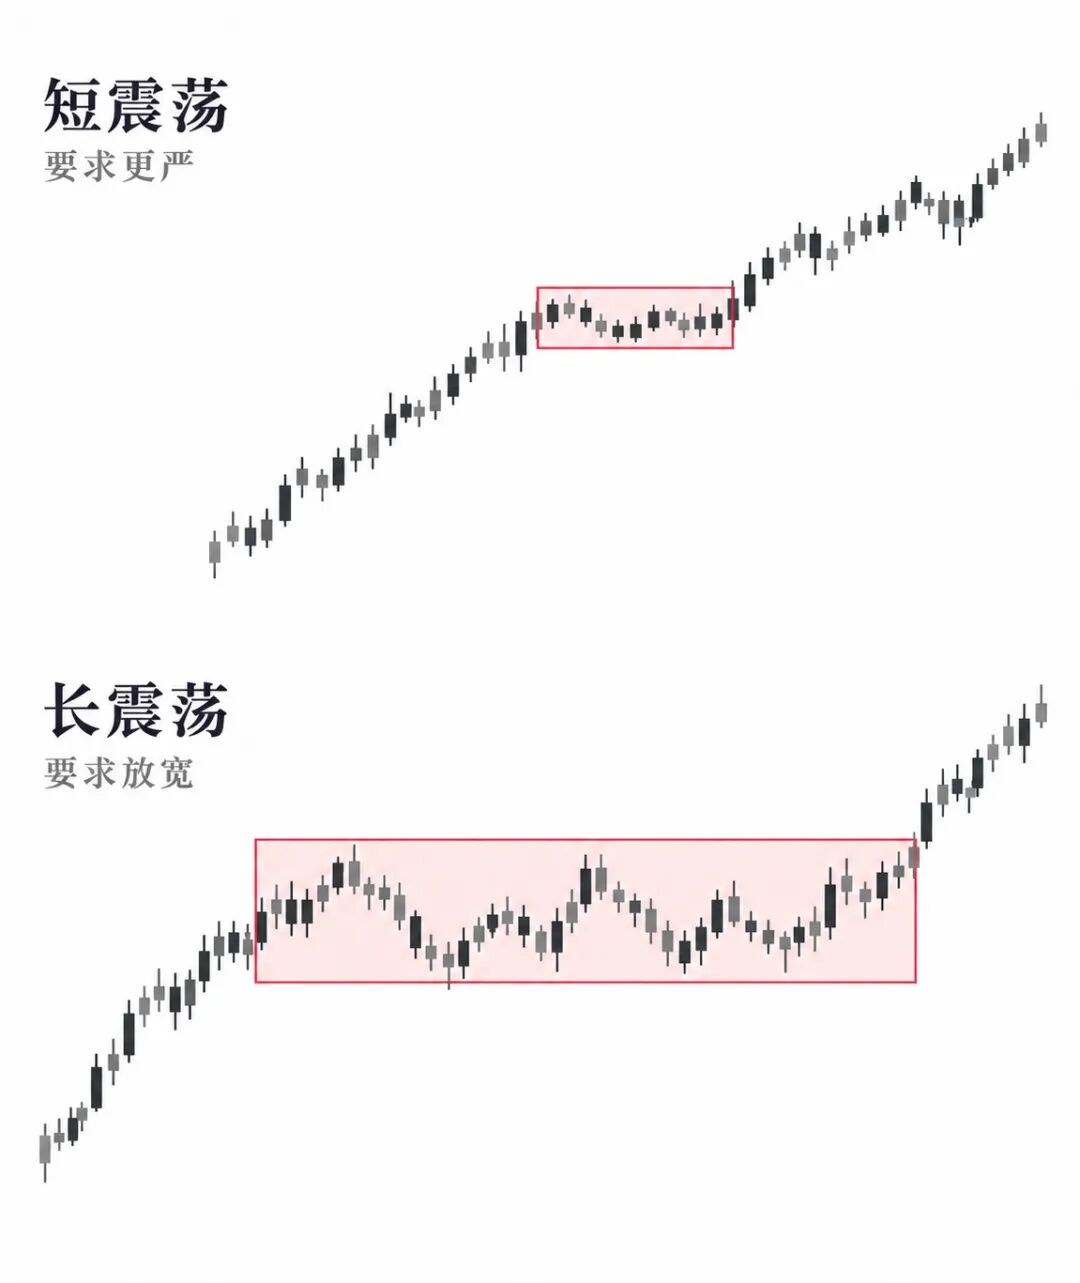
因此,很难用一个固定的时间窗口 n 来定义震荡。那参数自由度过大的问题该怎么解?
把参数改成函数,是解决这个问题的一条好路子。 ER 可以设计成一个“衰减函数”:
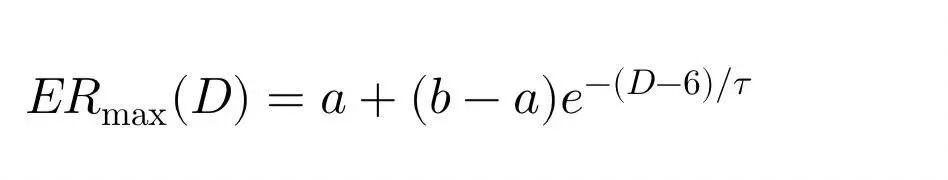
这个函数回答了这样一个问题:当窗口长度是 D 时,ER 的最大允许值是多少,才仍能被判为震荡。
公式中的 6 是我自己定义的参数,代表震荡最少需要 6 根 K 线。其余参数解释如下:
- D:震荡候选窗口长度,比如 6 根、20 根、60 根 K 线
- b:最短窗口 D=6 时的 ER 阈值
- a:当窗口变得很长时,ER 阈值最终趋近的长期水平
- τ:控制阈值从 b 向 a 变化的速度
当 D = 6 时,ER_max 恰好等于 b,也就是最短震荡所对应的 ER 阈值;当 D 不断增大,ER_max 逐渐趋近于 a。所以整条函数就是随窗口延长、从 b 平滑收敛到 a 的曲线。
它刚好刻画了“时间越长,对震荡的要求越松”这一直觉,把“视觉特征”翻译成了数学定义,把原本的常数参数改写为随市场尺度变化的函数。
接下来的工作就不再是寻找一个固定的 D,而是确定不同 D 分别对应什么阈值。
还有什么思路能绕开固定参数的弊端吗?有代码就必然会有参数。但代码真的是必选项吗?
我把一批依据 pullback 信号的开仓点位喂给 AI,让它去识别类似的信号形态。下面是 AI 返回的模板图:
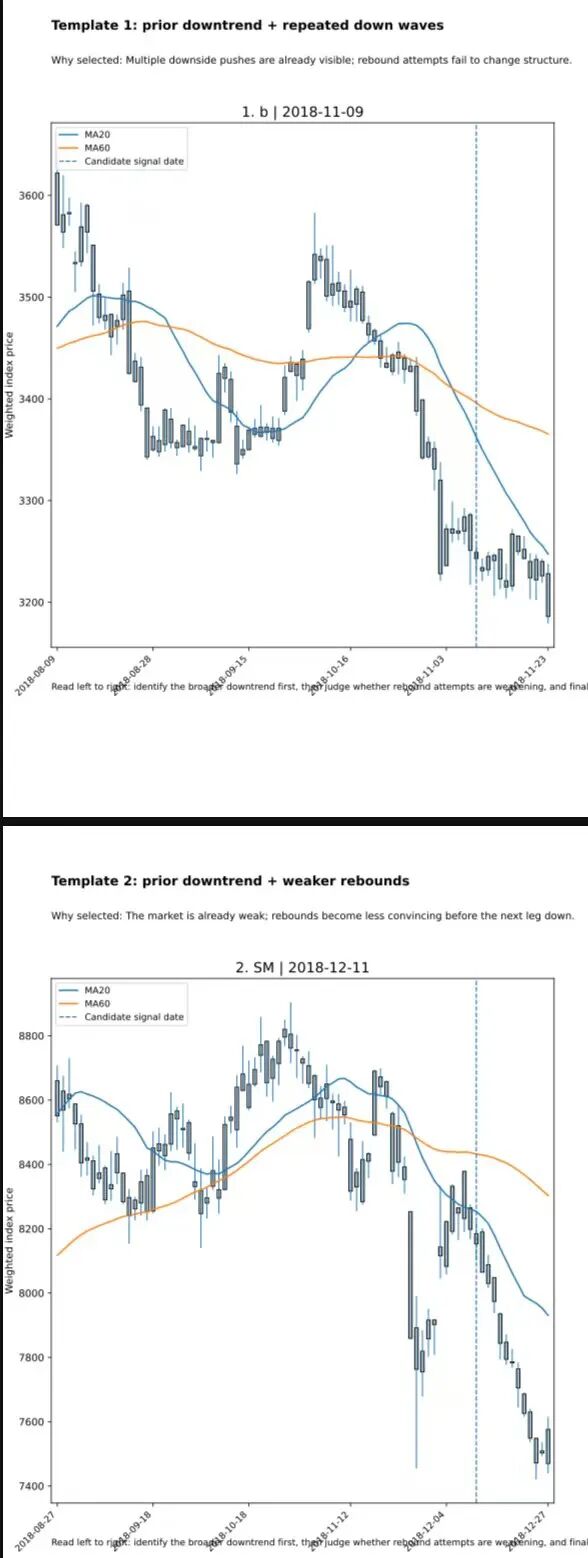
AI 的图像识别能力已经相当出色,依托AI 大模型的视觉理解能力,它几乎可以复现我靠肉眼做出的交易决策。这种能力在未来只会继续增强。所以,量化交易很可能走向“去代码、去参数化”,由多个 agent 分别负责交易决策的不同环节。
在量化圈,对 AI 工具的使用目前呈现出极其割裂的一幕:
有人用通达信编制简单指标参与交易,做法和 20 年前一模一样,这部分人对 AI 的使用程度为 0;
有人用 AI 编写代码、人工校正,这部分人停留在 2-3 年前 AI 的水平,对 AI 的使用程度为 1;
有人用 AI 编写代码,用多个模型互相校正,会把重复环节包装成 skills,这一部分人对 AI 的使用程度为 4;
有人把依赖主观判断的部分做成 agent,重复流程包装成 skills,这部分人对 AI 的使用程度为 5。
生产力的跃迁,大概率会集中在 AI 使用程度 ≥ 4 的群体里发生。在云栈社区,不少量化开发者正在分享参数函数化与 AI 辅助决策的实战经验。
 发表于 15 小时前
|
查看: 3|
回复: 0


