治好大模型的“废话病”:DeepSeek-V4.1-Flash 开源,顺手把搜索 API 价格打到了地板上
没有发布会,也没有铺天盖地的宣讲。DeepSeek 还是老样子,在社交平台上直接贴出更新公告:全新 DeepSeek-V4.1-Flash-1017 正式上线,权重同步开源,底层 Search & Fetch API 全面开放。
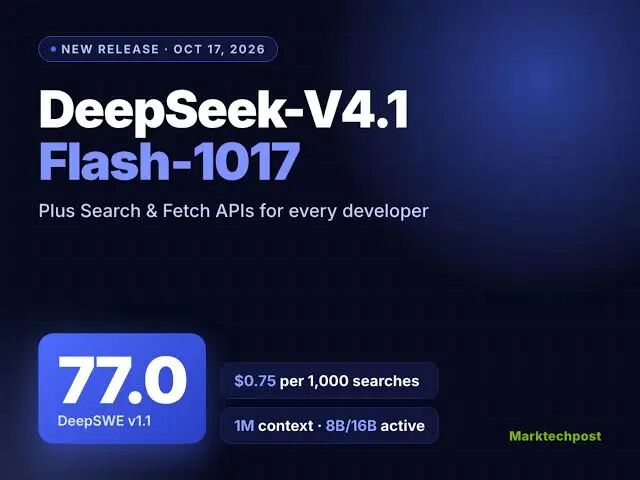
对每天盯紧 Token 账单、在 IDE 里写代码,或者正在搭建自动化 Agent 的一线开发者来说,这次更新几乎每一处都打在了实际业务的痛点上。
一、拒绝“废话连篇”:一次务实的帕累托优化
最近一年,随着推理模型(Reasoning Models)快速普及,一个尴尬的副作用越来越常见:模型变得越来越“啰嗦”。为了完成一段并不复杂的逻辑,模型常常会在后台自我反思几千个 Token,响应时间动辄几十秒。开发节奏被拖慢,月底账单也跟着水涨船高。
官方在公告第一句话就点出了这次更新的核心:在基准表现更强的前提下,实现更快的任务完成速度与更短的输出长度。
经济学把这种“不牺牲任何一方利益、全方位获得提升”的状态称为帕累托改进(Pareto Improvement)。放到大模型工程落地里,它意味着三件事:
- 显存与带宽压力释放:精炼的输出直接降低了生成延迟,提升了服务并发吞吐;
- 调试心智负担降低:模型直接给出经过有效收敛的方案,不再输出冗长且重复的思维碎片;
- 真实调用成本下降:算力开销不仅取决于单价,更取决于总 Token 量,输出变短等于实际支出缩水。
二、基准数据拆解:代码与 Agent 评测全线拉升
从官方公布的测试基准对比来看,V4.1-Flash-1017 对“软件工程”和“系统级操作”做了非常密集的定向提升:
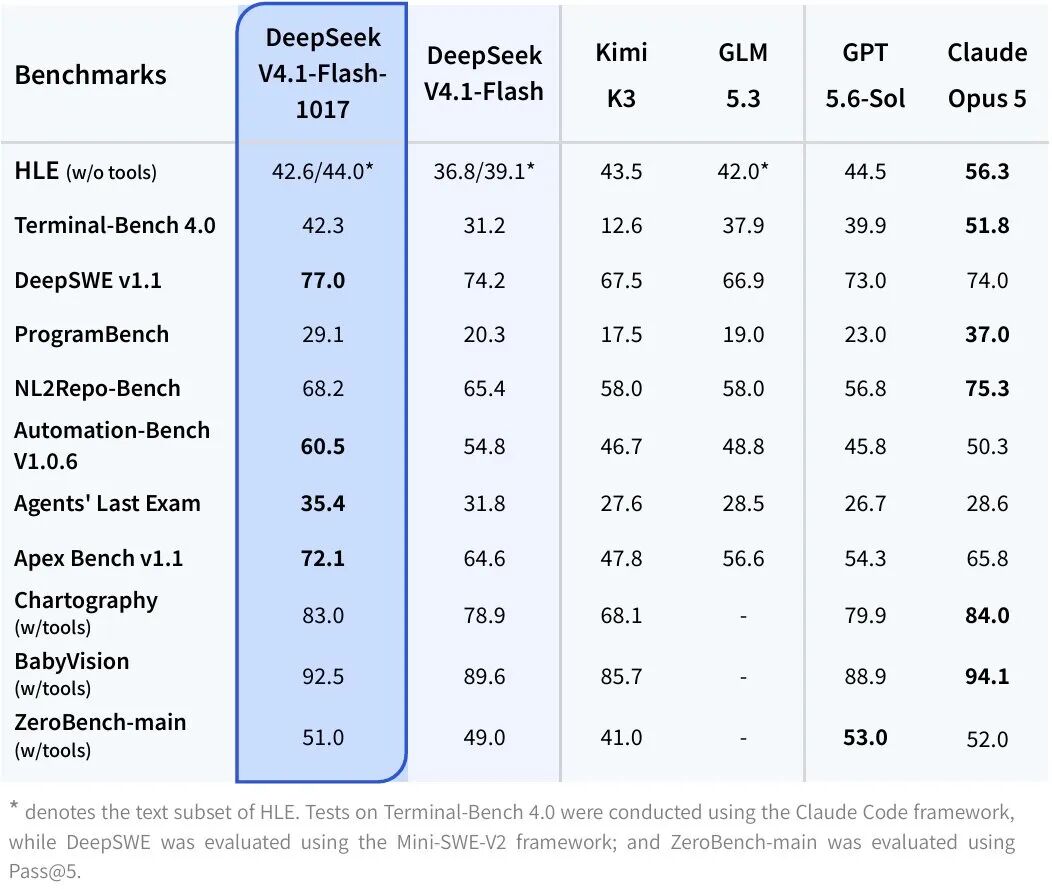
- DeepSWE v1.1:得分直接冲上 77.0%,超越同台竞技的 Claude Opus 5(74.0%)与 GPT 5.6-Sol(73.0%),相比前代版本有明显进步。
- Terminal-Bench 4.0:衡量模型在真实终端环境执行命令、排查系统问题的标杆测试,得分从上一代的 31.2% 飙升至 42.3%,大幅缩小了与高阶闭源旗舰的差距。
- ProgramBench 与 NL2Repo-Bench:分别达到 29.1% 和 68.2%,重点强化了多文件工程理解与大型仓库代码生成能力。
- Apex Bench(72.1%)与 Automation-Bench(60.5%):在长流程自动化任务中展现出极高的指令遵循稳定性。
这些测试不是考背书或写套话,而是真正让模型在无头浏览器、Linux 终端和脏乱的代码库里修 Bug、跑测试。这个成绩意味着,它已经不再只是一个“代码补全插件”,而是开始具备接管复杂工程子模块的成熟度。
三、带自我反馈的 RL:从“修代码”到“接完整项目”
如果只谈代码补全,很多模型早就表现不错。但如果让它们从零开始搭一个具备完整生命周期的项目,通常到第 4 或第 5 轮交互就会开始退化,甚至忘记最初的架构设计。
这次 DeepSeek-V4.1-Flash-1017 重点引入了带自我反馈的强化学习(RL with self-feedback)。
在长链路任务中,模型会在内部构建自我校验环:写完逻辑后预判运行状态,主动发现破绽并自我回滚修正。根据官方演示,该模型现已支持从零开发完整的轻量游戏,以及进行 3D 程序化建模。配合生态工具链,新模型已对 DeepSeek Harness(需升级至 v0.2.1-rc.1 或更高版本)、腾讯 CodeBuddy、WorkBuddy 等平台完成深度适配,开箱即可作为主力驱动核心使用。
四、意外的重头戏:Search & Fetch API 开放
除了模型本身,另一个在技术社区引发热烈讨论的,是 DeepSeek 搜索基建的商业化开放。
过去搭建联网 Agent(如研报生成、舆情监控、竞品情报检索),最头疼的问题往往出现在检索层:
- 自建爬虫集群容易遭遇高频反爬与封禁;
- 主流商业搜索 API 价格高昂,而且返回的原始 HTML 里充满广告和无用噪点,清洗一遍又要消耗大量清洗 Token。
DeepSeek 这次把自身日均承载数亿次请求的自研搜索引擎推到台前,正式开放 Search & Fetch API 文档。更关键的是价格策略:每个端点每 1000 次调用仅需 0.75 美元。
这个价位直接拉低了中小型团队构建生产级联网 Agent 的门槛。干净、格式化、专门针对 LLM 阅读理解优化过的搜索结果,能极大缓解幻觉问题,也让开发者不必再维护脆弱的爬虫链路。
五、坚持开源底色
在许多厂商逐步走向闭源、或只提供 API 包装的当下,DeepSeek 仍然保持了代码开源的传统。
目前,DeepSeek-V4.1-Flash-1017 不仅已在官网网页端、官方 App 及 API 节点全面实装,完整的模型权重也已同步托管在 Hugging Face 与 ModelScope。
对于有数据合规要求、内网隔离需求,或者希望针对自身业务场景做微调(LoRA/Full-FT)的企业来说,这意味着不必把核心商业数据押注在任何单一云服务商的闭源接口上。能在一个单卡或轻量集群上跑得飞快、代码工程能力一流的开源模型,才是构建企业内部数字资产时最实在的安全感。
从不搞玄学叙事,到把推理开销砍下来、把工程基准顶上去、把搜索接口打成白菜价,大模型正在从“拼参数量的军备竞赛”全面转入“拼落地实效的工程时代”。对开发者来说,放下冗长的技术焦虑,挑一把趁手的工具把项目真正跑起来,才是现阶段最重要的事。
 发表于 14 小时前
|
查看: 4|
回复: 0


