周末我在自己笔记本上干了一件平时不敢在生产环境随便干的事:往 Easysearch(后简称 ES)里一口气写 1 亿条数据。
秒表停在 44 分 57 秒。
机器是 Intel Core Ultra 9 185H,内存 63.5 GB,硬盘是 NVMe。Easysearch 2.5.0 就跑在本机 http://127.0.0.1:9200。
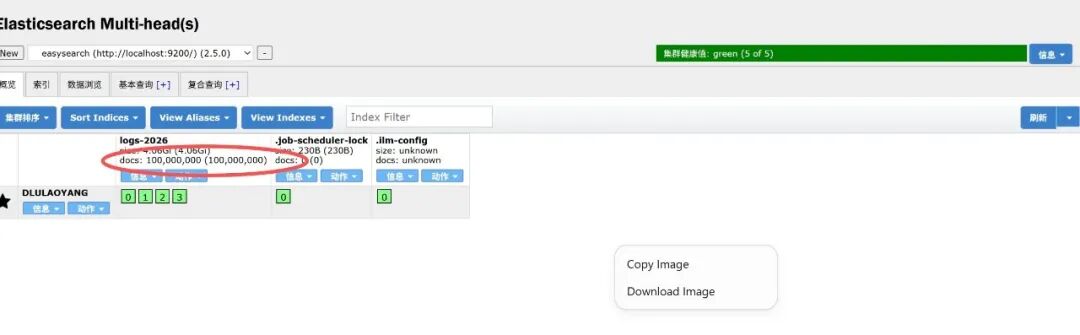
写完我去 Head 里看,索引 logs-2026 是 1 亿条,占了 4.06 GiB。集群一直是绿的。
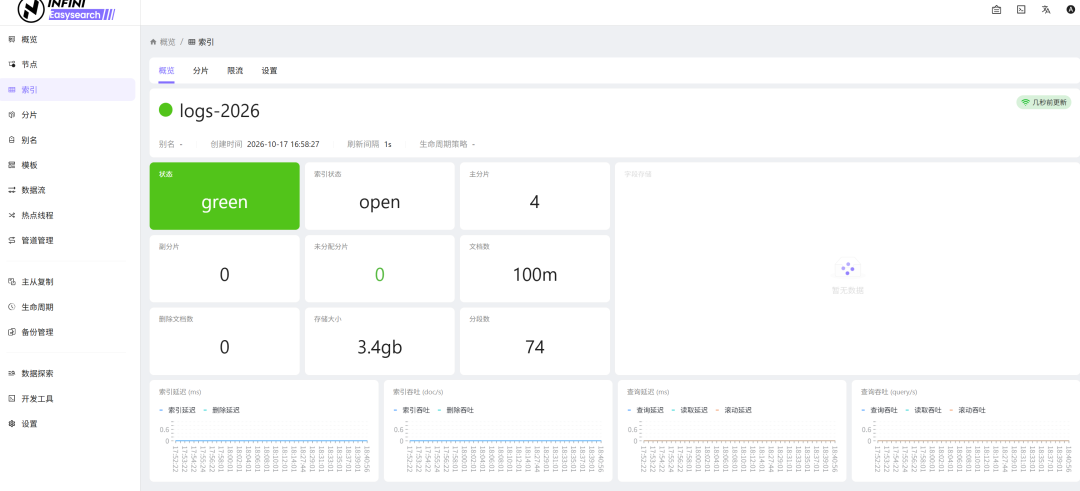
CPU 大多时候就两成到三成,没红过。
我得先泼一盆冷水。这 1 亿条都是小不点,一条就一个 id,外加一句 user login 或者 order paid。文件本身大约 5.4 GB。你要是灌带堆栈、带正文的日志,别拿我这 45 分钟去排期,那是两回事。
为啥不一条一条写
一条一条调用 index(),等于 1 亿次握手。笔记本再快也受不了这个来回。
Bulk 是把很多条捆成一包,一次请求送出去。我用的脚本是 es_bulk_load.py,命令就这一条:
$env:EASYSEARCH_HOSTS = "http://127.0.0.1:9200"
python es_bulk_load.py --index logs-2026 --file events.jsonl --shards 4 --id-field id --replicas 0
分片我给了 4 个。如果你对分片数量和容量规划没概念,可以看看这门 Elasticsearch 8.X 从入门到精通 课程,里面有专门讲分片机制和集群规划的章节。
这台机器只有一个数据节点,副本我设成 0。副本要是开着,等于每条写两份,单机还分配不出去,集群直接黄给你看。
文档 id 用的是 e-1、e-2 这种自己带的号。中途断了再跑,相同的号会盖掉旧的,不会变成 2 亿条。
还有一个开关特别容易忘:refresh_interval。
默认大概 1 秒刷一次,好让新数据马上能搜到。1 亿条要是跟着每秒刷,磁盘光合并段就够呛。所以灌的时候我把它关成 -1,写完再改回 1s,顺手 refresh 一次。Head 里那 1 亿,是这一下之后才稳稳显示出来的。
一批 2000 条,4 个线程一起发。官方的经验是每批先从 1000 到 5000 条、大概 5 到 15 MB 试。
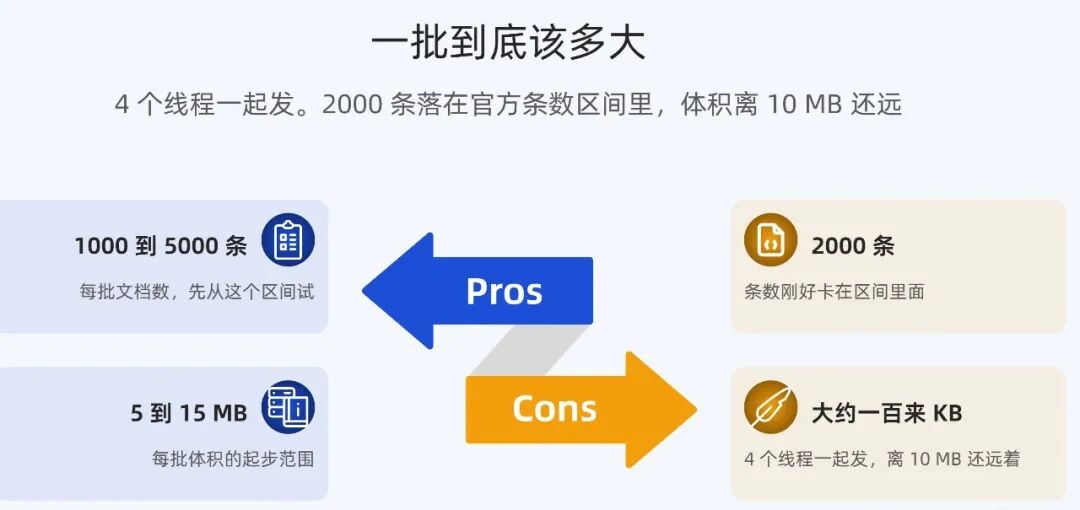
我这批太小,2000 条凑一起也就一百来 KB,离 10 MB 还远着。
代码其实不复杂,怕的是一口气读进内存
5.4 GB 的文件,要是 readlines() 一下全读进来,内存先给你个教训。脚本是读一行、吐一行。
吐出去的也不是原文那一行,而是批量接口认得的一个小字典。这里有个特别容易抄错的地方:普通写入用 _source。
你要是写成 update 那种 doc,这一条会失败,请求整体还可能回你一个 200,看着像成功。
action = {
    "_index": "logs-2026",
    "_op_type": "index",     # ← 已经有了就覆盖
    "_id": str(doc["id"]),   # ← 断了再跑,靠这个号对上
    "_source": doc,          # ← 正文在这,别写成 doc
}
客户端拿到它,会拆成两行再发出去。
第一行说「往哪写、id 是啥」,第二行才是内容。
最后一行也得换行,不然 Bulk 不认:
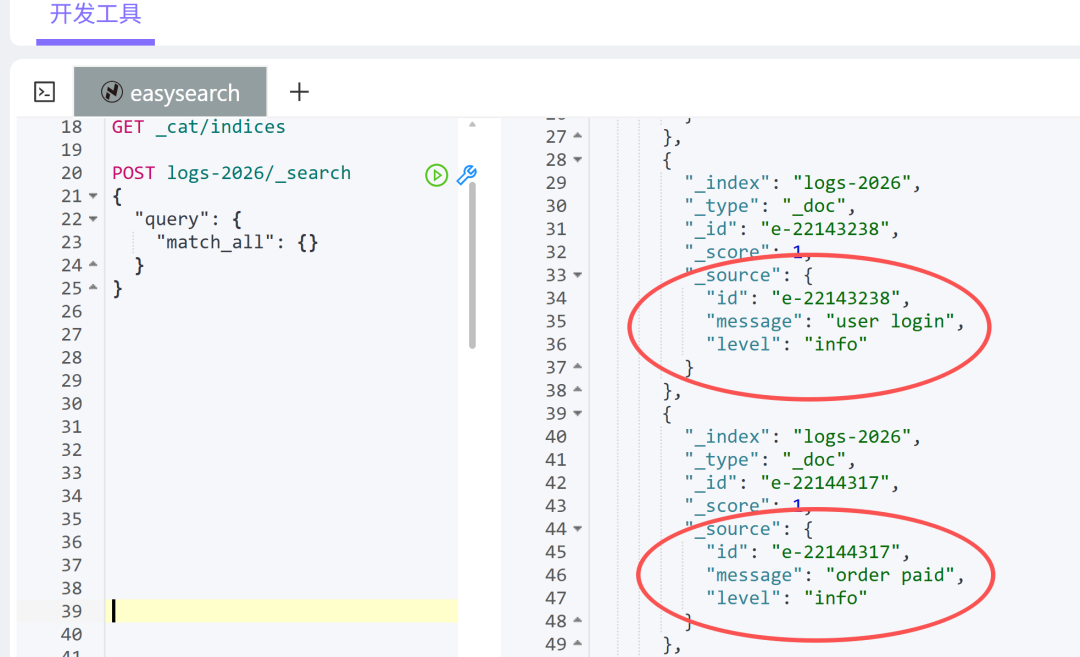
{"index":{"_index":"logs-2026","_id":"e-1"}}
{"id":"e-1","message":"order paid","level":"info"}
凑满再发。满 2000 条,或者这一包的字节能到大约 10 MB,就送走。
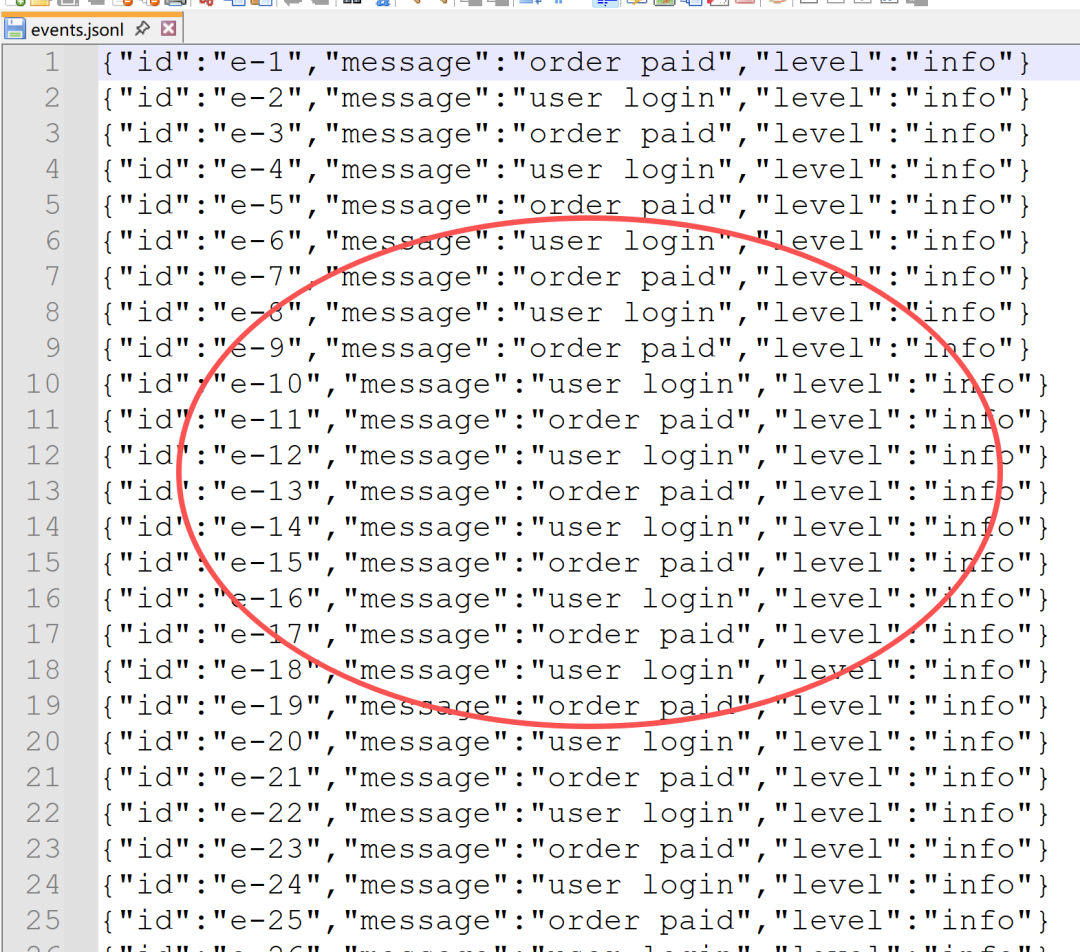
我这批小文档,先碰到的是条数。你要是灌大日志,往往条数还没到,体积先到了,那也正常。
if chunk and (len(chunk) >= batch_size or size + nbytes > max_bytes):
    yield chunk, last_line   # ← 这一包结束,记住最后读到文件第几行
并发我也卡死了。
最多 4 包在路上,再多主线程就歇一会,等有人回来。
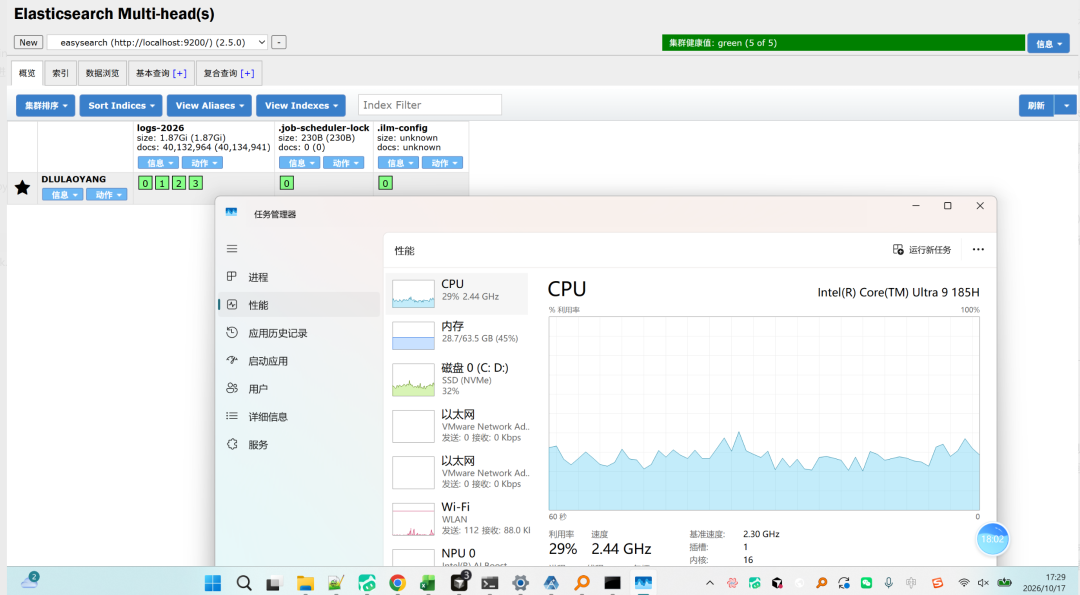
内存里大概就这 4 小包,所以任务管理器那条内存线几乎是平的。文档从 4000 万涨到 1 亿,内存还是 29 GB 左右,没跟着文档数一起长。
pending[pool.submit(send_chunk, client, seq, last_line, chunk)] = None
while len(pending) >= args.threads:   # ← 在飞的不超过 4 包
    take_done(wait_all=False)
4 个线程谁先跑完说不准。检查点要是谁先回来就记谁的行号,文件中间会空一截,下次续跑就把空的那截跳过了。所以每包有个序号,只按 0、1、2 往下记已经写稳的最后一行。
网断了、对方回 429 或者 502,这一包整包不算数,行号停在上一包,下次从这儿重来。某一条自己写坏了,比如字段类型不对,就把这条丢进错误文件,行号继续走。不能因为一条坏数据,把剩下的几千万条都卡死。
底下还有个小保险:失败了最多再试 3 次,先等 2 秒,越等越长,最多等到 60 秒。这次曲线很平,说明本机基本没走到重试。
我盯着屏幕看的那 45 分钟
秒表是从这次灌 1 亿条开始按的。下面这几行,都是我对着 Head 和任务管理器抄下来的。
| 秒表 |
文档数 |
索引大小 |
CPU |
内存 |
| 18:02 |
40,132,964 |
1.87 GB |
29%,2.44 GHz |
28.7 / 63.5 GB |
| 24:42 |
55,275,867 |
2.41 GB |
21%,2.92 GHz |
28.6 / 63.5 GB |
| 27:34 |
61,914,310 |
2.64 GB |
28%,3.12 GHz |
28.7 / 63.5 GB |
| 31:35 |
70,637,466 |
2.83 GB |
33%,2.97 GHz |
28.6 / 63.5 GB |
| 36:38 |
81,144,437 |
3.17 GB |
21%,2.53 GHz |
28.7 / 63.5 GB |
| 41:40 |
91,453,247 |
3.78 GB |
28%,2.89 GHz |
29.1 / 63.5 GB |
| 44:57 |
100,000,000 |
4.06 GB |
— |
— |
44 分 57 秒算下来是 2697 秒。1 亿除以 2697,大约 每秒 3.7 万条。
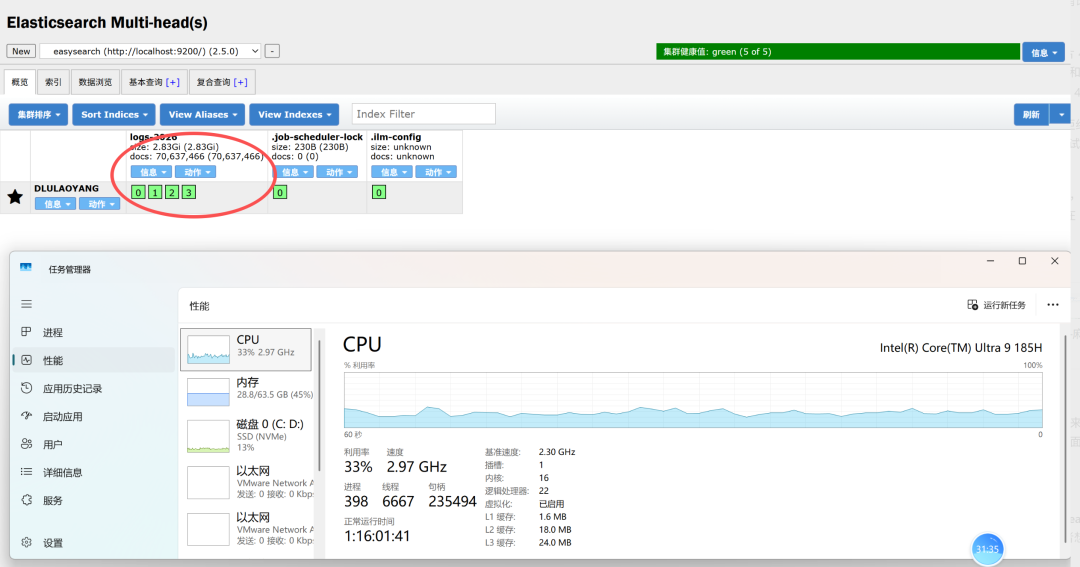
CPU 那条线我看了很久。这颗 U 是 16 核 22 线程,标称 2.30 GHz。灌的时候利用率就在 21% 到 33% 晃,频率偶尔到 3.12 GHz,大部分时候 2.5 到 3.0。没有一根刺戳到顶。
内存更没啥故事。63.5 GB 里一直用着 28.6 到 29.1 GB,百分之四十五上下。
磁盘是那块系统 NVMe,多数时候 10% 到 32%。写到 9100 多万的时候冲过一次 49%,下一眼又掉回去了。
4 个分片 0、1、2、3 都在这个节点上,健康值一直绿。
索引最后 4.06 GiB,4 个分片每个才 1 GB 出头。摊到每条,存储大概 44 字节。文件本身 5.4 GB,进了索引反而更小。小文档再压一压,就会出现这种索引比原文还瘦的情况。
这 45 分钟,别直接抄到生产
中间我还被 Windows 坑了一下,跟 Easysearch 没关系。
检查点要是每 2000 条就替换一次同一个文件,写到几千万行,events.jsonl.es_bulk.ckpt.tmp 会报 WinError 5,说拒绝访问。
多半是杀毒或者别的程序正抓着这个文件。程序退出了,已经写进去的数据还在,行号停在最后一次存成功的地方。加上 --resume 就能接着写,相同 id 会盖掉,不会重复插。
我后来改成大概每 10 万条才落一次盘,替换失败就再试几次。后面那一大段就没再被掐断。你要是在 Windows 上跑这种长任务,别那么勤快地换同一个小文件。
还有三句老实话。
-
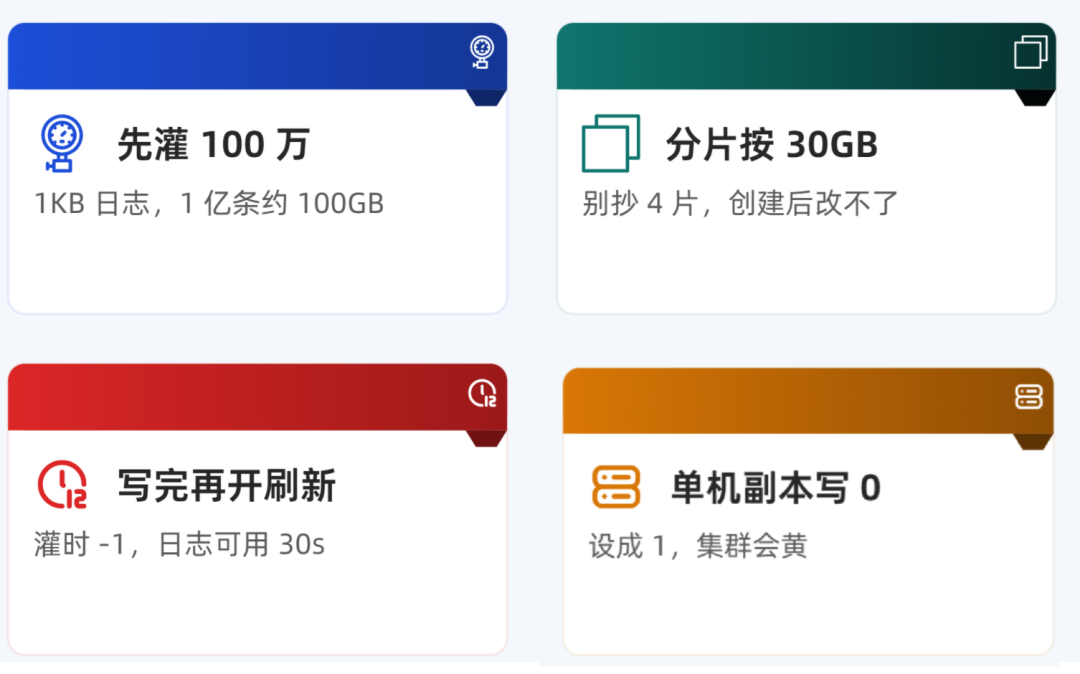
文档太小,所以才有每秒 3.7 万条。 换成一条 1 KB 的日志,1 亿条光原文就大约 100 GB,包变大,刷新和合并都更重。先用你自己的数据灌 100 万条,再去估 1 亿。
-
分片也别照抄成 4。 官方说一个主分片大概扛 10 到 50 GB 比较舒服。我这 4 GB 拆成 4 片,每片 1 GB,是图测试省事。分片个数创建之后改不了,生产上先拿原文体积除以 30 GB,再看看你有几个节点。
-
副本 0 只适合我这种单机瞎折腾。 节点要是挂了,这 1 亿条就没了。写完真要给人查,把副本加回去。单节点千万别设成 1,副本没地方去,集群会黄着不走。
refresh_interval=-1 灌的时候是对的,写完一定要改回来,不然新数据搜不到。
我改回的是 1s。日志要是能接受半分钟延迟,用 30s 更省磁盘。
你要是也想试
找一份不大的 JSON,在自己机器上跑一小批,看三眼就够:
- 文档数和文件里的有效行数对不对得上
- CPU 是不是早就满了。我这次没满,说明这批还能再加大
- 用索引大小除以条数,算算你自己一条占多少字节
我这 1 亿条小文档,45 分钟,CPU 三成,索引 4.06 GiB。
你线上一条大概多大?拿同样的脚本先灌 100 万条,把耗时和索引大小算出来,就能把这 45 分钟换成你的数。这类海量数据写入与搜索性能优化的话题,在 云栈社区 上也有不少同行在讨论,换数据之前不妨上去翻翻实战案例。
 发表于 2 小时前
|
查看: 10|
回复: 0


