在《Agentic Ontology:构建企业数字世界》中,我从对 Palantir 的分析出发,提出了 Agentic Ontology:用智能体构建企业本体,面向智能体应用构建企业本体。在后续讨论企业世界模型的文章中,本体同样是重要的基础。
但在这半年的实践中,我们发现大家对本体的理解并不一致。随着智能体的流行,各厂商都号称支持本体,可一旦落到具体项目,本体到底该怎么建,仍然众说纷纭。
在《从 Palantir 本体论看企业数据应用架构》中,我们分析了企业系统的数字孪生、事实数据与意义数据,强调面向业务场景构建对象、关系和行为。但如果面对的只是一堆 Excel,或者正在新建一个没有历史数据的系统,本体又是什么,又该如何构建?难道在本体这个词流行以前,我们就不做软件项目了吗?原有的数据建模理论和方法难道真的过时了吗?
如果解释不清,就很容易为了"有本体"而再增加一套模型、一层映射,却说不清楚到底解决了什么问题。所以我们需要先想清楚一件事:本体的本质到底是什么?
一、本体,究竟在建什么?
哲学中的本体讨论的是存在及其基本类别;而软件项目关心的,则是如何表达业务世界。在知识工程中,本体的经典定义是"对概念体系的显式规定"——把一个领域中的概念、属性、关系及约束明确表达出来,使其能够被共同理解和使用 [1]。
说到这里,做过软件的人大概会产生一种熟悉的感觉:这不就是数据建模吗?
新闻生产系统要定义文稿、素材及其关系;经营分析系统要定义客户、订单和统计口径。我们一直在做的事情,就是把业务世界转化为软件能够处理的模型。数据建模并不是简单地设计表和字段,而是先明确业务概念、含义、关系和约束,再考虑存储、访问与计算的问题。
本体所强调的,正是业务含义层面的建模。Gruber 也将"语义数据模型"列为相关术语 [1]。它并不是软件工程之外的一种神秘事物。
再看 Palantir 的 Foundry。官方将本体称为企业的"运营层":建立在已接入的数据集、模型等数字资产之上,关联现实中的设备、产品、订单等对象。在许多场景中,本体构成了企业的数字孪生,既包含对象、属性和关系,也包含动作、函数及动态安全机制 [2]。
这里需要注意:Palantir 的本体不只是一套模型,还有具体实例。它不只是定义"员工"的属性,还要能找到某一名员工,查询其属性和关联对象。这正是对象类型与对象实例的区别,也是模型与实际数据之间的连接 [3]。
把分散的数据组织成业务所需的对象、关系和状态,仍然离不开数据连接、集成、转换等能力,Foundry 也提供了相应的工具 [4]。数字孪生并不是照搬原系统的每一张表,而是根据应用需要来组织数据 [2]。
数据接进来之后,不同来源的对象能否对齐?含义是否一致?来源是否可信?状态是否及时?谁可以访问和修改?这一连串问题,又回到了数据治理的范畴。
在过去的文章中,我们借"意义即使用"强调面向场景组织和使用数据,并区分了"事实数据"和"意义数据":前者是经过清洗、转换和规范化的数据;后者则是面向场景组织、挖掘和理解的对象、属性与关系。落到本体建设上,就是只建立具体场景真正需要使用的概念及其关联数据。
简单地说,哪怕不用"本体"这个词,扎实地做好数据建模和数据治理,同样能做出优秀的项目。强调 Agentic Ontology,是为了回答智能体应用中的建模问题。因此,我们认为:
智能体本体(Agentic Ontology)的本质,就是面向业务场景、面向智能体的数据建模与数据治理。
二、软件一直在建模,为什么智能体还需要本体?
软件从来没有停止过建模,那么智能体应用究竟有什么不同?关键的变化在于使用对象,以及人与软件之间的分工发生了根本性的调整。
过去,业务系统通常由人来使用。系统管理数据、提供操作与流程,人带着业务知识和专业经验来完成工作。系统更多时候只是人手中的工具,系统没有表达的部分,人可以凭借自己的理解、其他材料或与同事的交流来补足。传统软件当然也可以内置规则、统计模型和自动流程,但仍有不少理解与判断能力留在了人身上。
比如分析"本月销售额为什么下降":系统有销售数据,可以按照人的指令完成统计。哪类产品下降得最多?与收款、现金流、库存之间有什么关系?在这种使用方式下,综合分析往往还是由人来主导,逻辑和判断存在于人的头脑中,分析方法体现为人的操作或预设模板。而智能体的应用,则需要运用人的方法,理解使用者的意图,给出建设性的意见。
一旦这部分工作交给智能体,就必须检查:完成任务所需的业务支持是否具备?所需的领域知识是否可用?
智能体可以调用 Skill、工具和检索能力,但不能默认它掌握了企业内部的特殊约定与专业方法。读懂了字段,不等于知道该采用什么口径。因此,首先要从任务出发,检查已有模型与数据能否支撑智能体完成任务,而不是另起炉灶发明一套概念。
已有模型足以支撑和约束该场景下智能体的运行与判断,就选取适合它的子模型及实例数据。 所谓"选取",是明确所需的概念、关系、约束和可用数据,不一定非要另建视图、做二次映射、复制数据或增加新平台。只需要向智能体开放与任务相关、获准使用的部分,按需访问即可。
如果已有模型不足,则补充必要的口径、判断依据、方法及适用条件;已有数据不便使用时,才去做转换和加工;所需数据分散在多个系统中,就通过接口联查或集成整理;原来由人掌握的知识是否需要建模,则取决于智能体承担了什么任务。这些概念、关系、约束及其关联的实例数据,共同构成了面向这个智能体的本体。
这也不意味着要把全部知识都塞进本体。概念、关系和约束可以建模,有些操作步骤和知识可以交给 Skill 或程序,说明材料可以通过检索来提供。具体知识究竟是显式建模,还是通过 Skill、程序或检索提供,需要结合任务需求、现有数据形态以及实现和维护成本来综合判断。
所以,并不是软件突然之间需要本体了,而是智能体所承担的任务,改变了模型与数据的要求。
三、项目实践:在具体场景中构建智能体本体
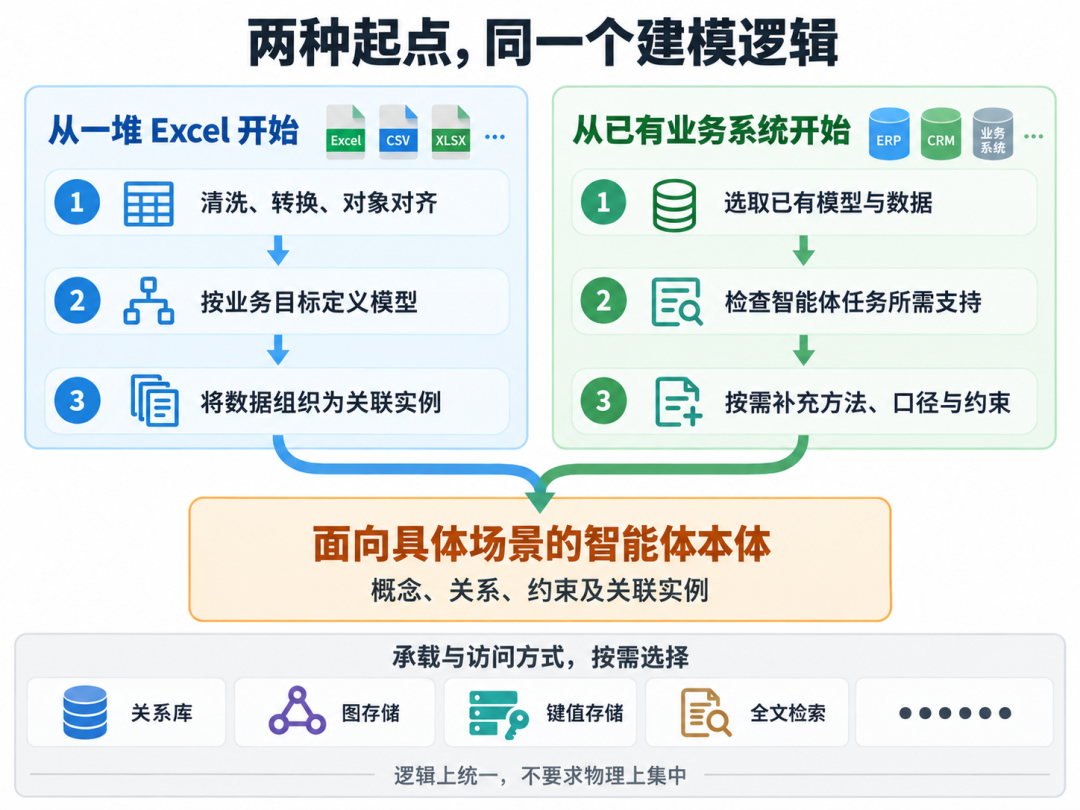
举两个例子。比如我们在用智能体做经营数据分析或人员关系分析时,拿到的可能是从各个系统导出的一堆 Excel。首先要清洗和转换原始数据,对齐字段含义、编码和时间口径,识别跨表中的同一对象,并保留来源信息,避免把同名对象盲目合并。
与此同时,根据业务目标定义所需的对象、属性、关系和约束,并检查现有数据是否能支撑这些定义。这其实就是本体设计,也可以理解为数据建模。随后把处理好的数据映射为本体实例。智能体可以辅助完成本体定义、数据清洗、映射和转换,从而降低按具体应用项目构建本体的实施成本。
我们使用关系型数据库承载本体数据,作为统一底座。为了便于"人+智能体"共同探索数据,还按需使用图存储、键值存储、全文检索引擎来适配特定的数据对象和关系。在这个架构中,它们作为面向应用的派生查询与索引层,通过统一对象 ID 关联底座,并维护更新、删除和权限的一致性。分析中新挖掘出来的关系和标签,同样属于本体数据的一部分。
再看另一个场景:我们要在 ERP、CRM、电视新闻生产系统等现有系统中增加智能体。系统本来就有业务数据模型,完全不需要为了"本体"这个概念再建一套。以自动销售分析为例,客户、产品、订单和回款等模型可以直接复用,真正需要重点补充的,是分析方法相关的数据:销售下降应该从哪些维度拆解?如何选择比较周期?是否需要联查回款或库存?
当智能体需要选择和组合这些分析方法时,可以建立一个"分析方法"对象,用它来表达适用条件、所需指标、比较维度和判断约束,再由 Skill 或程序利用这些表达来组织查询与计算。原始业务数据可以继续留在原系统中,新增模型用稳定 ID 引用,跨系统时带上来源和对象类型。前提是能够通过受控接口读取所需属性或统计结果;ID 用于定位,并不代替数据本身。需要复现分析时,再记录数据版本或必要快照。
因此,从逻辑组成上说:这个智能体的本体=原有业务模型中需要的部分+智能分析所需的新增模型,并关联相应实例数据。 这里的"加"是逻辑上的组合,并不要求把数据复制到同一个库里。
总结
我们讨论 Agentic Ontology,不是为了另造一套软件工程,而是想厘清一个问题:面向业务场景、面向智能体,到底该如何进行数据建模与数据治理。
数据分散,就按目标去整理和建模;已有业务模型,就复用其中需要的部分,再补充智能任务所必需的方法与约束。用什么数据库、是否复制数据、哪些内容交给 Skill,这些都是实现层面的选择,并不是本体的定义。
不是模型越大、概念越多越好,也不是凡有知识都必须对象化。建设的价值,归根结底在于是否支撑智能体完成了原本需要人来理解和判断的业务工作。
不是为了本体而本体,而是为了应用,决定本体应该建什么。
参考文献
[1] Tom Gruber. Ontology. Encyclopedia of Database Systems. 定义与说明.
[2] Palantir. Ontology: Overview; Ontology: Best practices and anti-patterns.
[3] Palantir. Object types: Overview.
[4] Palantir. Data integration: Overview.
 发表于 4 小时前
|
查看: 11|
回复: 0


