人类需要沟通,而沟通的高效化、智能化是必然趋势。智能化处理的对象无非是文本、语音和图像,围绕这三个维度的工具一直在演进。AI 的出现,算是对人类沟通方式的一次革命,AI 语音机器人就是其中一块主要阵地。把 AI 接入现代语音通信系统,是当下真正值得投入精力去攻克的方向。
开源 Asterisk 已经走过了二十多年,从传统 PSTN 接入到云通信,它都能应对得游刃有余。结合 AI 之后,Asterisk 提供了一条高性价比的开源集成路径。本系列计划从架构维度深入拆解 Asterisk 与 AI 语音机器人集成的技术框架,主要覆盖以下几个方向:
- 通过 ARI 和 AudioSocket 将 Asterisk 与外部 AI 服务对接
- 实时语音转文本与文本转语音集成
- 由 LLM 驱动的交互式语音应答和对话代理
- 自动化通话情感分析和实时转录
- 低延迟媒体流架构与生产环境扩展
今天先从技术架构和媒体处理入手,聊一聊 AI 与通信接口框架的第一部分。
现代 Asterisk 架构与媒体处理
Asterisk 本质上是一个背靠背用户代理(B2BUA)和媒体路由核心。在传统电话系统中,它终结来自运营商的入站信令,向分机或网关建立一条独立的出站 SIP 会话,然后在两者之间桥接双向音频。把 Asterisk 与外部人工智能集成之后,这个流程被彻底改变了:Asterisk 不再只是桥接两个人类终端,而是必须直接从通道内存中提取实时音频帧,以最小延迟通过网络传输进行序列化,再把合成的响应帧重新送回媒体管道。
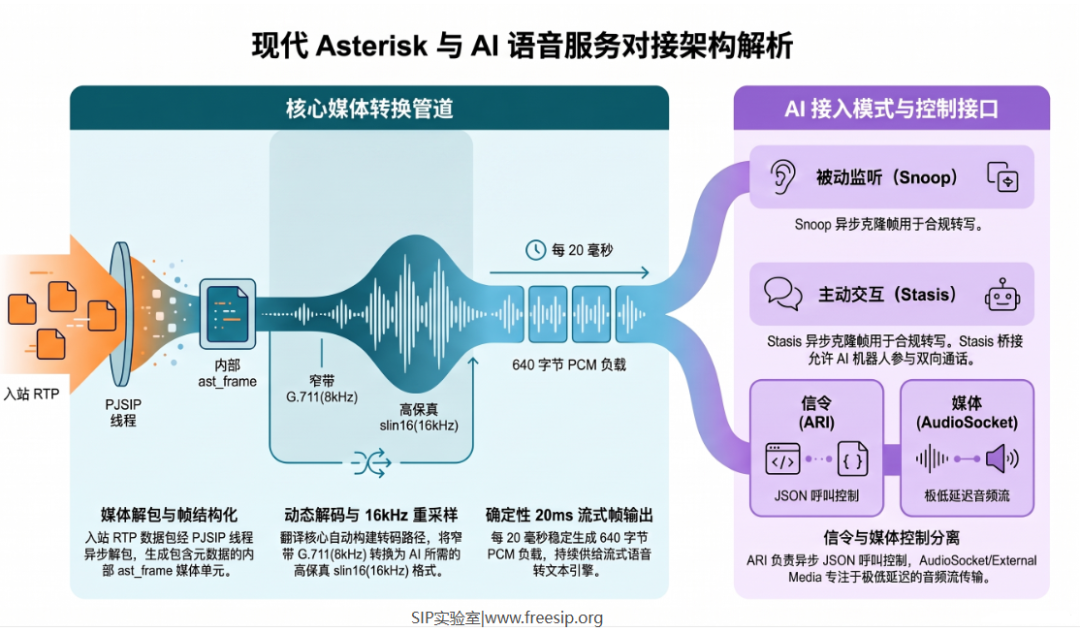
要把 Asterisk 与语音识别模型、大语言模型和文本转语音引擎对接起来,必须先理解现代 Asterisk 在内部如何处理媒体。Asterisk 通过分层的核心子系统,对物理网络、信令协议和原始编解码器做了抽象:通道核心、通道驱动层、桥接引擎,以及抽象翻译核心。
Asterisk 媒体核心架构
Asterisk 呼叫处理的基础是 ast_channel 结构体。一个 ast_channel 代表一条活跃的通信腿(leg)。当呼叫通过 chan_pjsip(基于开源 PJSIP 库构建的现代 SIP 协议栈)到达 Asterisk 时,Asterisk 会把 SIP 事务处理与媒体负载解耦。
信令由 PJSIP 线程异步处理,媒体则以数据包的形式到达由 Asterisk res_rtp_asterisk 引擎管理的专用 UDP 套接字。入站 RTP 数据包被解包为 Asterisk 内部的媒体单元,也就是 ast_frame 结构体。
网络层                         Asterisk 通道层                       内部媒体桥接

   +--------------------+        +-------------------------+        +--------------------------+
   | 入站 RTP (G.711)   | -----> | chan_pjsip (解包)       | -----> | ast_frame (语音, 8kHz)   |
   +--------------------+        +-------------------------+        +--------------------------+
                                                                                |
                                                                                v
                                                                   +--------------------------+
                                                                   | 翻译核心 (编解码器)      |
                                                                   | (ast_trans_pvt 管道)     |
                                                                   +--------------------------+
                                                                                |
                                                                                v
                                                                   +--------------------------+
                                                                   | ast_frame (PCM16, 16kHz) |
                                                                   +--------------------------+
                                                                                |
                                                                                v
                                                                   +--------------------------+
                                                                   | AI 流消费者 /            |
                                                                   | 外部音频套接字           |
                                                                   +--------------------------+
每个 ast_frame 都带有元数据,描述其帧类型(AST_FRAME_VOICE、AST_FRAME_DTMF、AST_FRAME_CONTROL)、时间戳、序列信息、数据长度和格式描述符。负载本身包含的是在 SIP SDP 握手期间协商好的编解码器所编码的原始音频采样。
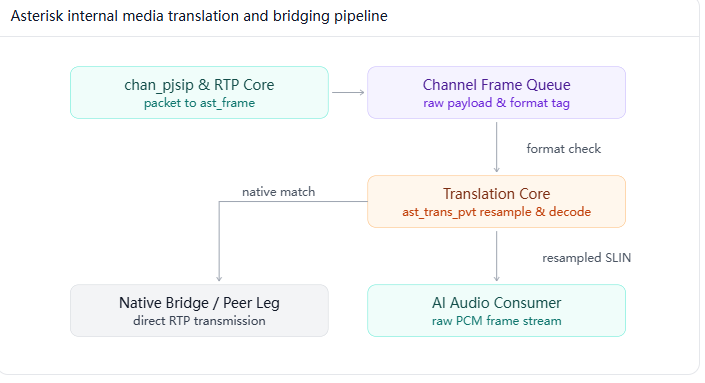
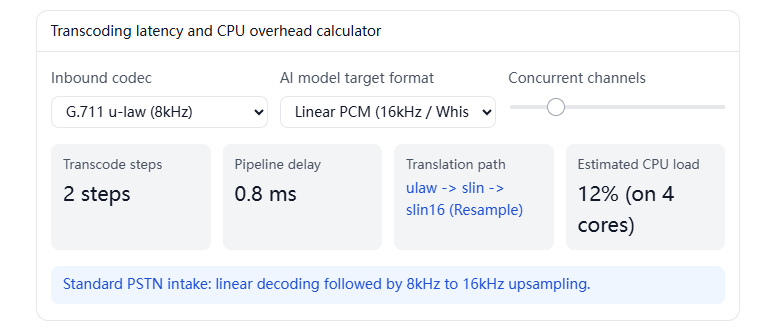
当 Asterisk 需要把媒体从一个通道移动到另一个实体——无论是出站中继、会议室还是外部 AI 端点——它都会评估源格式和目标格式。假如入站通道以 G.711 μ-law(8 kHz,8 位压扩)到达,而目标需要 16 kHz 线性 PCM 用于转写,Asterisk 就会通过翻译矩阵实例化一条翻译路径:codec_ulaw → codec_resample → codec_pcm。
Asterisk 内部媒体转换与桥接管道:
线程模型与桥接引擎
Asterisk 依赖 POSIX 线程(pthreads),采用事件驱动与工作线程池相结合的架构。与旧版本中单线程阻塞于同步 I/O 操作不同,现代 Asterisk 通过桥接 API(main/stasis_bridges.c 和 main/bridging.c)将通道媒体泵与应用逻辑解耦。
每个活跃的媒体流都会与两个关键的线程上下文交互:
- 通道监控线程:持续在底层文件描述符(通常是支撑 RTP 流的 UDP 套接字)上执行
ast_read()。它提取数据包、重组帧,并将其放入通道的入站队列。
- 桥接线程:评估在桥接中各参与方之间传递的媒体。当外部 AI 集成接入某个通道时,桥接器决定是克隆
ast_frame 用于外部分发,还是将合成帧直接注入桥接器的混音矩阵。
+-----------------------------------------------------------------------------+
| Asterisk 进程空间                                                           |
|                                                                             |
|  [chan_pjsip 线程] -------- ast_read() -------> [ast_channel 队列]          |
|                                                          |                  |
|                                                          v                  |
|  [AI 音频钩子 / FrameHook] <--- 克隆帧 --- [桥接引擎]                       |
|             |                                           |                  |
|             v                                           v                  |
|    (外部 TCP / WS)                             [出口 RTP / 通道]            |
+-----------------------------------------------------------------------------+
构建实时 AI 管道时,这些线程上下文中的延迟至关重要。如果外部 AI 消费者在通道线程或 framehook 内部执行阻塞式网络操作,ast_read() 循环就会停滞。Linux 套接字接收缓冲区将被填满,导致 UDP 数据包被丢弃、音频抖动以及转写准确率下降。
Warning
切勿使用同步 HTTP 请求或磁盘写入阻塞 Asterisk 通道线程。将媒体传输到外部 AI 服务时,Asterisk 线程只能写入非阻塞队列或异步套接字描述符。
为低延迟媒体配置 PJSIP
现代 Asterisk 使用 pjsip.conf 进行 SIP 信令和端点配置。为了确保语音模型获得最佳条件,必须为端点配置明确的编解码器偏好、直接媒体(direct media)策略和打包间隔(ptime)。
大多数深度学习语音转文本模型(如 OpenAI Whisper 或 Conformer 模型)期望以 16,000 Hz 或更高采样率、16 位有符号线性 PCM(slin16)采样的高保真音频。标准 PSTN 中继协商的是 8,000 Hz 的 G.711 μ-law(ulaw)或 A-law(alaw)。如果现代 SIP 终端或 WebRTC 客户端能够提供高清音频,直接协商宽带编解码器可以避免有损上采样带来的伪影。
下面是一份支持宽带 Opus 和标准 PSTN 编解码器、并配置为通过 Asterisk 进行媒体代理的 pjsip.conf 生产配置:
; /etc/asterisk/pjsip.conf

; Transport configuration defining the SIP UDP socket
[transport-udp]
type=transport
protocol=udp
bind=0.0.0.0:5060

; Template for AI-enabled endpoints
[ai-endpoint-template](!)
type=endpoint
context=nexusvoice-inbound
dtmf_mode=rfc4733
direct_media=no
force_rport=yes
ice_support=yes
media_encryption=no
allow_subscribe=yes
timers=yes

; Inbound carrier or client endpoint
[carrier-inbound](ai-endpoint-template)
disallow=all
allow=opus
allow=slin16
allow=ulaw
allow=alaw
; Enforce 20ms audio frame sizes
rtp_keepalive=1
rtp_timeout=30
rtp_timeout_hold=300

[carrier-inbound-auth]
type=auth
auth_type=userpass
username=nexus_carrier
password=SuperSecretCarrierKey987!

[carrier-inbound-aor]
type=aor
max_contacts=5
此配置中有两个参数对实时 AI 处理至关重要:
direct_media=no:强制所有 RTP 媒体直接流经 Asterisk,而不允许终端之间点对点传输 RTP。若没有此设置,Asterisk 将无法检查、克隆或将音频帧重新路由到 AI 服务。allow=opus,slin16,ulaw,alaw:按优先级顺序明确列出首选编解码器。Asterisk 会首先协商 Opus。如果协商成功使用 Opus,Asterisk 会将其解码为 48 kHz / 16 kHz 的内部 PCM,相比上采样后的 G.711 μ-law,能为语音模型提供更优的声学分辨率。
转码延迟与 CPU 开销计算器:
音频提取机制:嗅探 vs. 分流
在将活跃呼叫桥接到 AI 服务时,必须决定 Asterisk 如何提取媒体帧。Asterisk 核心提供了三种主要机制:
| 机制 |
工作层 |
可变性 |
双工模式 |
用例 |
ChanSpy 应用 |
通道层 |
只读(监听) |
可选(入 / 出 / 双向) |
异步通话转写与情感分析 |
AudioHooks API(C 级别) |
帧传递层 |
读/写(内联) |
双向拦截 |
实时翻译、动态噪声抑制 |
| Stasis / ARI 媒体桥接 |
桥接核心 |
读/写(完整参与者) |
双向混音 |
对话式语音机器人与自主代理 |
对于非侵入式 AI 处理——如实时合规监控或来电者实时转写——ChanSpy 会创建一个异步只读分流点。在现代基于 ARI 的架构中,这通过 Snoop 通道(Snoop Channels) 实现。Snoop 通道向活跃通道附加一个内部钩子,复制每个入站或出站的 ast_frame,并将其输出到专用的目标通道,而不会改变任何一方人类所听到的音频。
对于对话式代理(AI 需要回话并监听来电者的打断),通道则必须被放入 Asterisk 的 Stasis 桥接(Stasis Bridge) 中。
SNOOP 架构(被动 AI)

                    [来电者] <====== 实时通话 ======> [座席]
                                        |
                                   (音频钩子)
                                        |
                                        v (克隆的 ast_frames)
                                 [Snoop 通道]
                                        |
                                        v
                                 [AI 语音 STT]

-------------------------------------------------------------------------

                          STASIS 桥接架构(主动 AI 机器人)

                                    +--------------------+
                    [来电者] <====> |   Stasis 桥接      | <====> [AI 代理工作进程]
                                    | (混音 / 控制)      |        (AudioSocket / WebSocket)
                                    +--------------------+
在 Stasis 桥接内部,Asterisk 将外部 AI 端点视为平等的参与者,或将通道完全路由到 AI 应用引擎。
帧翻译与编解码器协商演练
为了理解 Asterisk 在活跃呼叫期间如何处理音频帧,我们来追踪一个具体场景:一个携带 G.711 μ-law 音频的入站呼叫到达,必须传递给期望 16 kHz 有符号线性 PCM(slin16)的外部语音识别引擎。
当通道驱动传递一个原始的 20ms μ-law 数据包(160 字节)时,Asterisk 将其包装为格式为 ulaw 的 ast_frame 对象。翻译核心查找从 ulaw 到 slin16 的最优转换矩阵,并逐步执行翻译。
变量:raw_bytes = 160 字节,src_codec = "ulaw",dst_codec = "slin16"
def process_frame(raw_bytes, src_codec, dst_codec):
    frame = ast_frame_create(raw_bytes, src_codec)
    trans_path = find_translation_path(frame.codec, dst_codec)
    linear_8k = trans_path.decode_ulaw(frame.data)
    resampled_16k = trans_path.resample(linear_8k, 8000, 16000)
    out_frame = ast_frame_wrap(resampled_16k, dst_codec)
    return out_frame.bytes_payload
第 1 步 / 共 7 步:携带 G.711 u-law 编码的 160 字节入站负载从 RTP 套接字到达。
每 20 毫秒,这一序列将一个 160 字节的负载转换为 640 字节、16,000 Hz 的 16 位 PCM 未压缩采样流。在一秒钟的语音片段中,Asterisk 会生成 50 个这样的帧,总计正好 32,000 字节。这种恒定、确定性的未压缩线性帧流,正是流式语音转文本引擎生成实时转写所需要的。
用于 AI 集成的 Asterisk 核心接口
Asterisk 提供多种编程接口,用于将电话逻辑与外部软件桥接。选择合适的接口取决于你需要控制信令、媒体流,还是两者兼有:
+-------------------------------------------------------------------------------+
|                        Asterisk 核心控制接口                                  |
+------------------------------------+------------------------------------------+
|  控制与信令层                      |  媒体与帧流层                            |
|                                    |                                          |
|  - Asterisk REST 接口 (ARI)        |  - AudioSocket (TCP 流, 16kHz PCM)       |
|    JSON 事件、WebSockets、REST     |    双向低开销流传输                      |
|                                    |                                          |
|  - Asterisk 网关接口 (AGI)         |  - External Media (RTP / 单播 UDP)       |
|    同步进程执行                    |    直接向外部服务器中继 RTP              |
|                                    |                                          |
|  - Asterisk 管理器 API (AMI)       |  - WebSocket 媒体流                      |
|    异步 PBX 事件监控               |    浏览器与云原生音频管道                |
+------------------------------------+------------------------------------------+
Asterisk REST 接口(ARI)
ARI 提供细粒度的异步 WebSocket 事件流和 RESTful HTTP 端点,允许外部应用直接控制通道、桥接、录音和声音播放。外部 AI 控制器无需逐行执行僵化的拨号计划脚本,而是注册为一个 Stasis 应用,并接收每个呼叫事件的实时 JSON 通知(例如 StasisStart、ChannelDtmfReceived 或 ChannelHangupRequest)。
AudioSocket
AudioSocket 专为 Asterisk 与外部微服务之间的双向媒体交换而开发,通过最简的 TCP 或 UNIX 域套接字连接传递 16 位线性 PCM 音频。它在每个音频负载前添加一个微小的 3 字节头部(1 字节表示消息类型,2 字节表示负载长度),从而消除了 RTP 数据包头部和 SDP 重新协商的开销。
Warning
ARI 通过 JSON 消息处理呼叫控制和状态机,而 AudioSocket 和 External Media 处理高吞吐、低延迟的音频流。生产级 AI 架构会同时使用这两种接口。
现代 Asterisk 版本允许使用 ARI(/ari/channels/externalMedia)创建未桥接的外部媒体通道。Asterisk 分配一个内部通道腿,并立即将出站 RTP 数据包流式传输到 AI 工作进程正在监听的指定 IP 和 UDP 端口,同时接受入站的合成 RTP 帧。
总结
现代 Asterisk 通过一个以 ast_channel、ast_frame 和动态翻译路径为中心的异步、模块化核心来处理媒体。通过禁用直接媒体路由(direct_media=no),Asterisk 强制 RTP 媒体流经其翻译矩阵,从而实现运营商级编解码器(如 G.711 μ-law 或 Opus)与 AI 语音引擎所需的高保真线性 PCM 格式之间的自动转码。
 发表于 12 小时前
|
查看: 2|
回复: 0


