一句话:AI 让“生成一份证明”便宜到近乎免费,但“确认这份证明就是你想要的那个命题”依然要一位稀有的专家花几天时间。生成在加速,裁定没跟上,于是“已验证”这三个字正在和“有人真的读过”脱钩。
722 篇,一夜之间,然后自己撤了 3 篇
10 月 6 日,一个 GitHub 仓库悄悄放出来,里面是 722 篇数学手稿,归成 372 个结果族,涉及数论、代数、几何、理论计算机科学,声称推进了大量悬而未决的开放问题。制造这批手稿的生成式模型没有公开,外界只被告知:大约 4,000 道题被拿去评测,每个结果平均烧掉约 3 小时 ChatGPT Pro 级别的推理算力。
一夜之后,这个仓库自己动了手术。仓库里那份 history.md 变更日志写得很平静:
在《Algebraicity of Weil classes on split abelian eightfolds》里,一个符号错误让一个稳定化迹的消去论证失效,并连带让依赖该构造的两篇论文一起失效。
于是 10 月 7 日撤回 3 篇、修订 14 篇、更新 13 篇的引用关系、额外补上 6 个形式化证明。变更日志末尾还写了一句,把“形式化覆盖率”第一次摆到了台面上:顶层结果里已有 300 / 719 ≈ 42% 完成了 Lean 形式化。
到这里为止,这其实是个正面故事——发布方自己发现问题、自己撤回、自己公开日志,还留了撤回版本供追溯。
真正扎人的地方,是从那句 42% 开始的。
一个百分比,三家数不出同一个答案
42% 这个数被媒体大量引用。但当你顺着 README 的链接去 lean/formalization.yaml(那份专门登记“哪些论文有形式化证明”的机器可读目录)想复核它时,数不出来。
目录里能数的东西是(self-attention.org 按 commit SHA 独立计数、TTL Research 用 GitHub API 复核,两者一致):
| 能数出来的数 |
数的是什么 |
出处 |
| 173 |
挂了形式化主要结果的论文篇数 |
formalization.yaml → sources: |
| 200 |
Lean 声明条数 |
formalization.yaml → status.main_results: |
| 416 |
comparator 挑战文件(支撑结果) |
lean/ComparatorChallenges/ |
| 242 |
形式化范围说明文档(按族) |
lean/docs/ |
300 不在里面。 它既不是一个字段,也不是这几个数的和或差(173+200=373,200+30=230,173+30=203)。而且整个仓库里“top-line result”这个词从没被定义过——你无法知道分子 300 到底数的是什么单位。
三支互不相干的团队各自去数(Pebblous、self-attention.org、TTL Research),得出三个不同的答案:按论文数是 24%(173/719),按结果族数是 36%(135/372),按官方口径是 42%。TTL Research 那篇审计说得最克制也最准:“42% 的算术没错,但 300 不出现在任何机器可读字段里,也没给出推导方式。记下来是‘声称’,不是‘证伪’。”
这个区分很关键。现有证据不足以指控 OpenAI 虚报;能确定的是——当一个“验证覆盖率”指标无法被外部任何一方重建时,这个指标本身就不再传递信息。你看到 42%,不知道它对应谁、对应哪一层、谁审过。
而有意思的是,同一个仓库里,有一个字段是诚实的。formalization.yaml 末尾写着:
review:
  status: unchecked
unchecked 是公开规范里六级词汇的最低档。这个仓库主动写下了“哪一层没人看过”。发布方其实给了你答案,只是这个答案藏在链接深处的 YAML 里,没有印在那个 42% 旁边。
这个 bug 长什么样:三层验证,只有一层能自动化
722 篇数学手稿只是症状。病根是一个叫“生成-验证剪刀差”的结构性失衡,而且它跟数学没关系。
先把“这个证明已验证”这句日常话拆开。arXiv:2608.28997《Verification abundance, adjudication scarcity》(2026-08-29) 把“验证”分成三层,这个拆法非常锋利:
- L1 推导有效性——证明项能不能通过内核类型检查?每一步推理对不对?这一层能完全机械化,成本正趋近于零。 Lean 就是干这个的,而且干得很好。
- L2 表征忠实性——形式化的那个命题,是不是论文用自然语言说的那个问题?不是编译器能查的,只能由一个既懂该领域、又读得懂形式语言的人,逐句比对来判断。
- L3 认识论意义——这个结果新不新、重不重要、框得对不对?这是同行评议的老本行。
关键洞察是:只有 L1 原理上可机械化,而 L2 原理上不可自动化。
这不是“工具还不够好”的问题,是原理问题。论文追溯到 Fetzer 1988 年在 CACM 的论证:形式验证能建立形式对象之间的关系,但它建立不了“这个形式对象”和“它想代表的那个真实事物”之间的对应——因为这种对应本身不是形式关系,推导碰不到它。想机械地查“形式命题 S 是否忠实表达问题 Q”,你得先有一个 Q 的形式化 S′,可“S′ 是否忠实表达 Q”正是你一开始要问的问题。无限回归,只能终止在一个人类的判断上。
于是生成-验证剪刀差就形成了:
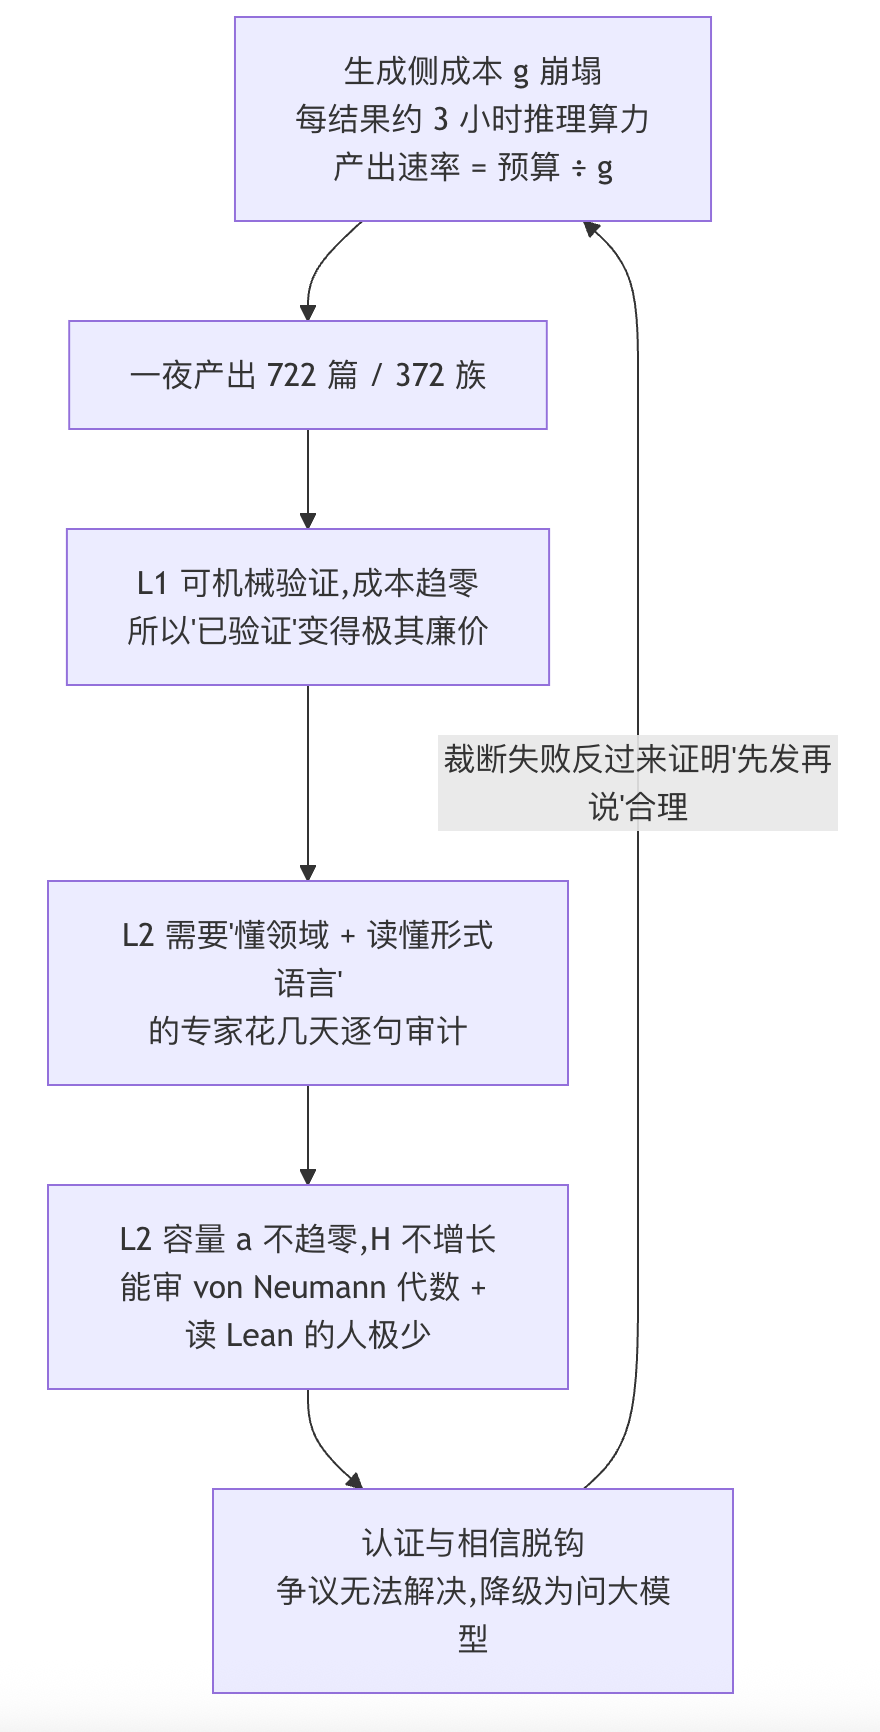
看这个闭环的狠处:L1 变便宜,不但没减轻审查负担,反而把原本“免费搭赠”的 L2 审查给隔离出来了。 过去一个读者逐行读证明,顺手也确认了命题说的是不是回事(因为要读懂论证就得理解对象)。现在机器接管了 L1,那点顺带的 L2 检查没了,L2 被单独拎出来,孤零零杵在那儿。而产出速率的唯一天然闸门——“要产出一份手稿得有人写”——也被拆掉了。
这不是数学独有的。arXiv 那篇论文明确说它可迁移到软件、密码学和受监管决策系统:一份机器验证过的“实现符合规范”证明,完全不能说明规范本身捕获了开发者想防的安全属性。
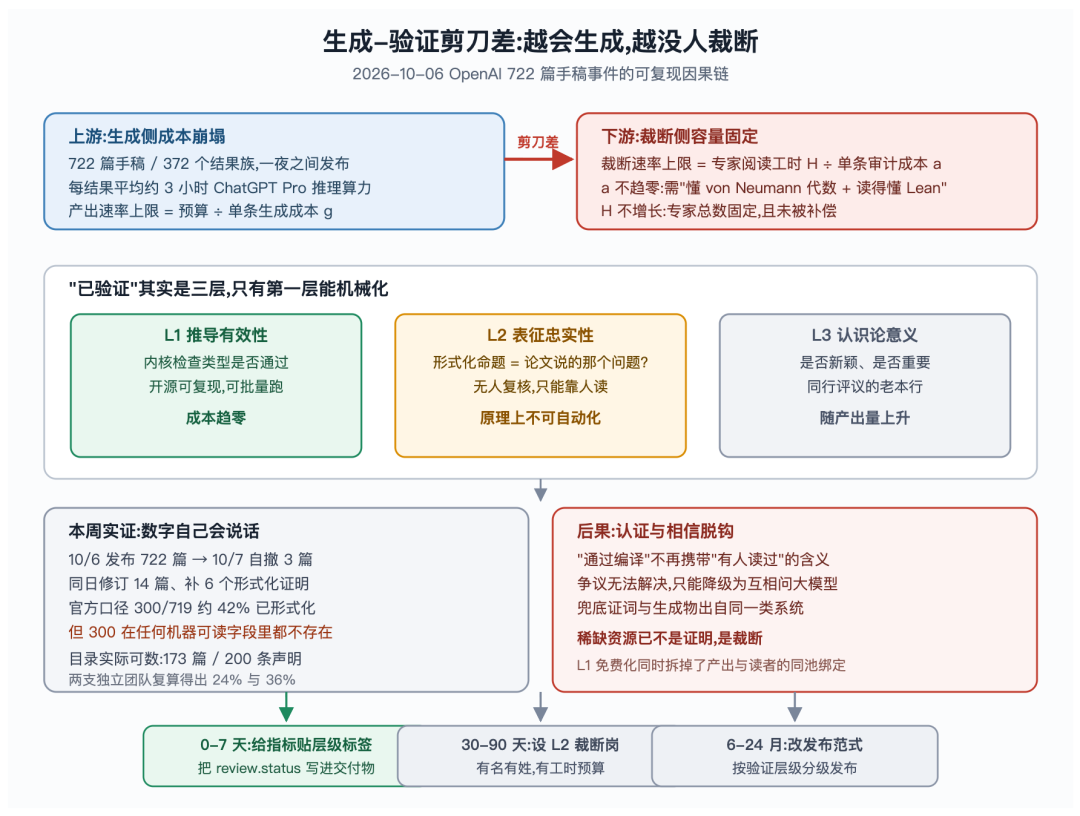
生成-验证剪刀差因果图
同期的工程佐证已经在发生。arXiv:2608.28997 对 8 月那次 10 个结果的全 Lean 形式化发布做了实测,量化出来是这样:
- 内核检查的证明体量:20.6 MB
- 需要人工审计的命题文本:55.6 KB
- 比例 379 : 1——按字节算,人要读的东西只占 0.263%
- 可问题面里塞了 218 个自定义定义,没有用社区已审定的库
按体积看,这工程做得漂亮(把审计面压到千分之三)。但它同时在另一个轴上把审计面撑大了:审的人不只是读一个定理,还得校验一本 218 个术语的私人字典。字节量压缩了,专业难度却没降。真正卡住这件事的,不是谁跑不完,也不是谁读不完 223 行,而是“能确认这份形式化恰好复现了 Connes 猜想原意”的人,得是既懂 von Neumann 代数、又熟 Lean、还愿意花几天替别家的成果做裁断的专家——这个交集极小,而且不随生成能力增长而变宽。
一句该被记住的话,来自那篇 arXiv 论文的结尾:稀缺资源已经不再是证明,是裁断。
四条链,同时在一个方向上断
为什么这个 bug 能持续存在?把它拆成四条链,每条都在同一个位置漏:
利益链:发布方的收益是速度与声量——722 篇、372 族、覆盖 4,000 题的标题,传播效果拉满。审稿方的成本是自己的时间。生成加速时,前者的边际收益上升、后者不变,没有任何力量让“多发一点”去等“审得过来”。
信息链:生成方和验证方之间缺的不是数据,是元数据。这份证明对应哪条自然语言命题、这些自定义定义对应社区里哪个标准定义、谁审过、审到什么程度——这些该跟着产物一起走的字段,要么空着,要么用散文写在一个链接不到的地方。
监管链:这件事没有监管。数学界的规范(同行评议)是自愿的,学界对 AI 成果的审稿机制还在摸索。AGMAI(普林斯顿高等研究院托管)9 月 29 日就发出过《负责任发布 AI 生成数学成果》,基于 600 多份问卷提了 5 条建议,建议 3 明确要求“公开模型名、用过的 prompt、摘要化的思维链、耗时、估算算力成本”。AGMAI 在声明里开头就直说:不认可在私有模型上测试高级数学问题这个前提。发布方在 10/6 的动作,基本上把这个前提踩过去了。
证据链:最有意思的一环。当 L2 裁断迟迟不来,社群的兜底行为是互相问大模型。8 月那场 Connes 刚性猜想的争议就是这么收场的——产生了对结论的批评、对批评的反驳、对批评作者机构是否存在的追问、另两家实验室扔出的机器生成的“反例”,最后是“部分参与者靠问语言模型来判断哪边对”。争议没被解决,它降级了。而且兜底的证词,和生成争议结论的东西,是同一类系统。
这就是这个 bug 的完整形状:它不是一个错误,是一个均衡态。 生成侧的理性选择(快速批量发布)恰恰制造了验证侧的不可行(无人可审),而验证侧的不可行又反过来证明了“先发再说”的合理性——因为反正没人审,审不审有什么区别?这个循环自己锁死了,不会自己走出来。
三层时间尺度上,分别能做什么
| 时间尺度 |
动作 |
责任方 |
怎么知道有效 |
| 0–7 天 |
给每个“验证/已核查”指标贴上层级标签和分母定义——把 review.status: unchecked 这类字段和指标印在同一处,分子分母必须同单位、可机器重建;撤回日志与覆盖率一起发布 |
发布方(AI 实验室、任何交付 AI 产出的团队) |
外部能仅凭公开产物独立重建该百分比;重建不出即为披露缺陷 |
| 30–90 天 |
给 L2 裁断设一个“有名有姓”的岗位——不是“质量保证”,是专门负责“确认形式/交付物=想要的那件事”的角色,有工时预算、可署名、可被引用 |
采纳 AI 产出的机构、期刊、会议、同行评议体系 |
该角色在流程里被真正执行过(有产出记录),而非只写在章程 |
| 6–24 个月 |
改发布与验收范式:按验证层级分级发布——claim / kernel-checked / statement-audited / absorbed 四级标签写进产物;形式方法社区用了几十年的“可复现检查脚本”下沉为默认交付形态 |
期刊/会议/标准组织、形式化社区 |
新发布默认携带层级标签;声称“已验证”不再需要读者额外追问层级 |
对不同角色的读者:
- 如果你在用 AI 产出做工程:先问“我的 L2 在哪”。AI 生成的 SQL、迁移脚本、模型配置,测试全绿不等于语义是你要的。一条经验:别让“通过了”这三个字单独出现在报告里,后面必须跟“谁看过、对照什么看的”。
- 如果你是数据库/工程侧:那个 42% 的教训直接可用——指标的分母必须可被外部重建。你们平台上的“通过率”“准确率”如果没人能从底层数据重新算一遍,就是在制造同样的对账黑洞。
- 如果你是投资人/看产业:这条裂缝未来会长出真生意(见下节),但也要清醒——现在还早,没有一家跑通了 L2 裁断的经济性。
三个正经商机(都不是灰产)
1. 交付物的“验证账本”(Verification Ledger)
- 谁买单:发布 AI 生成成果的实验室;把 AI 输出当交付物的企业团队(法务/合规/安全岗先买单,因为出了事要举证“我们验过”)。
- 为什么付钱:出事时,能拿出来的不是“我们跑了测试”,而是“谁在哪天、对照哪份规范、确认了哪一条”。现在没人卖这个,因为没人在意。
- MVP:一个 CI 式插件,读你的产物(代码/配置/形式化目录),自动生成一张账本——每个数字旁边标上层级标签、分母定义、复核人(可为空但必须显式为 unchecked)、证据链接。openai/math 的
formalization.yaml 其实已经是这个形状的雏形,只是没人把它当成可交付的产品面。
- 怎么验证有效:拿一批真实产物跑一遍,看能不能把“42%”这类不可重建的数字降到 0——能降到 0,账本就有用。
- 风险:卖“帮你标 unchecked”的工具没有护城河,容易被当作合规摆设;真壁垒在“复核人网络”和“账本被下游采信”的制度地位。
2. L2 裁断工程师(新型专家角色)
- 谁买单:同上,但换个收钱方式——不是卖工具,是把裁断本身做成服务/岗位。
- 形态:帮发布方按件承接口径审计(形式化命题 vs 自然语言命题的逐条比对、定义替换影响评估)。arXiv 论文里那个 218 自定义定义的审计面,就是一份现成的报价单。
- 为什么现在:8 月那场争议里,社群自己做了四周都没结论,恰恰说明这件事目前没人以“职业服务”承接,只靠免费热情。
- 怎么验证有效:出现第一批愿意为“这份形式化到底复现了原命题吗”付钱且拿到结论的案例。
- 风险:专业门槛极高(领域知识 × 形式方法 × 愿意替人做裁断),供给极稀缺,规模化很难;更现实的是先做人少但价高的精品服务。
3. 把“可复现检查”下沉成默认工程实践
- 谁买单:任何做 AI 生成代码/证明交付的工程团队。
- 为什么付钱:self-attention 那篇文章总结得很好——Comparator 那种检查是“编译器说了算、不是评分器说了算”,陌生人能重跑一遍、得到同样或不同的答案,单条结果跑一次的成本还很低。这正是“值得核对而不是相信”的检查的形状。
- MVP:把你产物里最关键的那条主张,包成一个陌生人一条命令就能重跑的检查脚本。
- 风险:这更多是方法论而非生意,价值在于提升信任而非变现;别硬包装成 SaaS。
还要盯什么(反证信号)
如果我上面这个“生成-验证剪刀差”的判断错了,大概率会看到这些信号:
- L2 出现实质性自动化:如果出现一个通用方法,能可靠地把“自然语言命题 ↔ 形式化命题”的忠实性也自动判定,那剪刀差就会被技术抹平——目前没有任何证据朝这个方向走。
- 外部能重建 42%:如果哪天第三方能仅凭公开产物把 300/719 精确重建出来,说明披露缺失只是早期疏漏,不是结构性问题。
- 裁断岗位被制度化:如果主流期刊/会议开始要求 L2 审计署名并计入评价体系(像同行评审那样被认可、被引用),H 会开始增长,剪刀差收敛。
- 争议被真正解决而非降级:如果类似 Connes 那类争议最终由一位具名专家给出明确裁断并被接受,说明兜底路径还没完全接管。
- 反过来的信号(我在错):如果发现 8 月/10 月语料其实有未被公开的内部人类 L2 复核,那“agent-reviewed = 无人复核”的推论要打折扣——不过这不影响剪刀差的结构,只影响 OpenAI 这个具体案例的严重性。
结语:稀缺的不是证明,是裁断
AI 驯服了“写出一份看起来像证明的东西”,但没有、也很可能永远不会驯服“这份东西恰好是你要的那个命题”。
前者是生成问题,后者是理解问题。它们看起来相邻,实际隔着一道原理性的墙——这道墙不是工程难度,是形式化本身的边界。绕过去的方式只有一个:有一个人,愿意花几天时间,认真读你写的东西,并说清楚他读懂了什么。
这套机制过去靠“要产出一份手稿,得先有人写”这个天然约束维持着。那个约束没了。补上它,不是靠更强的机器,而是靠给裁断这件事正名:定岗、定预算、定署名、定制度。围绕验证账本、L2 裁断这些话题,也值得在云栈社区继续讨论下去。
就像 arXiv 那篇论文说的——工程能把审计面缩小,但造不出审计员。
 发表于 4 小时前
|
查看: 12|
回复: 0


