AES 是对称加密算法,在逆向分析里经常遇到。AES 相关的白盒实现资料中,白盒 AES 算法详解写得很不错,读起来也容易理解。但我在从原理落到代码实现的过程中常常卡壳,所以这里结合 C 语言源码把 AES 的加密流程串一遍。本文使用的源码是 tiny-AES-c: https://github.com/kokke/tiny-AES-c
密钥扩展
下面以 AES-128 为例。输入密钥长度是 16 字节,因此每次参与加密的明文长度也要与之匹配。加密前需要先把明文按 16 字节一组切分,再按组分别加密,这与 ECB 加密模式的处理方式一致。
AES 加密一般要经过 10 轮运算,所以总共需要 11 个密钥:每轮一个,再加上最初的一个。用初始密钥生成后续 10 个密钥的过程,就是密钥扩展。如下图所示,k0 到 k3 为初始密钥,每个块占 4 字节,其余 k4 到 k44 则通过初始密钥扩展计算得到。
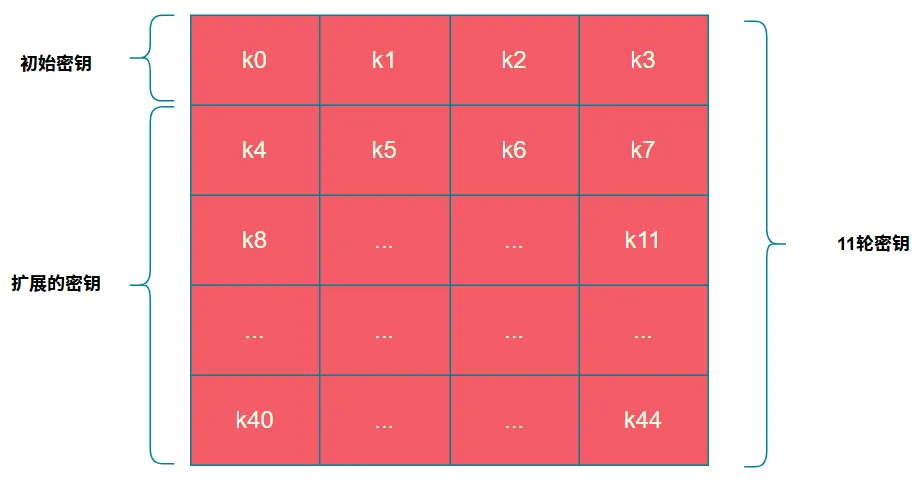
扩展密钥依赖公式:后面的密钥块由前面相邻密钥块异或得到。例如 k_n = k_{n-4} XOR k_{n-1},后面依次类推。
不过 k4、k8 直到 k40 这些位置比较特殊,它们的计算需要先经过 G 运算,再与前面的密钥块异或。
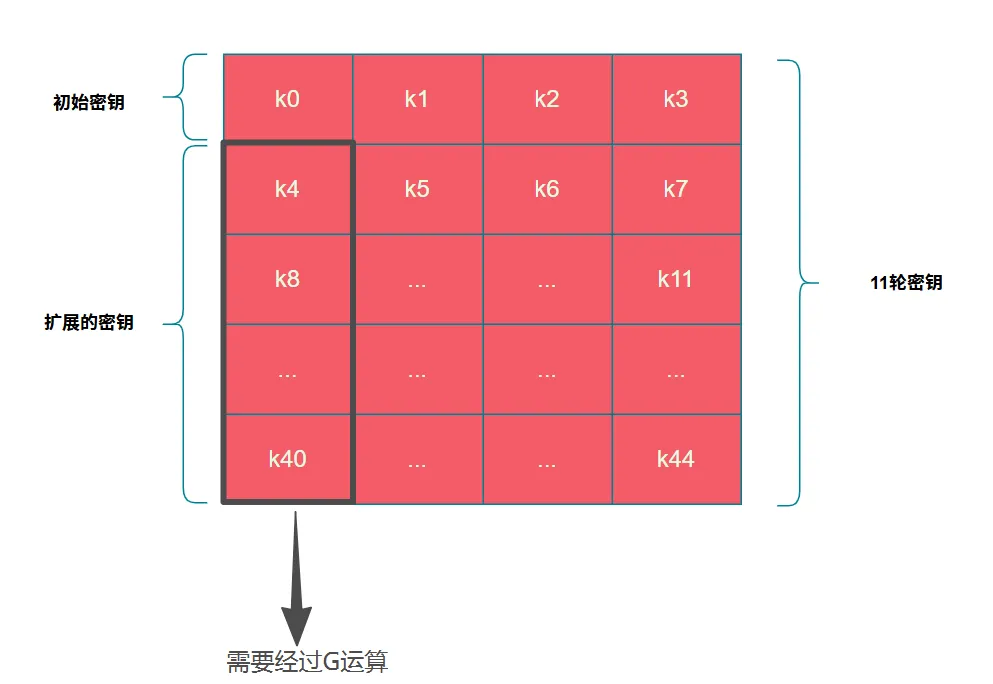
G 运算
G 运算可以拆成三个步骤:行位移、S 盒替换、与常数进行异或。这里假设 k3 = 0x11223344,方便说明。
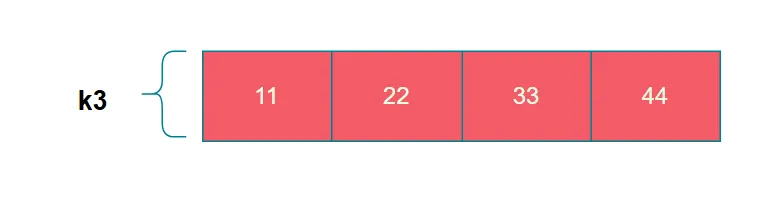
行位移
行位移实际上就是做一次循环左移,让每个字节整体向左移动一个字节的位置。
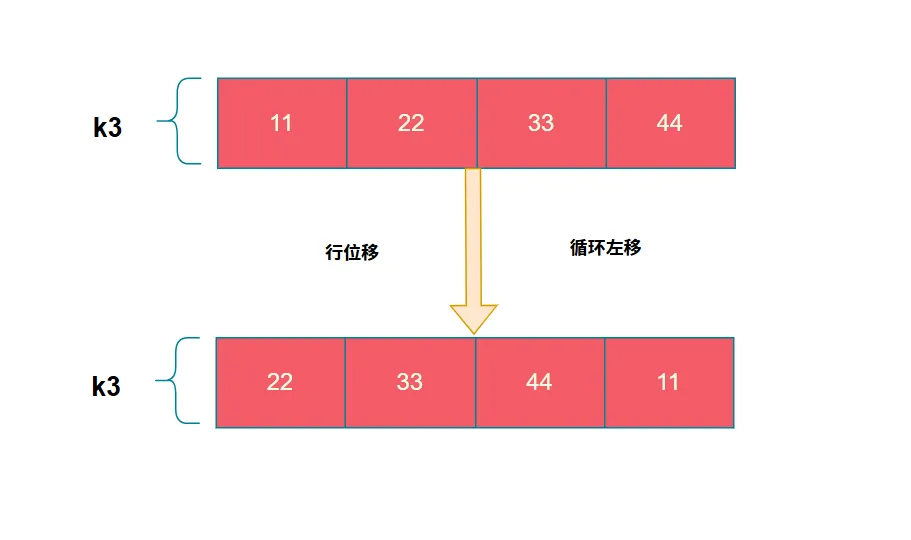
在 tiny-AES-c 中,行位移是通过临时变量交换实现的,核心逻辑如下:
// 行位移
const uint8_t u8tmp = tempa[0];
tempa[0] = tempa[1];
tempa[1] = tempa[2];
tempa[2] = tempa[3];
tempa[3] = u8tmp;
S 盒替换
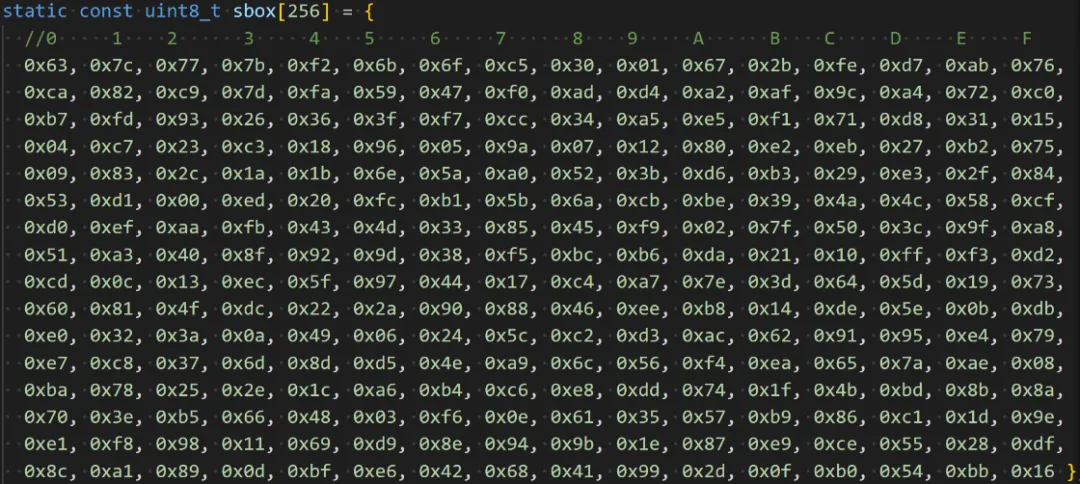
S 盒是一个长度为 256 的数组,里面存放着固定的数值。S 盒替换就是把字节的值作为下标,到数组中取出对应的值。
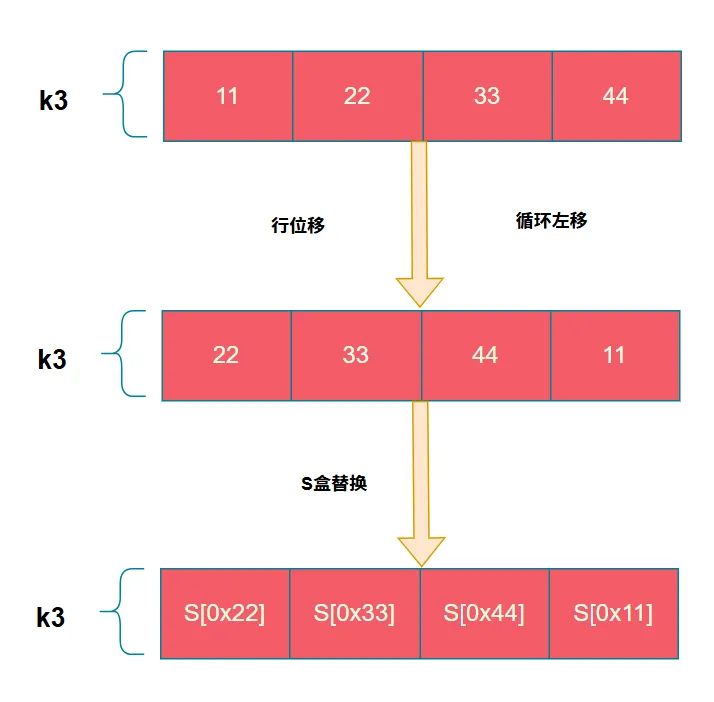
S 盒的数值如下,因此逆向时可以把 S盒的值作为AES算法的特征值 来判断目标程序是否使用了 AES。
S 盒替换的实现方式是先定义 sbox 数组,然后把行位移后得到的密钥字节值作为下标,从 sbox 中取值,示例代码如下:
#define getSBoxValue(num) (sbox[(num)])

// ...
tempa[0] = getSBoxValue(tempa[0]);
tempa[1] = getSBoxValue(tempa[1]);
tempa[2] = getSBoxValue(tempa[2]);
tempa[3] = getSBoxValue(tempa[3]);
// ...
常量异或
参与常量异或的数值保存在名为 Rcon 的数组中。

接下来把 S 盒替换的结果与这些常量进行异或。这里的 n 代表轮数,对应后续 10 轮扩展中使用的 Rcon 值。需要注意的是,Rcon 数组下标从 1 开始使用,而且每个元素只占一个字节,所以只需要取密钥的第一个字节进行异或即可。
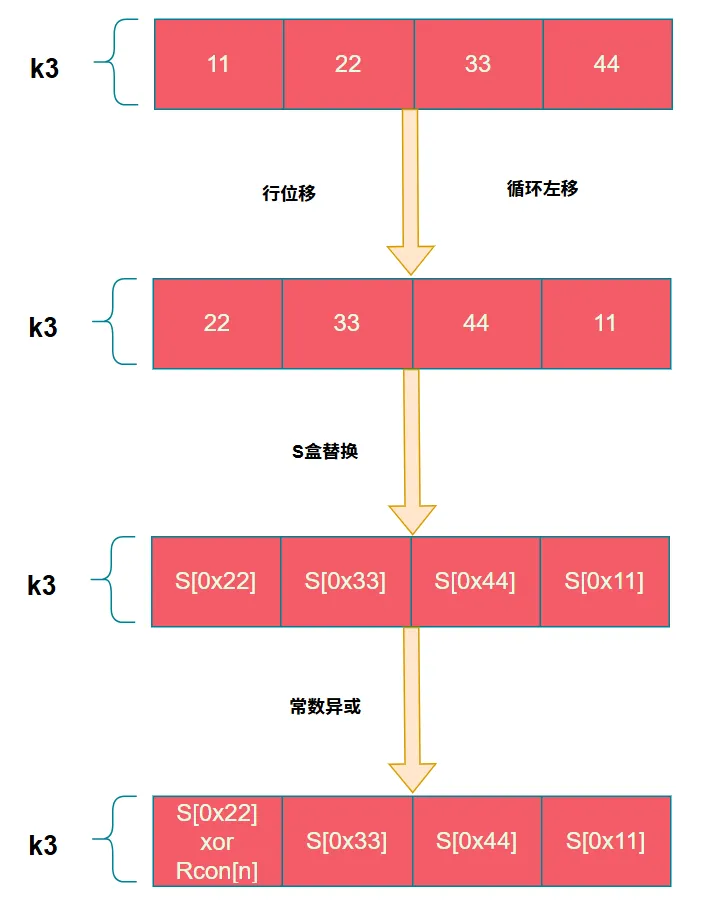
进一步看代码,由于 Nk=4,i 只会取 4 的倍数,因此 i/Nk 恰好表示轮数:第一轮使用 Rcon[1],第二轮使用 Rcon[2],依此类推。
// 常量异或
tempa[0] = tempa[0] ^ Rcon[i/Nk];
经过以上步骤就得到了 G 运算的结果。比如扩展密钥 k4 就是经过 G 运算后的 k3 与 k0 异或得到。也就是说,k4 = G(k3) XOR k0。
这里有个实现细节:代码是以字节为单位处理的,而 AES 算法中的 k_n 是以 4 字节为单位的,所以处理下标时要乘以 4。无论 tempa 中存的是经过 G 运算的结果还是普通的前一轮密钥块,都可以统一用下面这段异或逻辑处理:
// j 为密钥具体字节的下标,k 代表的是 n-4
// tempa 数组存储经过 G 函数处理后的密钥字节
j = i * 4;
k = (i - Nk) * 4;

RoundKey[j + 0] = RoundKey[k + 0] ^ tempa[0];
RoundKey[j + 1] = RoundKey[k + 1] ^ tempa[1];
RoundKey[j + 2] = RoundKey[k + 2] ^ tempa[2];
RoundKey[j + 3] = RoundKey[k + 3] ^ tempa[3];
加密阶段
正式加密前,需要先把明文转换为 state 状态矩阵。转换方式并不复杂,本质就是按列存储明文数据。
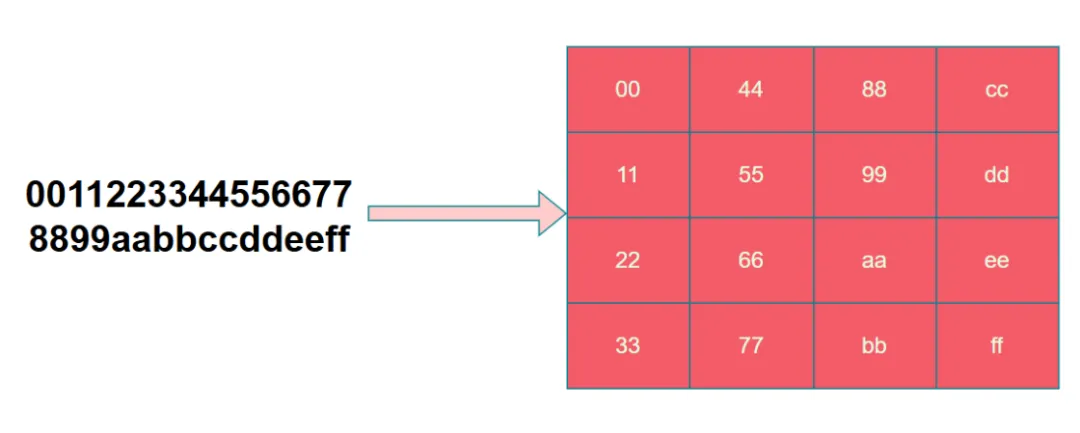
整体加密过程如下图所示:先经过轮密钥加、字节替换、行位移、列混淆,其中最后一轮不再进行列混淆。
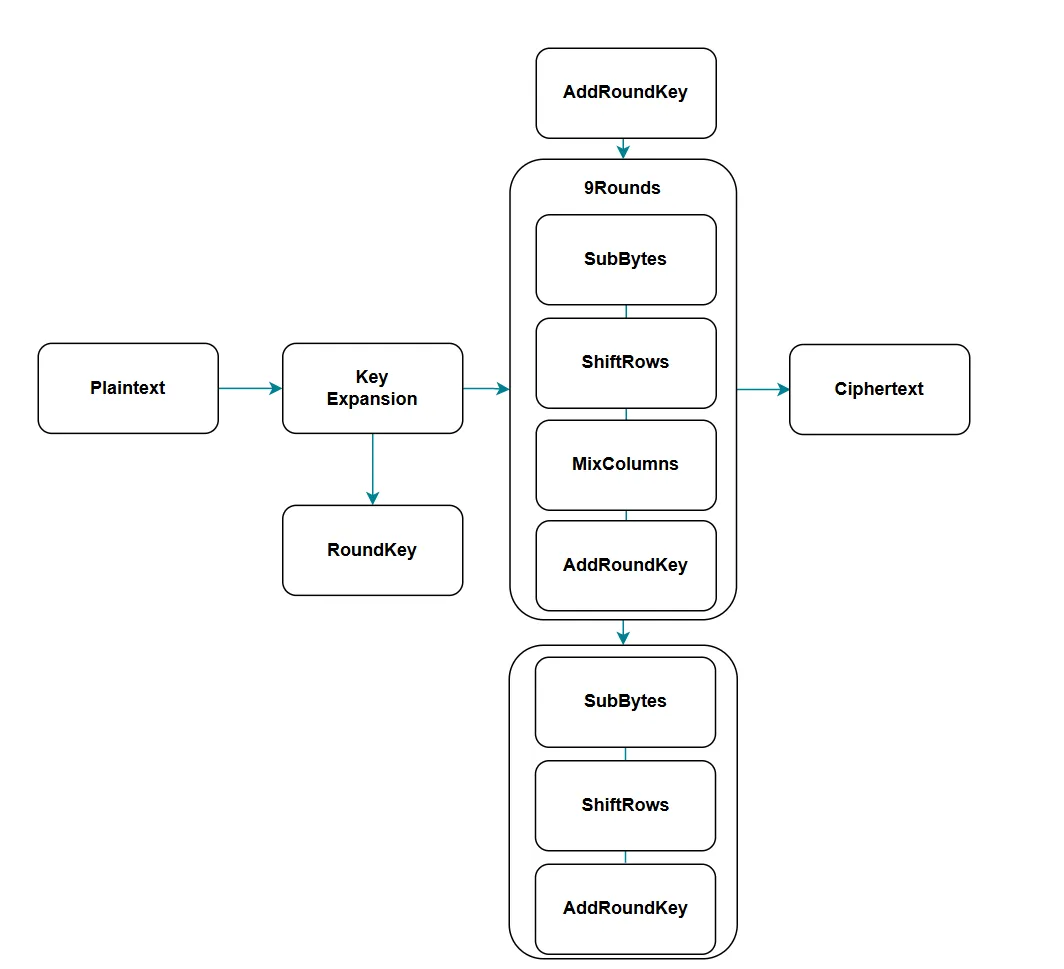
轮密钥加
在 AES 中,加法表现为异或操作。轮密钥加就是按字节把明文与当前轮密钥逐字节异或。
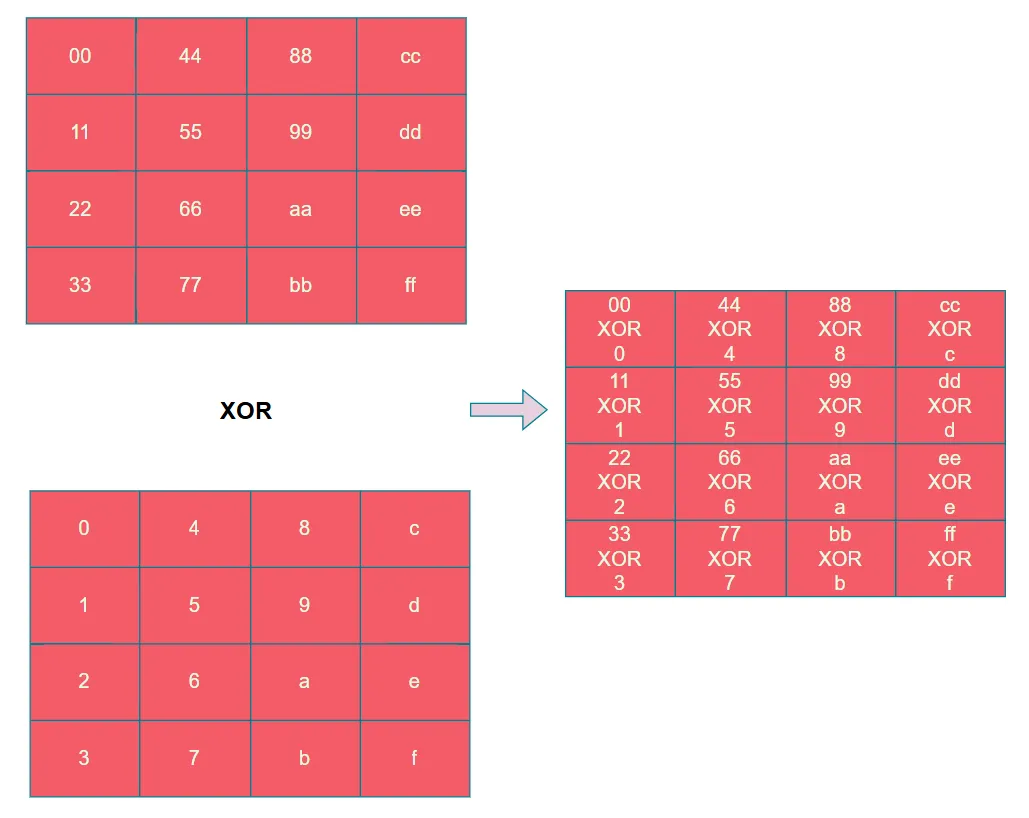
在 tiny-AES-c 中,state 实际按行存储,但轮密钥加只是逐字节异或,因此按行存储并逐字节取出明文与密钥异或,最终结果不会受影响。相关实现如下:
static void AddRoundKey(uint8_t round, state_t* state, const uint8_t* RoundKey)
{
  uint8_t i, j;

  // 轮密钥加,逐个字节异或
  for (i = 0; i < 4; ++i)
  {
    for (j = 0; j < 4; ++j)
    {
      // 每轮密钥是 16 字节
      (*state)[i][j] ^= RoundKey[(round * Nb * 4) + (i * Nb) + j];
    }
  }
}
字节替换
字节替换与密钥扩展中的 S 盒替换完全一样。这里逐行逐列取出字节,再进行 S 盒替换:
static void SubBytes(state_t* state)
{
  uint8_t i, j;

  for (i = 0; i < 4; ++i)
  {
    for (j = 0; j < 4; ++j)
    {
      (*state)[j][i] = getSBoxValue((*state)[j][i]);
    }
  }
}
行位移
行位移以 state 矩阵为单位,对每一行做循环左移。第一行不移动,第二行左移 1 字节,第三行左移 2 字节,第四行左移 3 字节。
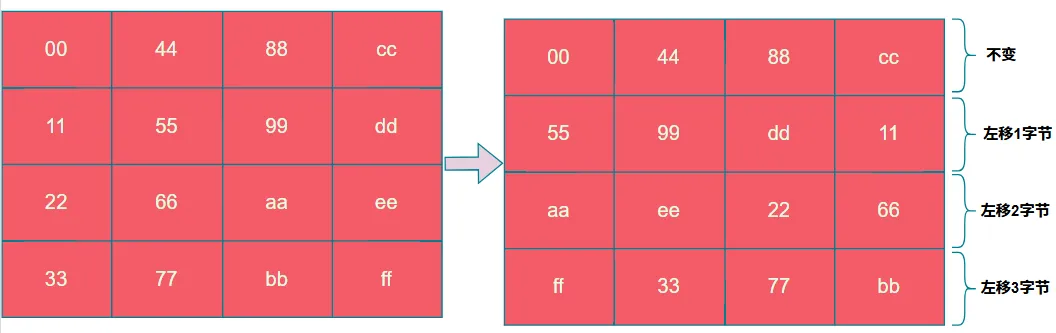
由于 tiny-AES-c 将明文按行存储方式转换为 state,所以实际移位时要“按列”来实现。
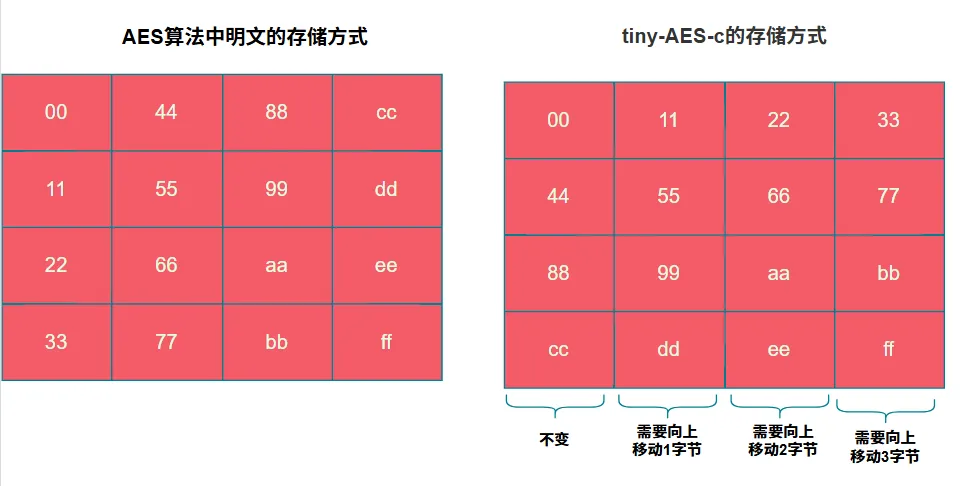
static void ShiftRows(state_t* state)
{
  uint8_t temp;

  // Rotate first row 1 columns to left
  // [1][1] 移动到 [0][1],相当于向上移动 1 个字节
  temp           = (*state)[0][1];
  (*state)[0][1] = (*state)[1][1];
  (*state)[1][1] = (*state)[2][1];
  (*state)[2][1] = (*state)[3][1];
  (*state)[3][1] = temp;

  // Rotate second row 2 columns to left
  // [2][2] 移动到 [2][2],相当于向上移动 2 个字节
  temp           = (*state)[0][2];
  (*state)[0][2] = (*state)[2][2];
  (*state)[2][2] = temp;

  temp           = (*state)[1][2];
  (*state)[1][2] = (*state)[3][2];
  (*state)[3][2] = temp;

  // Rotate third row 3 columns to left
  // [3][3] 移动到 [0][3],相当于向上移动 3 个字节
  temp           = (*state)[0][3];
  (*state)[0][3] = (*state)[3][3];
  (*state)[3][3] = (*state)[2][3];
  (*state)[2][3] = (*state)[1][3];
  (*state)[1][3] = temp;
}
这段代码的作用可以这样理解:把表格翻转一下,原本的“向左移动”就等价于代码中的“向上移动”。
列混淆
列混淆通过矩阵乘法实现。
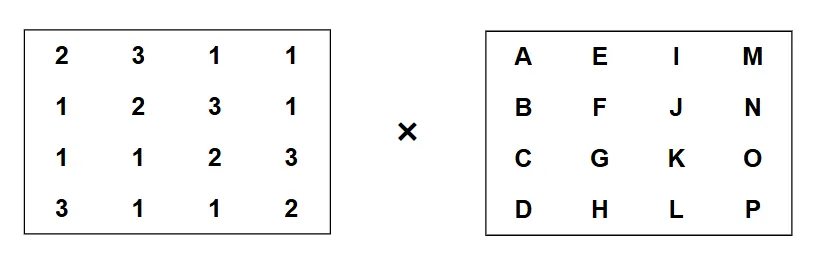
展开后得到的式子如下:
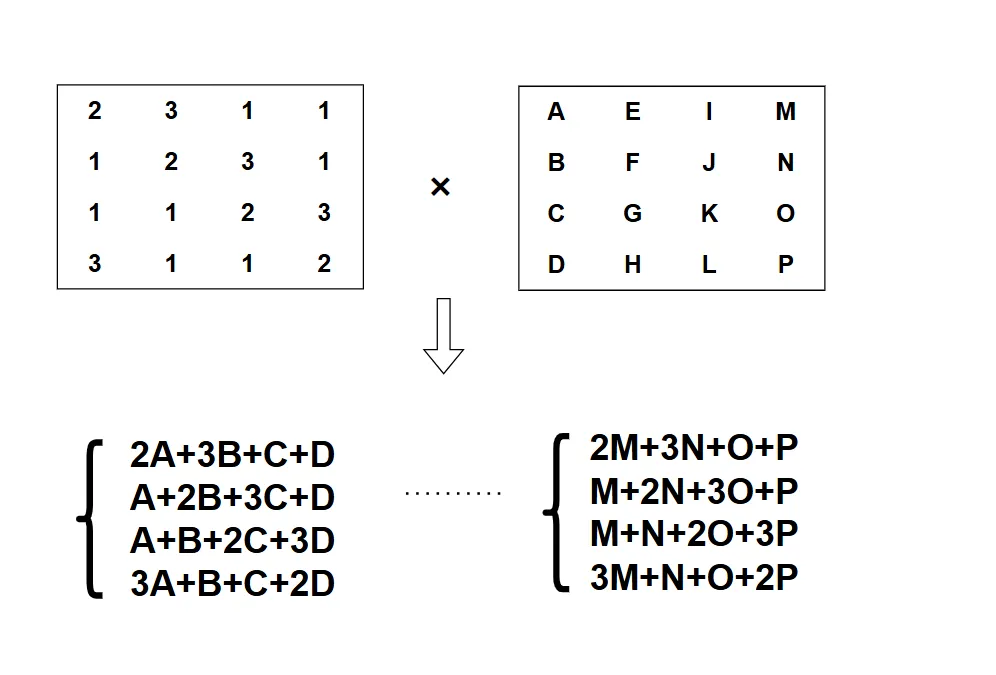
在 AES 中加法就是异或,所以式子进一步变为:
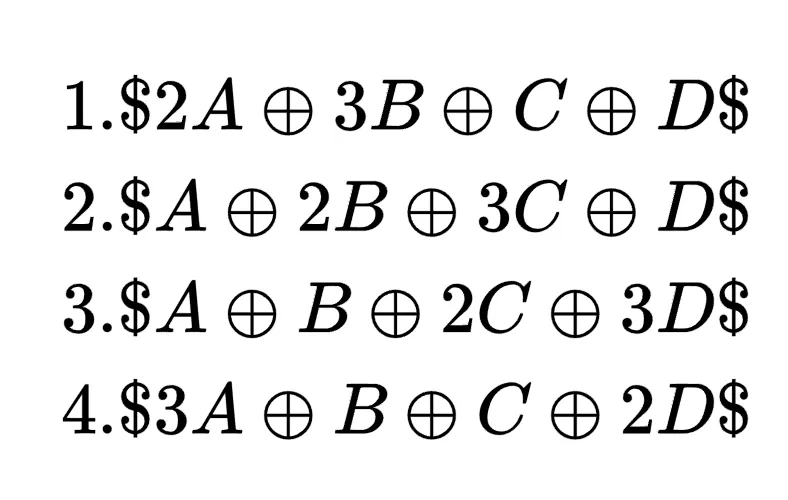
列混淆中的乘法属于伽罗瓦域内乘法。根据前面的式子,核心情况有三种:乘以 1、乘以 2、乘以 3。
- 乘以 1:保持原值。
- 乘以 2:左移一位,同时判断是否溢出。如果最高位为 1,左移后需要额外异或 0x1b。
- 乘以 3:可以拆成乘以 2 后再异或原值。
tiny-AES-c 中的列混淆实现如下。其中 xtime 是 GF(2^8) 下的二倍乘:先左移一位,再右移 7 位判断最高位是否为 1。若最高位为 1,说明左移发生溢出,需要异或 0x1b,否则不需要。
实际代码中会先算出 A xor B xor C xor D 作为公共部分,因为每一轮列混淆都会反复用到它,提前计算可以避免重复操作。以 2A xor 3B xor C xor D 为例,它的化简过程如下:
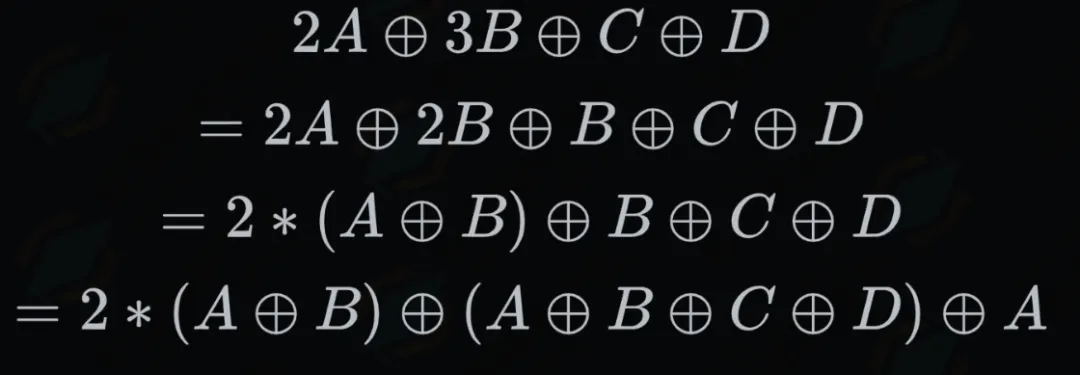
因此,列混淆的计算可以归纳为三个部分:
// xtime 为 GF(2^8) 的二倍乘
static uint8_t xtime(uint8_t x)
{
  // 左移一位相当于乘以 2,然后右移 7 位判断最高位是否为 1
  // 为 1 就需要异或 0x1b,否则不用
  // 最高位为 1,左移会溢出,因此需要加上 0x1b,而 GF(2^8) 中加法等于异或
  return ((x << 1) ^ (((x >> 7) & 1) * 0x1b));
}

// MixColumns function mixes the columns of the state matrix
static void MixColumns(state_t* state)
{
  uint8_t i;
  uint8_t Tmp, Tm, t;

  for (i = 0; i < 4; ++i)
  {
    // t 是 A
    t   = (*state)[i][0];

    // 先求 A xor B xor C xor D,因为这是求解的公共部分,避免重复操作
    Tmp = (*state)[i][0] ^ (*state)[i][1] ^ (*state)[i][2] ^ (*state)[i][3];

    // 2A+3B+C+D = 2A+2B+B+C+D = 2*(A+B)+B+C+D = 2*(A+B)+(A+B+C+D)+A
    Tm  = (*state)[i][0] ^ (*state)[i][1];
    Tm  = xtime(Tm);
    (*state)[i][0] ^= Tm ^ Tmp;

    // A+2B+3C+D
    Tm  = (*state)[i][1] ^ (*state)[i][2];
    Tm  = xtime(Tm);
    (*state)[i][1] ^= Tm ^ Tmp;

    // A+B+2C+3D
    Tm  = (*state)[i][2] ^ (*state)[i][3];
    Tm  = xtime(Tm);
    (*state)[i][2] ^= Tm ^ Tmp;

    // 3A+B+C+2D
    Tm  = (*state)[i][3] ^ t;
    Tm  = xtime(Tm);
    (*state)[i][3] ^= Tm ^ Tmp;
  }
}
逆向中 AES 的识别
这里以 [SCTF2019]creakme 为例,说明如何 在 IDA 的反编译结果中识别 AES 算法。
密钥扩展
当看到一串明文字符时,可以先根据字符串长度判断它是否可能是密钥,进而推断 AES 的种类。例如下图中存在字符串 sycloversyclover,长度正好是 16,并且代码把它按字节拆开存储。结合 tiny-AES-c 的源码可以知道,实际运算时密钥需要以字节为单位处理,因此可以猜测该程序可能使用了 AES-128,这个字符串很可能就是密钥。
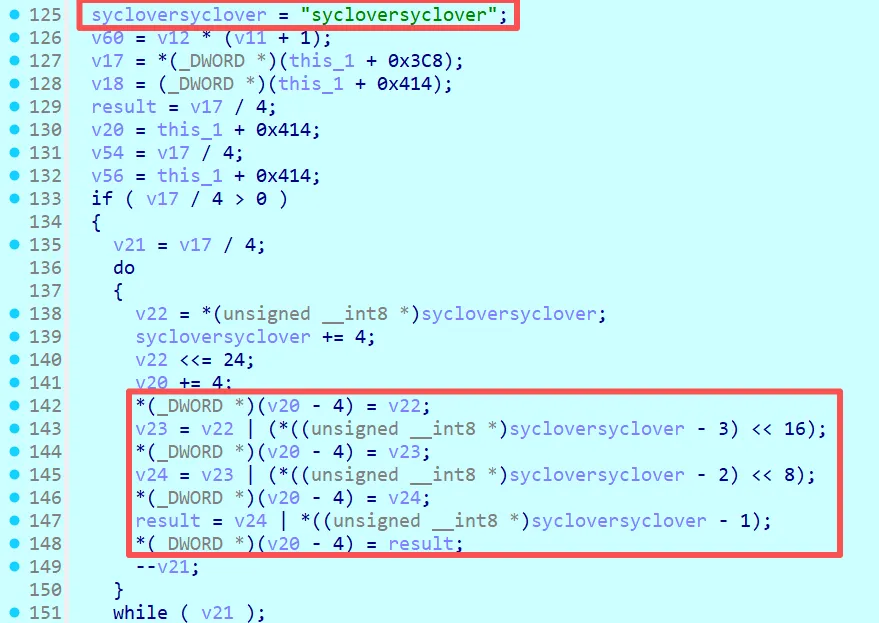
再结合后续操作能发现,185 行出现了 S 盒替换 S_BOX[v31] 以及 << 8 这类行位移特征。可以看到,IDA 反编译会把 G 运算的多步操作合并到一起。
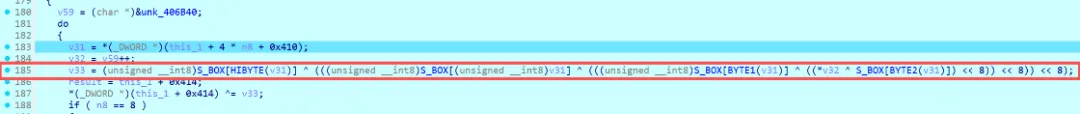
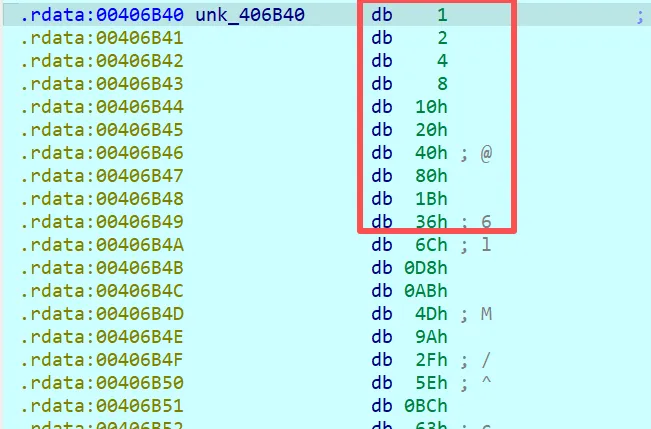
G 运算中还有一个常量异或操作,因此 *v32 大概率是在取 Rcon 数组的值。v32 由 v59 赋值而来,而 v59 又来自 unk_406B40。继续查看 unk_406B40 的数据,可以发现这些值与 AES 的 Rcon 数组完全一致,这就进一步验证了目标算法是 AES,当前函数属于密钥扩展操作。
另一个关键点是循环次数。AES 密钥扩展需要扩展到 k44,所以循环下标最大值也是 44。从调试信息中可以看到循环变量上限与这个特征吻合。
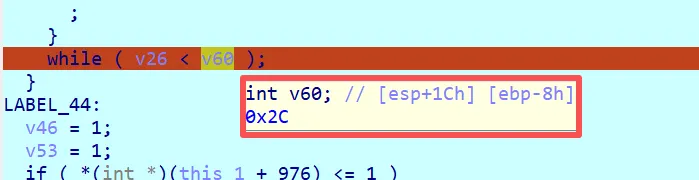
加密阶段
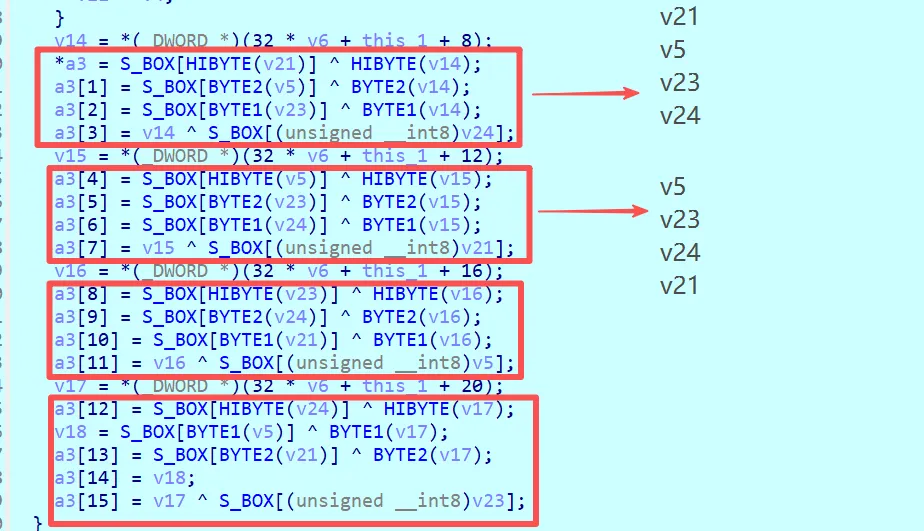
加密阶段可以直接看最后一轮,因为最后一轮不会执行列混淆。下图中可以明显看到 S 盒替换和轮密钥加操作。可能有人会疑惑:行位移在哪里?
仔细看每次参与 S 盒替换的变量其实不同,分别是 v21、v5、v23、v24。这些变量都是 int 类型,每个变量实际保存了 4 字节,这就相当于按行存储。前面已经分析过,如果 state 是按行存储的,那么移位就要按列向上移动,所以第二次替换顺序变成了 v5、v23、v24、v21。
那么前面的部分是否只是少了列混淆?这部分的字节替换看起来确实存在,但替换用的表似乎并不是普通 S 盒。
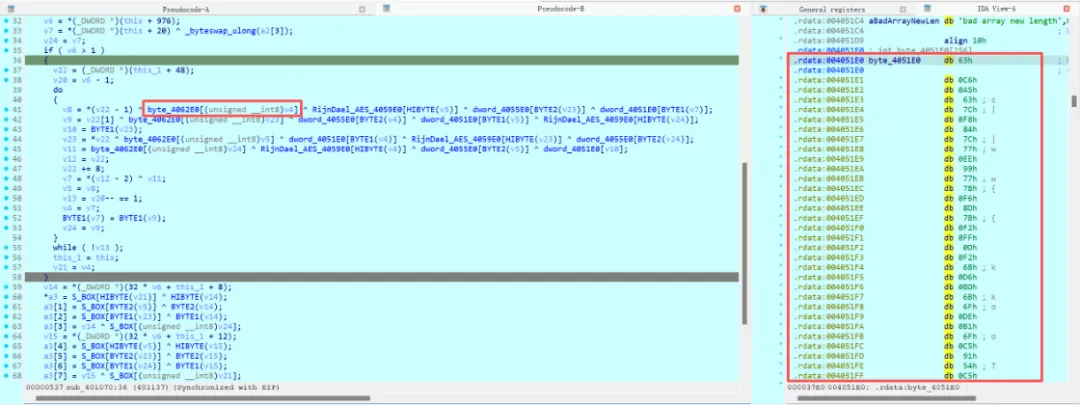
实际上这是 AES 的一种“空间换时间”实现,也就是 T 盒(T-table)实现。前面介绍的标准实现是:明文输入后依次经过轮密钥加、S 盒替换、行位移、列混淆。这些操作都以字节为单位,字节之间互不影响。一个字节的范围是 0 到 255,因此可以提前把每个字节经过 S 盒替换、行位移、列混淆后的结果算好,存成一张新表,这就是 T 盒。当输入一个明文字节时,只需直接查 T 盒即可得到上述多步结果,从而大幅减少运算时间。这也是为什么这里替换用的表不是原始 S 盒。
分析到这里,基本可以确认该函数就是加密阶段。
加密模式
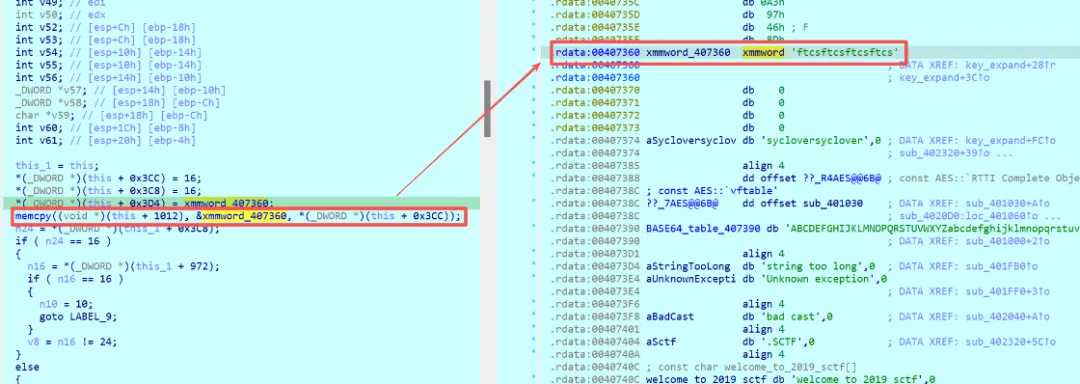
只要能识别出密钥扩展或加密阶段,通常已经能判断目标算法是 AES。但为了后续逆向更完整,还是建议快速区分这两个阶段。原因是分组对称加密还存在 ECB、CBC、CFB 等工作模式。例如下图中,加密前会先与 v15 进行异或,这就可以猜测是 CBC 模式,接下来就需要重点寻找 IV 初始向量。
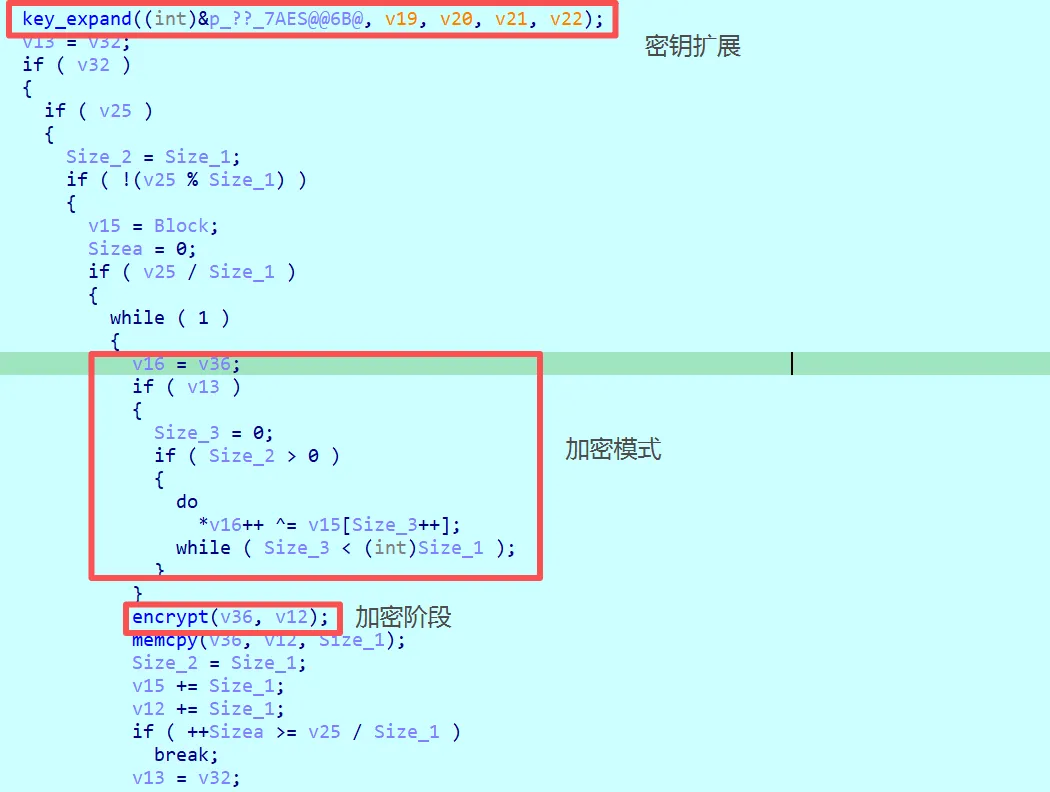
而在密钥扩展期间还能看到 IV 向量的拷贝过程,这也进一步验证了 CBC 加密模式的判断。
总结
AES 是常见的对称加密算法,如果熟悉它的加密流程,在逆向分析时可以显著节省时间。
识别 AES 算法时,可以重点从以下几个特征入手:
- 密钥扩展的循环次数
- S 盒特征值
- 第十轮加密流程中是否缺少列混淆
参考链接
 发表于 半小时前
|
查看: 3|
回复: 0


