国庆期间,那个在 OpenRouter 上横空出世、匿名屠榜的神秘模型 Space Bunny(玉兔),马甲终于被扒下来了。兔皮底下,竟然是 MiniMax。
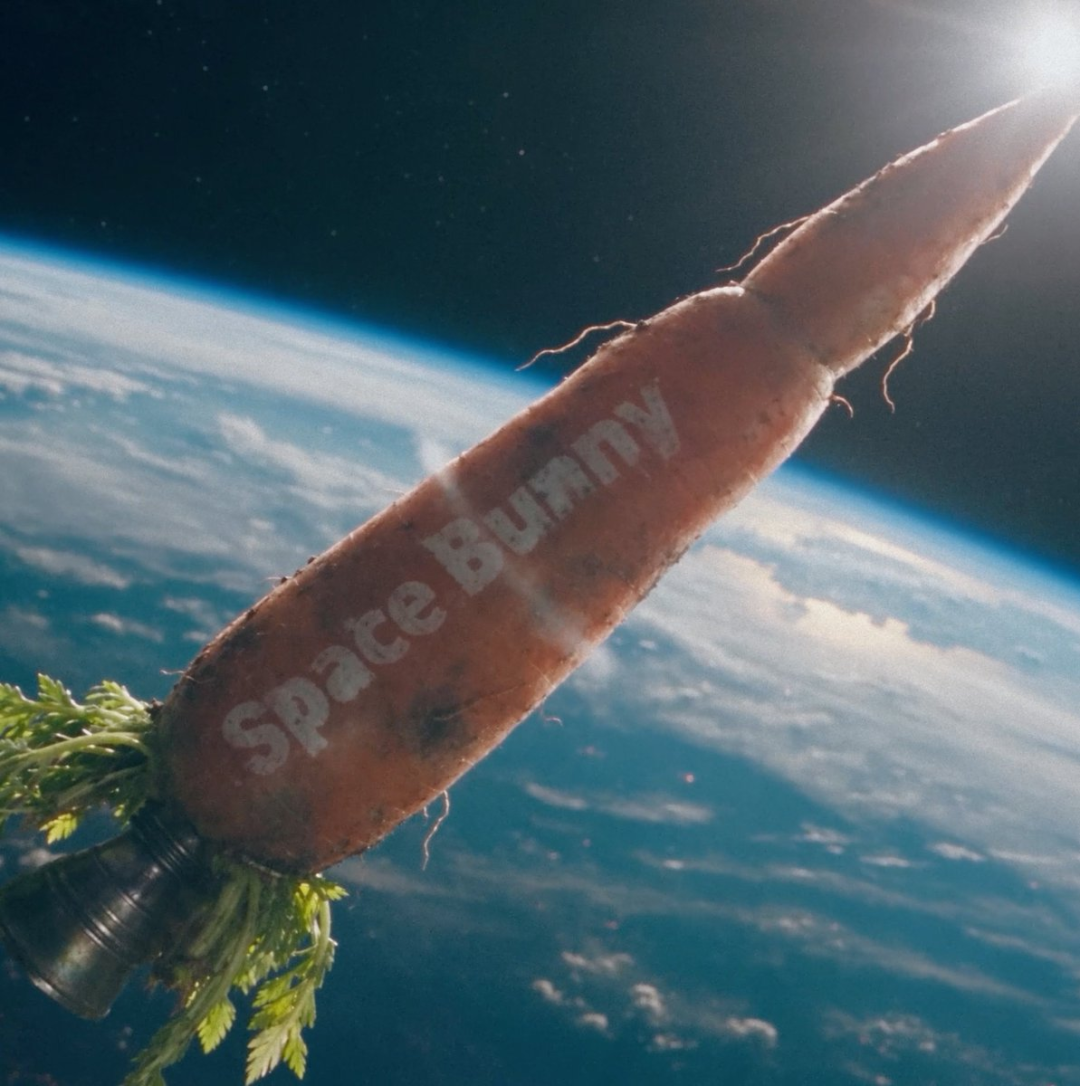
正式交卷的代号是 M3.1 Flash。而这个正式版的跑分能力,比 Space Bunny 还要猛一点,尤其是 Agent 这个技能点——Agents' Last Exam(ALE)得分 29.6%,直接拿下国模第一。
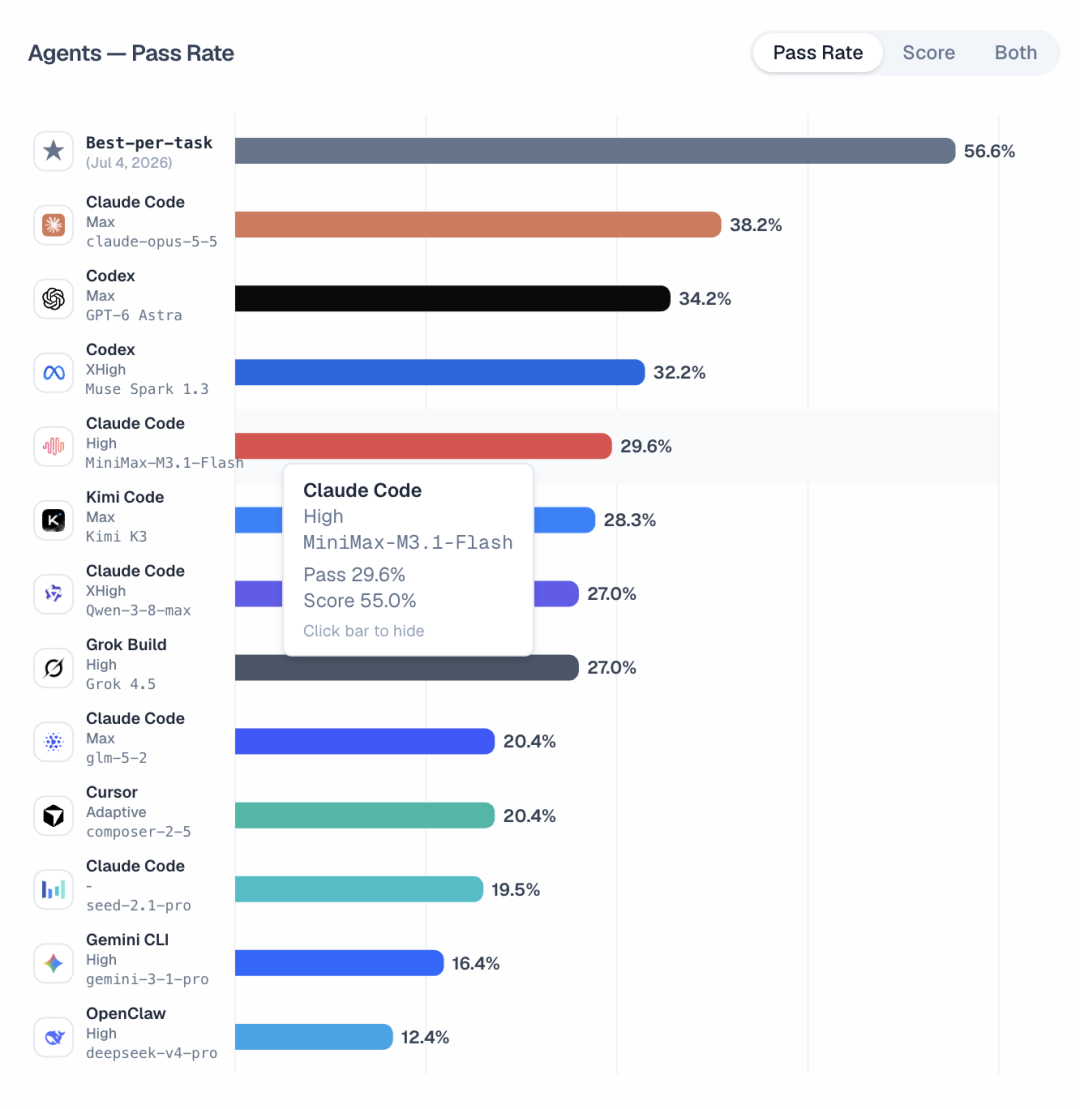
AA 榜单上它同样拿到了 43 分,作为 Flash 型号能有这个成绩,确实有点东西。
总之干活能力终于上来了,晋升高级牛马(doge)。
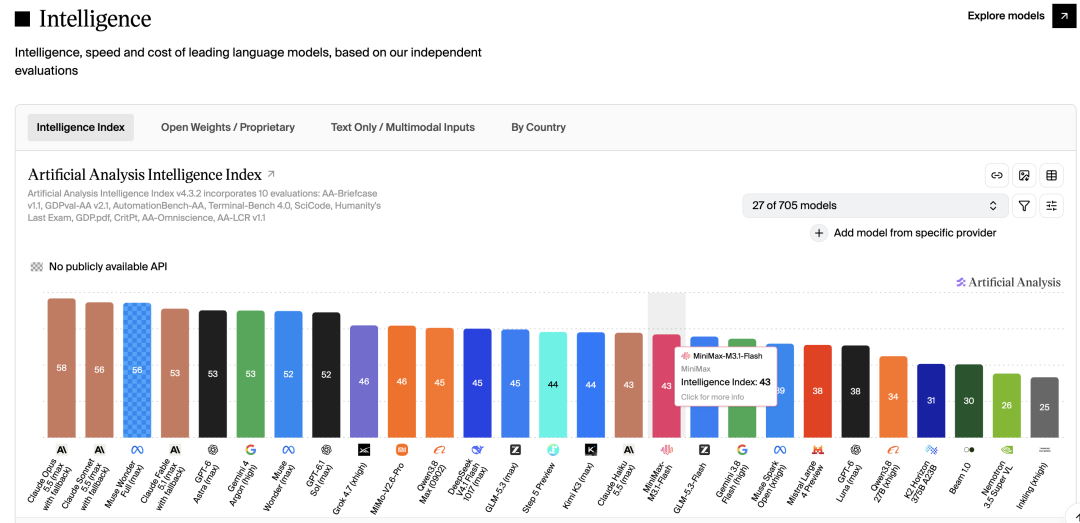
除此之外,Coding、网络安全、Computer Use……也全部杀进全球第一梯队。
在此基础上,「玉兔」时期的速度也保留住了,输出最快可达 200+ TPS。
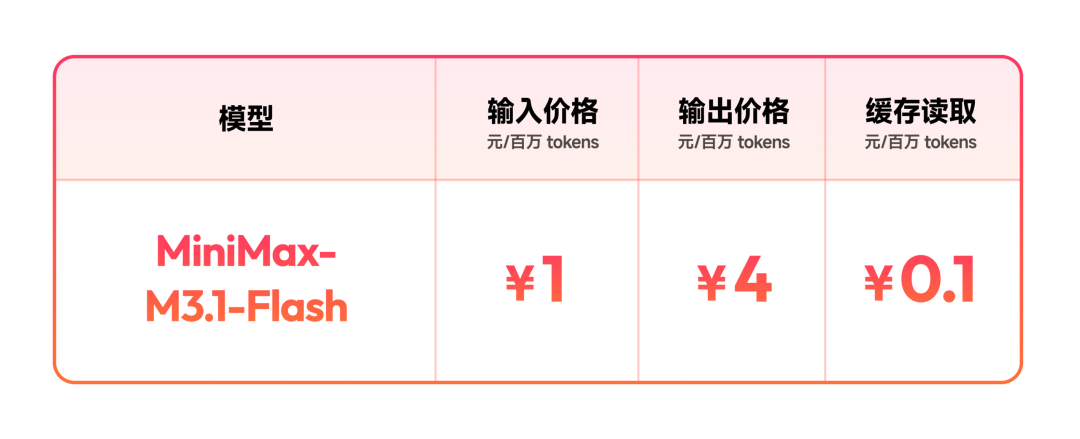
然后,最重要的来了——不愧是 Flash 啊,这价格是真的便宜!!输入每百万 Token 1 元,输出 4 元,缓存读取只要 0.1 元。综合成本直接压到上一代 M3 的 30%。什么,你对这个价格还是没概念?这么说吧——和谷期 V4.1 Flash 差不多。太仁义了,我宣布,以后闲时梁文谷,忙时闫俊峰!(bushi)
△ 图源:@大厂显微镜
不过,硅谷闭源阵营恐怕又得遭殃了。继 DeepSeek 之后,硅谷一众大参数旗舰又被国产 Flash 架上了一条全新的性价比斩杀线 o(╥﹏╥)o。
文本模型翻身仗
说实话,之前我对 MiniMax 有不少嘀咕。多模态和视频生成确实很顶,但纯文本大模型这边,不知道从什么时候开始就没动静了……这次 M3.1 Flash 亮相,也算打了一场翻身仗。咱们挨个看下战绩:
- 代码工程与真实修 Bug
DeepSWE v1.1 评测里,M3.1 Flash 拿下 73.7%。这波也算倒反天罡了。GPT-6.1 Sol、Claude Opus 5、Claude Fable 5……居然被一款 Flash 跑分反超。排在它前头的,只剩下 DeepSeek V4.1 Flash 1017 的 77 分。
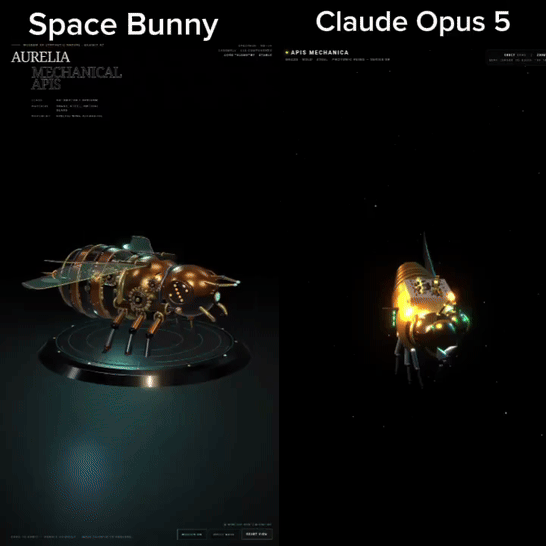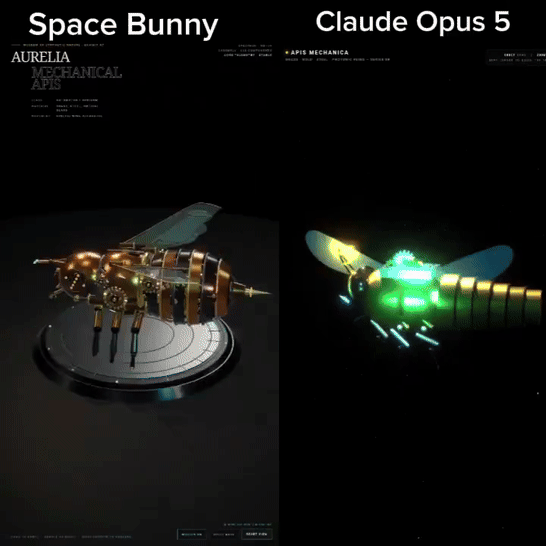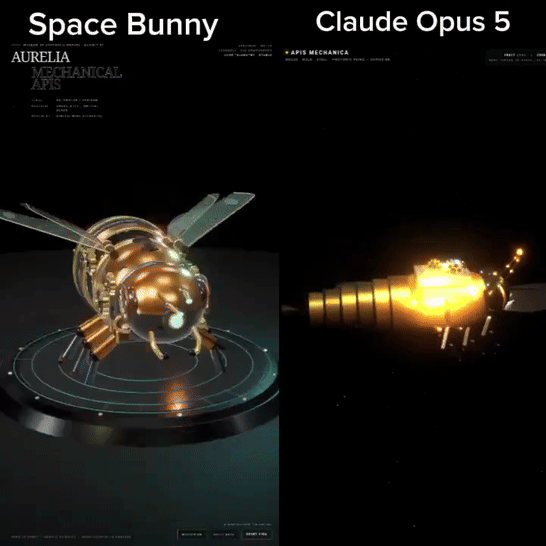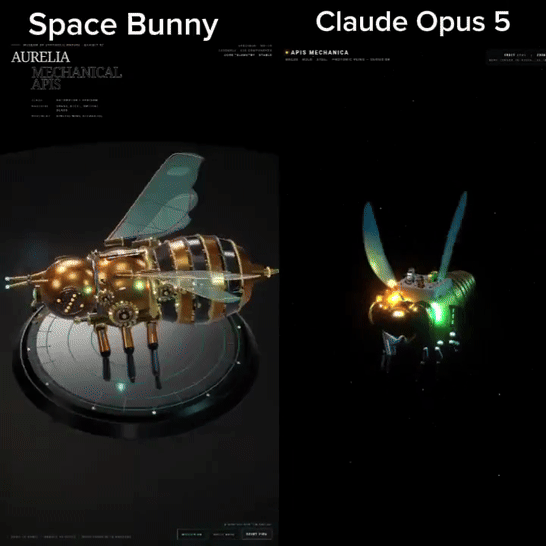
这也印证了玉兔匿名测试期间社区的反馈:处理 Three.js 这类 3D 渲染和复杂前端任务时,它对细节的把控极其变态。
- 网络安全实战
在加州大学伯克利分校主导的 CyberGym 基准测试中,M3.1 Flash 斩获 82.2 分,和 GLM-5.3(84.5)、GPT-5.6 Sol(83.6)并排坐在全球第一梯队。
- 复杂 Agent 与企业级跨 SaaS 工作流
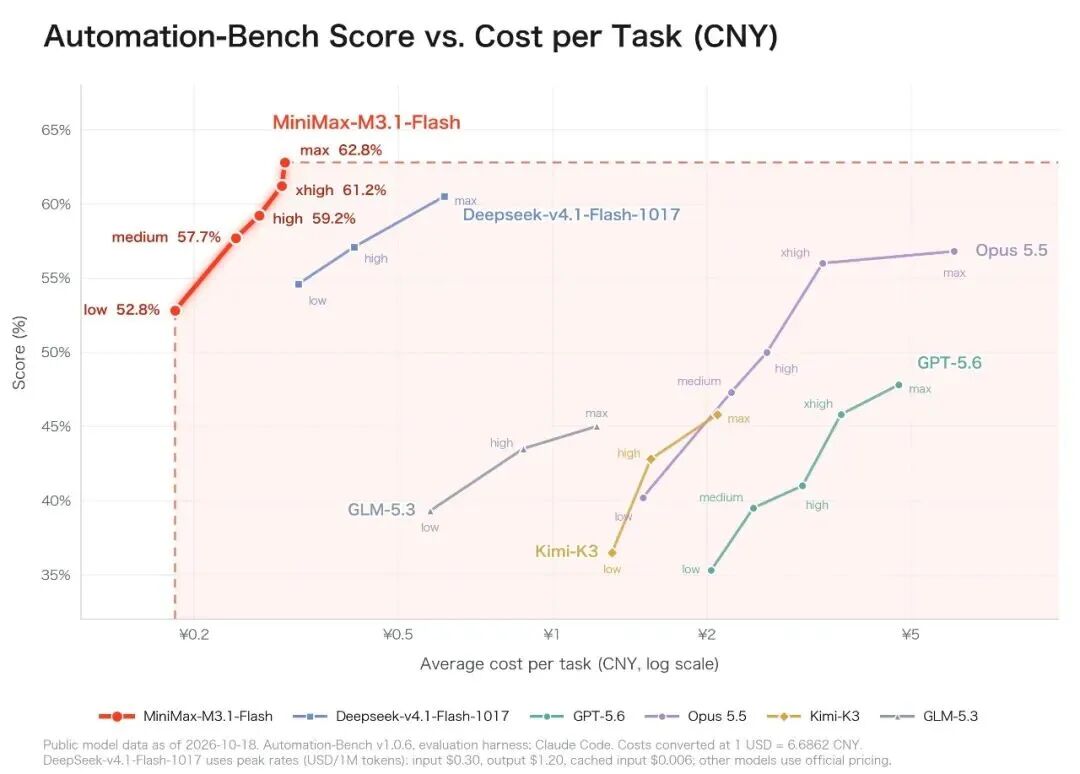
在自动化巨头 Zapier 开源的 AutomationBench-AA 评测中,M3.1 Flash 位居前列。单任务成本不到 0.05 美元,就能自己串起横跨销售、营销、客服、财务和 HR 的复杂工作流。在容错率极低的金融专属基准 BankerToolBench 上,M3.1 Flash 更是直接飙到 76.2 分,和公认的天花板 Claude Opus 5 并列全球第一。
- Computer Use 真实桌面操作
模拟真实电脑操作的 OSWorld V2 拿到 61.7 分;在衡量真实且带经济价值场景的 ALE 上,M3.1 Flash 也以极低的任务成本,做到顶尖模型级别的性能表现。两项都位列国产模型第一,又是斩杀一切的性价比大法。
说真的,我想过 MiniMax 的文本模型迟早会重回牌桌。但谁能想到,回来的是一个带 Flash 后缀的小家伙……
极速低价才是王道
只看基准跑分,你可能还觉得这只是神仙打架的日常。真正让人兴奋的,是这个模型对实际落地场景的降维打击。
大家平时搭多 Agent 协同或者长链路工作流,最怕遇到什么?无非两件事:无休止的转圈等待,和月底让人心惊肉跳的 API 账单。一个真正的企业级Agent,在后台往往要调几十次工具、在好几个子 Agent 之间反复传话。模型吐字慢,用户看着界面转圈直接关网页;调用单价贵,财务看一眼账单当场就能把项目叫停。
M3.1 Flash 爽就爽在这里。它底层上了相当激进的稀疏注意力架构,线上推理速度直接拉升将近 3 倍,输出速度最快可达 200+ TPS,中位数(P50)也稳稳维持在 170+ TPS。
170 TPS 是什么概念?你在 MiniMax Code 桌面端、Claude Code 或者各种本地 Coding 工具里派发一个重构任务,屏幕上的代码几乎以倾泻的状态瞬间刷满。以前串联四个子 Agent 像在等红绿灯,现在基本是无感刷新。
速度快得起飞的同时,价格更是直接打骨折:
- 输入价格:每百万 Token 只要 1 元
- 输出价格:每百万 Token 只要 4 元
- 缓存读取价格:每百万 Token 只要 0.1 元
输入和输出价格直接腰斩,缓存读取费用更是一口气降了 75%。结果就是,综合使用成本相比前代 M3 暴降 70%。
那还说啥了,站起来蹬吧家人们!!
国产双子星反围剿
过去大家有个默认共识:Flash 模型无非是旗舰大模型的廉价阉割版。选 Flash 是因为囊中羞涩,或者任务太水;真到了关键、复杂的硬核场景,最后还得加钱上大参数旗舰 Pro。
但现在呢?DeepSeek V4.1 Flash 1017 前脚刚立下性价比标杆,MiniMax M3.1 Flash 后脚就紧跟杀到,一个斩完另一个接着斩。小尺寸模型根本不是玩具,完全可以正面 PK 数倍参数、十倍价格的旗舰模型。黑子,说话!!
更有意思的是,这两个国产 Flash 模型走出了非常漂亮的互补路线:DeepSeek 在纯 Coding 的极致性价比上拔得头筹;MiniMax M3.1 Flash 则在跨 SaaS 企业工作流、金融工具链调用等综合 Agent 维度上有所强化。一个死磕代码工程,一个深耕复杂业务流。
而且家人们,我搁互联网上一刷,发现了个天才 idea!大肥鱼不是有谷价和峰价吗?之前苦于没有同等级性价比模型,峰价咬咬牙也就吃了。现在 M3.1 一出来,正好补上位。我直接一个路由,忙时 MiniMax,闲时大肥鱼,彻底把 Token 红利吃干抹净。泪目了,这就是咱激动人心的国产 Flash 组合技(bushi)。
这样一来,我觉得 API 其实也可以进入普通用户的选项里了。毕竟大模型这玩意儿迭代实在太快,就算只是买包月,也可能翻车。你像 Opus 5.5 一发,Astra 那一波订阅用户基本也翻车了。白买 Pro 10X,心疼我的钱包。
而且现在 C 端用户是真惨 o(╥﹏╥)o:5 小时限额、半夜 Reset 背刺,还要提防后台的降智偷袭……买 API,充个几十块钱,哪个拉胯了随时拜拜,简直不要太舒服。
泪目了家人们。不知道大家有没有相同感受,说实话,这一个月我是有点憋屈得慌。A 社、OpenAI、谷歌疯狂发旗舰模型,反观国产阵营这边,啥动静也没有。不少大佬也在说,LLM 这一战基本结束了,硅谷靠 Scaling 杀死了一切。
但如今,拐点似乎正在出现。短短两天,两款国产 Flash 模型接连登场。旗舰级的能力,正在以 Flash 的速度和价格加速普惠。确实,SOTA 这场仗不是那么好打的。但当「性价比」这个前提开始满足,另一场更重要的仗——大模型产业落地,或许才刚刚开始。
而这,一直是中国公司最擅长做的事。云栈社区也会继续陪你盯住这些真正改变落地逻辑的发布。
 发表于 1 小时前
|
查看: 5|
回复: 0


