当 Agent 要从海量文档里搜索信息时,往往需要先理清不同文件之间的关联,才能拼出完整答案。比如判断一个项目能否上线,Agent 得同时查阅需求文档、会议纪要、审批邮件和最新项目状态。这些资料分散在不同的数据源里,对同一个项目的称呼也未必一致。即便 Agent 能反复搜索整个文档库,也要花大量精力寻找线索、梳理文件关系。下次遇到类似问题,这些搜索和匹配工作可能又得从头再来。
来自 KAIST 和 Microsoft 的研究团队在论文《Follow the Entities: A Corpus Map for Agentic Search》中提出了 CorpusMap,核心思路是识别不同文档中反复出现的人物、项目等实体,将相关文件关联起来,为 Agent 建立一套可重复使用的文档导航结构。研究者在三个基准数据集上验证了方法效果:相比直接搜索原始文档,CorpusMap 将回答质量提高了约 6.4~11.7 分,同时减少了 34%~57% 的输入 Token 消耗。
Agent 搜索中的文档关联问题
传统 RAG 一般会根据用户的问题去检索相关文档,再把检索结果交给模型生成回答。这种方式强依赖检索结果,一旦系统遗漏了某些必要信息,模型就很难给出完整答案。
Agentic Search 在此基础上引入了多轮搜索能力:Agent 先找到关键文档,阅读其中的内容,再根据获得的线索调整搜索词,继续查找其他资料。虽然比传统 RAG 有所增强,但整个过程仍然需要 Agent 自行判断不同文档之间的关联。
举个例子,用户想了解某个项目延期的原因。Agent 从项目状态报告中了解到项目负责人是 J. Chen,但这篇报告并没有解释延期的具体原因。而另一份会议纪要记录了详情:J. Chen 负责的基础设施审查尚未完成,影响了项目进度。由于两份文档位于不同文件夹,会议纪要的标题也没提及项目名称,如果 Agent 没有沿着负责人这条线索继续搜索,就会遗漏这份关键记录。
即便 Agent 最终找齐了证据,也需要经过多轮搜索和文档阅读,产生额外的工具调用与上下文消耗。后续遇到类似问题,Agent 大概率还得重新经历一遍完整的检索流程。
论文认为,造成这一问题的一个重要原因是文档库缺少可供 Agent 使用的导航结构。虽然每份文件都可以独立检索,但文件之间的关联并没有被提前整理出来。事实上,有些关联可以在用户提问之前就被系统识别:不同文档会提到同一个人、项目、产品或事件,系统完全可以依据这些共同实体,把原本分散的文件提前关联起来。CorpusMap 正是基于这一思路,为 Agent 建立了一套以实体为中心的文档导航结构。
CorpusMap 的核心设计
CorpusMap 在原始文档基础上,增加了一层以实体为中心的导航结构。这里的实体(Entity)可以理解为文档中提到的具体对象,比如某个项目、产品、负责人或故障事件。同一个实体可能出现在多份文档中,且名称和描述在不同文件里也可能有差异。CorpusMap 会识别这些实体,将指向同一对象的记录关联起来,再为出现在多份文档中的实体创建专门页面,称为实体页面。
每个实体页面主要包含四类信息:
- 实体概览:简要介绍该实体。
- 关键事实:汇总不同文档中与该实体有关的信息,并标注来源。
- 名称与别名:记录该实体在不同文档中的名称和称呼。
- 关联文档:列出提及该实体的原始文件及其路径。
以项目延期问题为例,Project Atlas 的实体页面可以关联项目状态报告、客户合同和相关邮件;负责人 J. Chen 的实体页面则可以关联项目状态报告与会议纪要。当 Agent 需要查询 Atlas 项目延期的原因时,可以先通过项目的实体页面找到状态报告,了解负责人是 J. Chen,再通过 J. Chen 的实体页面找到相关会议纪要,一步步查明延期原因。
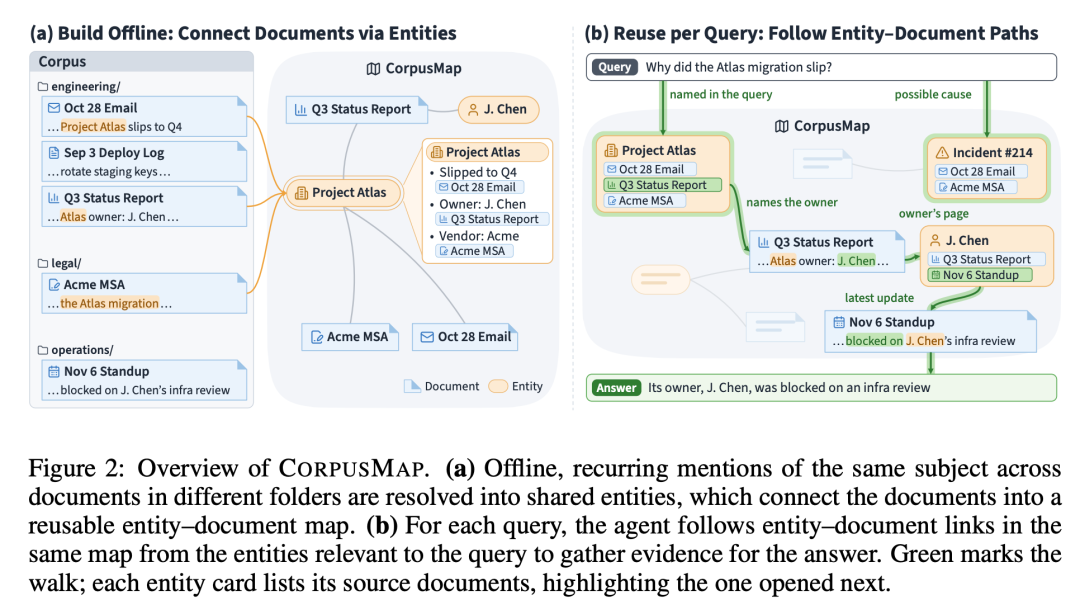
图 1:CorpusMap 的整体结构与跨文档导航
从结构上看,CorpusMap 将实体和文档组织成一个二部图(Bipartite Graph)。图中包含实体和文档两类节点,节点之间的连线表示某份文档提到了某个实体。一份文档可以关联多个实体,同一个实体也可以连接不同来源的文档。有了这些关联,Agent 既可以从某个实体出发找到提及它的相关文档,也可以从当前文档中发现其他实体,再通过对应的实体页面继续查找资料。
另外,CorpusMap 只为出现在至少两份文档中的实体创建实体页面。因为只在一份文档中出现的实体无法建立跨文档关联,没必要单独创建页面。不过,这些原始文档仍然保留在文件库中,Agent 可以通过常规搜索访问它们。
从原始文档构建实体地图
CorpusMap 的实体地图在用户发起查询之前就已完成构建,整个过程分为四个阶段:Cataloging(实体分类)、Extraction(实体提取)、Resolution(实体消歧)和 Rendering(页面生成)。四个阶段分工明确:先确定文档库中有哪些值得识别的实体类型,再从原始文件中提取具体实体,然后判断不同文件中的实体是否指向同一个对象,最后根据这些关联生成实体页面。
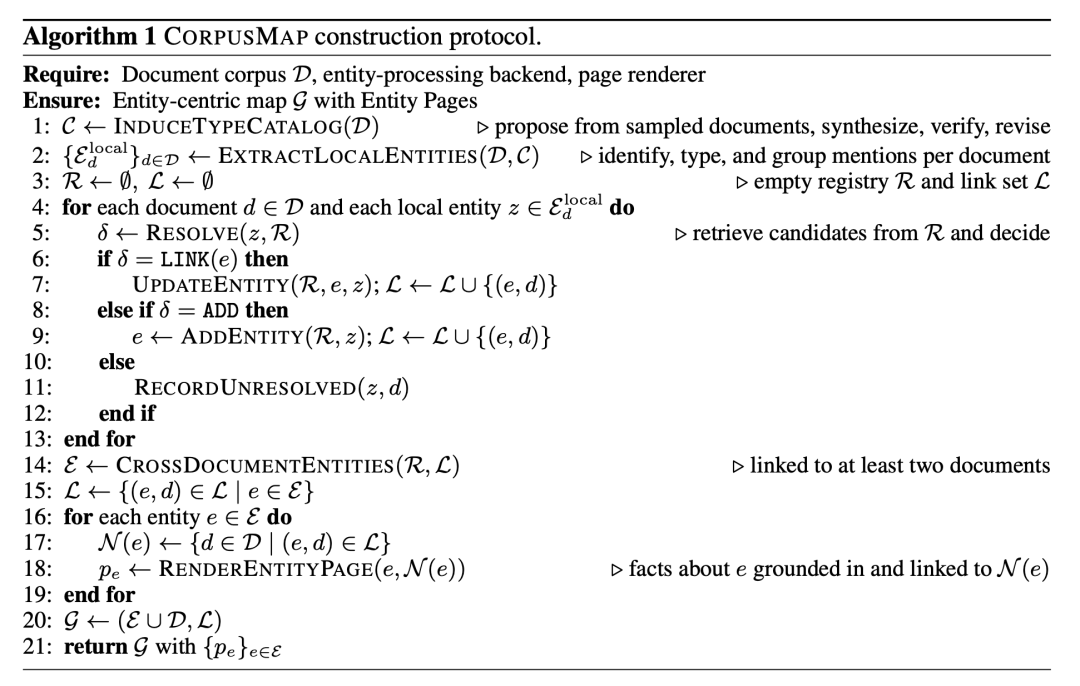
图 2:CorpusMap 的完整构建流程
Algorithm 1 CORPUSMAP construction protocol.

Require: Document corpus D, entity-processing backend, page renderer
Ensure: Entity-centric map G with Entity Pages

 1: C <- INDUCETYPECATALOG(D)          ▷ propose from sampled documents, synthesize, verify, revise
 2: {E_d^local}_{d∈D} <- EXTRACTLOCALENTITIES(D, C)   ▷ identify, type, and group mentions per document
 3: R <- ∅, L <- ∅                      ▷ empty registry R and link set L
 4: for each document d ∈ D and each local entity z ∈ E_d^local do
 5:     δ <- RESOLVE(z, R)              ▷ retrieve candidates from R and decide
 6:     if δ = LINK(e) then
 7:         UPDATEENTITY(R, e, z); L <- L ∪ {(e, d)}
 8:     else if δ = ADD then
 9:         e <- ADDENTITY(R, z); L <- L ∪ {(e, d)}
10:     else
11:         RECORDUNRESOLVED(z, d)
12:     end if
13: end for
14: E <- CROSSDOCUMENTENTITIES(R, L)    ▷ linked to at least two documents
15: L <- {(e, d) ∈ L | e ∈ E}
16: for each entity e ∈ E do
17:    N(e) <- {d ∈ D | (e, d) ∈ L}
18:    p_e <- RENDERENTITYPAGE(e, N(e))  ▷ facts about e grounded in and linked to N(e)
19: end for
20: G <- (E ∪ D, L)
21: return G with {p_e}_{e∈E}
1. Cataloging:确定实体类型
不同文档库需要关注的实体类型有所区别。企业项目资料中可能涉及项目、客户和负责人,软件开发文档中则可能包含功能模块、配置项和故障记录。因此,CorpusMap 需要先根据文档库的实际内容,确定后续要识别哪些类型的实体。
在这一阶段,系统会从文档库中抽取多组样本文档,让 LLM 分别分析其中出现的实体类型,再对各组结果进行合并、检查和修订,形成统一的实体类型目录。这个目录除了记录实体类型的名称和定义,还包含身份判定标准及实际样例。例如,对于“项目”这一类型,系统需要知道哪些信息可以用来区分不同项目,避免后续把名称相似的项目错误合并。完成后,实体类型目录会被固定下来,供后续阶段统一使用。
确定实体类型后,CorpusMap 开始逐份处理文档,识别其中符合条件的具体实体。这里需要区分实体类型和实体实例:“项目”是实体类型,而 Project Atlas 才是具体的实体实例。系统会根据实体类型目录和文档上下文,识别出原文中提到的具体实体。
同一个实体在一份文档中可能出现多次,且名称不一定相同。例如,某份项目报告先用 Project Atlas,后面又简称 Atlas。系统需要结合上下文判断这些名称是否指向同一个项目,再将相关提及合并为一个文档内部的实体记录。经过这一步,每份文档都会得到一组经过识别和归并的实体,但此时处理的仍只是单篇文档内部的关系,跨文档关联留待下一阶段完成。
3. Resolution:建立跨文档关联
实体消歧 是 CorpusMap 构建过程中的核心环节。系统需要判断不同文档中提到的实体是否属于同一个对象,并据此建立跨文档关联。
为此,CorpusMap 使用一个共享的实体注册表,记录此前识别出的实体及其相关证据。注册表最初为空,随着文档不断被处理,系统会逐步向其中添加实体及来源记录。对于每个新提取的实体,系统会先保留它在原始文档中的出处,再从注册表中查找可能匹配的候选项,并结合当前文档内容与已有实体的证据进行比较。
根据判断结果,系统会执行三种操作:
- LINK:确认当前实体与注册表中的某个实体相同,更新已有记录并建立该实体与当前文档的关联。
- ADD:确认是一个新实体,将其加入注册表,同时记录对应的文档来源。
- UNRESOLVED:暂时无法确认实体身份,保留这条未解决的记录,不建立实体关联。
例如,系统先在一份项目报告中识别出 Project Atlas 并建立注册记录。随后处理另一份文件时又发现 Atlas 这一名称,此时系统需要结合两份文件的内容判断它们是否指向同一个项目。如果确认一致,就将第二份文件关联到已有实体;如果证据表明两个项目只是同名但属于不同对象,则需分别保留;对于证据不足的情况,可以暂时不建立关联,避免错误合并。
随着文档不断加入,实体注册表会逐步积累跨文件的关联信息。同一个实体可以连接多个来源的文档,一份文档也可以同时关联多个实体。这一阶段直接影响后续导航的准确性:错误合并会导致 Agent 沿错误关联找到无关资料,该合并的没合并则会让本可连接的文档继续分散。
4. Rendering:生成实体页面
完成实体消歧后,CorpusMap 根据注册表中的关联记录生成实体页面。系统先筛选出至少关联两份文档的实体,因为只有这些实体才能提供跨文档导航路径。对于满足条件的实体,系统会收集所有关联文档,汇总其中的实体信息,包括实体概览、关键事实、名称变体和相关文件路径。其中,关键事实会标注对应的原始文档,方便 Agent 后续核实信息来源。
经过上述四个阶段,CorpusMap 完成了从原始文件到实体地图的构建。原本分散在不同文件夹、不同数据源中的文档,通过共同提及的实体建立起联系,Agent 在后续查询时能够反复利用这些关联。此外,论文中的实体提取、消歧和页面生成并不要求全部由 LLM 完成,研究人员也测试了使用现成实体处理工具和确定性组件替代部分步骤的方案。
Agent 如何使用 CorpusMap
实体地图构建完成后,Agent 就可以利用这些关联去查找信息。在论文的实现中,实体页面以普通文件的形式保存,与原始文档放在一起,Agent 可以继续使用已有的文件搜索和读取工具,无需额外接入专门的图数据库查询接口。
不过,仅仅让 Agent 能够访问实体地图还不够。如果每次回答问题都需要从大量实体页面中自行寻找起点,搜索成本依然不低。为此,CorpusMap 在查询阶段增加了一套候选文件检索机制,帮助 Agent 先找到与当前问题相关的文档,再利用实体地图继续调查。
1. 候选文件检索
当用户提出问题后,系统会先通过两轮 BM25 检索,为 Agent 筛选一组候选文件。
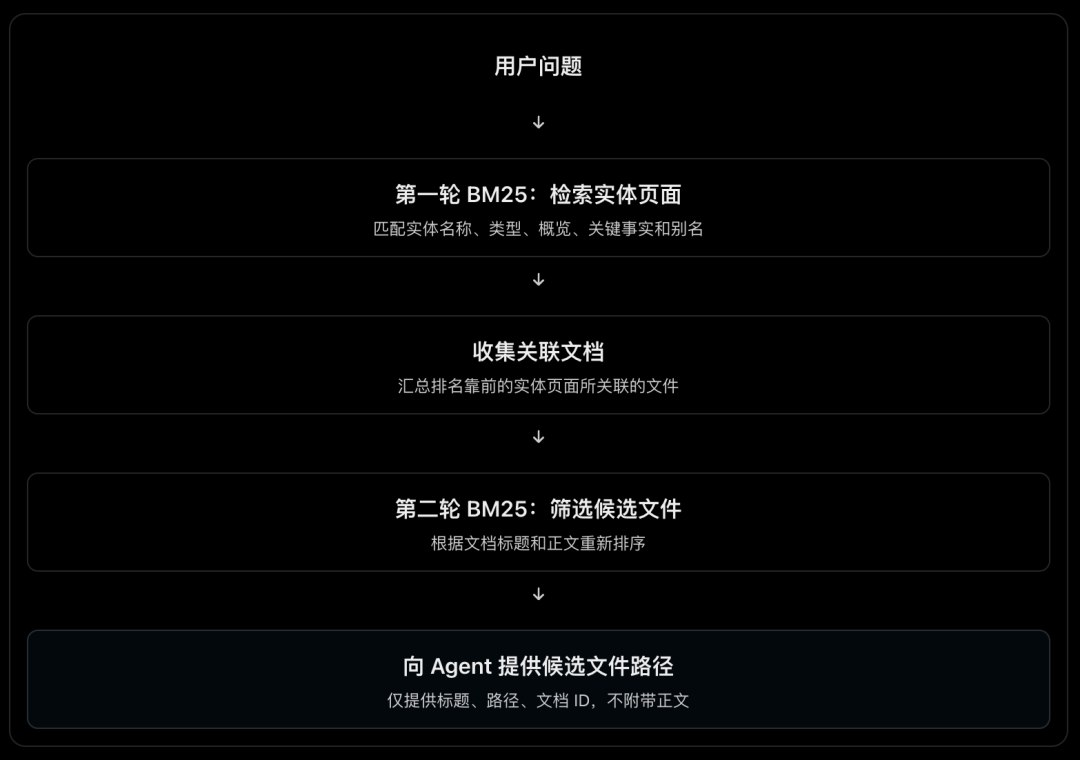
图 3:两轮 BM25 检索流程图
第一轮检索面向实体页面。系统根据用户的问题,对实体名称、类型、概览、关键事实和别名等内容进行匹配,找出相关性较高的实体页面。接下来,系统收集这些实体页面关联的原始文档,形成一个候选文档集合。例如,用户询问 Atlas 项目延期的原因,系统就可以先找到 Atlas 的实体页面,再收集该页面关联的项目报告、邮件和其他资料。
第二轮检索则面向候选文档。系统通过 BM25 对这些文档的标题和正文重新排序,筛选出与当前问题更相关的文件。完成两轮检索后,系统向 Agent 提供一份候选文件列表,其中只包含文件标题(如果有)、文件路径和文档 ID,不会把候选文件的正文全部放入上下文。这样 Agent 可以根据候选列表选择需要阅读的文件,再通过工具获取具体内容。由于候选文档来自相关实体页面,Agent 在搜索开始时就能获得一些跨文档关联线索,减少在整个文件库中反复尝试搜索词的次数。
2. Agent 的导航过程
获得候选文件后,Agent 可以自行决定阅读顺序,并根据文档中的新线索继续搜索。实体页面与原始文档之间的关联,为这个过程提供了更多可以探索的路径。
回到 Atlas 项目延期的例子:Agent 先通过候选列表找到项目状态报告,了解到项目负责人是 J. Chen,但报告没有解释延期的具体原因。按照传统搜索方式,Agent 需要继续尝试其他关键词来寻找更多线索。而在 CorpusMap 中,它可以根据当前文档的路径或负责人名称,搜索相关实体页面,进一步找到 J. Chen 的实体页面。由于 J. Chen 的实体页面关联了项目状态报告和另一份会议纪要,Agent 就可以沿着这条关系找到会议记录,了解到基础设施审查尚未完成,进而确认项目延期的原因。
整个过程中,Agent 可以从实体页面找到相关文档,也可以根据当前文档反向查找引用它的实体页面。如果发现新的相关实体,还能沿着其他关联继续搜索,直到收集到足够的证据。值得注意的是,CorpusMap 并没有限制 Agent 的搜索范围:除了访问实体页面和关联文档,Agent 仍然可以搜索整个原始文档库,寻找尚未被实体地图覆盖的信息。实体地图提供的是额外的导航路径,同时保留了 Agent 自主搜索和查阅原始资料的能力。
3. 候选文件对检索效率的影响
论文专门通过消融实验,分析了候选文件检索机制对 CorpusMap 的影响。研究人员在 EnterpriseRAG-Bench 数据集上,使用 GPT-5.5 比较了直接搜索原始文档、只提供实体地图,以及向 Agent 提供不同类型候选文件的效果。
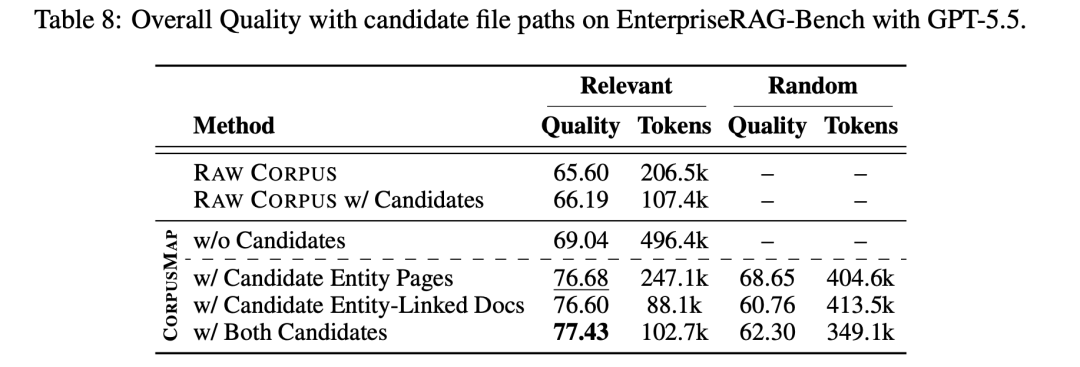
图 4:不同候选文件提供方式对 CorpusMap 回答质量与 Token 消耗的影响
从结果来看,只提供实体地图、不提供候选文件时,Agent 的回答质量从 65.60 提升到了 69.04,但输入 Token 消耗也从 206.5k 增加到了 496.4k。这是因为 Agent 虽然能够使用实体地图,但仍需花费大量搜索和阅读成本去找到与问题相关的实体页面和文档。
加入候选文件后,结果发生了明显变化。尤其是在提供相关实体页面所关联的候选文档时,回答质量提高到了 76.60,输入 Token 则下降至 88.1k,甚至低于直接搜索原始文档的消耗。 研究人员还测试了随机选择候选文件的情况,结果显示随机候选不仅降低了回答质量,也显著增加了 Token 消耗。这说明候选文件的相关性会直接影响检索效果,单纯向 Agent 提供更多文件路径并不能带来相同收益。
此外,论文还测试了候选文件数量的影响。结果表明,当候选列表从单个实体页面或文档增加到多个时,回答质量会明显改善,随后在较大范围内保持相对稳定。候选数量过少,Agent 需要自行进行更多搜索;数量过多,又会增加上下文中的列表长度。
这些实验说明,CorpusMap 的检索效率不仅取决于实体地图本身,还与查询阶段如何筛选候选文件有关。实体地图保存了跨文档关联关系,候选检索帮助 Agent 找到与当前问题相关的入口,两者结合,才能在提高回答质量的同时减少搜索消耗。
4. 为什么没有建立实体之间的直接关联
CorpusMap 采用的是实体与文档组成的二部图,实体之间需要通过共同关联的文档建立联系。那么,是否可以进一步增加实体之间的连线,让 Agent 更快地找到相关信息呢?
论文对这一问题也设计了实验。研究人员尝试使用 LLM 提取实体关系,或者将出现在同一份文档中的实体直接连接起来,再把这些关系加入实体页面。例如,原本需要经过“Project Atlas → 项目状态报告 → J. Chen”才能完成的导航,现在可以通过一条实体关联(Project Atlas → J. Chen)缩短路径。
不过,实验发现增加这些直接连线并没有明显提高文档召回率。相比原本的二部图,召回率变化范围仅为 -2.6 至 +0.2 个百分点,实体页面的平均长度却增加了 27%~52%,输入 Token 消耗最多增加了 28%。原因在于这些新增关联大多连接了原本就能通过共同文档找到的实体,只是缩短了已有路径,并没有增加新的可访问文档。同时,实体页面中增加的关系信息也会占用更多上下文,而且新增连接中有不少与当前查询无关。
这也解释了 CorpusMap 为什么选择相对简单的二部图结构:对于论文研究的跨文档搜索任务,实体与文档之间的关联已经能够提供足够的导航路径,增加更多关系未必能进一步提高检索效率。
除了查询效果,研究人员还验证了实体地图的复用与维护成本。实验表明,使用成本较低的模型构建实体地图,也能改善其他模型的回答质量。不过,建图需要额外投入,论文估算在不同模型设置下,约需 9,000~26,300 次查询才能摊平构建成本。
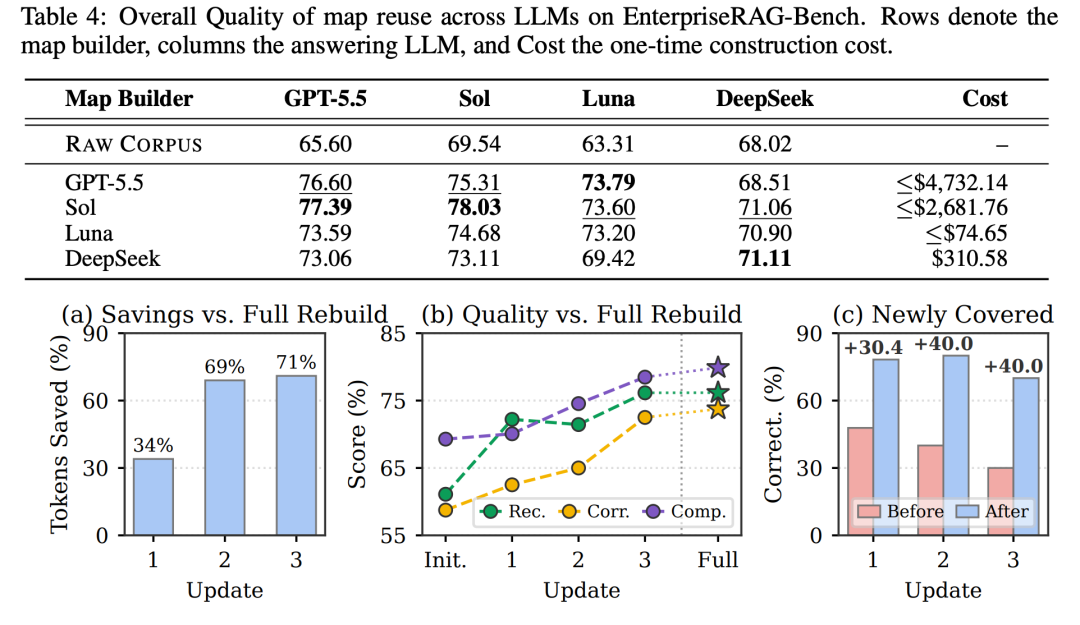
图 5:CorpusMap 的跨模型复用、构建成本与增量更新实验结果
对于持续更新的文档库,CorpusMap 可以沿用已有的实体注册表,只处理新增文档并更新受影响的实体页面。在三次增量更新实验中,相比全量重建,分别节省了约 34%、69% 和 71% 的构建 Token,最终回答质量也与全量重建的结果接近。
局限性与总结
CorpusMap 虽然改善了跨文档搜索的效果,但实际应用仍然依赖实体识别与消歧的准确性。如果不同对象被错误合并,Agent 就可能沿着错误的关联寻找证据;如果同一个实体没有被成功识别,相关文档也可能继续保持分散。
此外,实体页面会汇总多个来源的信息,实际部署时还需要考虑文档权限和敏感信息的访问控制。对于更新频繁的资料,系统也需要处理不同时间记录之间的变化与冲突,避免 Agent 使用过期信息。从成本上看,CorpusMap 需要提前构建和维护实体地图,因此文档库的规模、更新频率与查询量都会影响最终收益。
这篇论文的主要思路是,将原本需要 Agent 在搜索过程中自行发现的部分文档关联,提前整理成可复用的实体地图。Agent 可以通过实体页面找到相关资料,再沿着实体与文档之间的关系继续寻找证据。对于需要频繁进行跨文档查询的知识系统,这种设计提供了一种减少重复搜索、改善证据发现能力的实现思路。
参考资料
- Follow the Entities: A Corpus Map for Agentic Search — arxiv.org/abs/2609.37226
 发表于 2 小时前
|
查看: 8|
回复: 0


