截至 2026 年 10 月 19 日,能写进接口的只有 MiniMax 已经公开的 M3.1 Flash。网页源码里出现的 6.5、还没发布的 Carbon,这些都不能填进 model 字段。
名字以控制台为准
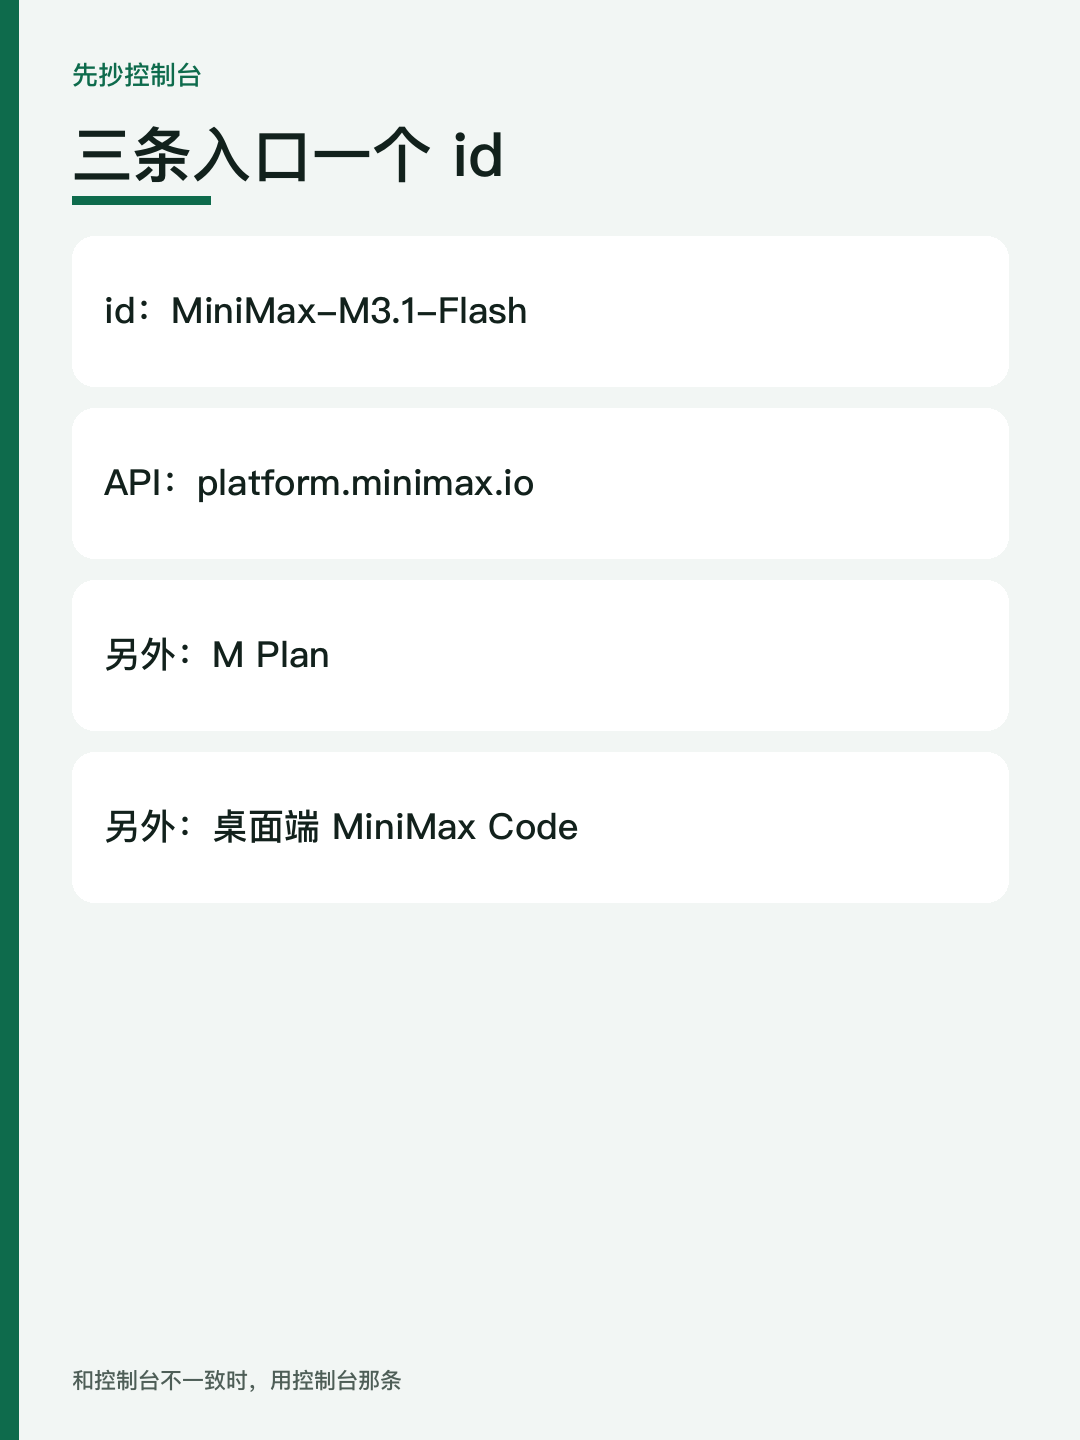
官方博客的表格里,模型名写作 MiniMax-M3.1-Flash。每 100 万 token:输入 0.15 美元,输出 0.60 美元,缓存输入 0.015 美元。
入口一共写了三条。API 在 platform.minimax.io,另外还有 M Plan 和桌面端 MiniMax Code。第三方目录里也会出现别的拼法。最终以你登录后控制台给出的 id 为准。
思考功能能不能关掉,我没有复现,所以步骤里先不写。控制台里的 id 如果和 MiniMax-M3.1-Flash 不一致,直接用控制台那一条,别手动改大小写碰运气。
同一题跑两次
准备一个小改动,你已经知道它的标准答案。旧模型跑一遍,Flash 再跑一遍。两次使用同一份说明、同一套测试。
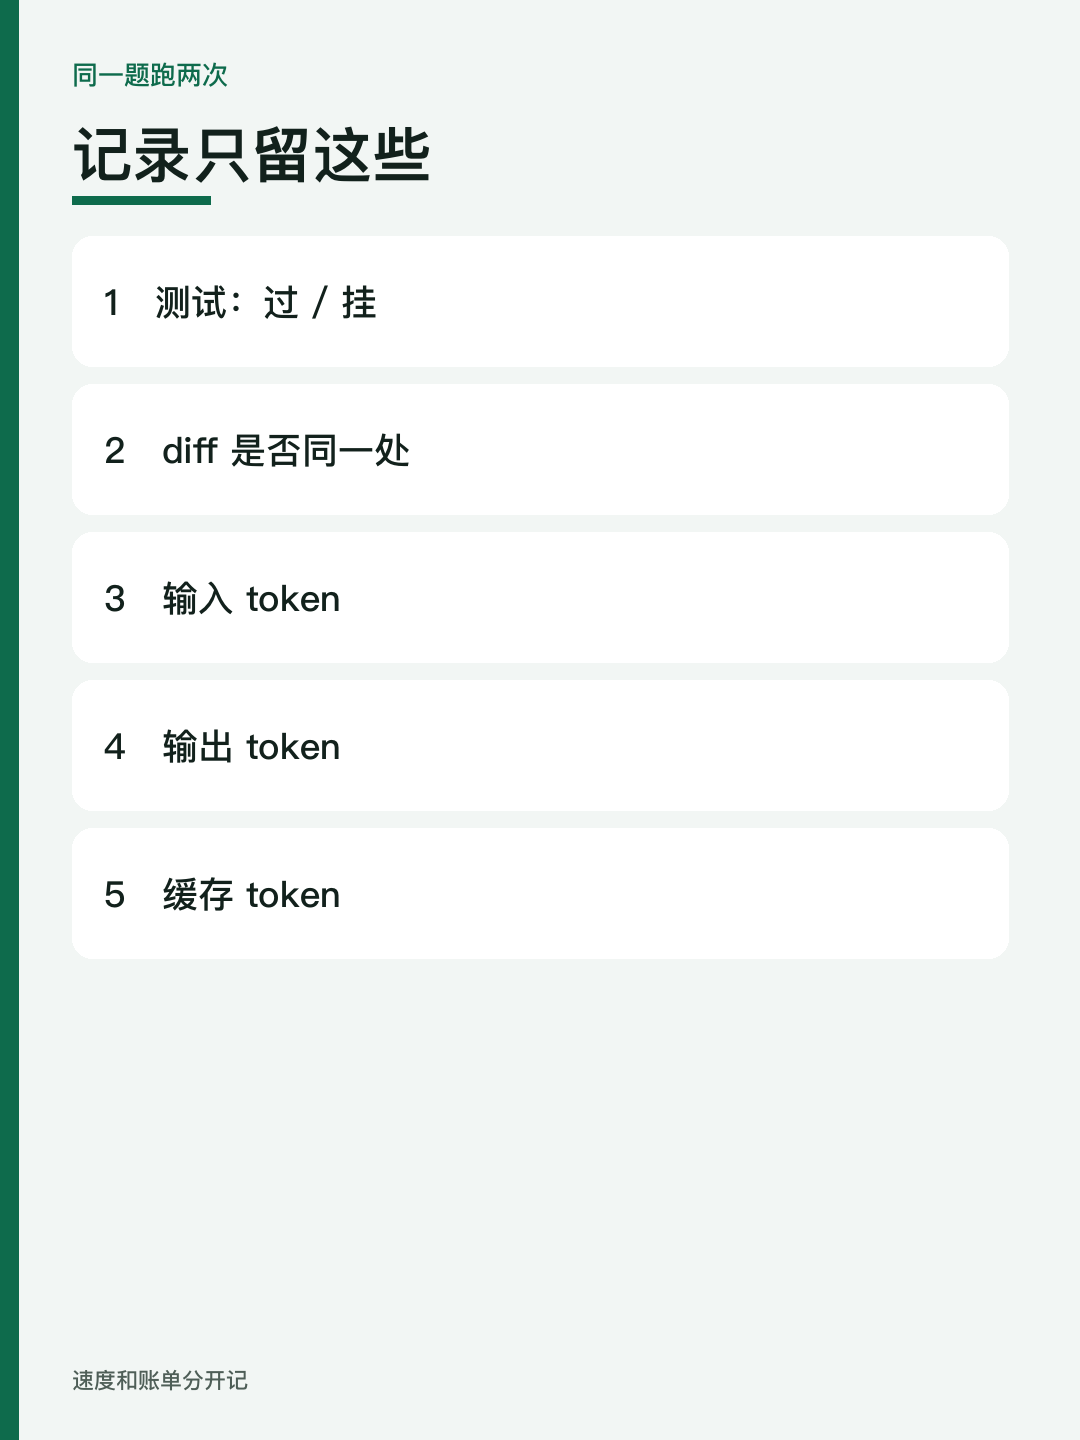
重点看三样:测试是过还是挂;diff 是否改在同一处;账单里的输入、输出、缓存各是多少。
官方称日常速度能到每秒 200 token 以上,中位数 170 以上。那是官方口径的测速。你自己要记下实际开始和结束时间。速度和账单要分开记,200 token/s 并不等于你要付的钱。
我会留一张对照条,跑完填这几格:
任务:
旧模型 id:
Flash id:
测试:过 / 挂
输入 token:
输出 token:
缓存 token:
官方说智能体任务相比上一代便宜 70%。可你这张对照条上如果没有上一代同一题的记录,这句话根本解释不了本单。
三格填完后,再按价目复算一遍。输入 token 先除以 100 万,再乘 0.15;输出同理除完乘 0.60;缓存输入乘 0.015。三个数相加,应该和供应商账单对得上,误差只允许在四舍五入范围内。对不上,先检查 id 是不是抄错了。
对照条放进仓库,文件名带上日期,别只留在聊天窗口里。下次遇到同类任务,先翻出这张条,再决定要不要继续用 Flash。
榜单互相打架的地方
Automation-Bench 上,官方帖大约 62%,转发帖是 62.2%。旁边还列着 Opus 5 的 50.3,以及 GPT-5.6 Sol 的 45.8。这组数字并不是我从那两家价目页抄来的。
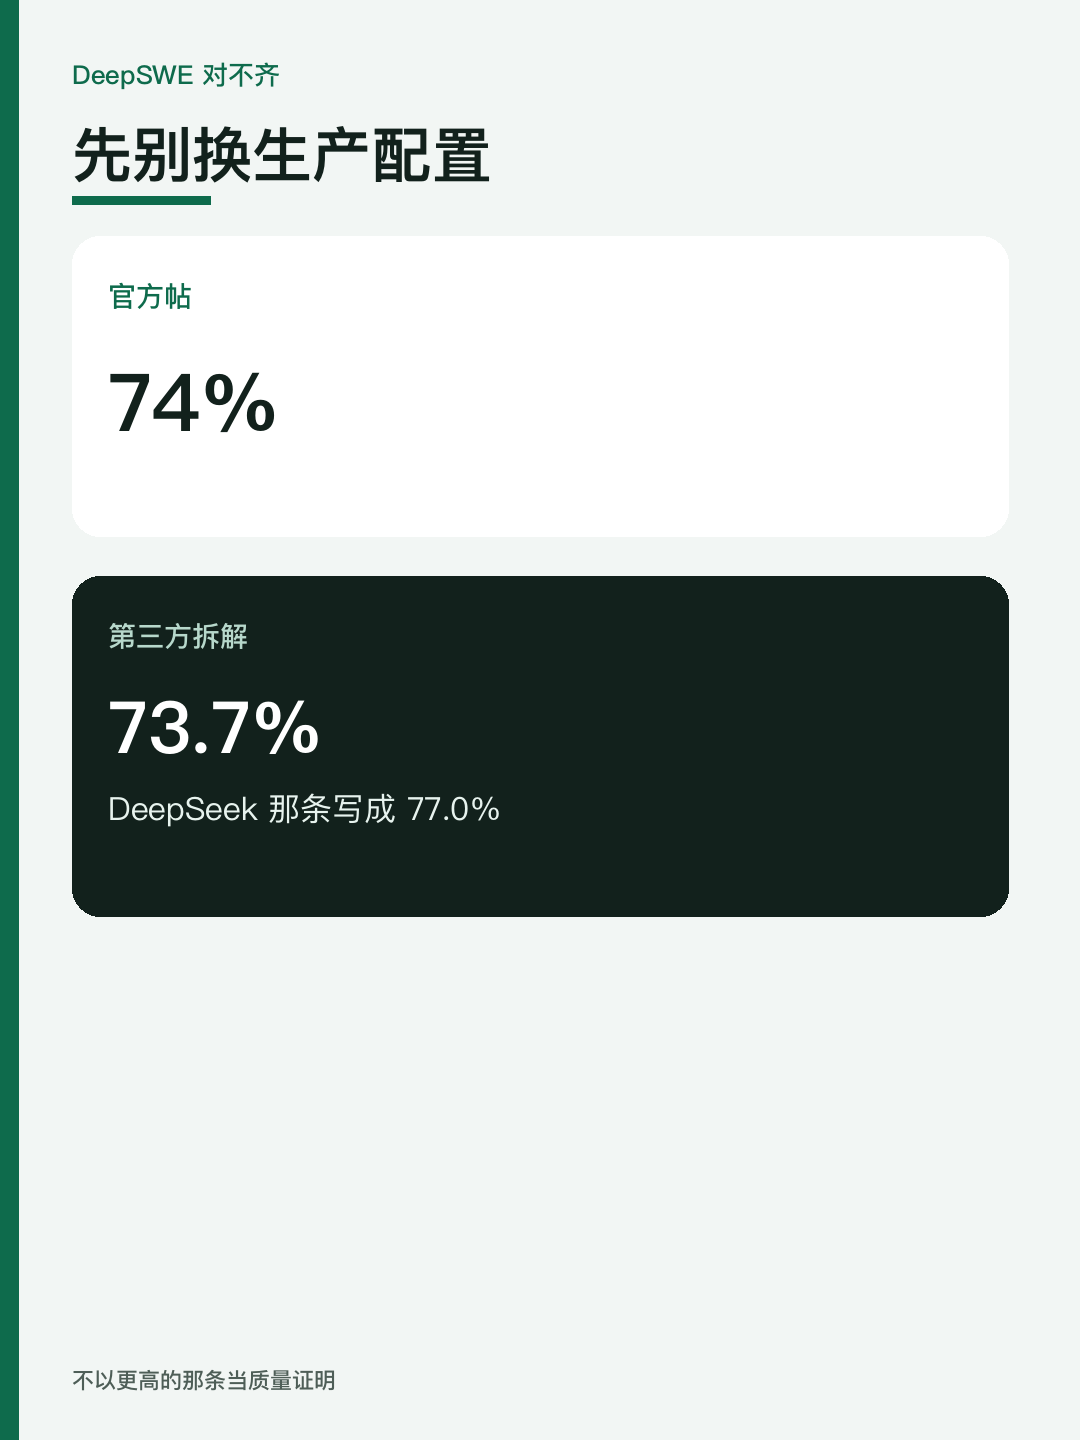
DeepSWE 这边,官方帖是 74%,第三方写成 73.7%,还提到 DeepSeek V4.1 Flash-1017 是 77.0%。编码任务我会两条一起看,不会拿更高的那条当质量证明。
还有人提到,Terminal-Bench 上它比 Opus 5 低 13.7 分,这也是第三方拆解的结果。终端里的活,我不会只凭 Automation-Bench 一个分数就换模型。
权重还没到手里
Space Bunny 是官方承认的早期版本,匿名期间处理过超过 200 万亿 token。博客说权重稍后发布,官方账号写的时间是 10 月 23 日。今天是 10 月 21 日,所以现阶段调用走 API,不走一份还没下载的权重。
倒计时不写进配置
opensi.lol 源码里藏着的 6.5,指向 2026 年 11 月 1 日上午 10 点,时区是旧金山。这个域名 9 月 22 日才注册,第二天的存档称它是待售的独立恶搞站。Tibo Sottiaux 倒是说过自己买了新域名,但 OpenAI 那边没有配套的发布说明。
The Information 在 10 月 19 日报道了三件仍在准备中的事:Anthropic 的新模型、Gemini 4 Carbon、OpenAI 的 Terra。报道没有确认型号是 Fable 5.5。总之,配置里只留已经能调用的 id。
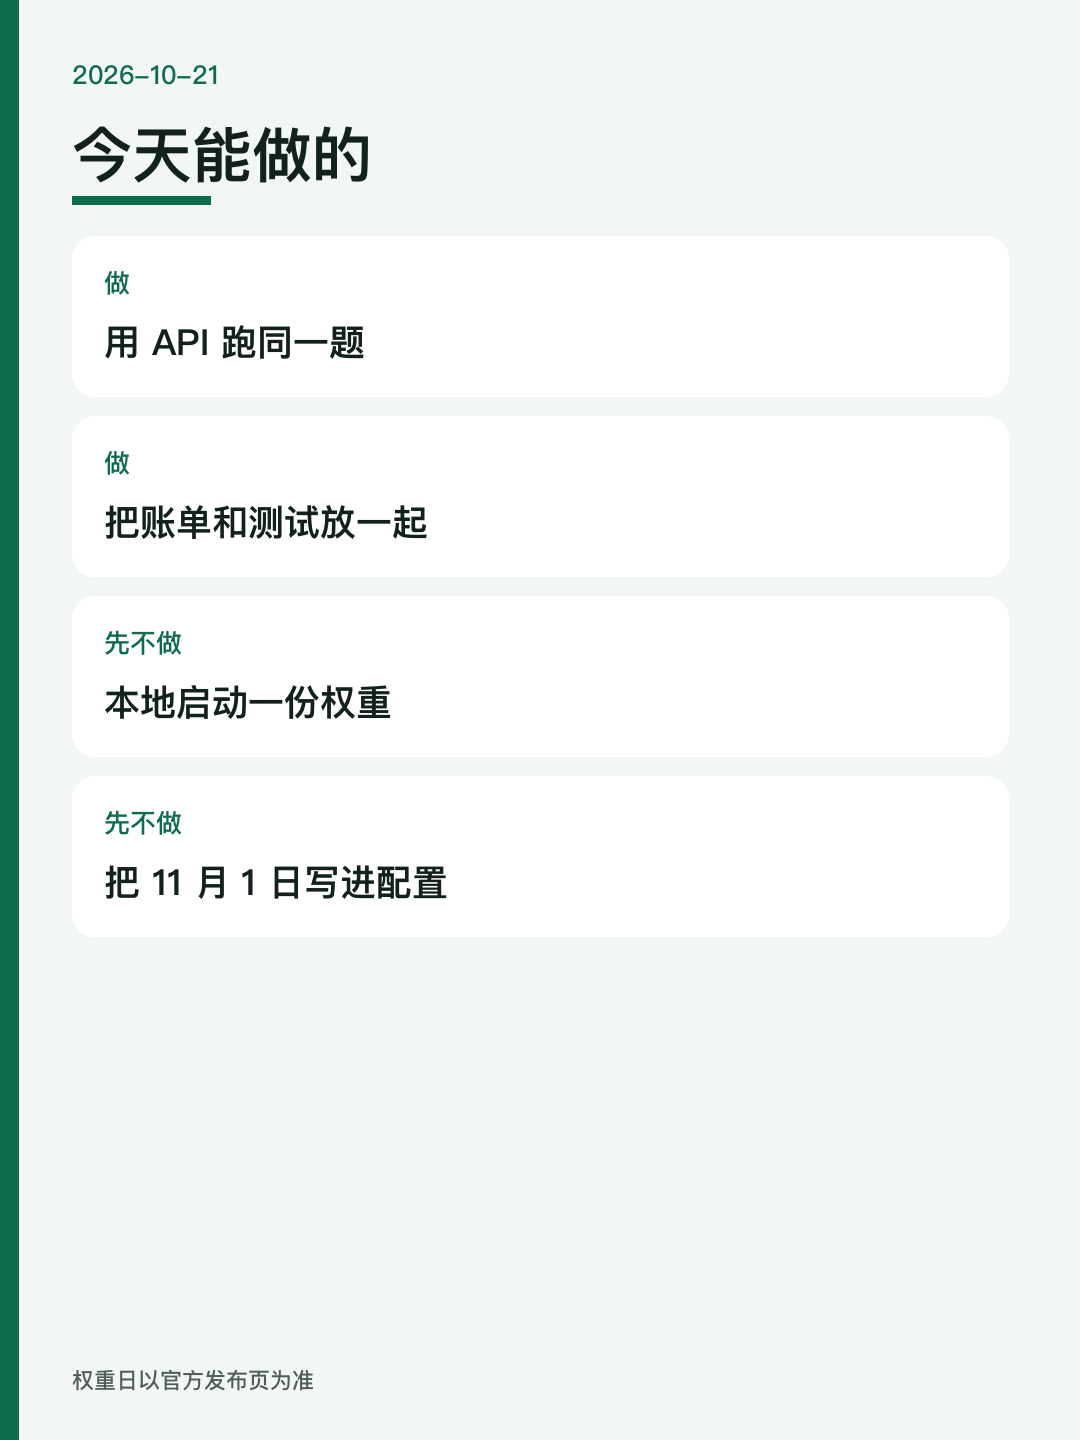
过关标准只有一条:在同一题上,Flash 的测试结果和账单你都能指出来,而且放在同一条记录里。指不出来,就先别换。这类判断模型切换的标准,在云栈社区也经常被拿出来讨论。
 发表于 3 天前
|
查看: 16|
回复: 0


