Agent架构也存在两种典型的失衡:单个 Agent 背负过多领域知识,容易把规则用串;子 Agent 拆得太碎,交接损耗又会直线上升。Meta 踩中的是前一种,Anthropic 观察到的麻烦则来自后一种。
Meta 曾让一个 Agent 全权负责推荐系统的数据列接入。演示时一切正常,进了生产环境,它开始把不同数据源的规则混在一起用。10 月 19 日,Meta 公布了改进后的架构:一个瘦编排器(thin orchestrator)负责流程控制和可靠性检查,14 个专业 Agent 各自处理具体领域任务。
Anthropic 遇到的却是另一番景象。它发文指出,有些企业子 Agent 建得过多,一件事转了好几手,用户刚说过的条件就传丢了。一个客户把多 Agent 流程合并回主循环,运行时间直接缩短了约一半。
一家忙着拆,一家忙着合。如果你正准备在架构图上再添一个 Agent,不妨先看看这两家公司各自在修什么错。
Meta 要自动化的活儿不小。新增一个数据列,可能要同时改 3 个代码仓库、跨 3 种编程语言,最多走完 6 个管道阶段。不同数据源还有各自的字段命名、代码生成和验证规则。
团队起初把这些知识一股脑交给同一个 Agent。Meta 在原文里写得很直白:
“It worked in demos. In production, it started hallucinating.”
演示时有效,进了生产环境却开始出错。它会拿一个子系统的命名规则去套另一个子系统,也会用错数据源的代码生成方式。工程师逐个任务帮忙写提示词,成功率能到 70% 至 80%;一旦撤掉这层人工照看,就只剩 10% 至 20%。继续往同一个上下文里塞规则,显然已经走不通了。
于是 Meta 把“派活”和“干活”拆开。约 1300 行的编排器按照固定流程查重、补齐字段、检查告警和审核要求,再把任务分发给对应的专业 Agent。真正理解 Schema、数据填充或验证规则的,是下面 14 个上下文彼此隔离的专家。编排器自己不生成配置,也不改代码。
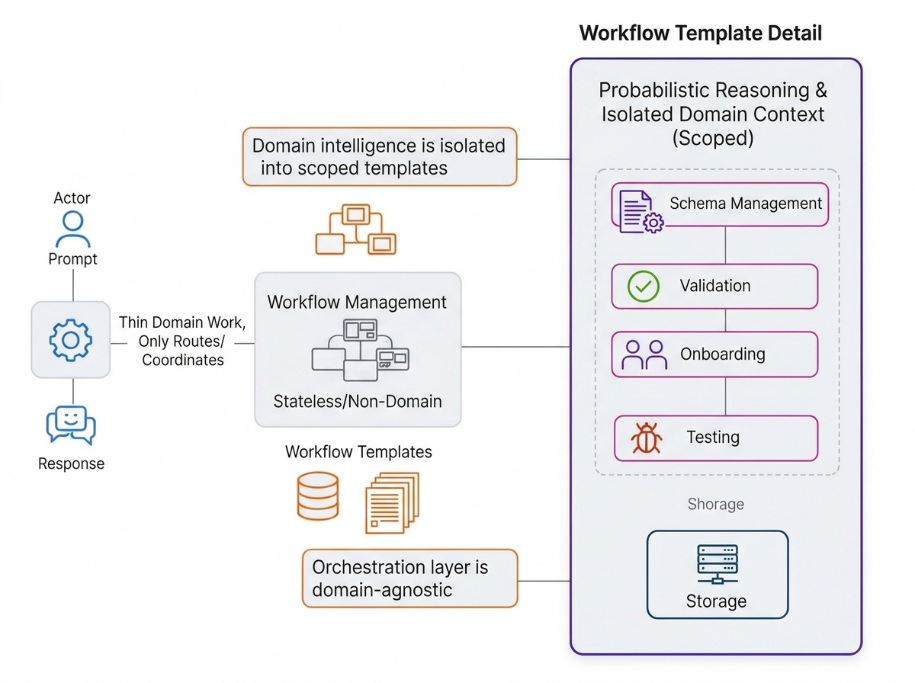
Meta 原文架构图。左侧为接收请求、路由和协调的“瘦编排器”,右侧为按领域隔离的工作流;Schema 管理、验证、接入和测试由专业 Agent 承担
Meta 也没有为每一条新流程都造一个新 Agent。接入数据列、迁移管道等 20 多种工作流,只是按不同顺序调用同一批专家。这样一来,改动一份领域知识文件,不用把编排器也连着重写。
Meta 的成绩单里有两个数字值得注意。新方案在无需逐任务手写提示词的条件下,成功率约 70%;原图另列出了约 95.5% 的上线评测分。它们不是同一个指标,95.5% 不能理解成“几乎所有任务都成功了”。此外,Meta 还称约三分之二的系统改动落地时不需要大量人工修改,线上回滚率约 0.2%。
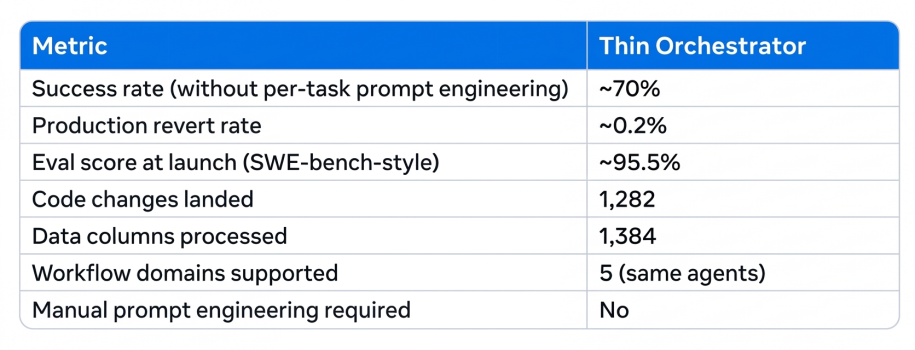
Meta 原文结果图。自上而下分别是无逐任务提示词时的成功率约 70%、线上回滚率约 0.2%、上线时评测分约 95.5%、已落地代码修改 1282 次、处理数据列 1384 个、支持 5 类工作流领域;最后一项是无需人工逐任务编写提示词
Anthropic 踩到的是另一种坑:活交出去了,话没传全
Anthropic 看到的客户项目,很多面向同一个用户。前一轮对话问订单,后一轮问退货,再往下可能要推荐替代商品。几个问题连在一起,Agent 得记得用户刚才说过什么。
一些企业按团队或问题类型拆分 Agent:订单归订单组,推荐归推荐组,客服归客服组,再由总 Agent 转发。组织上很整齐,但用户的一次请求却要在多个上下文之间搬来搬去。Anthropic 把这种现象叫做 “telephone game”——传话游戏。后一个 Agent 拿到的是前一个留下的摘要,细节和判断理由往往已经丢了。
文章提到,一家公司的面客 Agent 下面挂着十多个专家子 Agent,统一的品牌口吻难以保持,延迟也拖累了体验。另一个客户做了对比,单 Agent 循环的运行速度约为原多 Agent 流程的两倍。
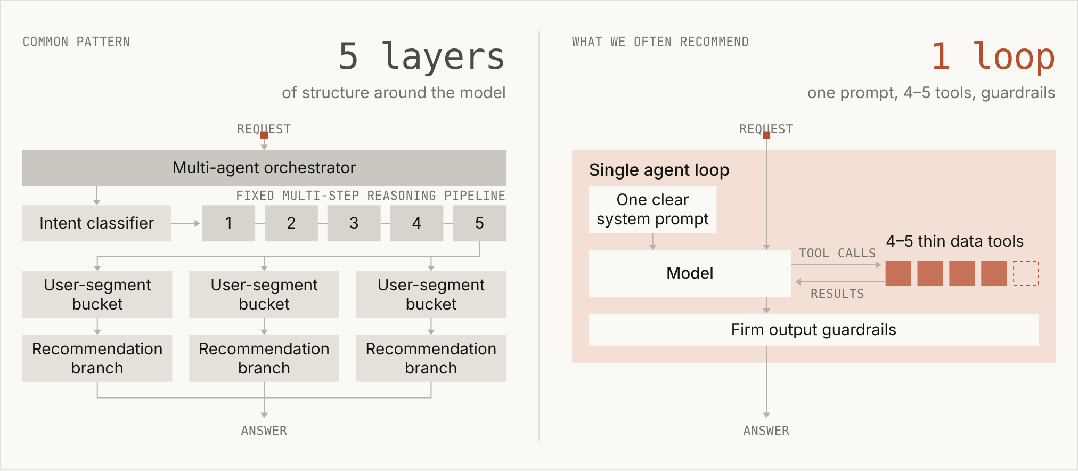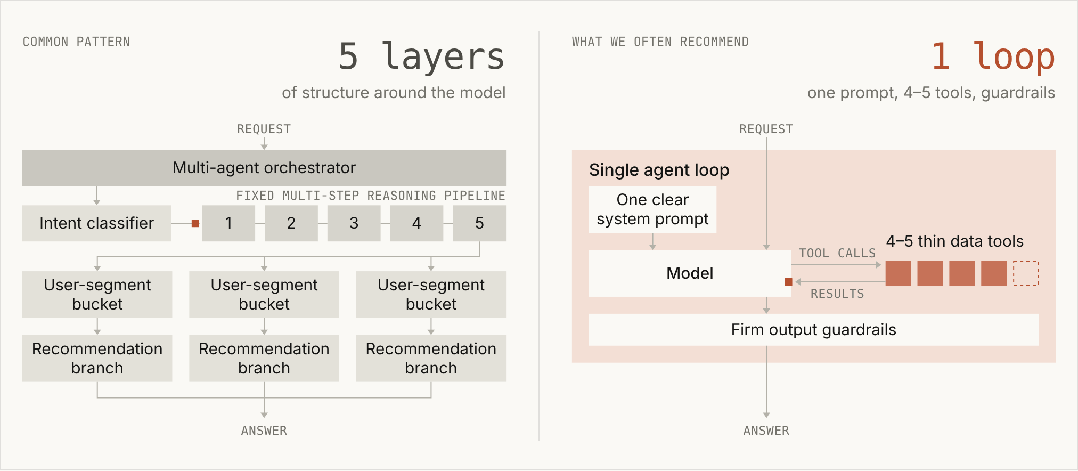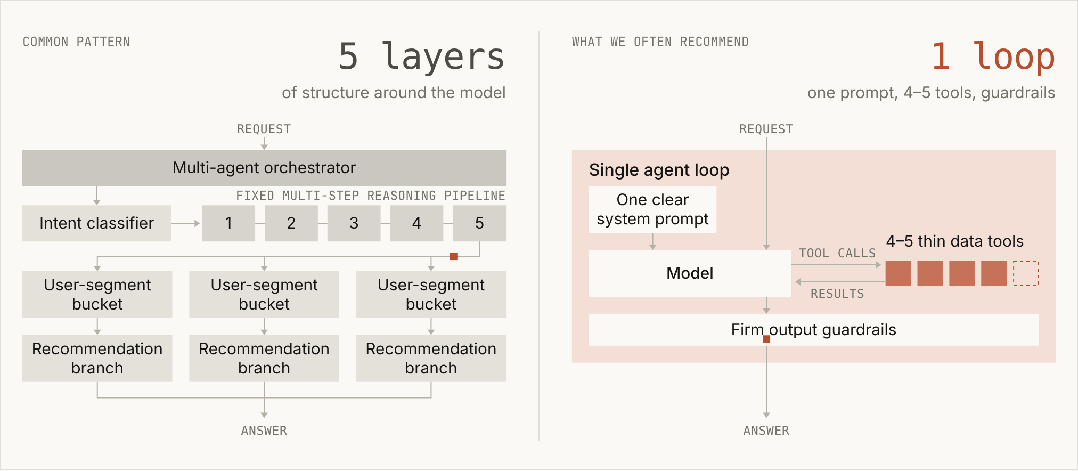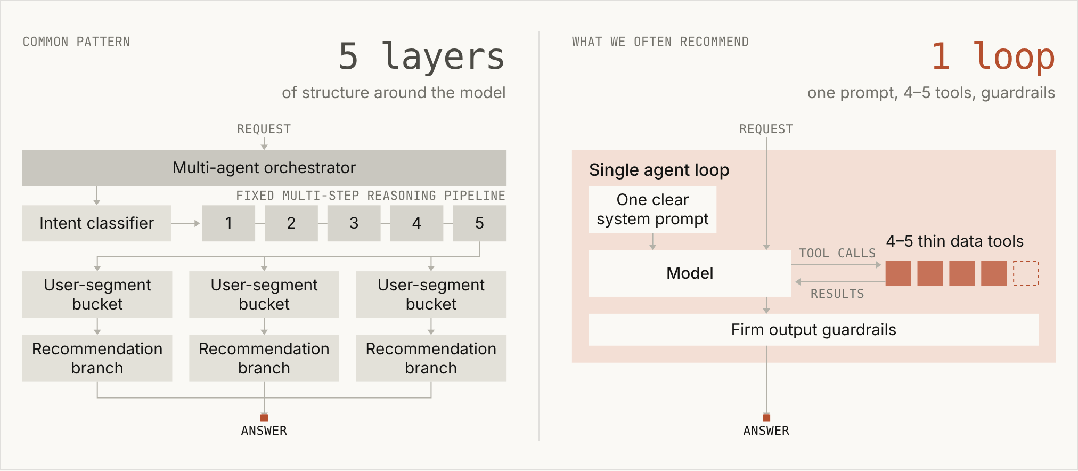
Anthropic 原文动图。左侧是意图分类、固定推理步骤、用户分组与推荐分支叠成的多层流程;右侧收成一个主 Agent 循环,配 4 至 5 个薄数据工具和输出约束。它展示的是 Anthropic 在部分客户场景中的简化方向
想想一次常见的改动:一个 Agent 写功能,另一个写测试,第三个审查代码。三段活分得很整齐。可写测试的 Agent 如果只收到一份简短交接,它并不知道实现时为什么舍弃了某个方案,测试就容易只覆盖表面。
Anthropic 建议把关系紧密的功能实现和测试编写留在同一个主循环,让模型沿用需求与改动过程;测试运行和结果核对,可以交给独立验证者。验证者只需拿到代码、命令和判定标准,不必继承整段思考过程。
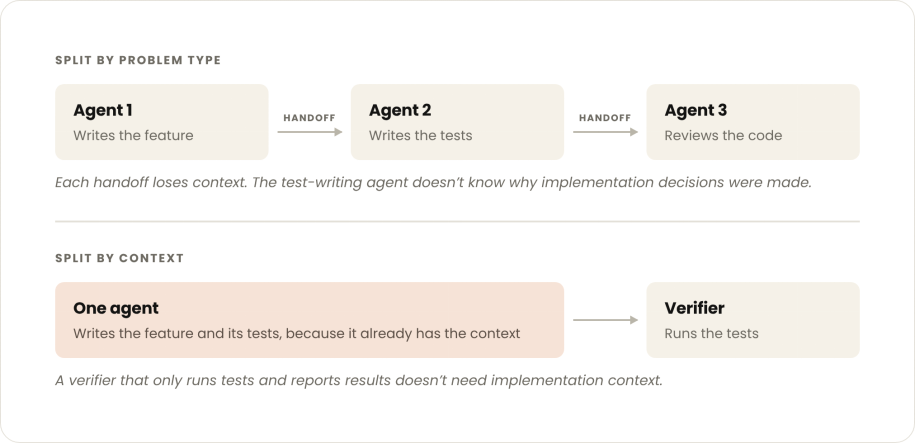
Anthropic 原图。上半部分按“写功能、写测试、审查”拆成 3 个 Agent,每次交接都可能丢失实现背景;下半部分让同一个 Agent 写功能和测试,另设独立验证者运行测试、报告结果
合回去以后,专业知识放哪儿?
Meta 刚吃过单 Agent 的亏。Anthropic 把人合回去,难道不会再把所有规则塞进同一份提示词?
Anthropic 给出的办法是按需加载。主 Agent 保留与用户的连续对话;某个流程要用的操作步骤和规则写进 Skill,用到时才加载;查询订单、读取实时数据或执行动作则交给工具。知识没有一次性塞进系统提示词,用户上下文也不必在不同 Agent 之间重讲。
它列了三种处理现有子 Agent 的方式:共享上下文很多的直接合并;确实需要独立运行的,让主 Agent 像调用工具一样调用它;只承担步骤和 API 调用的,改造成 Skills 与工具。
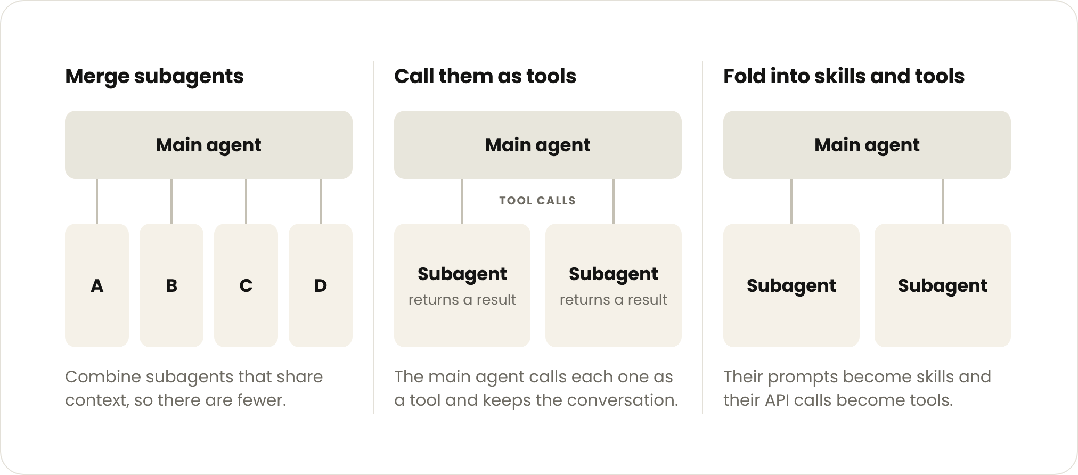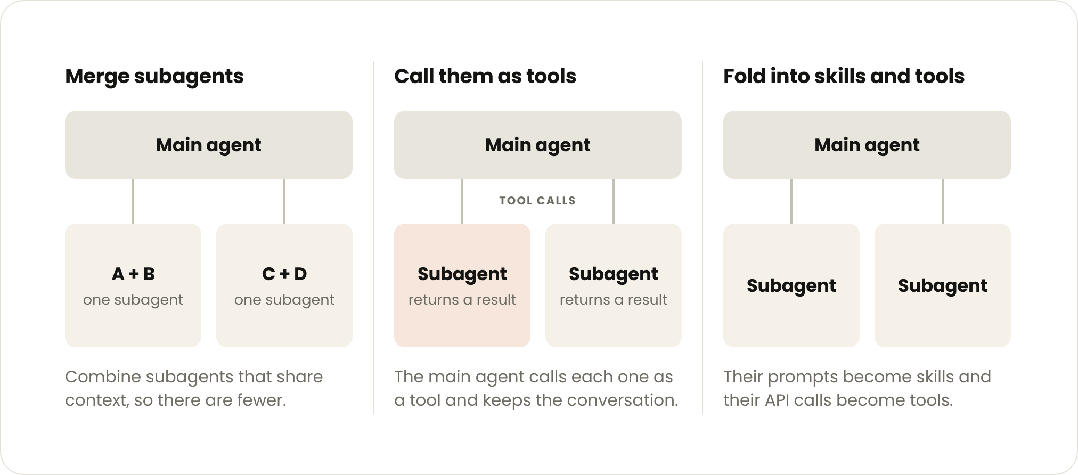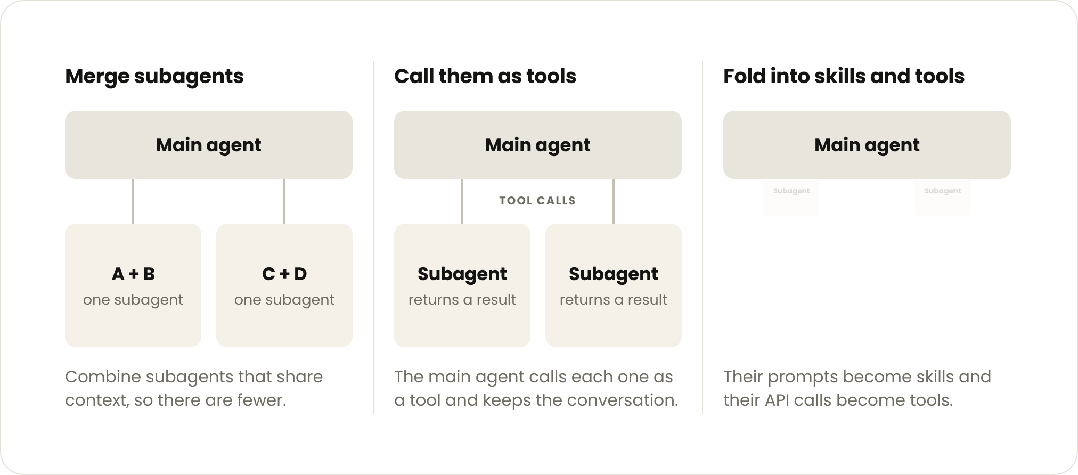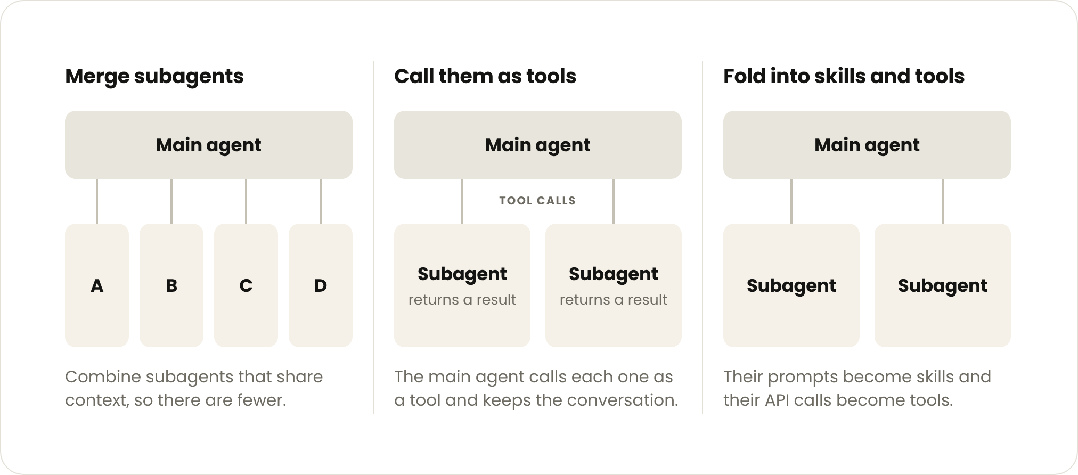
Anthropic 原文,从左到右分别是合并共享上下文的子 Agent、把子 Agent 作为工具调用、将原有提示词与 API 调用改为 Skills 和工具。它没有主张删除所有子 Agent
独立验证、并行处理互不相干的任务、隔离权限,仍然是保留子 Agent 的理由。Anthropic 自己也明确写了这些例外。Meta 那种规则容易串线、领域知识需要隔离的场景,更不适合一句“合回去”解决。
还要不要加新的 Agent?先翻失败记录
先把 Agent 数量放一边。Meta 的故障是 A 数据源的规则跑进 B 数据源;Anthropic 看到的是用户说过的话在交接中被忘记,响应也越来越慢。这些问题,翻生产日志就能找到痕迹。
对准备改架构的团队,可以先挑 10 个真实任务,保留原方案的结果:哪里用错了规则,哪里忘了用户条件,交接花了多久,最后由人改了多少。然后只调整一个边界——合并一对经常接力的 Agent,或者把一组冲突规则拆开——再重新跑同一批任务。
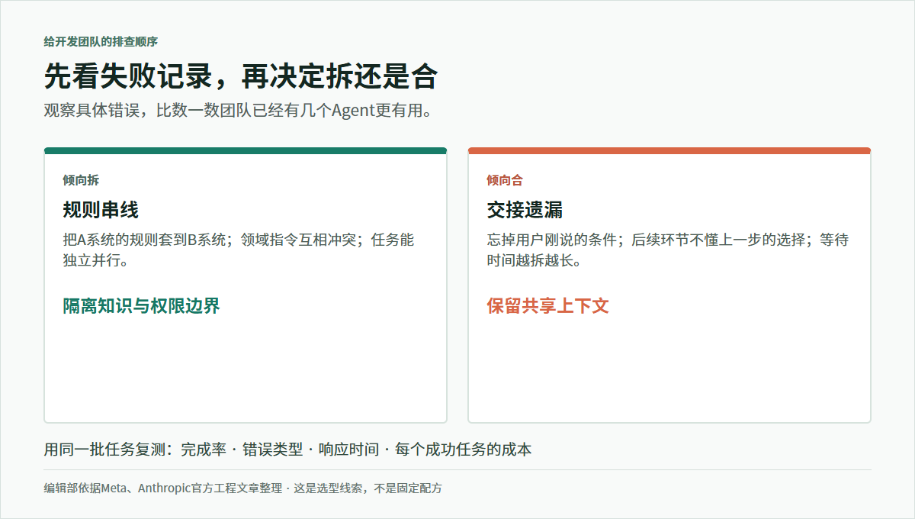
根据 Meta 与 Anthropic 两篇工程文章整理的中文排查图。左侧对应规则串用,右侧对应交接遗漏
Anthropic 还提醒了一个容易漏掉的细节:某次合并让整体延迟下降,却把原本能走通的配送日期查询弄坏了。平均分更好看,用户要的答案反而丢了。评测要盯住哪些任务从“能做”变成“不能做”。
下次有人提议“再加一个专家 Agent”,先问他要解决哪条失败记录。拿不出对应的案例,这个 Agent 多半还不该加上。
参考链接:
https://engineering.fb.com/2026/10/19/ml-applications/thin-orchestrator-ai-agent-architecture/
https://claude.com/ja/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
 发表于 昨天 22:26
|
查看: 9|
回复: 0


