大家好,我是 J哥。
经常让 AI 写初稿的朋友应该有同感:一句话丢过去,写出来的东西工整得可怕。能看,就是不像我写的。
问题出在哪?它不认识我,没读过我的历史文章,不知道我的写作风格。
最近我琢磨出一个解法:把 20 篇历史文章蒸馏成一套「写作 DNA」,直接交给 AI 当说明书。
实测下来的效果真不赖,下面整理成教程分享给大家。
01 如何蒸馏
先说思路。人手上手蒸馏,一般走这个流程:
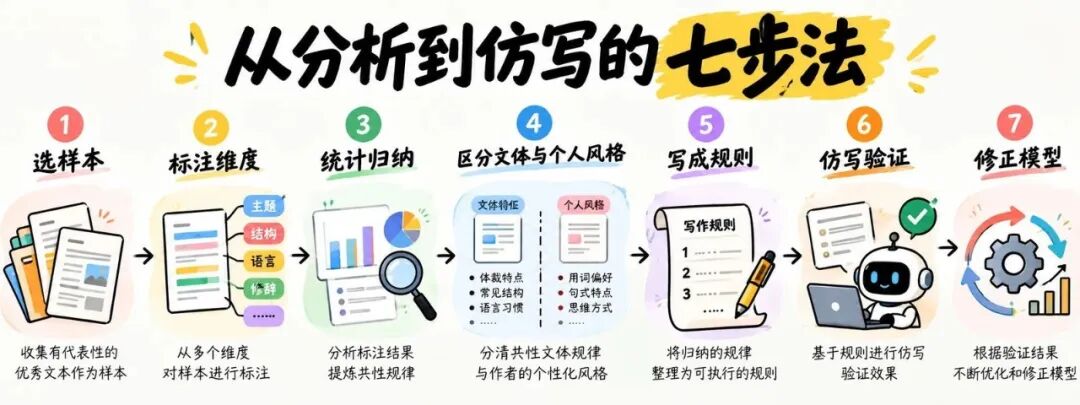
每一步都费时间。
要让 AI 来干,就得先给它一份操作手册,这正是 Skill 的用武之地。
我试了几个同类技能,最后选了 ahao-writing-dna-distiller 这个开源项目。
它有个核心主张,我特别认同:蒸馏别求平均,要建「规律 + 基线 + 样本」三层档案。
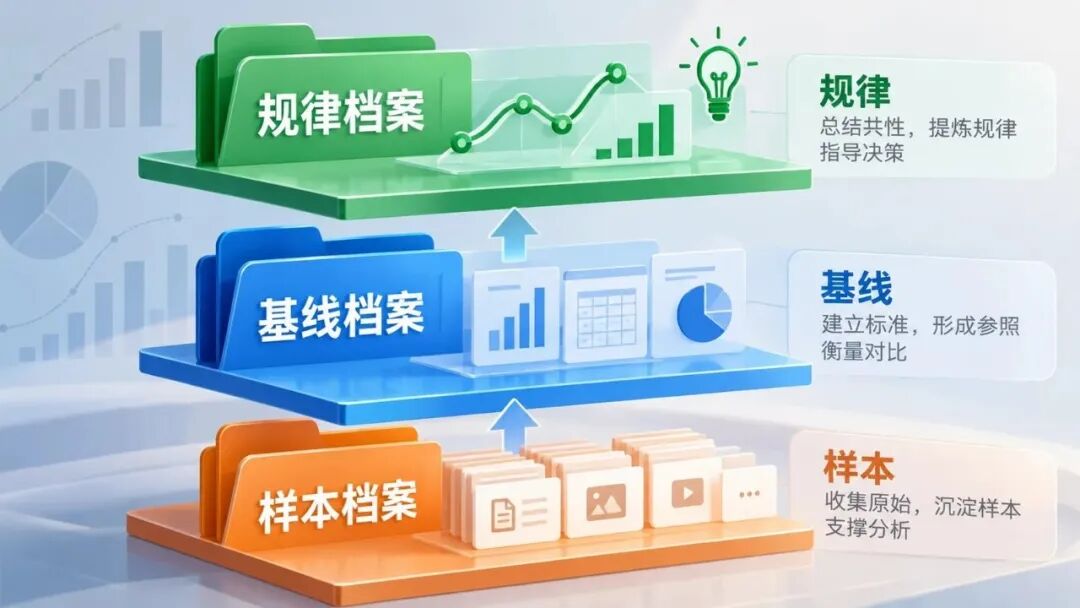
说人话就是:不光总结出「我爱用短句」,还要量出「多短、多久出现一次」,再把我那些带脾气的原句原文照抄留下来。
光有规律,留不住手感。
02 实战一下
文章采集
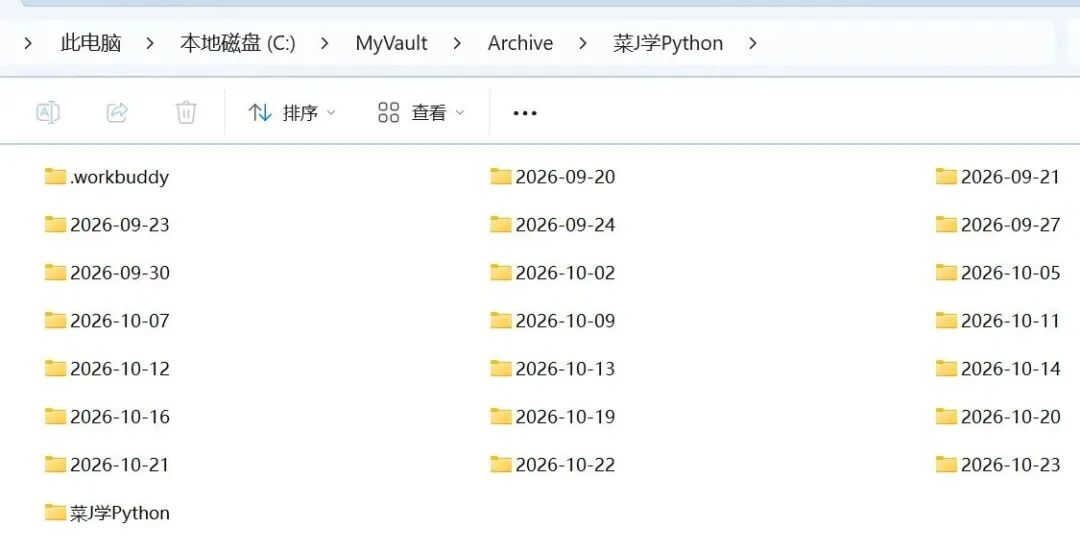
语料是地基。我用之前写过的采集方法手把手教你用 WorkBuddy 自动采集公众号文章,采集了这个号的历史文章。
一共 20 篇,Markdown 格式。
安装技能
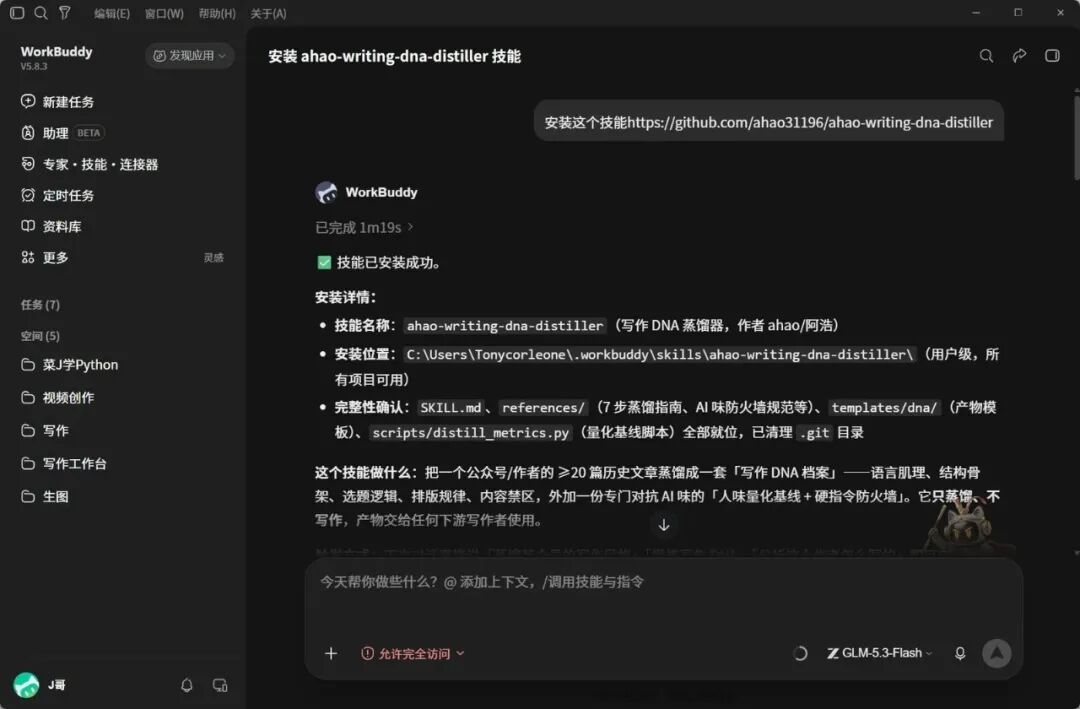
打开 WorkBuddy,输入如下提示词:
帮我安装这个技能:https://github.com/ahao31196/ahao-writing-dna-distiller
运行一分钟,安装完成。
提炼风格
接下来就一句话的事:
文件中有我所有的历史文章,帮我提炼写作 DNA
然后就可以去泡杯茶了。
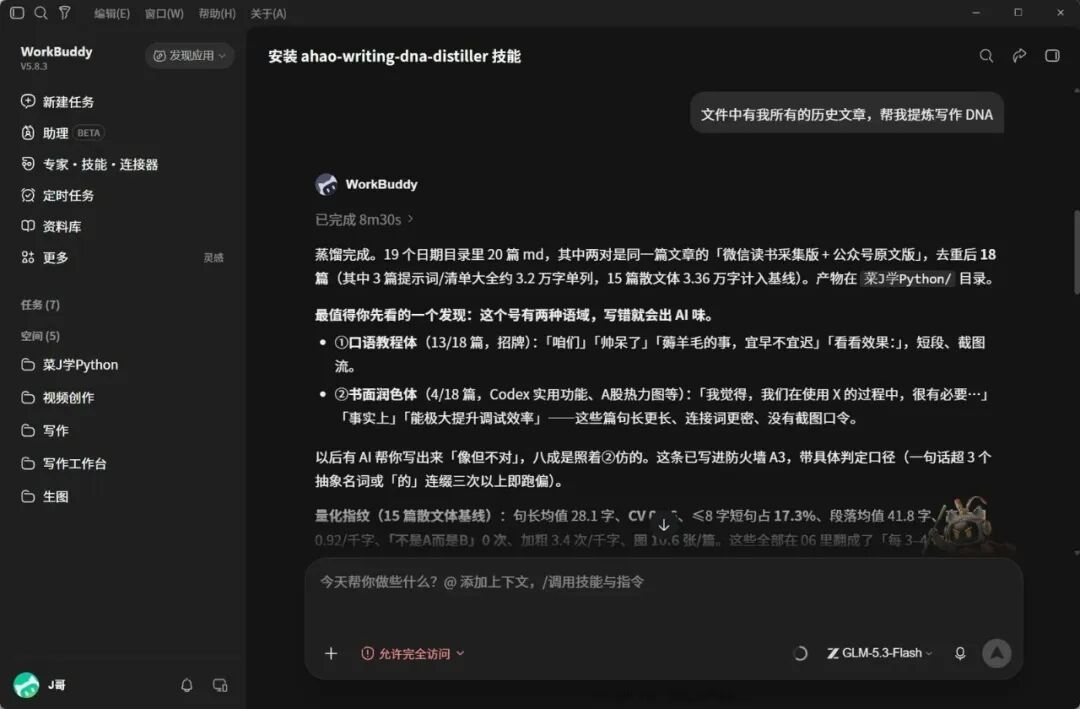
AI 会自己干三件事:先把重复文章剔掉,再跑一个量化脚本,最后逐篇精读。我 20 篇里有 2 对重复,剔完剩 18 篇,它自己就发现了。
半个多小时后,一套完整的 DNA 档案出炉。挑几个有意思的说说。
先看数字。
它量出我的句长均值 28.1 字、句长变异系数 0.86、每篇配图 10.6 张。最意外的是一个句式统计:「不是A,而是B」,全文 0 次。
我压根不这么写。以后 AI 替我写,也不许这么写。
再看发现。
它翻完 18 篇,发现我其实有两种文风:教程类的口语体占 13 篇,另外 4 篇被 AI 润色过,书面腔明显。
它直接把书面体标成「红线」,提醒以后照那个写就跑偏了。说实话,被自己的文章拆穿,还挺服气。
最后看产物。
蒸馏完成后,它直接把我的写作风格提炼出来,并生成一句话风格印象。说实话,还蛮准的。
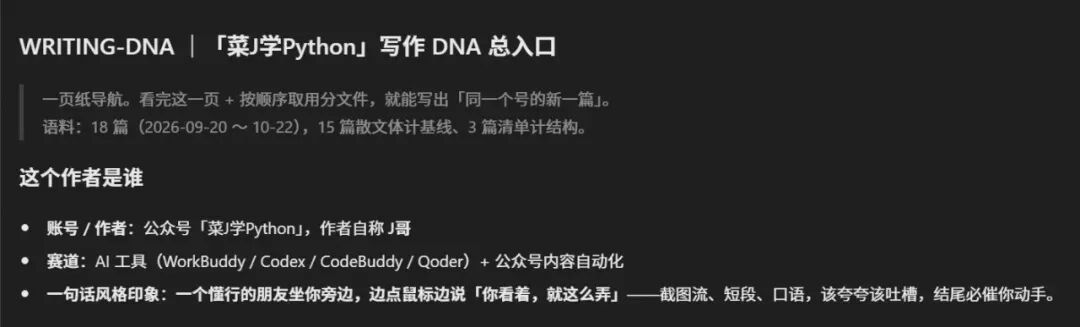
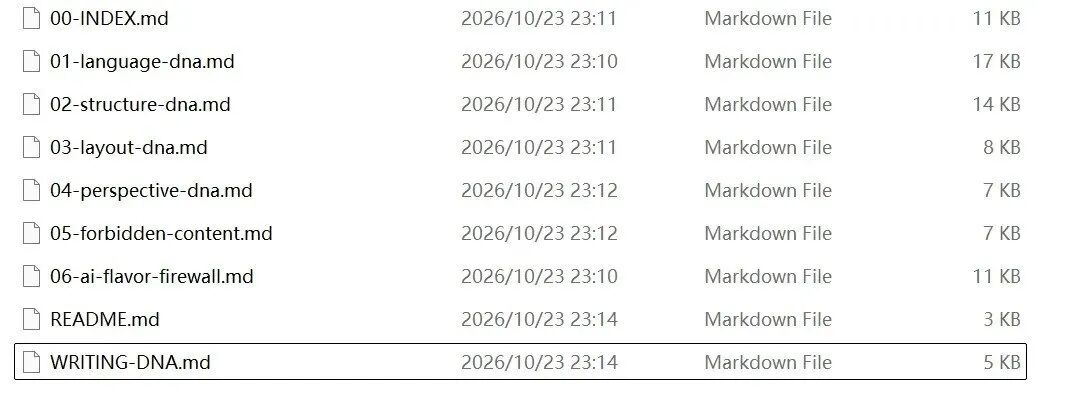
一套档案共 9 个文件:一页纸导航、6 个结构原型、47 条按功能分好桶的原句样本,还有一份专门防 AI 味的防火墙清单。
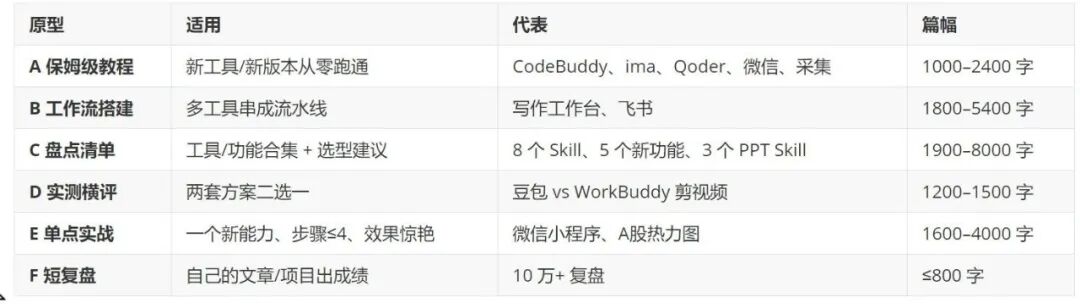
其中 6 个结构原型长这样:
防火墙里全是能照做的硬指令:「每 3–4 句必须砸 1 句不超过 8 字的短句」「全文『然而』出现次数 = 0」「1200 字加粗 4–5 处」。
能一条条数出来,这才叫规则。
看看效果
我把框架丢给 WorkBuddy,让它按这套 DNA 写初稿。
请帮我按「菜J学Python」的风格写一篇公众号文章,框架我发给你。
开头自动带上了「大家好,我是J哥。」,段落短,图的位置留了占位符,连结尾的四行仪式都齐了。
就是你现在看的这篇。框架是我写的,初稿是它按 DNA 生成的,我再人工改一遍。
03 写在最后
这套方法不限于蒸馏自己的号。
你完全可以拿它拆对标账号:学习别人怎么选题、怎么起标题、怎么安排节奏。拆完的档案,就是你自己的素材库。
当然,它现在还不完美。数字量得准,「语感」这种东西还得靠原句样本兜着,蒸完最好自己再过一遍档案,把不对的地方改掉。
感兴趣的朋友,不如现在就上手试试;更多实操细节,也可以在 云栈社区 找到同好一起交流。
 发表于 2 小时前
|
查看: 8|
回复: 0


