引言
在计算机的世界里,只有 0 和 1。为了让人类看懂 "Hello" 和 "你好",我们需要一套字典(字符集)和一套查字典的规则(编码方案)。早期,各地自扫门前雪——美国人发明了 ASCII,中国人发明了 GB2312。这就像不同地区使用不同的方言,一旦跨国界,满屏都是"乱码天书"。直到 Unicode(统一码)出现,才真正为全球每一个文字符号发了一张独一无二的"身份证"。今天,我们就用 A(英文代表)和 中(中文代表)这两位"特邀嘉宾",亲自走一遍这趟编码进化史。
01 ASCII:英文世界的"独行侠"
背景:1963 年诞生,只用了 7 位(实际存储占 1 个字节)就定义了 128 个字符。它的逻辑很简单:26 个字母、数字、标点,够用了。
嘉宾登场:A
在 ASCII 的世界里,大写 A 排在第 65 位。
- 十六进制:
0x41
- 二进制:
0100 0001(仅占 1 字节)
- 存储形态:
41
嘉宾登场:中
查无此字!ASCII 的字典实在太小了,只有 128 个空位,根本没有给汉字留座位。如果硬要存储,计算机只能尴尬地显示为两个乱码字符,或者直接报错。
小结:ASCII 的优点是简单高效、地位稳固;缺点是极其"排外",无法表示任何非英语字符。
02 ANSI(GB2312 / GBK):中文世界的"地方诸侯"
背景:为了解决中文问题,中国制定了 GB2312,后扩展为 GBK。它的策略是"兼收并蓄":英文沿用 ASCII 那一套(单字节),中文则用两个字节(双字节)来表示。
嘉宾再登场:A
- 十六进制:
0x41
- 二进制:
0100 0001(仅占 1 字节)
- 存储形态:
41
- 潜规则:完全兼容 ASCII!只要看到小于 127 的字节,GBK 就按英文处理。
嘉宾再登场:中
汉字"中"被安排在 GB2312 的第 54 区第 48 位(区位码)。
- 十六进制:
0xD6 0xD0
- 二进制:
1101 0110 1101 0000(占 2 字节)
- 存储形态:
D6 D0
- 空间效率:只用了 2 个字节,比 UTF-8 少 1 个字节,非常省空间!
小结:GBK 的优点是兼容 ASCII,且纯中文体积更小;缺点是仅限简体中文环境,无法同时处理繁体、日文或 emoji,国际化场景下寸步难行。
03 Unicode:给全宇宙字符发"身份证"
背景:混乱的编码让跨国软件苦不堪言。Unicode 应运而生,它只负责给字符分配唯一的码位(Code Point),至于怎么存,它不管。
嘉宾再登场:A
嘉宾再登场:中
- 码位:
U+4E2D(十六进制 0x4E 0x2D)
- 二进制原型:
0100 1110 0010 1101
小结:此时,A 和 中 都拿到了全球唯一的"门牌号"。但问题来了——怎么把这个门牌号存进硬盘呢?这就引出了下面的 UTF 编码方案。
- 案例 01|UTF-16 BE:用 2 个字节(16 位)直接表示码位,存储时采用大端字节序。
- 案例 02|UTF-16 LE:用 2 个字节(16 位)直接表示码位,存储时采用小端字节序。
- 案例 03|UTF-8:采用变长编码。英文 1 字节,欧洲文 2 字节,中文 3 字节。它巧妙的设计是:单字节首位为 0,多字节首字节开头的 1 的个数代表总字节数。
3.1 UTF-16:内存里的"效率贵族"
UTF-16 统一用 2 个字节存储码位,存储时需要区分大端字节序(MSB)还是小端序(LSB)。
背景:大部分常用字符(包括 A 和 中)都在基本多语言平面(BMP)内,UTF-16 用 2 个字节(16 位)直接存储码位。Windows 内部、Java、Python 内存中常采用它。但它有个麻烦事——字节序(Endianness),也就是先存高字节还是低字节?
嘉宾再登场:A
- 大端序(BE):
0x00 0x41(二进制 0000 0000 0100 0001)
- 小端序(LE):
0x41 0x00(二进制 0100 0001 0000 0000)
- 槽点:空间浪费典型!为了存一个英文字母,居然空出 8 个零,白白浪费一倍空间!
嘉宾再登场:中
- 大端序(BE):
0x4E 0x2D(直接照搬码位 U+4E2D)
- 小端序(LE):
0x2D 0x4E(高低字节互换)
小结:UTF-16 的优点是中文处理极快,无需解码计算;缺点是不兼容 ASCII,而且跨平台时必须靠文件开头的 BOM(字节顺序标记)来分辨是 FE FF(大端)还是 FF FE(小端),否则极易乱码。
3.2 UTF-8:互联网上的"流量之王"
UTF-8:采用变长编码(英文 1 字节,欧洲文 2 字节,中文 3 字节)。它的规则也很直观:单字节首位为 0,多字节首字节开头的 1 的个数代表总字节数。
嘉宾再登场:A
- 十六进制:
0x41
- 二进制:
0100 0001(占 1 字节)
- 存储形态:
41
- 惊人事实:和 ASCII 的
41 一模一样!这就是 UTF-8 横扫互联网的最大杀招——纯英文文档无需任何转换。
嘉宾再登场:中
- 十六进制:
0xE4 0xB8 0xAD
- 二进制:
1110 0100 1011 1000 1010 1101(占 3 字节)
拆解过程:
- 确定 Unicode 码:汉字"中"的 Unicode 码是
4E2D,二进制为 0100 1110 0010 1101(共 16 位有效数字)。
- 找到 UTF-8 表示汉字的 3 字节模板:
1110 xxxx 10xx xxxx 10xx xxxx(共 16 个 x 空位)。
- 把 Unicode 码填充进去:填充后得到
1110 0100 1011 1000 1010 1101,换算成十六进制就是 E4 B8 AD。
小结:UTF-8 的优点是互联网绝对主流、兼容 ASCII、自同步无乱码风险;缺点是中文比 GBK 多占 1/3 的空间。
一张表看懂 A 与 中 的百变身份
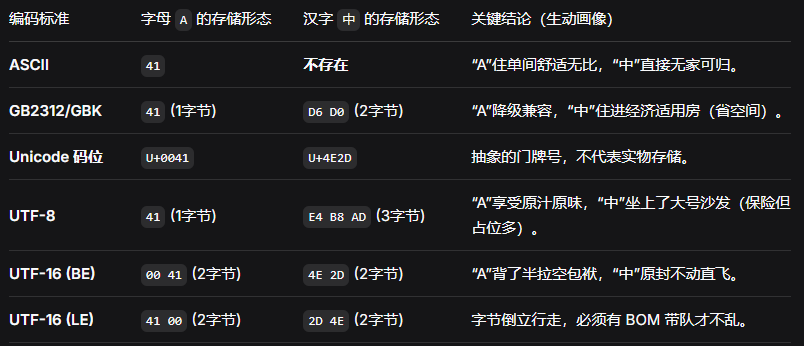
04 结语与实战选择建议
透过 A 和 中 这两个细微的视角,我们窥见了编码演进的宏大史诗:
- 如果你是做网页、API 接口、跨平台文件传输:无脑选 UTF-8。它兼容 ASCII,是全球互联网的"普通话"。
- 如果你维护的是老旧中文 Windows 系统的内部文档:GBK 依然能用,但导出时强烈建议转为 UTF-8,避免其他地区用户打开是乱码。
- 如果你在写 Java 或 C# 程序,处理内存中的字符串:UTF-16 是 JVM 和 CLR 的默认选择,因为定长(大部分)处理速度快。
- 如果你追求极致的随机访问速度,不介意空间:UTF-32(固定 4 字节)一刀切最简单,但现实中极少用于存储,因为空间成本太高。
从 A 到 中,从单字节到多字节,字符编码的演进本质上是人类文明在数字世界的大融合。理解了它们的底层二进制形态,你就再也不会被乱码困扰了。
 发表于 昨天 23:24
|
查看: 4|
回复: 0
 /1


