今天来聊聊优化算法中牛顿法的核心逻辑:它为什么会比普通梯度下降更快?关键就在二阶信息。
首先,牛顿法是一种利用二阶信息(梯度与海森矩阵)进行迭代更新的优化算法。它在当前点对目标函数做二阶泰勒近似,用该近似的极小点作为下一次迭代点,因此在接近最优解时通常具有二次收敛速度。
相比只用一阶信息的梯度下降,牛顿法使用曲率信息来“校正”步长与方向,从而能更快、更稳定地逼近极小值。
核心原理
在点 $x_k$ 处对可微函数 $f(x)$ 做二阶泰勒近似:
$$
f(x) \approx f(x_k) + \nabla f(x_k)^\top (x - x_k) + \frac{1}{2}(x - x_k)^\top H_f(x_k)(x - x_k)
$$
其中 $\nabla f(x_k)$ 为梯度,$H_f(x_k)$ 为海森矩阵(二阶导数矩阵)。
最小化上述二次近似,可以得到更新方向 $s_k$,它满足线性方程:
$$
H_f(x_k) s_k = -\nabla f(x_k)
$$
因此更新公式为:
$$
x_{k+1} = x_k + s_k
$$
一维情形的经典形式是:
$$
x_{k+1} = x_k - \frac{f'(x_k)}{f''(x_k)}
$$
收敛特性:在最优点附近且 $H_f(x_k)$ 正定时,牛顿法通常具有二次收敛速度。为了更稳健,实际中常用阻尼牛顿法(配合线搜索)或修正海森矩阵(如拟牛顿法)来处理非正定或病态情形。
Python 实现
我们用一个二维的非线性凸函数来演示牛顿法的迭代轨迹。
函数为:
$$
f(x_1, x_2) = (x_1 - 2)^4 + (x_2 + 1)^2 + 0.1(x_1 - 1)^2
$$
该函数的 Hessian 矩阵在全局范围内正定。我们用 PyTorch 自动求梯度与海森矩阵,迭代若干步并在等高线图上绘制牛顿法的路径。
import torch
import numpy as np
import matplotlib.pyplot as plt

# 1) 定义目标函数
def f_torch(x):
    # x: tensor of shape (2,)
    x1, x2 = x[0], x[1]
    return (x1 - 2)**4 + (x2 + 1)**2 + 0.1*(x1 - 1)**2

def f_numpy(X, Y):
    return (X - 2)**4 + (Y + 1)**2 + 0.1*(X - 1)**2

# 2) 牛顿法迭代(用 PyTorch 自动微分计算梯度和海森)
def newton_optimize(x0, max_iters=7):
    x = x0.clone().detach().requires_grad_(True)
    trajectory = [x.detach().numpy().copy()]

    for k in range(max_iters):
        # 计算梯度
        f_val = f_torch(x)
        grad = torch.autograd.grad(f_val, x, create_graph=True)[0]

        # 计算海森矩阵(逐分量对 x 再求梯度)
        H_rows = []
        for i in range(2):
            # retain_graph for multiple backward calls
            Hi = torch.autograd.grad(grad[i], x, retain_graph=True)[0]
            H_rows.append(Hi)
        H = torch.stack(H_rows, dim=0)  # shape (2,2)

        # 解线性方程 H s = -grad
        # 为稳健可加微小扰动对角线(正则化),这里函数本身正定无需
        s = torch.linalg.solve(H.detach(), -grad.detach())

        # 更新
        with torch.no_grad():
            x += s
            x.requires_grad_(True)

        trajectory.append(x.detach().numpy().copy())

    return np.array(trajectory)

# 3) 运行牛顿法
x0 = torch.tensor([-1.5, 1.5], dtype=torch.float32)  # 初始点
traj = newton_optimize(x0, max_iters=7)

# 4) 绘制等高线与牛顿法轨迹
plt.figure(figsize=(7, 6))

# 网格
xmin, xmax = -2.5, 4.0
ymin, ymax = -3.0, 2.0
xx = np.linspace(xmin, xmax, 400)
yy = np.linspace(ymin, ymax, 400)
X, Y = np.meshgrid(xx, yy)
Z = f_numpy(X, Y)

# 等高线图
contours = plt.contourf(X, Y, Z, levels=40, cmap='turbo')
plt.colorbar(contours)

# 轨迹
plt.plot(traj[:, 0], traj[:, 1], color='magenta', linewidth=2.5,
         marker='o', markersize=6, label='牛顿法轨迹')
plt.scatter(traj[0, 0], traj[0, 1], color='red', s=80, label='起点')
plt.scatter(traj[-1, 0], traj[-1, 1], color='lime', s=80,
            edgecolors='black', linewidth=1.2, label='终点(近最优)')

# 目标点(解析上 y*=-1,x*≈接近2)
plt.scatter(2, -1, color='cyan', s=70, marker='X', label='理论最优附近')

plt.xlim(xmin, xmax)
plt.ylim(ymin, ymax)
plt.xlabel('x')
plt.ylabel('y')
plt.title('牛顿法在二维非线性凸函数上的迭代轨迹')
plt.legend(loc='upper left', frameon=True)
plt.tight_layout()
plt.show()
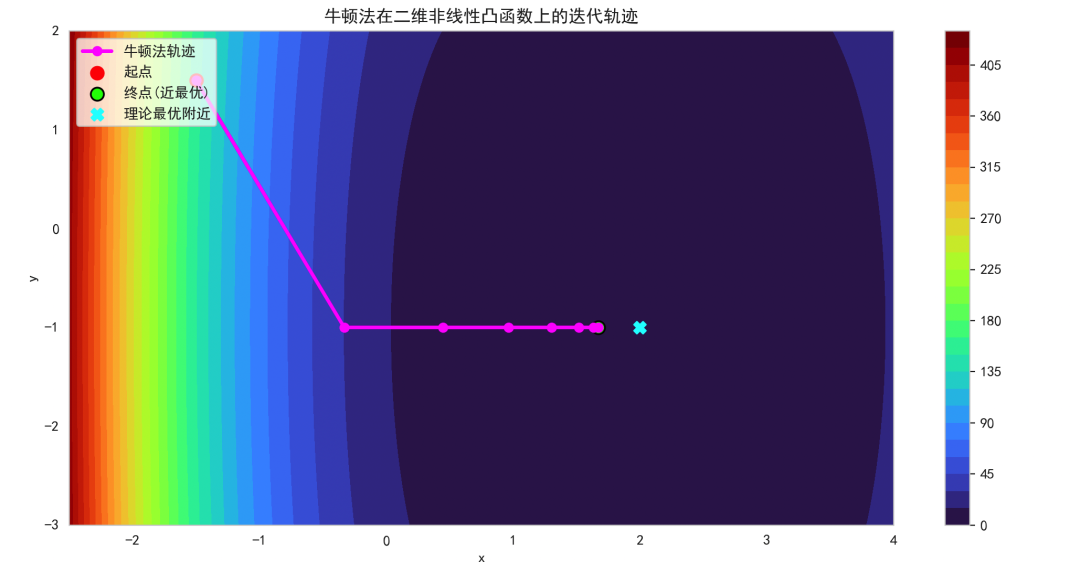
使用二阶泰勒近似得到方向 $s_k$,其中 $H_f(x_k) s_k = -\nabla f(x_k)$,$x_{k+1} = x_k + s_k$。PyTorch 自动求导可以获取梯度与海森矩阵,避免手动推导复杂二阶导。
在全局正定的函数上,牛顿法通常能快速逼近最优点;图中也能看到轨迹迅速向理论最优区域收敛。
如果 $H_f(x_k)$ 非正定或病态,实践中常加入对角正则项,例如 $H + \lambda I$,或者采用带线搜索的阻尼牛顿法,以保证下降方向有效、迭代过程更稳健。
 发表于 昨天 23:26
|
查看: 10|
回复: 0
 /1


