前言
不知道大家有没有留意过,使用一些 App 注册账号时,系统会提示用户名已经被占用了,需要换一个。这背后的检查逻辑是怎么实现的?
你可能想:这还不简单,去数据库里查一下有没有不就行了?但如果用户量达到数亿甚至十亿级别,这套思路还能撑住吗?
数据库方案
第一种方案就是直接查询数据库,这也是大多数人第一时间能想到的做法。
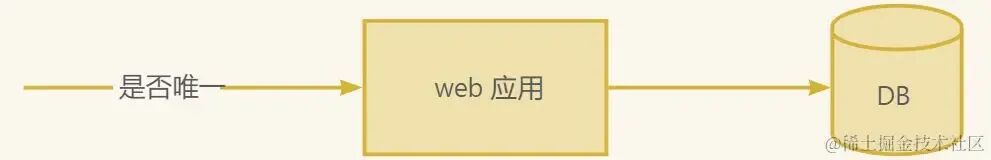
public class UsernameUniquenessChecker {
    private static final String DB_URL = "jdbc:mysql://localhost:3306/your_database";
    private static final String DB_USER = "your_username";
    private static final String DB_PASSWORD = "your_password";

    public static boolean isUsernameUnique(String username) {
        try (Connection conn = DriverManager.getConnection(DB_URL, DB_USER, DB_PASSWORD)) {
            String sql = "SELECT COUNT(*) FROM users WHERE username = ?";
            try (PreparedStatement stmt = conn.prepareStatement(sql)) {
                stmt.setString(1, username);
                try (ResultSet rs = stmt.executeQuery()) {
                    if (rs.next()) {
                        int count = rs.getInt(1);
                        return count == 0;
                        // 如果count为0,代表用户名可用
                    }
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        return false;
        // 发生异常时,默认判定用户名不可用
    }

    public static void main(String[] args) {
        String desiredUsername = "new_user";
        boolean isUnique = isUsernameUnique(desiredUsername);
        if (isUnique) {
            System.out.println("Username '" + desiredUsername + "' is unique. Proceed with registration.");
        } else {
            System.out.println("Username '" + desiredUsername + "' is already in use. Choose a different one.");
        }
    }
}
但这种方式存在几个明显的问题:
- 性能问题,延迟高。 当数据量很大时,查询速度会明显变慢。再加上数据库查询涉及应用服务器和数据库服务器之间的网络通信,建立连接、发送查询、接收响应,每一步都会带来额外延迟。
- 数据库负载过高。 频繁执行 SELECT 查询 来检查用户名唯一性,每个查询都需要消耗数据库资源,包括 CPU 和 I/O。
- 可扩展性差。 数据库对并发连接和资源都有限制。如果注册流量持续增长,数据库服务器可能难以应对不断增加的请求。垂直扩展(给单台服务器堆更多硬件)成本高昂,而且总有上限。
缓存方案
为了解决数据库调用用户名唯一性检查的性能问题,可以引入高效的 Redis 缓存(Set 集合)。
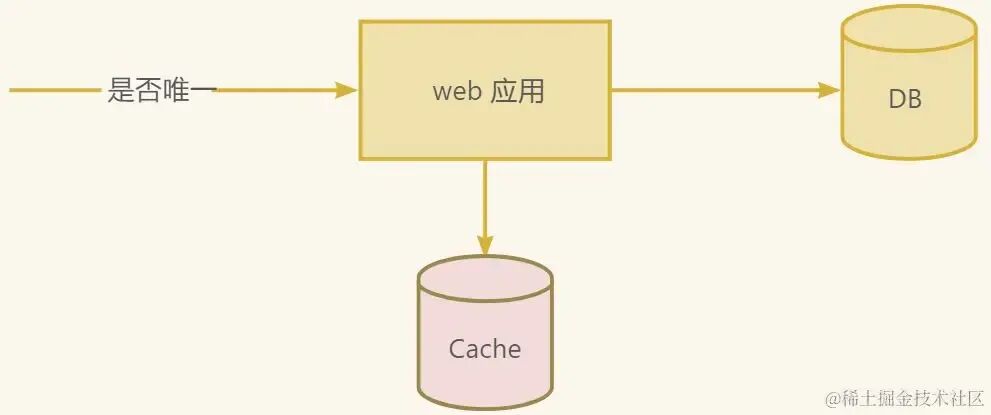
public class UsernameCache {
    private static final String REDIS_HOST = "localhost";
    private static final int REDIS_PORT = 6379;
    private static final int CACHE_EXPIRATION_SECONDS = 3600;
    private static JedisPool jedisPool;

    // 初始化Redis连接池
    static {
        JedisPoolConfig poolConfig = new JedisPoolConfig();
        jedisPool = new JedisPool(poolConfig, REDIS_HOST, REDIS_PORT);
    }

    // 使用Redis缓存校验用户名是否唯一
    public static boolean isUsernameUnique(String username) {
        try (Jedis jedis = jedisPool.getResource()) {
            // 判断用户名是否在Redis集合中
            if (jedis.sismember("usernames", username)) {
                return false;
                // 用户名已存在,不唯一
            }
        } catch (Exception e) {
            e.printStackTrace();
            // Redis异常时,可以降级到查询数据库
        }
        return true;
        // 缓存中不存在,用户名可用
    }

    // 将用户名加入Redis缓存
    public static void addToCache(String username) {
        try (Jedis jedis = jedisPool.getResource()) {
            jedis.sadd("usernames", username);
            // 把用户名添加到Set集合
            jedis.expire("usernames", CACHE_EXPIRATION_SECONDS);
            // 设置缓存过期时间
        } catch (Exception e) {
            e.printStackTrace();
            // 处理缓存写入失败的情况
        }
    }

    // 关闭连接池,释放资源
    public static void close() {
        jedisPool.close();
    }
}
这个方案最大的问题是内存占用过大。
假设每个用户名大约需要 20 字节的内存,想要存储 10 亿个用户名,就需要 20 GB 的内存:
总内存 = 每条记录的内存使用量 × 记录数
20 字节/记录 × 1,000,000,000 条记录 = 20,000,000,000 字节 = 20,000,000 KB = 20,000 MB = 20 GB
布隆过滤器方案
直接使用 Redis Set 缓存,内存占用实在太大。有没有更好的办法?布隆过滤器就是一个非常合适的选择。
那究竟什么是布隆过滤器呢?布隆过滤器(Bloom Filter)是一种概率型数据结构,用于快速检查一个元素是否存在于一个大型数据集中。它的典型用途是:在不需要百分百精确判断的场景下,以极低的内存成本快速过滤掉不可能存在的元素,从而避免后续成本更高的查询操作。
布隆过滤器的主要优势在于:查找和插入速度极快,内存占用极低。
实现原理
布隆过滤器的核心思想是使用一个位数组(bit array) 和一组哈希函数。
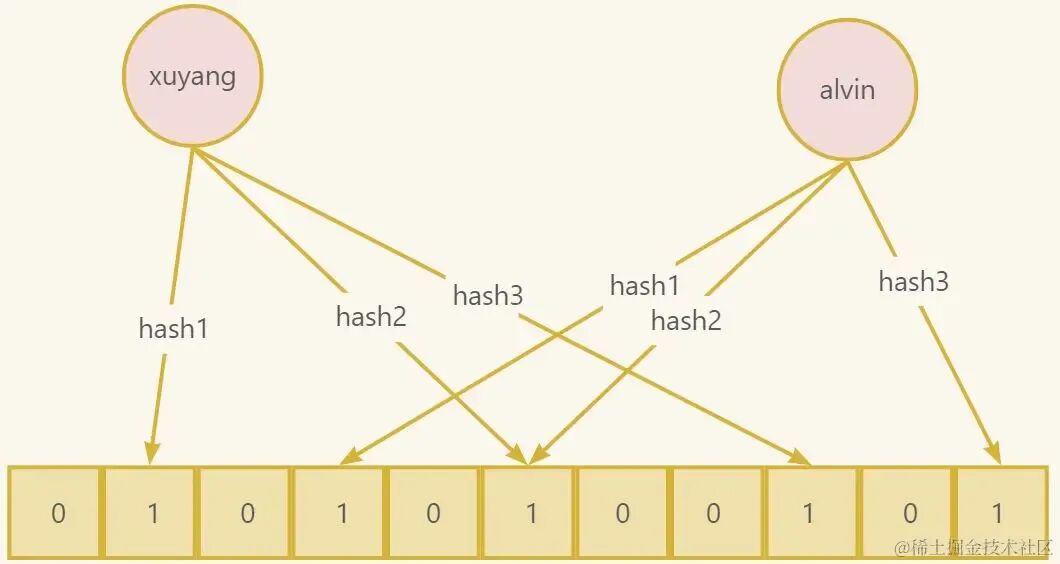
- 位数组(Bit Array):布隆过滤器使用一个包含大量 bit 位的数组,初始全部置 0。每个 bit 只有 0/1 两个值,用来标记元素"可能存在"。
- 哈希函数(Hash Functions):布隆过滤器使用多个相互独立、分布均匀的哈希函数,将输入元素映射到位数组的不同位置。
添加元素:插入元素(例如用户名 xuyang、alvin)时,通过多个哈希函数算出多个 bit 下标,把这些位置的 bit 全部置为 1。
查询元素:校验元素是否存在时,使用相同的哈希函数算出对应的 bit 位置。
- 如果任意一个 bit 为 0 → 元素一定不存在
- 如果所有 bit 都是 1 → 元素可能存在(存在误判)
Redis 原生支持布隆过滤器,代码示例如下:
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;
import redis.clients.jedis.JedisPoolConfig;

public class BloomFilterExample {
    public static void main(String[] args) {
        JedisPoolConfig poolConfig = new JedisPoolConfig();
        JedisPool jedisPool = new JedisPool(poolConfig, "localhost", 6379);
        try (Jedis jedis = jedisPool.getResource()) {
            // 创建布隆过滤器:指定名称、预计元素数量、期望误差率
            jedis.bfCreate("usernameFilter", 10000000, 0.01);
            // 将用户名添加到布隆过滤器
            jedis.bfAdd("usernameFilter", "alvin");
            // 检查用户名是否已经存在
            boolean exists = jedis.bfExists("usernameFilter", "alvin");
            System.out.println("Username exists: " + exists);
        }
    }
}
布隆过滤器的优缺点
✅ 优点
- 节约内存空间:相比哈希表或 Set,布隆过滤器不存储原始元素,只存 bit 位。例如在误差率为 0.001 的情况下,存储 10 亿条记录仅需约 1.67 GB 内存,对比 Redis Set 的 20 GB,内存占用大幅下降。
- 高效查找:O(1) 常数时间即可判断元素是否存在,不需要遍历整个数据集。
❌ 缺点
- 存在误判率:布隆过滤器有假阳性,有可能判断元素存在但实际不存在;但不会出现假阴性,也就是说,它不会把实际存在的元素判定为不存在。
- 一般不支持删除元素:直接删除元素会清除对应的 bit 位,这会影响到其他元素的判断,从而提高误判率。
总结
Redis 布隆过滤器方案,为大数据量场景下的唯一性校验提供了一种高效且省内存的解决思路。实际使用中,需要在内存消耗和误判率之间做权衡。
布隆过滤器的应用场景远不止这一处,比如 防止缓存穿透、拦截恶意访问等,都是它的经典用武之地。
来源:稀土掘金
 发表于 昨天 23:31
|
查看: 4|
回复: 0
 /1


