作为全球最大的短视频和直播平台之一,快手(Kwai)旗下核心应用的日活跃用户已经超过 4 亿,月活跃用户接近 8 亿。在 AI 方面,快手旗下的图像与视频生成模型可灵 AI(Kling AI)的用户数也已经突破 1 亿,覆盖全球 224 个国家。
图片由 Kling AI 创建
在这一背景下,快手平台每天会产生海量的新增非结构化数据。如何在持续写入新数据的同时,从数十亿乃至数百亿条数据(以视频为主)中快速找到所需内容?传统的关键词检索显然已经无法满足需求。
为此,经过技术选型和大规模落地实践,快手基于 Milvus 向量数据库搭建了一套面向全公司业务的向量检索平台。
目前,这套平台已经帮助快手管理着数百亿条向量数据,其中部分单集群向量数量超过百亿,为内容安全、视频去重、智能搜索以及各类 AI 应用提供统一的检索服务。以下是具体的实践分享。
01 挑战
在快手,一条新上传的视频,首先要经过内容安全审核;接着,还需要与平台已有的海量视频进行去重比对,判断它是否是曾经发布过的内容,或者只是换了水印、翻转了画面后重新上传的旧视频。
要完成以上任务,仅靠视频标题、标签等关键词信息远远不够。系统必须能够识别视频的实际内容,理解不同视频之间的语义关联,并在海量数据中快速找到相似结果。
而视频去重和内容安全,只是快手众多 AI 应用中的一部分。随着多模态搜索、RAG、AI Agent 等技术逐步落地,越来越多的业务开始依赖语义检索,向量数据库也由此成为重要的底层基础设施。
但在业务实战中,快手并不是一开始就采用了专门的向量数据库。
早期团队选择在已有的 Elasticsearch 架构上增加近似最近邻(ANN)索引,以支持向量检索。这种方式既能复用现有技术体系,也基本满足了当时的业务需求。但随着集团内的业务不断增加,向量数据规模逐渐向数百亿级别增长,原有架构的问题开始集中暴露出来。
首先是读写资源争抢,导致查询延迟难以保持稳定。
以风控和内容安全业务为例,平台每天都有大量新内容上传,新的向量数据需要持续写入数据库,并尽快进入可检索状态。与此同时,线上还有大量查询请求,系统必须在很短的时间内完成相似性检索。
但在 Elasticsearch 中,写入和查询会共用相同的节点。随着并发量增大,两类任务会不可避免地争抢计算资源。写入压力一旦升高,查询延迟就容易出现明显波动。对于普通的离线分析任务,偶尔慢一些或许还能接受;但风控和内容安全系统需要持续处理线上请求,对响应时间的稳定性要求很高,频繁的延迟抖动会直接影响业务。
其次是存储与计算资源绑定,规模越大,扩容成本越高。
随着向量数据不断积累,快手需要持续扩大集群容量。但 Elasticsearch 的存储和计算资源是耦合的,即使当前只缺存储空间,扩容时往往也需要一起增加 CPU 和内存;反过来,如果只是查询压力增加,同样很难单独扩展计算资源。当数据规模达到数百亿条向量时,这种扩容方式不仅造成资源浪费,也让集群调度和日常管理变得越来越复杂。
另一个问题来自 Elasticsearch 对向量维度的限制。随着 Embedding 模型持续演进,快手部分新模型已经能够生成超过 4,096 维的向量,但原有 Elasticsearch 方案的向量维度上限只有 4,096。这意味着,即使业务团队找到了更适合自身场景的模型,也可能因为底层检索引擎不支持对应的向量维度而无法直接使用。
读写干扰、扩容成本和维度限制,这些问题叠加在一起,让快手意识到单纯依靠 Elasticsearch 继续扩展已经很难满足未来的业务需求。团队需要一套真正面向大规模向量检索设计的基础设施。
02 为什么选择 Milvus
对市场上的向量检索产品进行了内部评估后,快手最终选择了 Milvus。
吸引快手的首先是 Milvus 的分布式架构。Milvus 将数据写入、查询、索引构建和集群协调等任务拆分到不同组件中,并将存储与计算解耦。这样一来,写入和查询可以分别使用不同的计算资源,系统可以持续接收新内容,同时保持在线查询的稳定性。需要扩容时,也可以根据实际瓶颈单独增加查询、计算或存储资源,避免不必要的硬件投入。
除了架构,检索性能同样是快手关注的重点。Milvus 能够在数十亿级向量规模下实现毫秒级检索,为内容安全、视频去重等实时业务提供所需的响应速度。
但快手内部的业务差异很大,很难用一套索引配置满足所有需求。例如,风控业务可能更看重高并发吞吐量,需要处理每秒上万次查询;另一些业务的数据量更大,但查询频率相对较低,反而更关心存储和内存成本。Milvus 提供 HNSW、IVF、DiskANN 等多种索引类型,也支持 SQ8、RaBitQ 等量化压缩方案。业务团队可以根据自身的数据规模和性能要求,灵活调整索引策略,在召回率、延迟、内存占用和成本之间做出取舍。同时,Milvus 对数万维向量的支持,也让快手能够更加自由地采用不同的 Embedding 模型。
此外,快手需要的也不只是简单的向量相似性检索。在实际业务中,向量搜索经常需要与标量过滤、全文检索、语义搜索、混合检索以及聚合查询结合使用。Milvus 将这些能力集成在同一个引擎中,业务团队可以通过统一 API 完成检索,无需再为不同需求分别维护多套系统。
Milvus 的开源生态也是快手选型时考虑的因素之一。作为采用 Apache 2.0 许可证的开源项目,Milvus 已积累超过 46,000 个 GitHub Star、10,000 多家企业用户和超过 1 亿次下载。成熟的社区基础既方便快手开展深度定制与优化,也为双方长期的技术合作提供了空间。
03 解决方案:从单一检索引擎到公司级向量检索平台
选定 Milvus 后,快手开始逐步将各类向量检索需求迁移到统一的平台上。
如今,快手已部署多个基于 Milvus 2.5 和 2.6 的生产集群,管理数百亿条向量数据。其中,最大的单个集群存储超过 100 亿条向量,部署了 400 多个 QueryNode(查询节点)。
这套平台承载的业务也越来越丰富。除了最初的风控、内容安全和视频去重,还包括 RAG 知识库、Agent 记忆、推荐与用户画像、多模态及跨模态搜索等场景。
不同业务使用的向量维度从 64 维一直延伸到超过 10,000 维,峰值查询吞吐量超过 10,000 QPS。
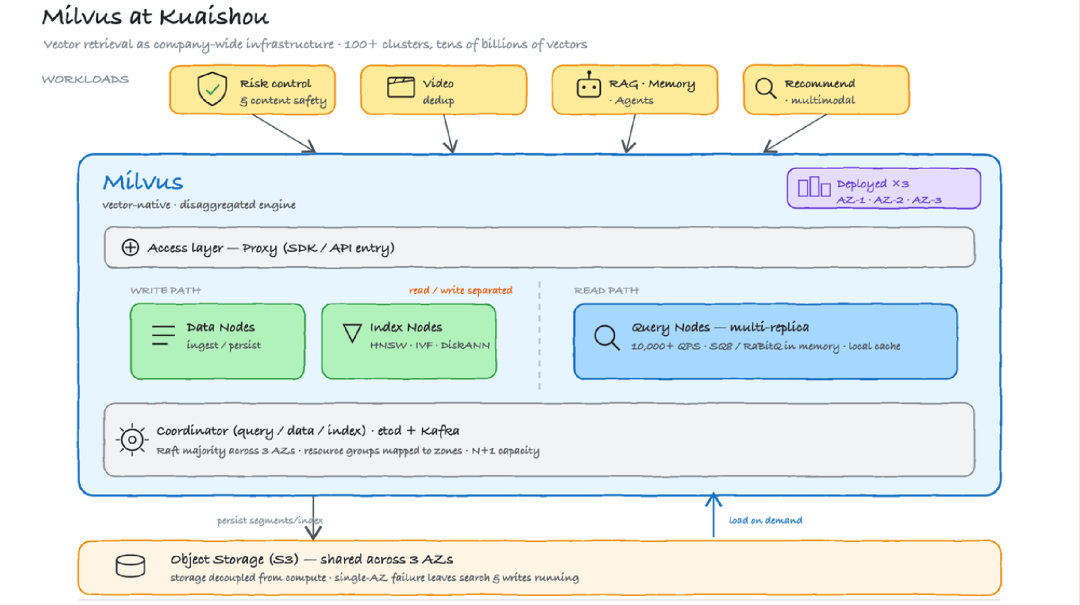
快手的 Milvus 部署架构
在这套大规模平台上,快手既要满足不同业务的性能要求,也要解决集群管理、资源调度和故障恢复等问题。为此,团队围绕几个核心业务场景,对 Milvus 进行了针对性的部署与优化。
3.1 风控与内容安全:数十亿向量规模下,如何稳定支撑 10,000+ QPS 的读写分离?
风控和内容安全业务对检索速度和实时性都有很高的要求。从 Elasticsearch 迁移到 Milvus 后,快手利用读写分离架构,将数据写入与在线查询安排在不同节点上运行,从而减少两者之间的相互干扰。
在索引方案上,快手选择了 HNSW,通过图结构加速近似最近邻搜索,保证在线查询的响应速度。但数十亿条向量如果全部以原始精度存放在内存中,成本依然不低。因此团队还引入了 SQ8 量化压缩,将单条向量的数据体积压缩到原来的约四分之一,在保证业务所需检索效果的同时,显著降低内存开销。
为了进一步提升吞吐量,快手还采用多副本部署,让多个查询副本共同承担流量。这套方案最终实现了数十亿向量规模下超过 10,000 QPS 的峰值查询能力。不过,要让系统在这样的规模下稳定运行,快手还做了不少针对实际生产环境的调优:包括根据机器资源调整 Milvus 的 Segment(数据段)大小,以及优化不同可用区之间的副本负载分配,让集群能够更充分地利用现有硬件资源。
这些大规模部署经验也反过来推动了 Milvus 的产品改进。Milvus 2.6 已经将其中部分优化整合进产品,减少了类似场景所需的额外调优工作。
3.2 视频去重:如何从数百亿向量中实时找出重复视频?
视频去重是快手规模最大的两类向量检索业务之一。针对这种业务需求,快手采用的方案是先对上传视频进行抽帧,再将每一帧转换成向量,随后到 Milvus 中进行相似性检索。
这样一来,即使视频经过水印替换、镜像翻转等处理,只要画面内容仍然具有较高相似度,系统就有机会识别出这些重复或二次加工的视频。
但这一过程的计算量相当大。快手的视频内容每天都在持续增长,而去重系统需要从数百亿条向量中实时搜索相似结果,查询吞吐量达到每秒 5,000 至超过 10,000 次,并且需要全天候运行。
针对这一场景,快手选择了 Milvus 的 HNSW 索引。原因是视频去重业务有一个特点:绝大多数数据都是新增的,已有视频很少需要修改。因此索引主要处理持续增长的数据,通常不需要频繁重写。这种数据访问模式与 HNSW 的特点较为契合,有助于保持较高的检索效率。
3.3 大量生产集群,如何通过 Milvus Operator 统一管理?
随着越来越多业务接入 Milvus,快手面对的新问题是:如何高效管理数量不断膨胀的生产集群?
如果每个集群都需要 DBA 手动创建、配置和维护,那么随着业务增长,运维工作量也会迅速增加。尤其在不同业务频繁调整资源、升级版本的情况下,手动管理很难兼顾效率和稳定性。
为此,快手基于 Milvus Operator 建立了统一的集群管理体系。借助 Operator,团队将集群创建、扩缩容、滚动升级和配置变更等操作自动化。如今,业务团队提出需求后,一个新的生产集群只需几分钟就可以完成部署。
日常监控方面,快手基于 Milvus 开源的 Grafana Dashboard 建立了监控体系。数据迁移则交给 Apache SeaTunnel,既用于不同 Milvus 集群之间的数据流转,也用于将旧检索引擎中的数据迁移到新平台。
除了这些自动化工具,快手还开始尝试用 AI 提高数据库运维效率。团队开发了一套基于大语言模型的容量规划 Agent。业务团队只需提供预计存储的向量数量、目标 QPS 和预算,Agent 就能据此推荐合适的集群规模与索引配置。当然,这些建议并不会直接替代人工决策——在大型业务上线前,DBA 仍会对方案进行审核,确保资源配置符合实际需求。
3.4 同城三可用区容灾:一个数据中心故障,如何保证业务不中断?
随着风控、内容安全等核心业务逐步迁移到 Milvus,平台的可用性变得越来越重要。
快手需要考虑一种极端情况:如果某个数据中心整体发生故障,依赖 Milvus 的在线业务还能否正常运行?
为此,快手采用了同城三可用区部署方案,将 Milvus 分布在同一城市的三个数据中心,确保单个数据中心故障不会中断搜索和写入服务。
这套容灾方案利用了 Milvus 分布式架构的特点。Milvus 的大部分服务组件是无状态的,不需要在组件内部保存独有的数据。快手在三个数据中心分别部署这些服务的实例,当其中一个数据中心发生故障时,其他数据中心的实例就可以继续承担相应工作。
但 Query Node 的处理要复杂一些。由于每个查询节点都缓存着部分数据,如果某个数据中心故障,而其他数据中心没有完整的可检索数据,业务仍然可能受到影响。
针对这一问题,快手使用 Milvus 的 Resource Group(资源组)机制,在每个数据中心都维护一份完整的可检索数据副本。这样,即使其中一个数据中心不可用,另外两个数据中心仍然拥有完整的数据,可以继续执行查询。与此同时,快手还为剩余两个数据中心预留了足够的冗余资源,以承接故障发生后的核心业务流量。Milvus 所依赖的元数据存储和消息队列,也采用跨三个数据中心的部署方式,避免底层组件出现单点故障。
通过这套方案,快手实现了单个数据中心故障下搜索和写入服务零中断,进一步提高了公司级向量检索平台的可靠性。
04 成果与收益
从最初基于 Elasticsearch 扩展向量检索,到如今拥有数百亿向量,快手已经将 Milvus 建设成一套成熟的公司级向量检索平台。这套系统能够在数十亿向量规模下实现超过 10,000 QPS 的峰值查询吞吐量。更重要的是,它能在持续写入新数据的同时保持在线查询稳定——通过读写分离,快手解决了过去写入压力增加时查询延迟容易抖动的问题。
随着平台规模扩大,集群运维效率也得到提升。借助 Milvus Operator 和自动化运维体系,一个新集群可以在几分钟内完成部署,平台的告警 SLA 达到 99%。
在数据和模型层面,Milvus 也为业务提供了更大的灵活性。过去,Elasticsearch 的 4,096 维上限限制了部分 Embedding 模型的使用;现在,快手可以在同一套基础设施上支持从 64 维到超过 10,000 维的向量,业务团队可以根据实际需求选择模型,不必再受原有检索引擎的维度限制。
存储与计算分离也改善了资源利用效率。需要提高查询吞吐量时,可以单独扩展计算资源;需要存储更多数据时,则可以按需增加存储容量。对于适合压缩或磁盘索引的业务,SQ8 和 DiskANN 还能进一步降低内存成本。
此外,基于 Resource Group 的同城三可用区部署,让平台具备了应对整个数据中心故障的能力——即使失去一个数据中心,搜索和写入服务仍然可以继续运行。
这些变化最终体现在业务团队的使用方式上。过去,每个业务可能需要单独考虑如何选型、部署和维护向量检索系统;现在,无论是视频去重、内容安全,还是新的 RAG、Agent 应用,只要需要向量检索服务,就可以直接向平台申请一个 Milvus 集群。向量检索由此成为快手内部一项可以按需获取的基础能力。
05 未来规划:持续优化 Milvus,探索 LakeBase 新架构
在完成大规模生产部署后,快手接下来的重点是进一步提高系统稳定性、降低资源成本,并将 Milvus 推广到更多业务场景。
此外,快手团队也在持续关注 Milvus 3.0 的架构演进,并规划逐步升级到生产环境的路径。其中,Milvus 3.0 的 LakeBase 能力是快手重点关注的方向之一。借助 LakeBase 的 S3 外表能力,可以将不同访问频次的数据分层存储(热数据用高性能存储、冷数据用对象存储),同时复用已有的离线数据,并逐步完善向量数据从写入、检索到归档的全生命周期管理。
除了继续优化内部平台,快手还计划进一步加强与 Milvus 开源社区的合作。快手数百亿条向量以及持续高并发的在线业务,让团队积累了大量大规模向量数据库的实践经验。未来,这些经验将转化为更多技术反馈和开源贡献,与社区共同推动 Milvus 的演进。
对向量数据库、RAG 及 AI 基础设施感兴趣的朋友,也欢迎在云栈社区与更多开发者一起交流讨论。
 发表于 5 小时前
|
查看: 2|
回复: 0
 /1


