一、动机
检索增强生成(Retrieval-Augmented Generation, RAG) 已经成为缓解大语言模型幻觉问题的重要方法。典型 RAG 系统会先将文档切分成 chunks,再使用关键词检索或语义向量检索找到与用户问题最相似的若干 chunks,最后把这些 chunks 拼接到 prompt 中供 LLM 生成答案。
但本文指出,现有语义检索式 RAG 存在三个核心问题:
-
检索结果容易同质化和冗余:语义相似度高的 chunks 往往围绕相近表述或局部主题,可能重复提供同一类信息,却漏掉多跳问答所需的关键事实。
-
chunks 之间缺少显式关系:直接按相似度排序拼接上下文,会把信息组织成孤立片段,无法表达实体、事件、关系之间的事实连接,限制了 LLM 的综合推理能力。
-
上下文组织方式粗糙:传统 RAG 通常把检索结果简单串联,既可能引入噪声,也可能让真正相关的信息分散在长上下文中,导致模型难以利用。
知识图谱(Knowledge Graph, KG) 天然以三元组(head entity, relation, tail entity)表示事实,并通过共享实体建立事实之间的连接。因此,本文希望用 KG 为 chunks 建立事实级关联:先用语义检索找到种子 chunks,再沿知识图谱扩展相关 chunks,最后按图结构组织成更连贯、更有信息密度的上下文。
二、贡献
本文的主要贡献有:
-
提出 KG2RAG 框架:将知识图谱引入 RAG 的检索增强流程,通过 chunk-KG 关联、KG 引导扩展和 KG 组织上下文,提升检索多样性与上下文连贯性。
-
设计图引导的 chunk expansion:以语义检索得到的 seed chunks 为起点,在知识图谱上做 m-hop 遍历,召回包含重叠实体或相关三元组的 chunks,补充语义检索可能遗漏的事实。
-
设计 KG-based context organization:使用图结构过滤冗余边,并将相关 chunks 组织成内部一致的段落,使输入给 LLM 的上下文更紧凑、更有结构。
-
构造 Shuffle-HotpotQA 变体:通过随机替换实体,降低 LLM 依赖训练语料中已有 Wikipedia 知识的可能性,更直接地评估 RAG 的真实作用。
-
实验验证有效性:在 HotpotQA、Shuffle-HotpotQA、MuSiQue、TriviaQA 等数据上,相比 Semantic RAG、Hybrid RAG、GraphRAG、LightRAG 等方法,在回答质量和检索质量上均取得更优结果。
三、方法
KG2RAG 的整体流程包含三个阶段:文档离线处理、KG 增强的 chunk 检索、KG 组织的上下文构建。
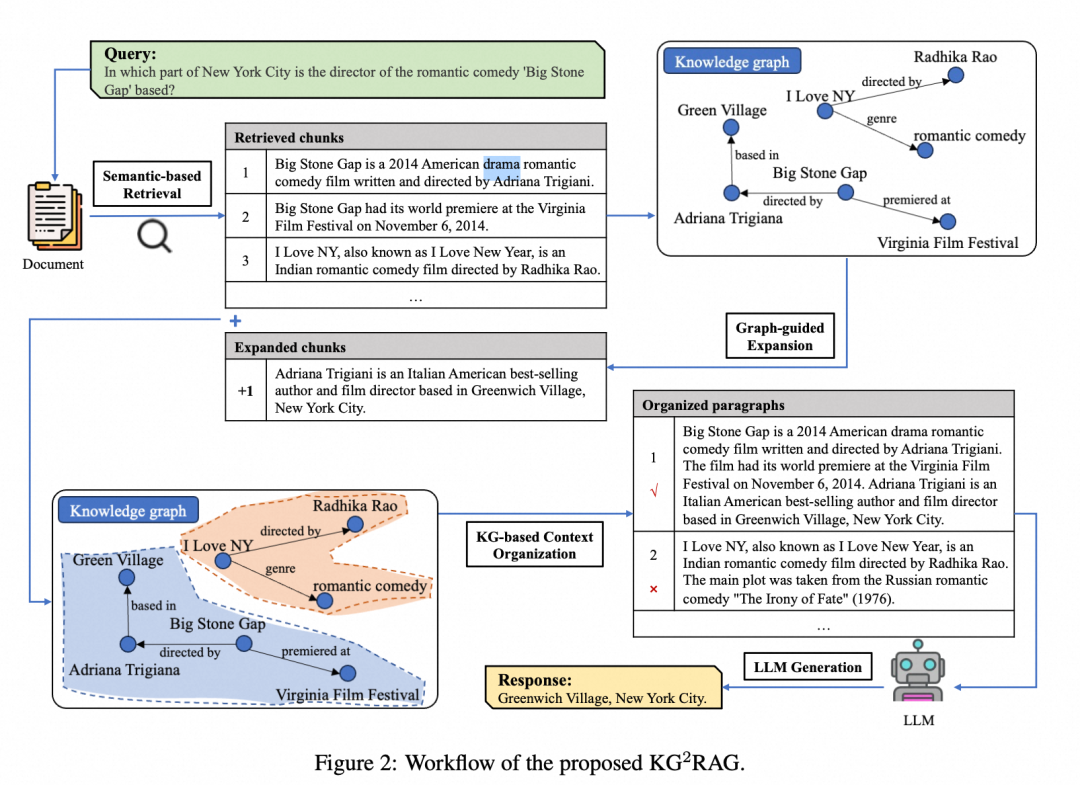
3.1 文档离线处理:建立 chunk-KG 关联
和标准 RAG 一样,系统首先把文档集合切分为 chunks:
D = {c1, c2, ..., cn}
为了捕捉 chunks 之间的事实级关系,KG2RAG 会为每个 chunk 抽取三元组,并记录三元组来自哪个 chunk,形成如下结构:
G = {(h, r, t, c) | c in D}
其中:
h 表示头实体;r 表示关系;t 表示尾实体;c 表示该三元组来源的 chunk。
如果已有外部知识图谱,可以通过实体识别、关系识别和实体链接完成 chunk-KG association。但为了避免依赖现成 KG,本文采用 LLM 从 chunks 中直接抽取实体和关系,构建任务相关 KG。论文使用 LLaMA3 进行三元组抽取,并给出固定 prompt,要求模型从文本中直接输出 <head, relation, tail> 格式的 informative triplets。
这个阶段是 query-independent 的,因此可以离线完成。新文档加入时,只需对新增文档做 chunking 和三元组抽取,支持增量更新。
3.2 KG-enhanced chunk retrieval:语义检索 + 图扩展
KG2RAG 的检索分为两步。
第一步:Semantic-based Retrieval
系统先计算用户问题 q 与所有 chunks 的语义相似度:
S = {s(q, c) | c in D}
其中 s(q, c) 由 embedding model 编码后计算 cosine similarity。随后选择相似度最高的 top-k chunks 作为初始检索结果 Dq。这些 chunks 在 KG2RAG 中被视为 seed chunks,不是最终上下文。
第二步:Graph-guided Expansion
仅靠语义检索得到的 seed chunks 可能缺少多跳问题中需要的连接信息。KG2RAG 会先取出 seed chunks 对应的子图:
Gq0 = {(h, r, t, c) | c in Dq}
然后在完整知识图谱 G 上,以该子图中的实体为起点做 m-hop 遍历,获得扩展子图:
Gqm = traverse(G, Gq0, m)
论文中 traverse 可用 BFS 实现。扩展完成后,系统读取扩展子图中所有三元组对应的 chunks,得到 expanded chunks:
Dqm = {c | (h, r, t, c) in Gqm}
这个设计和简单增大 top-k 或滑动窗口扩展不同:
- 增大 top-k 仍然依赖语义相似度,容易召回同质内容;
- 滑动窗口只利用文本物理相邻关系;
- KG-guided expansion 利用事实关系召回跨文档、跨段落的相关 chunks,更适合多跳问答。
3.3 KG-based context organization:过滤 + 排列
图扩展会提高召回,但也可能带来噪声和过多 chunks。因此,KG2RAG 在送入 LLM 前加入一个后处理模块,用 KG 结构组织上下文。该模块同时承担两个角色:filter 和 arranger。
作为 Filter:用最大生成树保留关键信息
系统首先计算 expanded chunks 与 query 的语义相似度,并把扩展子图转为无向加权图:
Umq = {(h <-> t, rel: r, src: c, weight: s(q, c)) | (h, r, t, c) in Gqm}
其中边权重来自 chunk 与 query 的语义相似度。由于图中可能存在多个连通分量,以及同一实体对之间可能有多条冗余边,KG2RAG 对每个连通分量生成最大生成树(Maximum Spanning Tree, MST):
Ti = MST(Bi)
这样可以保留更重要的实体连接,减少重复和低价值边。
作为 Arranger:用图结构组织成连贯段落
对每棵 MST,系统构造两种表示:
-
文本表示:选择权重最高的边作为 root,沿 DFS 顺序拼接边对应的 source chunks,形成较连贯的段落;
-
三元组表示:把 MST 中的边以 <h, r, t> 形式串联,作为结构化摘要。
随后,系统用 cross-encoder reranker 计算 query 与每棵 MST 的三元组表示之间的相关性:
R(q, Ti) = C(q, conc(Ti))
最后按相关性排序选择若干 MST 的文本表示,直到满足 top-k chunk 数量约束,再把这些组织好的段落和用户问题一起输入 LLM 生成答案。
这一步是 KG2RAG 的关键:它不是简单地“多召回一些材料”,而是把召回材料压缩成更相关、更少冗余、更有事实骨架的上下文。
3.4 训练与实现细节
本文方法整体不需要针对下游 QA 做模型训练,核心依赖以下组件:
- LLM:LLaMA3-8B,用于 KG 构建和最终回答生成;
- Embedding model:mxbai-embed-large,用于语义检索;
- Reranker:bge-reranker-large,用于 Hybrid RAG 和 KG2RAG 的 cross-encoder reranking;
- 默认 top-k:10;
- 默认图扩展 hop 数:m = 1。
四、实验
4.1 实验设置
数据集
主实验使用 HotpotQA。HotpotQA 是多跳问答数据集,适合评估检索结果能否覆盖多个相互关联的事实。论文使用两个设置:
- HotpotQA-Dist:distractor setting,每个问题提供 10 篇候选文档,其中包含支持答案的文档和干扰文档;
- HotpotQA-Full:fullwiki setting,需要从 66,581 篇 Wikipedia 文档中检索有用知识,检索难度更高。
为了降低 LLM 直接依赖预训练知识回答的可能性,论文还构造了:
- Shuffle-HotpotQA-Dist
- Shuffle-HotpotQA-Full
构造方式是:对每个实体,随机替换为同类别的另一个实体,并同步更新 queries、triplets 和 documents。例如把 Family Guy 替换为 Rick and Morty。这样模型不能只靠记忆中的 Wikipedia 知识回答,而必须依赖检索上下文。
KG 构建规模
论文对 HotpotQA 的 66,581 篇文档进行三元组抽取,得到:
- 211,356 个 triplets;
- 98,226 个 entities;
- 19,813 个 relations。
每个 triplet 都链接到其来源 chunk。论文还观察到每个 chunk/document 中的三元组数量呈长尾分布。
基线方法
本文比较了以下方法:
- LLM-only:不检索,直接让 LLM 回答;
- Semantic RAG:语义向量检索 top-k chunks 后直接拼接;
- Semantic RAG + Rerank:在语义检索后加入 reranker;
- Hybrid RAG:结合语义检索和关键词检索(如 BM25),再用 cross-encoder reranker 合并排序;
- LightRAG:轻量级图 RAG 方法,抽取实体关系并生成实体描述用于检索;
- GraphRAG:构建图索引和社区摘要,用于 query-focused summarization;
- KG2RAG:本文方法。
评估指标
论文从两个维度评估:
- Response Quality:生成答案与标准答案之间的 F1、Precision、Recall;
- Retrieval Quality:检索 chunks 与参考事实之间的 F1、Precision、Recall。
4.2 核心结果:回答质量
在四个 HotpotQA 设置上,KG2RAG 的回答质量均优于基线。
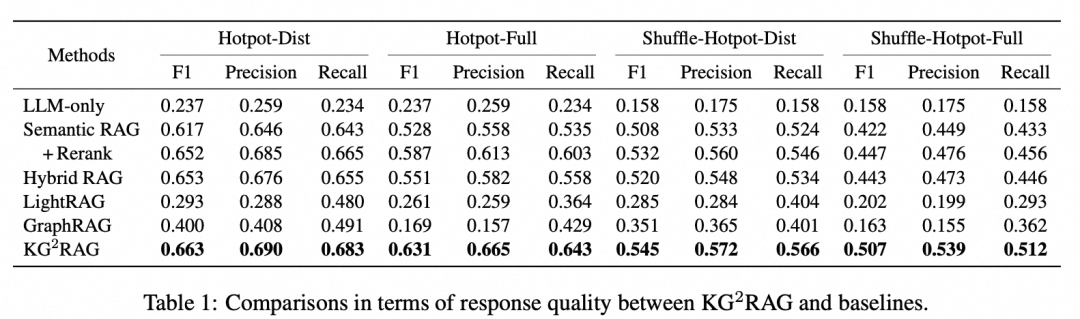
HotpotQA-Dist
- LLM-only:F1 = 0.237
- Semantic RAG:F1 = 0.617
- Semantic RAG + Rerank:F1 = 0.652
- Hybrid RAG:F1 = 0.653
- KG2RAG:F1 = 0.663
在干扰文档较少的场景,强 reranker 和 Hybrid RAG 已经较强,但 KG2RAG 仍取得最高 F1。
HotpotQA-Full
- Semantic RAG:F1 = 0.528
- Semantic RAG + Rerank:F1 = 0.587
- Hybrid RAG:F1 = 0.551
- KG2RAG:F1 = 0.631
Fullwiki setting 下,候选文档规模远大于 distractor setting,对检索和上下文组织要求更高。KG2RAG 相比最强基线提升明显,说明 KG-guided expansion 和 KG-based organization 在大规模检索空间中更有价值。
Shuffle-HotpotQA
在 Shuffle-HotpotQA-Dist 上:
- KG2RAG:F1 = 0.545
- 最强基线 + Rerank:F1 = 0.532
在 Shuffle-HotpotQA-Full 上:
- KG2RAG:F1 = 0.507
- 最强基线 + Rerank:F1 = 0.447
Shuffle 设置削弱了 LLM 依靠预训练记忆回答的能力,因此更能体现 RAG 的真实贡献。KG2RAG 在该设置下优势更明显。
4.3 核心结果:检索质量
检索质量方面,KG2RAG 在 precision 与 recall 之间取得了更好的平衡。
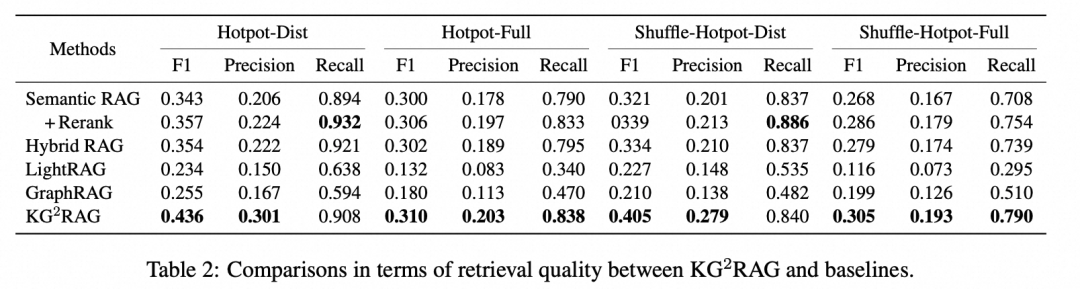
HotpotQA-Dist
- Semantic RAG:F1 = 0.343,Precision = 0.206,Recall = 0.894
- Semantic RAG + Rerank:F1 = 0.357,Precision = 0.224,Recall = 0.932
- Hybrid RAG:F1 = 0.354,Precision = 0.222,Recall = 0.921
- KG2RAG:F1 = 0.436,Precision = 0.301,Recall = 0.908
KG2RAG 的 recall 与基线相近,但 precision 显著更高,说明它不是盲目扩展,而是能更准确地保留相关 chunks。
Shuffle-HotpotQA-Full
- Semantic RAG:F1 = 0.268
- Semantic RAG + Rerank:F1 = 0.286
- Hybrid RAG:F1 = 0.279
- KG2RAG:F1 = 0.305
在最难的 Shuffle + Fullwiki 设置中,KG2RAG 仍取得最高 retrieval F1。
4.4 消融实验
论文在 HotpotQA-Dist 和 Shuffle-HotpotQA-Dist 上分别做了消融,验证两个关键模块的作用。
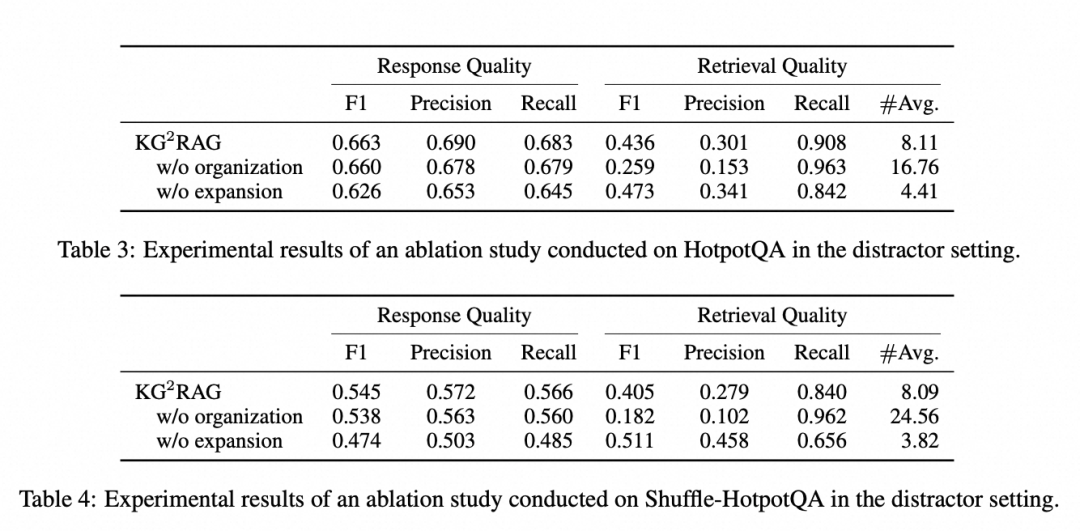
去掉 KG-based context organization
在 HotpotQA-Dist 上:
- KG2RAG:Response F1 = 0.663,Retrieval F1 = 0.436,平均 chunks = 8.11
- w/o organization:Response F1 = 0.660,Retrieval F1 = 0.259,平均 chunks = 16.76
去掉 context organization 后,回答质量接近,但检索质量大幅下降,平均输入 chunks 数量翻倍。这说明图扩展本身会带来更多候选信息,如果缺少组织和过滤,容易引入噪声并消耗 token。
去掉 KG-guided expansion
在 Shuffle-HotpotQA-Dist 上:
- KG2RAG:Response F1 = 0.545,Retrieval F1 = 0.405,平均 chunks = 8.09
- w/o expansion:Response F1 = 0.474,Retrieval F1 = 0.511,平均 chunks = 3.82
去掉 expansion 后,检索 precision 和 F1 可能更高,因为召回 chunks 更少、更保守;但回答质量明显下降,说明仅靠语义检索和组织无法覆盖多跳问题所需的关键事实。
这个结果很重要:检索质量指标高不一定代表最终回答更好。对多跳 QA 来说,扩展召回的事实覆盖度对生成答案非常关键。
4.5 超参数分析
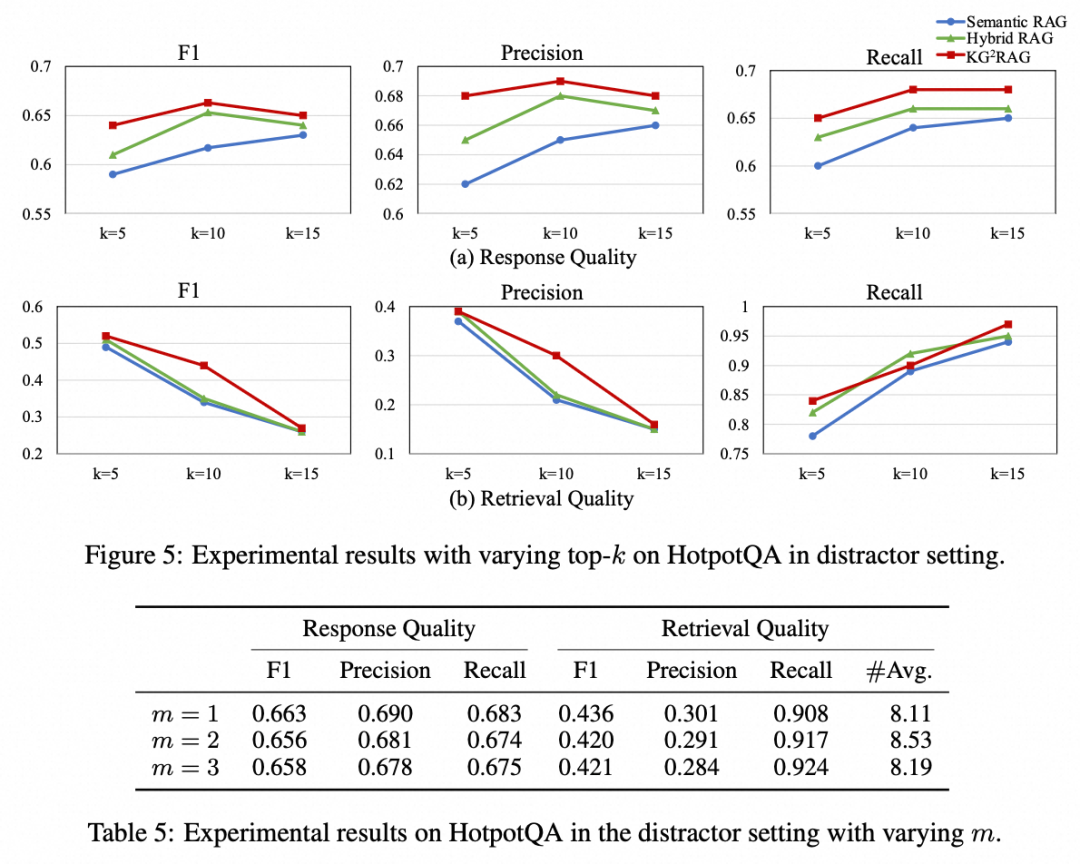
top-k 的影响
论文比较了 k = 5、10、15。结果显示,KG2RAG 在不同 k 下都优于 Semantic RAG 和 Hybrid RAG,并且对 k 的敏感性更低。
当 k 过大时,retrieval recall 可能提高,但 response quality 不一定提升,说明简单增加 chunks 数量不能保证更好的回答。有效的上下文组织比“多塞材料”更重要。
图扩展 hop 数 m 的影响
论文比较了 m = 1、2、3:
- m = 1:Response F1 = 0.663,Retrieval F1 = 0.436,平均 chunks = 8.11
- m = 2:Response F1 = 0.656,Retrieval F1 = 0.420,平均 chunks = 8.53
- m = 3:Response F1 = 0.658,Retrieval F1 = 0.421,平均 chunks = 8.19
结果表明 m = 1 已经足够,继续扩大 hop 不会带来明显收益,可能还会引入额外噪声。
4.6 鲁棒性与泛化实验
KG 质量受限时的鲁棒性
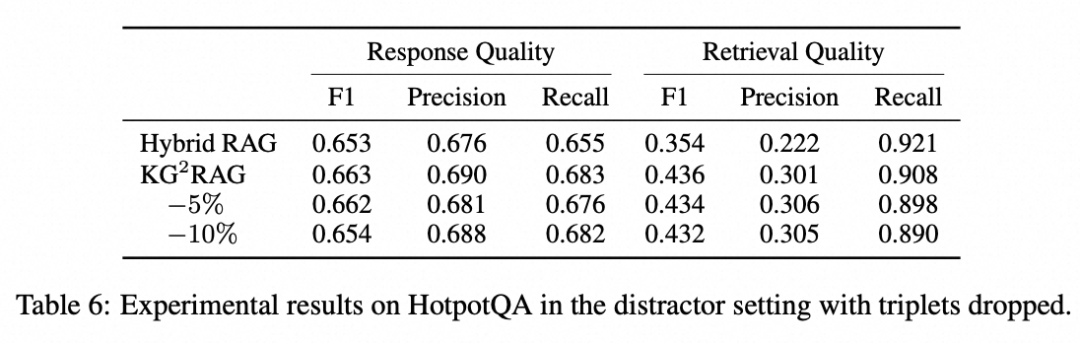
论文随机删除构建 KG 中 5% 或 10% 的 triplets:
- KG2RAG 原始:Response F1 = 0.663,Retrieval F1 = 0.436
- 删除 5% triplets:Response F1 = 0.662,Retrieval F1 = 0.434
- 删除 10% triplets:Response F1 = 0.654,Retrieval F1 = 0.432
即使 KG 有一定缺失,KG2RAG 仍优于 Hybrid RAG,说明方法对 KG 不完整具有一定鲁棒性。
更多数据集
论文附录还在 MuSiQue 和 TriviaQA 上验证泛化性。
MuSiQue 上:
- Semantic RAG:Response F1 = 0.367,Retrieval F1 = 0.365
- Semantic RAG + Rerank:Response F1 = 0.380,Retrieval F1 = 0.372
- Hybrid RAG:Response F1 = 0.380,Retrieval F1 = 0.364
- KG2RAG:Response F1 = 0.419,Retrieval F1 = 0.451
TriviaQA 上:
- Semantic RAG:Response F1 = 0.259
- Semantic RAG + Rerank:Response F1 = 0.265
- Hybrid RAG:Response F1 = 0.262
- KG2RAG:Response F1 = 0.273
这些结果说明 KG2RAG 不只适用于 HotpotQA,也能迁移到其他多跳或长上下文问答任务。
4.7 效率分析
和 GraphRAG、LightRAG 相比,KG2RAG 的 KG 构建成本更低。
单 chunk 平均 KG 构建成本:
- LightRAG:输入 1,269 tokens,输出 381 tokens,1 次 LLM 调用,约 3s;
- GraphRAG:输入 2,791 tokens,输出 629 tokens,5 次 LLM 调用,约 6s;
- KG2RAG:输入 561 tokens,输出 22 tokens,1 次 LLM 调用,约 1s。
单 query 平均检索与生成耗时:
- Semantic RAG:检索 21ms,生成 2500ms;
- LightRAG:检索 40ms,生成 5600ms;
- GraphRAG:检索 42ms,生成 5500ms;
- KG2RAG:检索 25ms,生成 2300ms。
KG2RAG 的效率接近 Semantic RAG,同时明显优于 GraphRAG 和 LightRAG。这主要因为它不需要复杂社区摘要生成,也不会在查询时调用多轮图摘要流程。
五、局限
本文也明确指出,KG2RAG 只优化 RAG 系统中的 retrieval optimization 部分,没有覆盖完整 RAG pipeline 的所有环节。例如:
- 没有专门优化 query rewriting;
- 没有处理多轮对话中的上下文追踪;
- 没有系统讨论不同 KG 构建质量对复杂业务场景的影响;
- 主要使用自动抽取 KG,三元组抽取错误仍可能影响后续图扩展和上下文组织。
不过,KG2RAG 与这些模块是正交的,可以作为 plug-and-play 的检索增强组件,与 query rewriting、reranking、multi-turn dialogue 等方法结合。
六、总结
本文提出的 KG2RAG 是一种面向 RAG 的知识图谱增强框架。它的核心思想不是把知识图谱直接塞进 prompt,而是利用 KG 为文本 chunks 建立事实级连接:先通过语义检索找到 seed chunks,再沿 KG 做图扩展召回相关事实,最后用最大生成树和 DFS 等图算法过滤并组织上下文。
从实验结果看,KG2RAG 的优势主要体现在三点:第一,它能补充语义检索遗漏的多跳事实;第二,它能减少简单扩展带来的冗余和噪声;第三,它能把检索结果组织成更连贯、更适合 LLM 使用的段落。在 HotpotQA-Full 和 Shuffle-HotpotQA-Full 这类更依赖检索质量的场景中,KG2RAG 的提升尤其明显。
这篇论文对实际 RAG 系统有较强启发:当问题需要跨文档、多实体、多跳推理时,单纯的向量相似度检索往往不够;把文本块之间的事实关系显式建模出来,再用于检索扩展和上下文组织,可能是比“加大 top-k”更有效的方向。
论文链接:https://aclanthology.org/2025.naacl-long.449/
发表会议:NAACL 2025
 发表于 5 小时前
|
查看: 5|
回复: 0
 /1


