其实,这个问题很典型——很多人一提到多Agent上下文共享,第一反应就是"搞个公共的地方存着",但真正要解决的问题比这复杂得多。
值得问自己一句:你共享的是"数据",还是"上下文"?这两件事不是一回事。
今天就把这个说清楚。
✦ ✦ ✦
单个 Agent 的上下文管理已经够头疼了。窗口长度有限,历史记录会被截断,模型还会遗忘早期细节。多 Agent 场景把这个问题乘以了 N。
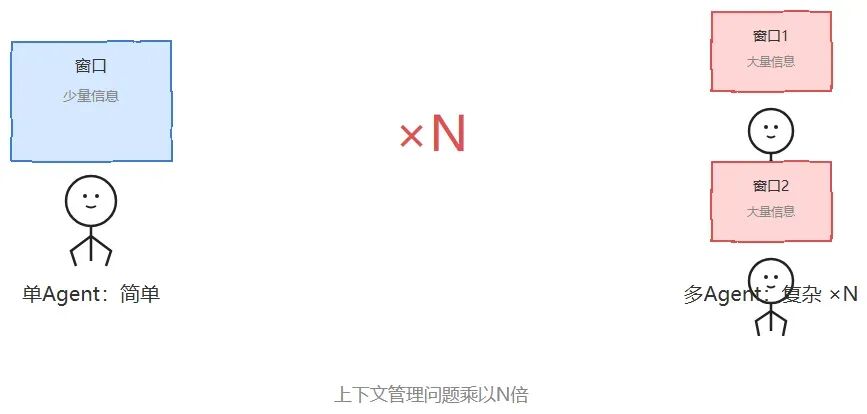
信息在谁手里,谁负责传递?没有统一的机制,信息传递全靠 Agent 之间口口相传。经过几轮转手之后,信息就失真了。
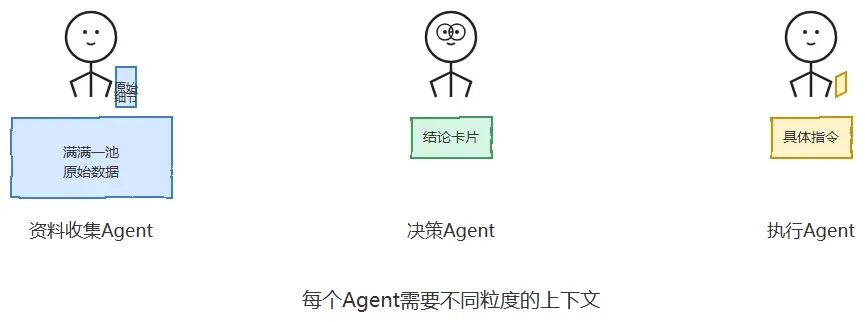
每个 Agent 需要的上下文粒度也不一样。资料收集 Agent 需要原始的细节,决策 Agent 只需要结论,执行 Agent 只需要具体的指令。全量塞给所有人既浪费 token,又引入噪声。
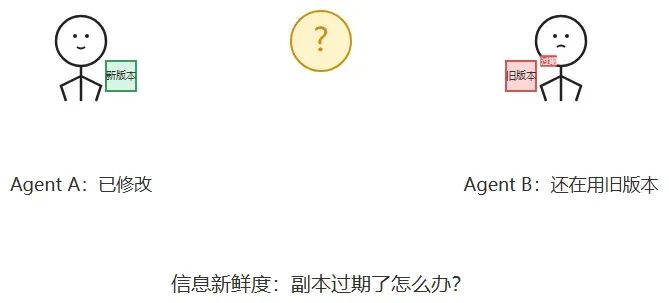
状态还会变。一个 Agent 修改了某个数据,其他 Agent 怎么知道呢?会不会用着过期信息继续干活?
谁说了算?当两个 Agent 对同一件事有冲突的认知时,以谁的上下文为准?
想清楚这几个问题,才能挑对方案。
✦ ✦ ✦
五种主流的上下文共享模式
1. 共享黑板模式(Blackboard Pattern)
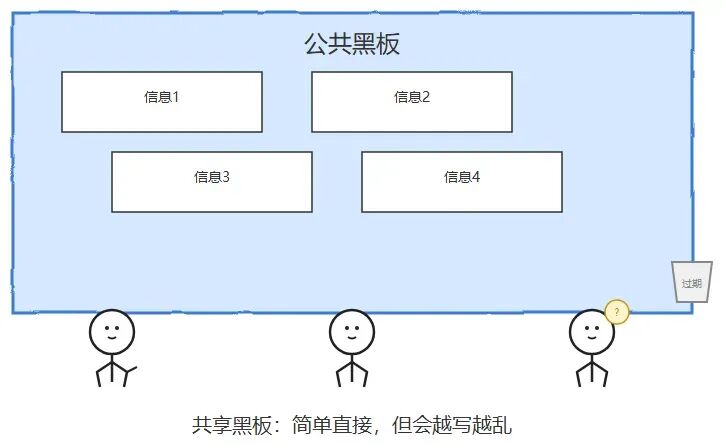
最经典的思路就是搞一块所有 Agent 都能读写的公共黑板。这块黑板可以是内存对象、Redis,或者一张数据库表。每个 Agent 完成一步,就把结果写到黑板上。需要信息的时候,就去黑板上查。
优点是简单直接,天然支持异步协作。缺点是黑板会越写越乱。如果没有清晰的命名空间和结构约定,后期就会变成一锅粥,谁也读不懂谁写的东西。
适合的场景是 Agent 数量不多,任务流程相对固定的系统。
2. 消息总线 / 事件驱动
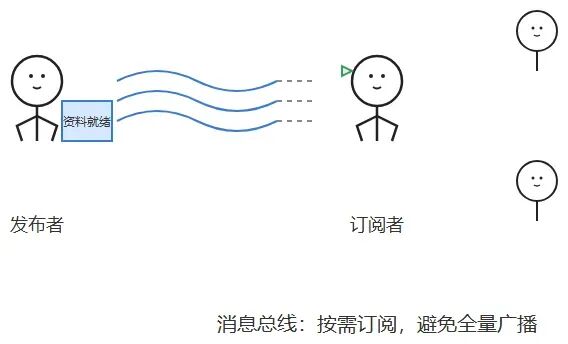
Agent 之间不直接共享一块地,而是通过发布订阅消息来传递上下文变化。比如资料 Agent 完成搜集之后,发布一条"资料就绪"事件,携带精简后的关键信息。写作 Agent 订阅这个事件,收到之后就开始工作。
这种方式解耦性更好,适合 Agent 数量多、协作关系复杂的系统。也天然支持"谁需要什么就订阅什么",避免了全量广播的浪费。代价是需要设计一套事件 schema,前期投入更大。
3. 集中式编排者(Orchestrator)模式
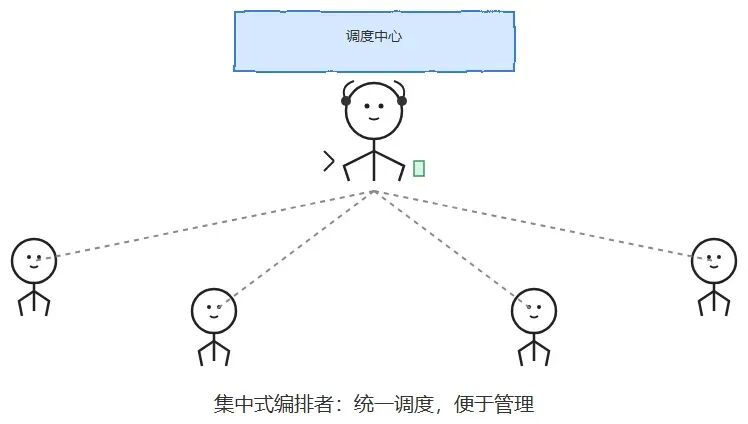
不让 Agent 之间直接对话,而是设一个总控 Agent 或者调度层。所有上下文流转都经过它。子 Agent 只和编排者打交道。编排者根据每个子任务的需要,裁剪、组装出恰好够用的上下文,然后再分发下去。
这是目前很多框架默认采用的思路,比如 LangGraph 的图结构、CrewAI 的 Manager 模式。因为它把"上下文该怎么传"这个复杂问题,收敛成了一个可以集中治理的地方,便于调试和加约束。
4. 结构化交接(Structured Handoff)
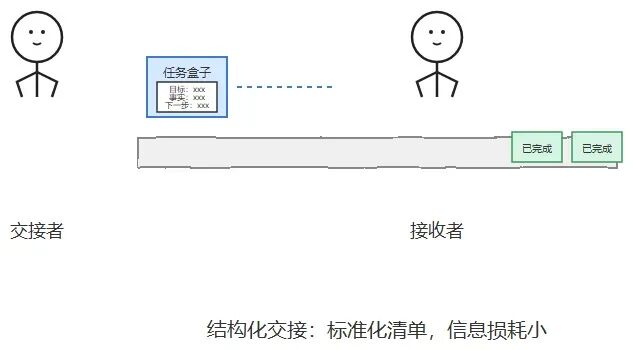
不追求共享全部,而是明确定义每次交接时该传什么。比如规定任何 Agent 把任务转交给下一个 Agent 时,必须附带一份标准化的任务摘要。这个摘要要说明目标是什么、已确认的事实是什么、还存在哪些不确定性、下一步该做什么。
这种做法本质上是把上下文压缩成一份结构化文档,而不是原始对话记录的堆砌。信息损耗小,而且方便人工审查和调试,是目前生产环境里比较推荐的做法。
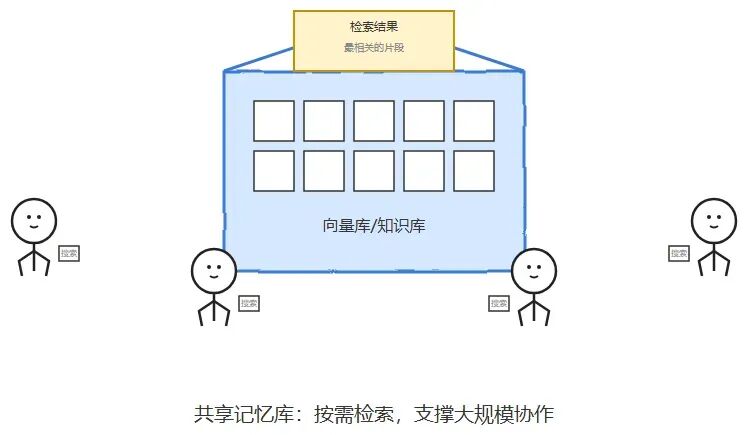
把所有 Agent 产生的关键信息统一存进一个向量库或者知识库。每个 Agent 在需要时通过检索获取相关片段,而不是被动接收全部历史。
好处是可以支撑长期、大规模的协作,上下文量再大也不怕。而且天然做到了按需取用。代价是检索质量直接决定协作质量。检索不准,Agent 就会用错误或过时的信息做决策。
✦ ✦ ✦
几个绕不开的坑
无论选哪种模式,以下问题都得提前想清楚。
信息新鲜度:某个 Agent 修改了共享状态,其他 Agent 手里的副本是不是已经过期了?需不需要版本号或者时间戳机制?
上下文瘦身:不是信息越多越好。给 Agent 塞太多无关上下文,反而会稀释它对关键信息的注意力,拖慢推理,增加出错概率。
冲突消解:多个 Agent 各自得出结论,谁的更可信?需要明确的仲裁规则,而不是让最后一个说话的 Agent 说了算。
可观测性:上下文在 Agent 之间流转的过程,最好是可记录、可回放的。不然出了问题根本没法排查是哪一步信息传丢了。
✦ ✦ ✦
一点建议
如果要给一句话建议,那就是先明确"谁需要知道什么",再决定"怎么共享"。
大多数团队一上来就想搞一个大而全的共享上下文池,结果每个 Agent 都在噪声里挣扎。更稳妥的路径反而是从结构化交接开始。先把每次协作节点该传递的最小信息集定义清楚,跑通了再考虑要不要升级到消息总线或共享记忆库这类更重的架构。
上下文管理,说到底考验的不是模型能力,而是系统设计的克制程度。这也是云栈社区里不少做多Agent工程的老哥反复聊到的一个共识:架构选型的本质,是学会在合适的地方做减法。
 发表于 昨天 19:21
|
查看: 13|
回复: 0
 /1


