这是云栈社区 ESP-Claw 源码剖析系列的第七篇。本章剖析 components/claw_modules/claw_memory,它把 Agent 的“记性”拆成三份生命周期完全不同的数据——会话历史、长期记忆条目、画像文档,分别回答“这一场对话说了什么”“这个用户是谁”“这台设备的 Agent 是谁”三个问题。
本章将逐文件精读真实源码,重点解释:会话历史如何用追加式日志加二进制索引在掉电后自愈、长期记忆如何只把标签目录注入上下文而把正文留给 memory_recall、请求门控在什么条件下拒绝服务、阶段注记如何把记忆变更透明地汇报给用户,以及这一切为什么是嵌入式约束(上下文窗口、Flash 写寿命、本地隐私)倒逼出来的设计。
本文结构:
- 记忆分层总览
- 会话历史:追加式日志与二进制索引
- 长期记忆:结构化条目与四文件联动
- provider 机制与两级检索
- 请求门控与阶段注记
- cap_session_mgr:会话管理暴露为 LLM 能力
- 设计动机:分层、写寿命与隐私
- 本章小结
1. 记忆分层总览:三份不同生命周期的数据
claw_memory 在 AGENTS.md 里的一句话定位是“session history、profile/long-term memory providers、memory persistence、request gating、stage notes”。拆开看,它同时是三个东西:四个 clawcore 上下文 provider(第4章《Agent核心设计》的 provider 契约在这里第一次被大规模使用)、一组 memory* LLM 能力(第5章《能力系统》的注册范型)、以及两个 claw_core 回调(请求门控与阶段注记)。本章先立坐标,再逐层下钻。
1.1 三层记忆与各自边界
所有可写数据都落在 DATA 根(第12章《板级适配与配置服务》里由 claw_paths 决定是 /fatfs 还是 SD 卡挂载点)。应用外壳在 app_claw.c 中用两条规则定下全部路径,从不硬编码 /fatfs:
claw_paths_join(CLAW_PATH_DATA, "sessions", paths->memory_session_root, ...)
claw_paths_join(CLAW_PATH_DATA, "memory", paths->memory_root_dir, ...)
三层记忆的真实边界如下表:
| 记忆层 |
落盘位置(DATA 根下) |
进入上下文的方式 |
生命周期 |
| 会话历史 |
sessions/s_<会话>_<哈希>.log 及 .idx、.blocked |
以 messages 形式注入,仅请求开始一次 |
随 /session new 创建、/session delete 删除,跨重启存活 |
| 长期记忆条目 |
memory/memory_records.jsonl 等四文件 |
仅标签目录进 system prompt,正文靠 memory_recall 按需取 |
跨会话,压实后最多保留 128 条 |
| 画像文档 |
memory/soul.md、identity.md、user.md |
全文注入 system prompt |
跨会话,仅用户显式要求时修改 |
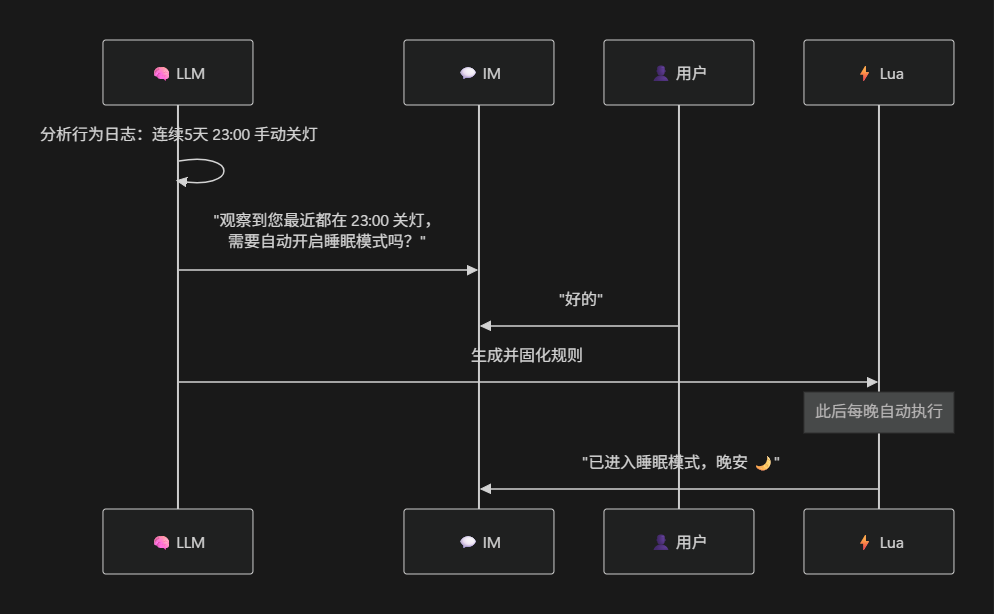
这张时序图展示了一个典型的记忆驱动行为:LLM 分析行为日志(连续 5 天 23:00 手动关灯),经 IM 向用户确认后生成并固化规则,随后每晚由 Lua 自动执行。分层的本质是“读写频率”分层:会话历史每轮都追加、增长最快,所以有最激进的尺寸熔断;画像几乎不变但每轮都要全文在场;长期记忆条目介于两者之间,靠“目录常驻、正文按需”控制注入量。
1.2 组件文件布局与运行时接线
claw_memory 的源码按职责切成八份:claw_memory.c 是长期记忆核心 API 与长期能力 provider,claw_memory_session.c(约 2100 行,组件内最大)管会话历史、门控、阶段注记与异步抽取,claw_memory_storage.c 管 JSONL 索引与压实,claw_memory_cap.c 把 store/recall/list/update/forget 包装成 LLM 能力,claw_memory_profile.c 管画像三文件,claw_memory_extract.c 是自动抽取的 LLM 提示与结果解析,claw_memory_lightweight.c 提供轻量 provider,claw_memory_utils.c 是共享工具。
接线发生在 app_claw.c 的 app_claw_fill_core_config:persist_context、request_gate、on_request_start、collect_stage_note 四个函数指针被填进 claw_core 配置,其中后两个仅在 CONFIG_APP_CLAW_MEMORY_MODE_FULL 下启用。同一个宏还决定长期记忆用哪个 provider——这是本章反复出现的双模式开关。
2. 会话历史:追加式日志与二进制索引
会话历史要回答的问题是:重启之后,Agent 如何零解析成本地找回“这场对话说到哪了”。
2.1 .log/.idx/.blocked 三件套
每个会话对应三个文件。数据文件名由 claw_memory_session_path_dup 生成:
return dup_printf("%s/s_%s_%08" PRIx32 ".log",
                  s_memory.session_root_dir,
                  safe_session_id[0] ? safe_session_id : "default",
                  hash);   /* 会话 ID 先净化再截断到 24 字符,哈希为 FNV-1a */
.log 里每条记录是一段 JSON 文本,类型对齐 claw_core 的四种记录(CLAW_CORE_CONTEXT_RECORD_USER/ASSISTANT_FINAL/ASSISTANT_TOOL/TOOL_RESULT)。旁边伴生一个二进制索引 .idx,条目只有 10 字节:
typedef struct {
    uint32_t offset;        /* 记录在 .log 中的字节偏移 */
    uint32_t length;        /* 记录字节长度 */
    uint8_t  record_type;   /* 用户/最终回复/工具调用/工具结果 */
    uint8_t  backend_format;/* OpenAI 或 Anthropic 消息格式 */
} __attribute__((packed)) claw_memory_session_index_entry_t;

_Static_assert(sizeof(claw_memory_session_index_entry_t) == 10,
    "session history index entry must contain only offset, length, type, and backend format");
为什么在 FATFS 上再自建索引?因为读取历史时不需要逐行解析整个 JSON 日志,按 offset/length 直接 fseek 取记录即可;索引头部带 CHDX 魔数、版本号与条目尺寸三重校验(session_history_index_header_valid),任何一项不符即判定索引与数据不配套。backend_format 记录每条消息当初属于哪种后端协议,重放历史时无需猜测格式。第三个文件 .blocked 是内容为空的封锁标记,只看存在性。
写入路径是 claw_memory_persist_context_callback:claw_core 每轮提交一个 claw_core_context_persist_batch_t 批次,回调把记录逐条追加进 .log 并同步追加索引条目——两处都是纯追加,没有任何原地改写。
2.2 会话内压实与 150KB 熔断
追加式日志必然增长,claw_memory 用“先压后封”两段式处理。每轮结束(batch->turn_completed)时检查:
static esp_err_t session_history_compact_if_needed(...)
{
    if (file_size_bytes(data_path) <= CLAW_MEMORY_SESSION_SIZE_LIMIT) {
        return ESP_OK;                                  /* 150KB 以内不动作 */
    }
    err = session_history_validate_pair(data_path, idx_path, &index);
    if (err != ESP_OK) {                                /* 索引失配:直接重建空文件 */
        return session_history_recreate_file(data_path, idx_path);
    }
    return session_history_rewrite_compacted(session_id, request, data_path, idx_path, &index);
}
压实算法在 session_history_analyze_turns 与 session_history_compact_keep_record 中:以每条 USER 记录为界把日志切成“轮次”,USER 与 ASSISTANT_FINAL 永远保留;工具调用与工具结果只保留最近一个带工具的完整轮次(CLAW_MEMORY_SESSION_COMPACT_TOOL_TURNS 为 1);尚未完成的尾部轮次整体保留。也就是丢掉的是“中间轮次的工具过程”,保住的是“用户说了什么、Agent 最终答了什么”。
若重写后仍然超限,session_history_rewrite_compacted 会创建 .blocked 标记并通过 claw_core_publish_stage_text 向用户推送 CLAW_MEMORY_SESSION_SIZE_WARNING,提示用 /session new [name] 开新会话、/session delete <name> 删旧会话。这个提示与第6节的 session_command 能力严丝合缝地闭环。
2.3 会话历史 provider 的注入方式
claw_memory_session_history_provider 的 collect 实现(claw_memory_session_history_collect)从三件套读出历史,输出 CLAW_CORE_CONTEXT_KIND_MESSAGES;两个细节值得注意。其一,provider 挂着 CLAW_CORE_CONTEXT_PROVIDER_FLAG_REQUEST_START_ONLY 标志——历史只在请求开始收集一次,工具循环的后续迭代不再重读,既避免磁盘反复读,也避免正在生成的中间轮次与磁盘历史重复拼接。其二,历史为空时返回 ESP_ERR_NOT_FOUND 而不是空数组,让 claw_core 干脆跳过这个 provider。会话文本在写入前经 claw_memory_normalize_session_text 归一化,单条上限 max_message_chars(应用配置 4096 字符),UTF-8 按字符截断不切坏多字节序列。
3. 长期记忆:结构化条目与四文件联动
长期记忆是跨会话的“用户知识库”,它的设计核心是:条目定长、文件分工、追加优先。
3.1 claw_memory_item_t:定长字段的设计
一条记忆就是一个纯定长结构体,没有任何堆指针:
typedef struct {
    char     id[40];             /* 条目 ID,由 claw_memory_make_id 生成 */
    char     source[16];         /* manual=LLM 工具写入,auto=后台自动抽取 */
    char     content[256];       /* 归一化记忆正文,上限 256 字符 */
    uint16_t summary_ids[3];     /* 所属摘要标签 ID,最多 3 个 */
    uint8_t  summary_id_count;
    char     tags[96];           /* 检索标签 */
    char     keywords[128];      /* 关键词 */
    uint32_t created_at;
    uint32_t updated_at;
    uint16_t access_count;       /* 被 recall 命中次数,参与优先级排序 */
    uint8_t  deleted;            /* 软删除墓碑 */
} claw_memory_item_t;
为什么坚持定长?因为条目要在 claw_memory_item_list_t 动态数组里整块拷贝、排序、去重,定长结构体让所有操作都是 memcpy 级别,内存用量也可预测。代价是 content 上限 256 字符——但长期记忆本来就该存“归一化事实”而非原文,memory_ops 技能的硬规则明确要求“写归一化事实,不写用户原话”。deleted 是软删除:遗忘一条记忆只是在日志里追加一条墓碑记录,从不改写旧记录。
3.2 写入管线:去重与幂等
claw_memory_store_with_result 背后的 claw_memory_store_prepared_item_internal 是一条严谨的管线:修剪空白、归一化元数据、补默认 source、生成 ID,然后做两级去重——先比 claw_memory_build_item_key 生成的键(内容与标签的规范化摘要),再调 claw_memory_items_semantically_match 做语义等价判断;命中任一者就复用已有 ID 并把 out_changed 置 false 直接返回。这保证了 LLM 重复调用 memory_store 不会堆出重复条目,也让“这轮到底改没改记忆”有了一个布尔答案——阶段注记(第5.2节)正是消费这个答案。真正的新条目才会走完“追加 JSONL 记录、更新索引标签统计、重建关键词索引、保存索引、同步 MEMORY.md、追加 digest 行”的全链路。
3.3 记录、索引、摘要与导出的联动
memory 目录下四个文件各司其职:memory_records.jsonl 是追加式事件日志,每行一条完整条目快照,例如:
{"id":"...","source":"manual","content":"The user's profession is a programmer","tags":"profession","keywords":"profession,job","created_at":1760000000,"updated_at":1760000000,"access_count":0,"deleted":false,"summary_ids":[7]}
memory_index.json(版本 3)维护摘要标签目录(label 到 summary_id 的映射及引用计数)与关键词倒排索引;memory_digest.log 追加记录每次 store/forget/recall 动作;MEMORY.md 是全部活跃条目的 Markdown 渲染导出,既给轻量模式当注入源,也方便用户直接查看。
claw_memory_recall 的流程是:把请求里的 summary_labels 解析成 summary_id,过滤软删条目,按 claw_memory_sort_by_priority_desc 排序(访问次数与新鲜度加权),截断到 limit(默认 8)后渲染 JSON。最巧的一笔是 recall 的副作用处理:命中条目不回写 jsonl,只往 digest 追加一行 access_count+1,等压实时由 claw_memory_apply_digest_recall_deltas 依据 last_compact_digest_size 偏移回放增量——读路径完全零改写。
压实的触发条件是双阈值:
esp_err_t claw_memory_maybe_compact(void)
{
    if (s_memory.write_changes_since_compact >= CLAW_MEMORY_COMPACT_CHANGE_THRESHOLD ||
        file_size_bytes(s_memory.records_path) >= CLAW_MEMORY_COMPACT_SIZE_THRESHOLD) {
        return claw_memory_compact_internal(true);  /* 5 次变更或 32KB 触发 */
    }
    return ESP_OK;
}
claw_memory_compact_internal 重放整个 jsonl:跳过墓碑、按键合并重复项(保留更高的 access_count 与更新的内容)、按容量分(access_count 乘 3 加时间项)裁剪到 CLAW_MEMORY_MAX_ACTIVE_ITEMS(128 条),最后整体重写记录、索引与 Markdown。启动时 claw_memory_init 也会以 append_digest=false 跑一次,把上次掉电残留的日志收敛干净。
3.4 画像层:soul.md、identity.md 与 user.md
画像是最简单也最常驻的一层。claw_memory_profile_init_defaults 在 memory 目录确保三个文件存在,默认内容就是可填空的模板(soul 是 Agent 的价值观与交互风格,identity 是名片式清单,user 是用户长期偏好)。设备出厂时这三个文件的种子放在只读 SYSTEM 镜像的 /system/.recovery/memory/ 下,首次启动才复制进 DATA——恢复机制与路由规则、技能目录共享同一套 .recovery 约定。
claw_memory_profile_provider 的 collect 把三份非空文件拼成一段 system prompt,格式为“标题(文件路径):内容”。注意这一层的修改不走 memory_* 能力,而是走普通文件能力:profile_memory_ops 技能声明自己依赖 cap_files 能力组,指导 LLM 用 read_file/edit_file 直接编辑这三个 Markdown 文件——画像被当作“持久的提示词文档”而非结构化记忆条目,这是有意的分野。
4. provider 机制与两级检索
claw_memory 是 claw_core provider 契约(第4章 4.1 节)最重的使用方:它一次注册了三个(外加一个轻量备选)。
4.1 四个 provider 与 FULL/LITE 模式
四个 provider 的差异一目了然:
| provider |
name 字段 |
kind |
注入内容 |
claw_memory_profile_provider |
Editable Profile Memory |
system prompt |
画像三文件全文 |
claw_memory_long_term_provider |
Long-term Memory |
system prompt |
使用规则前导加标签目录 |
claw_memory_long_term_lightweight_provider |
Long-term Memory |
system prompt |
整份 MEMORY.md |
claw_memory_session_history_provider |
Session History |
messages |
会话历史(仅请求开始) |
应用层的选择逻辑只有几行:
claw_core_context_provider_t base_providers[] = {
    claw_memory_profile_provider,
#if CONFIG_APP_CLAW_MEMORY_MODE_FULL
    claw_memory_long_term_provider,              /* 只注入标签目录 */
#else
    claw_memory_long_term_lightweight_provider,  /* 整份 MEMORY.md 直接注入 */
#endif
    claw_memory_session_history_provider,
    claw_skill_skills_list_provider,             /* 技能目录,见第8章 */
};
LITE 模式牺牲检索精度换取零额外 LLM 调用——适合小模型或低频设备;FULL 模式则实现了完整的两级检索。
4.2 为什么只注入标签目录
FULL 模式的 claw_memory_long_term_collect 注入的不是记忆正文,而是一段很长的英文使用规则加“Summary label catalog”清单,正文里只有类似 - dietary_preferences 的标签行。前导第一句就挑明动机:“The auto-injected long-term memory context only contains summary labels, not full memory bodies.”
原因有三:上下文窗口与 token 成本(128 条记忆全文远超标签目录)、召回精度(按需 recall 比全文淹没更准)、以及防幻觉(标签必须逐字复制自目录,memory_recall 侧还有二次校验——cap_memory_find_invalid_summary_label 发现编造的标签时返回 invalid_summary_labels 错误并附上 available_summary_labels 合法清单,LLM 可以自我纠正)。这正是 RAG 的“目录先行、正文按需”两级形态,只是检索索引是 LLM 自己维护的标签目录,而非向量库——嵌入式端没有余量跑 embedding。
5. 请求门控与阶段注记
claw_core 为记忆系统留了两个特殊回调位:request_gate 在请求出队后、循环开始前裁决“这个请求要不要放行”;collect_stage_note 在每轮迭代结束时收集一条要推给用户的阶段注记。两者合起来构成记忆系统对请求生命周期的“前后夹持”。
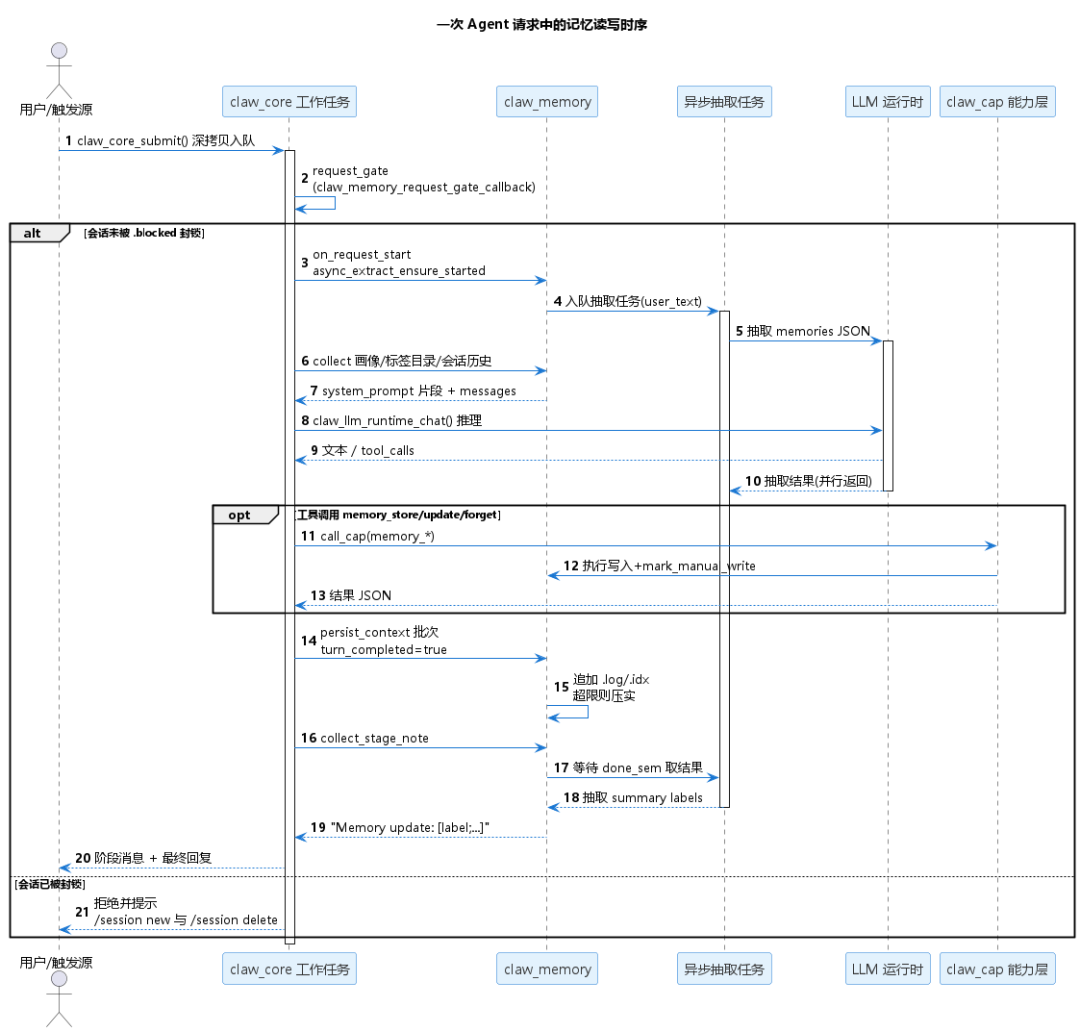
流程执行说明:
- 门控阶段(步骤 2-3)
claw_memory_request_gate_callback 只检查一件事:会话是否被 .blocked 标记封锁。- 未封锁则放行,进入正常 Agent Loop;已封锁则以
CLAW_MEMORY_SESSION_SIZE_WARNING 拒绝,用户被明确指引开新会话、删旧会话。
- 请求启动阶段(步骤 4-5)
claw_memory_request_start_callback 唯一的动作是 claw_memory_async_extract_ensure_started:把 user_text 交给异步抽取任务,与主循环并行。- 抽取任务立刻向 LLM 发起“从这句话里提取值得长期记住的事实”的独立调用。
- 上下文构建阶段(步骤 6-7)
- claw_core 依次 collect 三个记忆 provider:画像全文、长期记忆标签目录(或 MEMORY.md)、会话历史 messages。
- 会话历史带
REQUEST_START_ONLY 标志,只在此刻读一次磁盘。
- 推理与工具阶段(步骤 8-14)
- LLM 返回最终回复或工具调用;
memory_store/memory_update/memory_forget 经 claw_cap 执行真实记忆写入,并通过 claw_memory_request_mark_manual_write 给本轮打上“手动写入”标记。
- 持久化与注记阶段(步骤 15-19)
claw_memory_persist_context_callback 以纯追加方式落盘本轮记录,超限则压实,仍超限则封锁会话。claw_memory_stage_note_callback 等待抽取任务完成(done_sem),合并手动写入与自动抽取的标签,产出“Memory update: [label1;label2]”注记,由 claw_core 以“🦞 [Round N]”前缀推给用户。
5.1 请求门控:唯一的拒绝条件
门控回调短得可以整段贴出:
esp_err_t claw_memory_request_gate_callback(const claw_core_request_t *request,
                                            char *reject_message,
                                            size_t reject_message_size,
                                            void *user_ctx)
{
    if (!request || !request->session_id || !request->session_id[0]) {
        return ESP_OK;                    /* 无会话上下文的请求一律放行 */
    }
    reject_message[0] = '\0';
    if (!session_history_session_blocked(request->session_id)) {
        return ESP_OK;                    /* 未封锁:直接通过 */
    }
    strlcpy(reject_message, CLAW_MEMORY_SESSION_SIZE_WARNING, reject_message_size);
    return ESP_ERR_INVALID_STATE;         /* 已封锁:带指引拒绝 */
}
值得品味的是它的保守性:门控不校验记忆模块健康度、不做配额、不碰 LLM 配置——唯一会拒绝的情形是“这个会话的磁盘已经救不回来了,继续写只会浪费所剩无几的存储”。拒绝消息本身是一句可执行的用户指引而非报错术语。fail-safe 方向也很明确:检查不了(无 session_id、未初始化)一律放行,记忆系统自己出问题绝不能把整个 Agent 拖死。
5.2 阶段注记:三个来源的合成
claw_memory_stage_note_callback 把本轮的记忆变更收敛成一句话,来源有三:本轮是否有手动写入(claw_memory_request_take_manual_write 消费 request_id 维度的标记)、能力层登记的待汇报标签(claw_memory_pending_summary_take_summary_list 按会话聚合)、异步抽取的结果。合成逻辑浓缩成五行:
manual_write = claw_memory_request_take_manual_write(request->request_id);
summary_list = claw_memory_pending_summary_take_summary_list(request->session_id);
async_summary = claw_memory_async_extract_take_summary_list(request, !manual_write);
line_list_merge_unique(&summary_list, async_summary);       /* 去重合并 */
*out_note = claw_memory_format_update_stage_note(summary_list);
/* 最终渲染为 "Memory update: [label1;label2]" */
注意第三个调用的参数 !manual_write:本轮若 LLM 已经显式调过 memory_* 工具,自动抽取的结果就被整体丢弃(apply_result 为 false 时直接 free 掉 LLM 文本),避免同一条事实被手动与自动重复写入。
注记的发布时机在 claw_core 侧:每轮迭代结束 claw_core_publish_stage_note_for_round 把它格式化成带轮次号与品牌前缀的阶段消息推给用户(第4章 9.2 节的阶段消息通道)。设计意图是透明性——用户能看见“设备刚才悄悄记了什么”,而 LLM 的系统提示又要求它不要在正文里解释记忆策略,汇报职责完全交给这条机器生成的注记,口径统一且不可被 LLM 润色美化。
5.3 异步自动抽取流水线
自动抽取是 FULL 模式的增值部分:用户随口说的“我中午必须睡一觉”不必等 LLM 决定要不要记,后台自动沉淀。实现是一个专职 FreeRTOS 任务(6KB 栈、优先级 5、队列深度 4),任务结构体 claw_memory_async_extract_job_t 携带 request_id、user_text、意图与完成信号量;过期任务由 60 秒一次的 claw_memory_async_extract_sweep_locked 清扫。
提示词在 claw_memory_extract.c 中构造:“Existing summary labels:”加现有目录与“Current user message:”,系统提示要求问题类、请求类消息一律返回空 {"memories":[]}、标签保持 1 到 2 个、最多产出 3 条(CLAW_MEMORY_AUTO_EXTRACT_MAX_ITEMS)。消息意图枚举 CLAW_MEMORY_MESSAGE_INTENT_FORGET/REPLACE 让“忘记我喜欢苹果”这类消息能触发替换或删除既有条目(claw_memory_replace_conflicting_items 仅在 REPLACE 意图下生效)。
有一个容易忽略的取舍:claw_memory_async_extract_take_summary_list 在阶段注记回调里以 portMAX_DELAY 等待 done_sem——即本轮收尾会被最慢的那条抽取调用拖住。透明性优先于收尾延迟,这是产品层面的主动选择;好在抽取与主推理并行启动,通常早已完成。
6. cap_session_mgr:会话管理暴露为 LLM 能力
会话本身也需要被 LLM(和用户)操作。components/claw_capabilities/cap_session_mgr 注册了单个能力 session_command,描述为“Handle consolidated /session chat commands”,解析 /session 后的子命令分发到 new、list、switch、delete 四种操作。
它与 claw_memory 的耦合点有两处:其一,应用外壳调用 cap_session_mgr_set_session_root_dir(paths.memory_session_root),让会话管理器与记忆系统共享同一个 sessions 目录;其二,cap_session_mgr_set_delete_session_handler 被接到 app_claw_delete_session_history——这个包装函数同时清理两份按会话存放的状态:claw_memory_delete_session_history 负责解链 .log、.idx、.blocked 三件套,另一半负责技能系统的会话激活状态(第8章《技能系统》的 session_state_root_dir 恰好也指向 memory_session_root)。
把会话管理做成 LLM 能力而非纯本地命令,意味着用户在 IM 里说“开个新会话”与敲 /session new 等价;而门控拒绝消息里引导的正是这套命令,形成“磁盘满了→封锁→指引→新会话→旧会话删除→磁盘回收”的完整闭环。
7. 设计动机:分层、写寿命与隐私
本章最后回到第一性原理:为什么一个 ESP32 上的 Agent 要把记忆做得这么细?
7.1 为什么不只留会话历史
如果只要“接着上次聊”,会话历史就够了。但三层各自解决会话历史解决不了的问题。
上下文窗口有限:每轮请求都要为全部注入内容付 token 与延迟,128 条记忆全文加几十轮对话根本塞不下,所以长期记忆必须“目录常驻、正文按需”,会话历史必须压实掉中间工具过程。跨会话复用:用户上周说的偏好要在下周的新会话里生效,只有长期记忆与画像跨 /session new 存活。角色稳定性:soul.md 让同一份固件刷出不同“性格”的设备,且用户可以自己改——这是把 prompt 工程的部分主权交给用户的机制化。
反过来,若只有长期记忆没有会话历史,Agent 每句话都要做检索判断,成本与错误率都不可接受;分层的实质是按“访问频率×注入成本”给数据排座位。
7.2 Flash 写寿命的账
NOR/NAND Flash 擦写块寿命有限,esp-claw 的对策在 claw_memory 里俯拾皆是:会话历史与记忆记录都是纯追加(append-only),追加永远落在文件尾部,FATFS 只需更新少量元数据;读路径零写入(recall 的访问计数只追加 digest 行,压实时统一回放);真正的重写只在阈值触发时发生(会话 150KB、记忆 32KB 或 5 次变更),且压实后文件显著缩小,写放大被摊薄。软删除墓碑同理:遗忘不擦旧数据,只在压实时统一回收。
启动时的一次 claw_memory_compact_internal(false) 则保证任何一次掉电留下的日志都能收敛到一致状态——配合索引的魔数与尺寸断言,整个持久化层的崩溃恢复不依赖任何事务机制,只依赖“追加可重放”这一条性质。
7.3 隐私优势的边界
“隐私不出设备”是 esp-claw 的卖点,其根基在存储侧确实成立:会话历史、记忆条目、digest、画像全部只落 DATA 根(片上 Flash 或 SD 卡),没有任何代码把 memory 目录上传;.recovery 种子也只在本地 SYSTEM 分区与 DATA 之间复制。
但诚实的说法是“数据主权在设备”而非“内容零出域”:标签目录、画像全文、被 recall 命中的记忆正文,都会按设计进入发往云端 LLM 的 prompt——这是 Agent 能工作的前提。分层的贡献在于把出域内容压到最小且可审计:用户翻一眼 MEMORY.md 就知道设备记了什么,memory_forget 删一条、/session delete 删一场,删除动作全部本地生效、立即彻底。相比云端托管记忆的方案,这里没有任何“服务端还留着一份”的灰色地带。
8. 本章小结
claw_memory 用约六千行 C 代码在单片机上实现了三层记忆:会话历史靠“.log 加二进制 .idx”的追加式日志跨重启存活,靠轮次感知的压实在 150KB 内自律,实在救不回就封锁并指引用户开新会话;长期记忆以定长条目为单元,四个文件分工(事件日志、标签与关键词索引、动作摘要、Markdown 导出),读路径零写入、双阈值压实、128 条容量分裁剪;画像三文件全文常驻 system prompt,把人格做成用户可编辑的文档。
对 clawcore,它暴露四个 provider 与四个回调;对 LLM,它注册五个 memory* 能力并配两个技能文档约束用法;对用户,它用阶段注记交代每一次记忆变更。下一章的技能系统将复用同样的套路——把“使用说明”做成 SKILL.md、把状态按会话落盘——并与本章共享 sessions 目录。
参考文献
[1] ESP-Claw 官方源码仓库:https://github.com/espressif/esp-claw
[2] ESP-IDF FATFS 文件系统文档:https://docs.espressif.com/projects/esp-idf/en/stable/esp32/api-reference/storage/fatfs.html
[3] ESP-IDF FreeRTOS 任务与队列文档:https://docs.espressif.com/projects/esp-idf/en/stable/esp32/api-reference/system/freertos.html
[4] cJSON 解析库:https://github.com/DaveGamble/cJSON
 发表于 4 小时前
|
查看: 5|
回复: 0
 /1


