上一篇聊页表,讲的是地址怎么翻译;这一篇聊地址空间怎么管。malloc 返回一个指针的时候,物理内存一个字节都还没申请,这场「先承诺后兑现」的把戏,就是虚拟内存管理的全部工作。
1. 全景介绍
每个进程启动时都拿到一份完整的地址空间地图:代码、数据、堆、栈,各自占据一段连续地址,彼此隔开。进程以为这些内存连续、独占、随取随有,实际上这三条假设全是假的——物理内存是共享的、碎片的、按需给的。
在「进程以为的」和「实际发生的」之间站着两个角色。页表负责翻译,上一篇讲过;虚拟内存管理负责合同,这一篇讲它。
内核把进程的地址空间切成一段一段的区间,每段记着起止地址和读写执行权限,也记着背后是文件还是匿名内存,这份记录叫 VMA。进程对内存的一切要求,都以 VMA 为准:访问了没有 VMA 背书的地址,会发生段错误;访问了有背书但还没兑现的地址,发生缺页中断,内核现场兑现申请。
malloc 就是一次登记。glibc 先看自己的空闲块够不够,不够就找内核要一段新地址,内核建一个 VMA 返回。物理页一个都没动。第一次往里写数据,CPU 查页表,抛缺页异常,在缺页异常中,内核这才从伙伴系统拿一个页填进去。所以写个小测试,malloc 1GB 之后立刻看 RSS,数字几乎没动,开始 memset 才涨,就是这个原因。
这套「先承诺后兑现」换来三样东西:
- 隔离:每个进程活在独立的地址空间里,谁也影响不到谁;
- 按需:申请了不用的内存不占物理资源;
- 超售:所有进程加起来承诺的内存可以超过物理总量,赌的就是它们不会同时用满(跟航空公司一个德行)。
第三样是最激进的,也是 OOM killer 存在的理由。
2. 实际情况
先说几个现象。
- RSS 比 VSS 小一大截,不是泄漏。VSS 是承诺的总量,RSS 是实际兑现的。
- RSS 加起来比物理内存大,也不是见错误。两个进程共享同一个 libc,那个库的页在两边 RSS 里各算一次,物理上只有一份。
- mmap 一个 2GB 的文件瞬间完成,没有拷贝发生。mmap 只是登记了一段地址说「这段映射到这个文件」,真正读的时候缺页,从页缓存搬。mmap 代价小,但是第一次访问代价高。
- major fault 和 minor fault 差一个数量级。minor 是内核里补个页就完事,major 要去磁盘读。性能分析里两者要单独定位。
- malloc 很少返回 NULL,不代表内存是无限的。overcommit 打开时,内核把承诺发出去,赌大家一起用不会用尽内存;用尽后就轮到 OOM killer 按分数杀进程。
3. 核心对象
| 对象 |
是什么 |
关键点 |
mm_struct |
进程整个地址空间的记录 |
持有 pgd(页表根)、区域统计、mmap 基址;fork 时复制 |
vm_area_struct |
一段地址区间的合同 |
vm_start 到 vm_end、读写执行权限、文件或匿名、私有或共享 |
| maple tree |
VMA 的索引结构 |
6.1 起取代红黑树加链表,读侧 RCU 无锁,查找更稳 |
VM_* 标志 |
合同的条款 |
VM_READ/VM_WRITE/VM_EXEC、VM_SHARED、VM_SEQ_READ 等 |
| 缺页异常入口 |
合同的执行者 |
查 VMA、判类型、补页、建 PTE,一条流水线 |
VMA 有个容易被忽略的性质:稀疏。地址空间按 64 位算大得离谱,一个进程的 VMA 通常只有几十上百个。mmap 一万个小文件就有一万个 VMA,查找和锁的压力全在这上面,maple tree 换掉红黑树就是为解决这个问题。
4. 整体模型
把一个进程的地址空间和它的 VMA 摆在一起看。
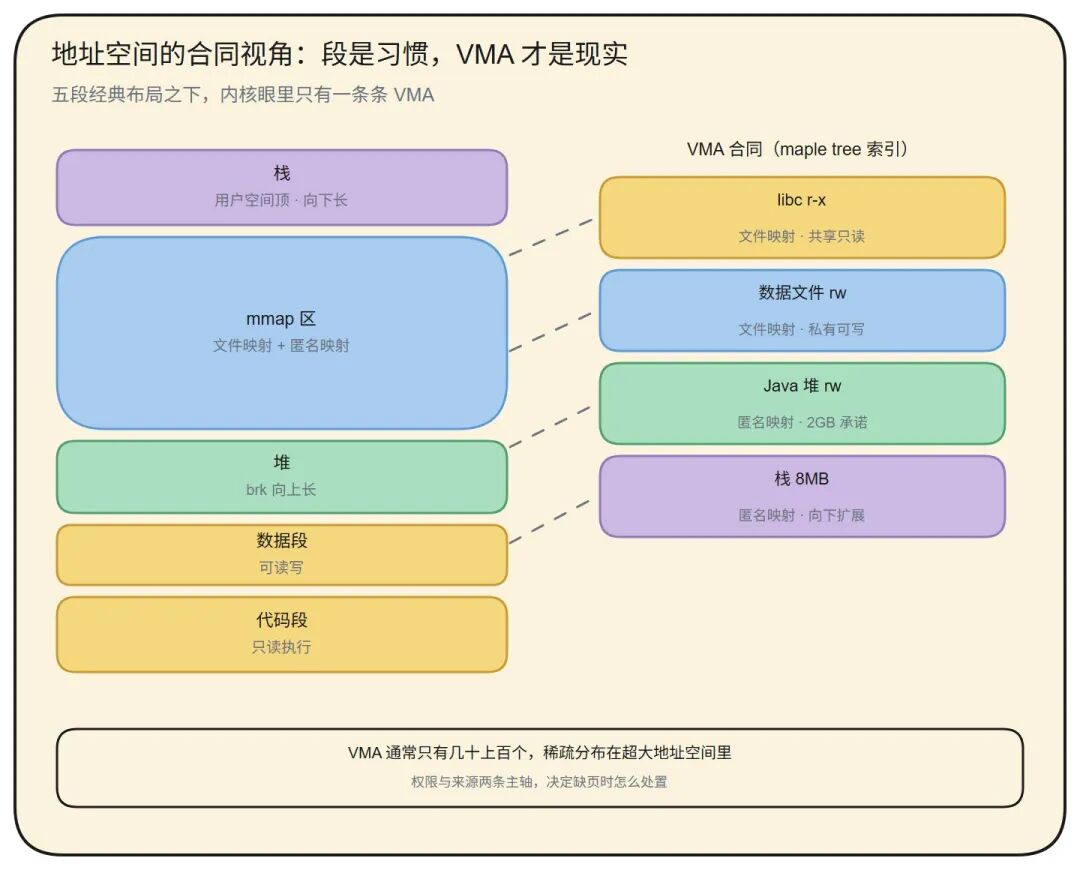
经典布局是五段:代码段和数据段在低处,堆往上涨,mmap 区在中间,栈在用户空间顶端往下长。但 VMA 视角下没有「段」,只有一条条独立的「合同」:同样是 mmap 区,libc 的映射是一段只读执行的文件映射,刚 mmap 的 2GB 数据文件是一段私有的文件映射,Java 堆是一大段匿名的读写映射。段的划分是编译器和链接器的习惯,内核眼里只有 VMA。
权限和来源是 VMA 的两条主轴。来源决定缺页时去哪拿数据:文件映射去页缓存,匿名映射找伙伴系统或 swap。权限决定怎么处置越界:写只读页和写没有 VMA 的地址都会抛异常,但内核的处理完全不同——前者可能触发 COW,后者直接 SIGSEGV。
5. 数据流
一次缺页的完整决策路径:
CPU 访问一个地址,页表无有效项,抛异常进内核。内核先拿地址查 VMA:查不到,说明这个地址从来没登记过,发 SIGSEGV,段错误。查到了,看权限对不对,往只读的合同上写,要么 COW 要么杀。都合法,再按状态分流:PTE 标着 swap entry 就换入,匿名页首次访问就分配,文件页就去页缓存,页缓存没有再发起 IO,这一下就是 major fault。补好页表,TLB 填上,重新执行那条指令。
6. 运行时流程
VMA 的生命周期贯穿进程始终。
进程创建时,fork 复制父进程的全部 VMA 和页表,写位清零,父子写时复制。谁先写谁缺页,内核补一张新页。fork 快的原因就在这——复制的是合同不是资产。
进程运行时,mmap 建合同,mprotect 改条款,madvise 递使用偏好,munmap 销毁。munmap 最贵:拆 VMA,拆区间内所有页表,再把 TLB 失效广播到每个核,上一篇写过这个成本。频繁 mmap/munmap 大块内存的程序,性能开销大头通常不在 mmap 本身,在收尾。
匿名页内存紧张时被回收,内容写进 swap,PTE 里只留一个条目。下次访问触发缺页,从 swap 换回。这一来一回的成本,就是 swappiness 调的赌注。
进程退出时,exit_mm 把整个地址空间连同 VMA、页表一起销毁,物理页归还伙伴系统,swap 条目释放。进程死了,合同清零,这就是地址空间隔离的最后保障。
7. 总结
理解虚拟内存管理,记住三条线:
-
承诺线:malloc 和 mmap 都只是登记合同,物理内存在第一次访问时才兑现。看占用用 RSS 和 PSS,VSS 是承诺不是消耗。
-
缺页线:缺页是机制不是故障,minor 和 major 差一个数量级。服务抖动先分缺页类型,再谈 IO。
-
合同线:VMA 决定一切——地址有没有登记、权限对不对、缺页去哪拿数据。进程对内存的所有疑问,都由异常路径按合同裁决。
|  发表于 4 小时前
|
查看: 7|
回复: 0
 /1


