Linux 7.4 合并窗口期间,ext4 接收了一个打磨了三年的重大补丁:把带页缓存的普通读写路径,从沿用多年的 buffer_head 切换到了 iomap。补丁作者在封面信中附上了测试数据,最亮眼的一项:1 MiB 写入从每秒 1404 MiB 提升到 2883 MiB,涨幅达到 105%。
ext4 是 Ubuntu、Debian 等众多发行版的默认文件系统,因此这个数字很容易让人联想到:只要升级内核,写文件就能快一倍。不过该功能默认处于关闭状态,需要手动添加挂载选项才能生效。为什么默认关闭?提速来自哪里?又牺牲了什么?我们得拆开来看。
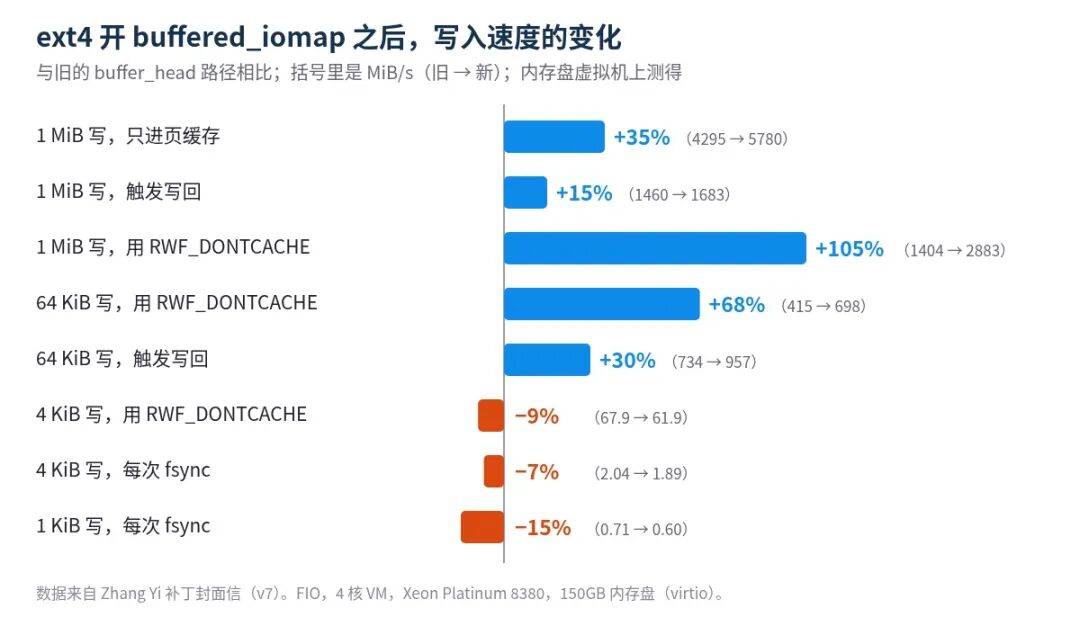
图 1 补丁封面信中的写入性能测试,蓝色为提升,红色为下降
数字从哪来
作者是华为的 Zhang Yi。测试使用 FIO 在一台 4 核虚拟机里进行,CPU 为 Xeon Platinum 8380,磁盘是 150GB 的内存盘(virtio 接口)。同一内核下,对比旧的 buffer_head 路径和新的 iomap 路径。
1 MiB 写入,只进页缓存的提升 35%,触发写回的提升 15%;64 KiB 写入,触发写回的提升 30%。+105% 和 +68% 这两项使用了 RWF_DONTCACHE 写入标志,意思是数据写完就尽快写回磁盘,不在页缓存里久留。
反过来,小块和同步写入有退步:4 KiB 的 DONTCACHE 写入慢了 9%;每次写完都 fsync(强制落盘)的,4 KiB 慢 7%,1 KiB 慢 15%。读测试一共 12 项,除了一项 +13% 之外,都在正负 6% 以内。封面信自己的结论也是:大块 I/O 写入明显更快,同步和不走缓存的小块 I/O 略有退步。
还有一点要留意:磁盘是内存盘,等于把硬件的速度拿掉了,测出来的是内核这一层的开销。换成真实的 SSD 或机械盘,差距多半会小得多。
快慢的差别,要从 ext4 记账的方式说起。
页缓存里的账本
写文件时,数据先落在内存里的页缓存,之后再批量写回磁盘。内核得记住:缓存里这块数据,对应磁盘上的哪个位置,有没有被改过。
旧办法是 buffer_head。页缓存里的一页(常见 4 KiB)如果按 1 KiB 的块分,就挂四个小结构,每个结构记着自己对应的磁盘块号、是脏的还是干净的。数据越多,这些小结构越多,占的内存和处理的次数也跟着涨。
新办法是 iomap,一套内核里通用的「文件范围 → 磁盘位置」映射框架。它不再一块一块挂结构,而是以文件范围为单位去问文件系统:这一段在磁盘上哪里?文件系统回答:从某个位置起,连续这么长。它还搭配 folio(内核里可以比一页更大的缓存单位),一次能处理更大的一块。
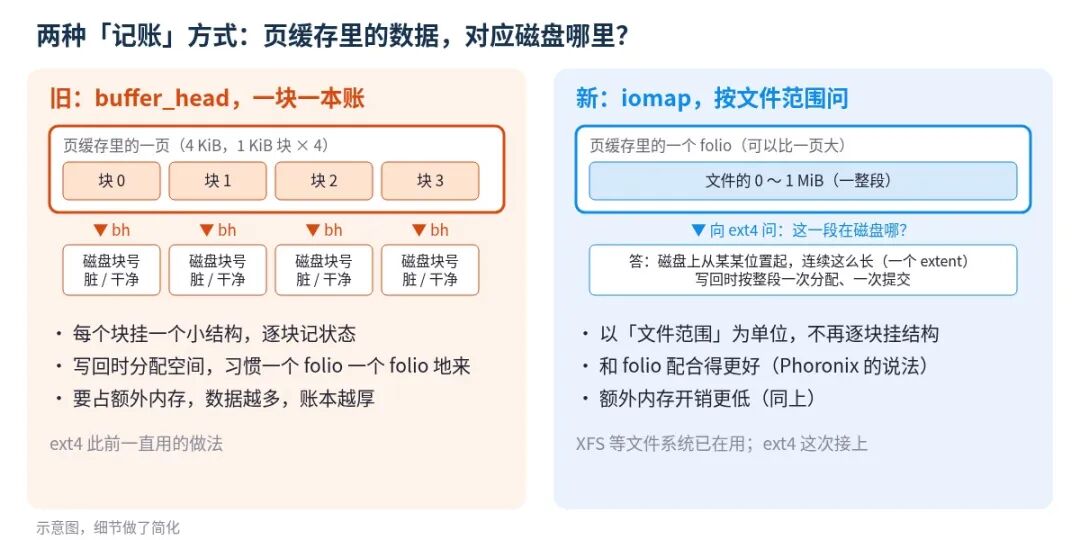
图 2 buffer_head 与 iomap 的记账方式对比(示意图,细节做了简化)
XFS 等文件系统早就在用 iomap,ext4 的直接 I/O 也已经走它,这次轮到带页缓存的缓冲 I/O。Phoronix 对它的概括是:和 folio 配合得更好,额外内存开销更低。
大块写入为什么更赚
我读了补丁的提交说明,找到两处和大块写入直接相关的改动。以下是我的理解,不是作者的原话。
第一处在写回。提交说明写道,块还没分配时,会按写回的长度和延迟分配的长度一次分下去,而不是一次只给一个 folio 分配。(延迟分配是 ext4 的老习惯:写进缓存时先不给磁盘位置,等真正写回时再统一分配。)写得越大,一次分配覆盖的范围越长,摊到每个字节上的开销越小。
第二处在写入。ext4 里有个 ext4_nonda_switch(),用来在磁盘快满时放弃延迟分配。以前每处理一个 folio 就调用一次,现在一次写入只调用一次。1 MiB 的写入,如果都是 4 KiB 的页,最多要处理 256 个,这里能省下不少调用。
小块写入没有这些好处,反而要多走几层新逻辑,所以 4 KiB、1 KiB 的同步写入慢了几个点到十几个点,也说得通。至于为什么 DONTCACHE 那一行涨幅最大,补丁里没有直接解释。我猜是它让每次写入后都马上走写回,写回路径的改进就被放大了,这只是推测。
为什么默认关着
Ted Ts'o 在合并请求里说得很明白:这个功能不默认开启,要加 buffered_iomap 挂载选项,因为这种模式还不支持在线碎片整理、内联数据、fsverity、fscrypt、非 extent 的老文件和 data=journal 模式。
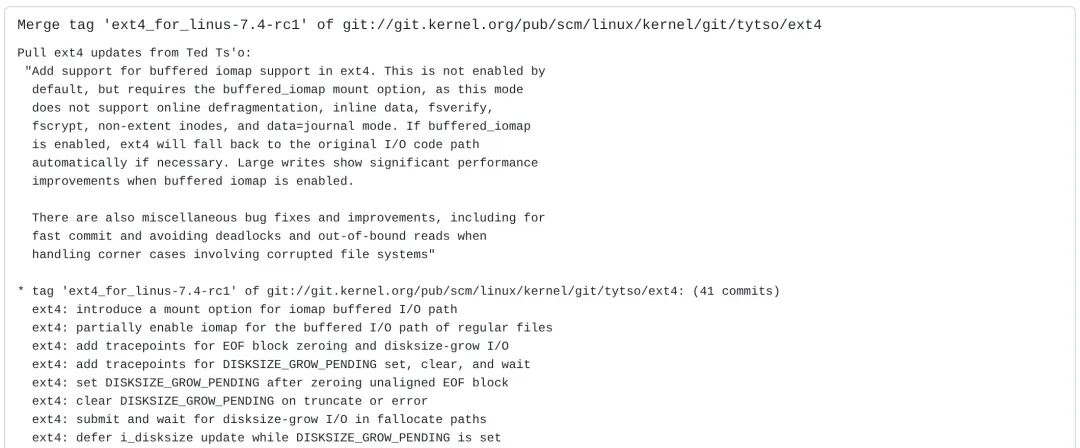
图 3 Linux 7.4 里 ext4 合并提交页(GitHub 截图):Ts'o 的说明,以及随后的提交列表
遇到这些不支持的情况,内核不会报错,而是悄悄退回老路。判断发生在 inode 初始化的时候:只要文件用了不支持的功能,这个文件就继续走 buffer_head。开关也可以通过 remount 切换,但不会立刻生效,要等 inode 重新读进内存之后。
所以哪怕加了选项,同一个文件系统里,也可能新旧两条路并存。
丢掉的 data=ordered
这组补丁里改得最狠的一处,是放弃了 data=ordered。
ext4 默认的日志模式叫 data=ordered:追加写文件时,先把新数据写到盘上,再提交记录这个文件变大了的元数据。这样即使中途断电,也不会出现「文件变大了,新增部分却是别人删掉的旧数据」的情况。
iomap 路径用不了它。提交说明给了两个原因:一是 iomap 里先锁 folio、再开日志事务,顺序和 buffer_head 路径正好相反,套上 data=ordered 会死锁;二是 iomap 的写回不支持只提交半个 folio,这在块比 folio 小的时候是 data=ordered 需要的,同样会死锁。
作者换了两套办法顶替它。
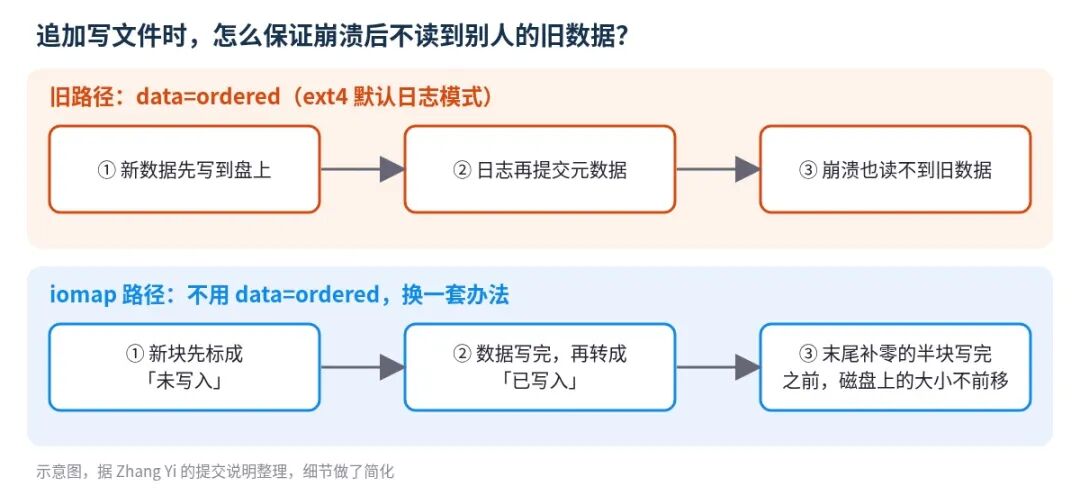
图 4 追加写时防止读到旧数据的两种做法(示意图,据提交说明整理,细节做了简化)
第一套是 unwritten extent(未写入区段)。新分配的块先标成「未写入」,读它只会得到零;等数据真的写完,再转成「已写入」。这等于总是开着 dioread_nolock 这个选项,它已经默认开了很多年。
第二套对付一个更细的情形:文件大小不是块大小的整数倍,在末尾追加写的时候,要先把最后那个半块里文件尾之后的部分补零。补完零,ext4 给这个 inode 打上 DISKSIZE_GROW_PENDING 标记,磁盘上记录的文件大小(i_disksize)暂时不往前推,等补零的那块写到盘上,才把它追到真正的大小。这个办法是 Jan Kara 建议的。
代价在提交说明里也写了:崩溃之后,文件大小可能已经更新,而新增那一段读出来是零。是零,不是别人的旧数据,作者认为这对不对齐的追加写可以接受,也没有打破 ext4 现有的保证。
三年,31 个补丁
这组补丁的第一版 RFC 在 2023 年 11 月发出,到这次合并,改到了第七版,一共 31 个补丁。封面信说,测试用 xfstests 跑了默认、fast_commit 和 64k 块三种配置,除了 generic/127 偶发失败之外,没有新的失败。generic/127 的问题出在内存管理里大 folio 的拆分,会另外修。第七版的一部分修复,来自 Sashiko 指出的问题,这是一个审查内核补丁的 AI 工具。
现在要不要管
对大多数人来说,暂时不用。Linux 7.4 预计年底前后才发布,发行版跟进还要再等一阵,默认配置也不会变。
想试的话,加上 buffered_iomap 挂载选项就行。但根据测试表,如果你的负载是数据库那种频繁 fsync 的小写入,开了不一定更快;大文件拷贝、日志写入这类大块写入,才是它擅长的。真机 SSD 上的表现,还得等更多人测。
参考信息:
 发表于 4 小时前
|
查看: 7|
回复: 0
 /1


