用通用代码 Agent 写业务系统,很多开发者已经轻车熟路。可一旦把它切换到生物信息、药物分子筛选或临床试验数据检索,翻车几乎是常态。
表面看,大模型能输出语法完全正确的 Python 脚本;真正丢进环境一跑,问题就来了:编造不存在的数据库接口、混淆基因组版本号,甚至在没有任何数据校验的情况下推出离谱结论。
科学研究不是普通 CRUD,容错率极低。正因如此,K-Dense 开源的 Scientific Agent Skills(原 Claude Scientific Skills)能在 GitHub 拿下近 5 万颗星。它想通过开放标准,把散落在各学科里的专业规则注入通用智能体。
项目卡片
- 项目:scientific-agent-skills[1]
- 状态:v2.72.0 / 49k+ Stars / MIT 协议
- 一句话判断:用开放规范把 177 个专业科研工作流与 100+ 权威数据库检索契约打包进 Agent,把通用编程助手变成懂规矩的数字科研助理。
为什么通用模型做科研总是翻车?
通用大模型的确储备了海量通识知识,但面对科研流水线时,往往卡在三个要命的环节。
第一个瓶颈,是数据库接口幻觉与格式混乱。科研领域遍布权威数据库:PubChem、ChEMBL、UniProt、ClinicalTrials.gov……光是接口与标识符规则就足够复杂。常见事故是:模型给出的查询脚本看起来很专业,一跑端点全错;更隐蔽的是,它分不清 RefSeq 与 GenBank 的构建版本,下游分析从一开始就建立在错误数据上。
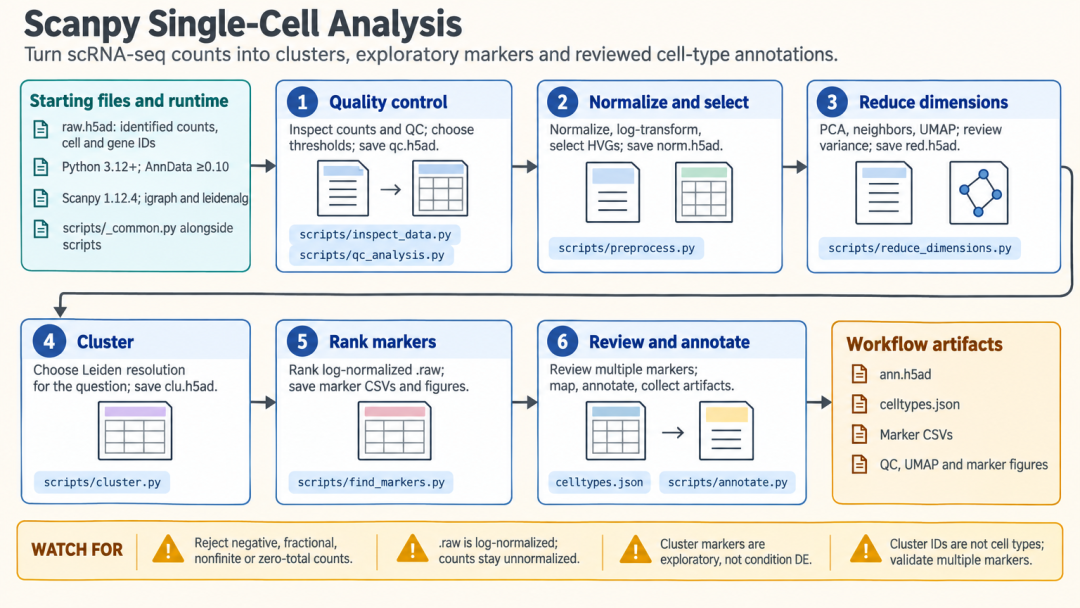
第二个瓶颈,是缺乏跨步骤的过程规约。拿单细胞 RNA 测序来说,数据加载、质控过滤、双胞剔除、差异表达分析、通路富集,每一步都有严格的参数门槛和版本依赖。通用模型没有整套工作流的最佳实践约束,代码看着连贯,实际常常漏掉关键质控步骤。
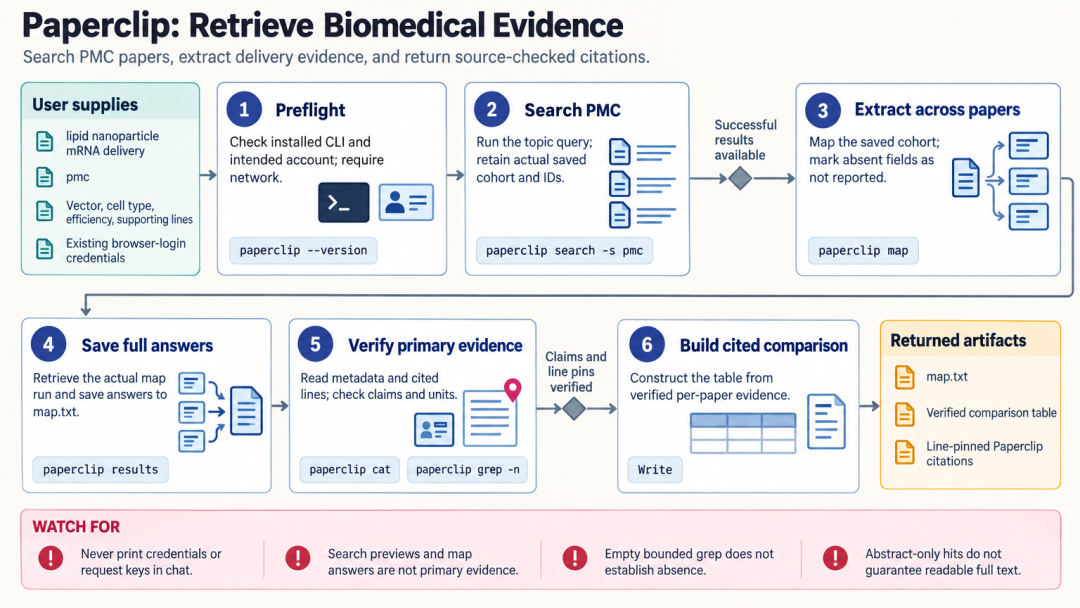
第三个瓶颈,是缺乏可审计的数据追溯。科研论文与实验报告要求结论具备完整证据链,但通用模型习惯输出一段顺滑的自然语言总结,说不出事实来自哪篇文献的哪一行,也拿不出具体接口响应。
177 个技能到底装了什么硬货
项目没有从头重训一个庞大的垂直领域模型,它选择把各学科已验证的科研工作流拆解并封装为开放标准的 Agent Skills。
目前仓库里收录了 177 个针对性技能,覆盖生物医药、材料模拟、物理仿真、实验自动化以及学术写作。
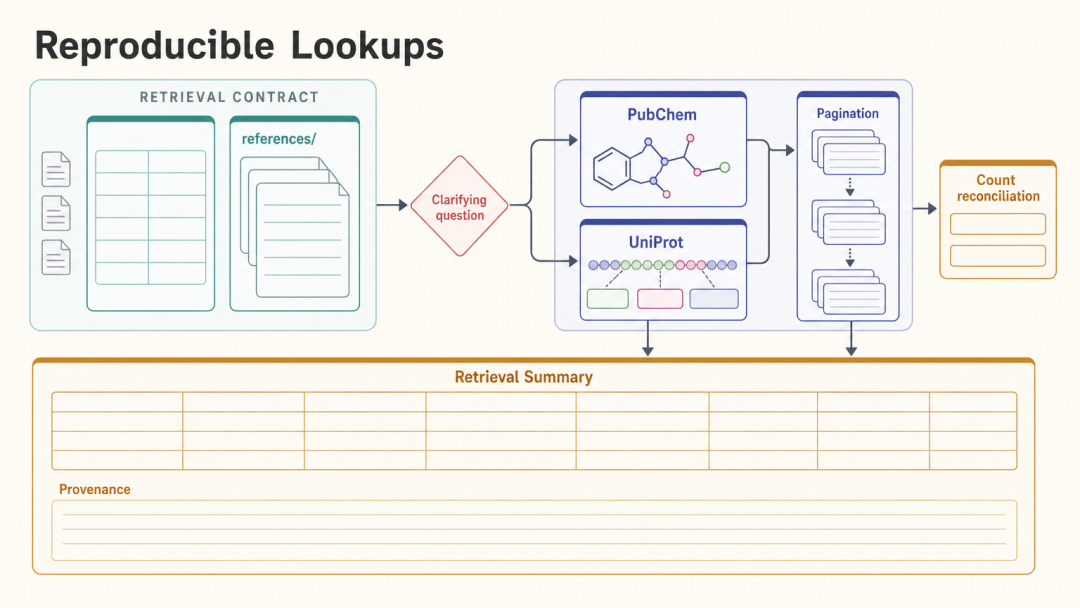
最核心的一块资产,是面向 100 多个权威数据库的结构化检索契约。以 database-lookup 为例,它不让智能体凭空猜测 API,而是强制执行检索三原则:先核对标识符类型、严格设置分页限流、对返回数量进行双向对账。即使接口返回空集,也必须如实记录,杜绝模型用脑补填平空白。
在具体计算与分析层面,仓库整理出 70 多个经过版本校准的 Python 生态技能。比如,化学信息学与分子对接方向的 RDKit、DiffDock;单细胞数据处理方向的 Scanpy、PyDESeq2;医学影像处理方向的 pydicom;以及电池循环建模用的 PyBaMM。每个技能都带独立 SKILL.md,写清版权、版本要求、工具权限和参考用例。
除了基础计算,项目还延伸到实验室自动化与科研交付。例如 Opentrons 技能生成移液工作站的执行脚本,Paperclip 对监管文件与论文做精确到行号的事实检索,甚至能自动生成符合学术规范的矢量示意图和演示幻灯片。
普通开发者怎么在本地三分钟跑起来
尽管项目起源于 Claude 生态,目前已经全面拥抱开放标准。无论你用的是 Cursor、Claude Code、Codex 还是 Google Antigravity,都能直接挂载使用。
如果你使用的是支持标准 Agent Skills 的终端客户端,只要在项目根目录运行这一条安装命令:
npx skills add K-Dense-AI/scientific-agent-skills
Cursor 用户则可以在本地插件目录创建软链接,重启窗口后就能在自定义面板中看到这批技能:
mkdir -p ~/.cursor/plugins/local
ln -s "/path/to/scientific-agent-skills" ~/.cursor/plugins/local/scientific-agent-skills
安装完成后,提示词不再需要写长篇大论的人设。只要在需求里自然提到目标即可:
请调用可用技能:从 ChEMBL 查询 IC50 < 50nM 的 EGFR 抑制剂,
使用 RDKit 分析构效关系,并检索 PubMed 相关文献生成结构化对比表。
当智能体识别到科研场景时,会自动调取对应技能文件,按文档规定的安全边界和 API 参数调用外部工具。
哪些场景好用,哪些红线绝对不能踩
实际使用中,有三条技术边界必须记牢。
第一条底线,不要一次性全量加载 177 个技能。我最初测试也试过全选,结果上下文瞬间被挤占,连做个简单分子转换,它都会去翻天体物理、地质等无关技能。合理用法是像搭积木:做化学分析只挂分子计算模块,做临床文献梳理只挂数据检索模块。
第二条底线,技能文件不等于运行环境。技能提供的是高价值过程知识、防御性校验和逻辑骨架,但它不会替你安装体积庞大的科学计算包。Scanpy、OpenMM 这类重型库,仍然需要你用 uv 或 Conda 提前备好独立、干净的虚拟环境。
第三条底线,科研辅助绝不能替代专业决策。项目在代码和安全规范里反复强调:临床报告、变异证据审查、药物动力学模拟等模块的产出,都只是带水印的研究草稿,仅供具备资质的专业人员核查,严禁直接作为诊疗决策或用药依据。
真正下场跑科研分析之前,先给智能体装上懂规矩的检索与校验契约,能帮你省去大半和虚假代码、幻觉数据死磕的弯路。
引用链接
[1] scientific-agent-skills
 发表于 昨天 23:27
|
查看: 9|
回复: 0
 /1


