上一篇收官时留了一套 Go 服务骨架。结尾那个 A/B 投票里,选 A(生产化实战)的占多数,这一季就从这个骨架开始,第一件事是让它真的能跑起来。
我原以为「从骨架到能跑」差的是数据库驱动加几段 CRUD。真动手才发现,差的是另一件事:租户这条线怎么落地。
这个项目是多租户的——一套代码服务多个客户,每个客户只能看见自己的订单。我把内存 store 换成 SQLite、把下单链路跑通、curl 能出数据,只花了不到一小时。然后我故意漏传了一次租户 ID,两分钟后就看到了一个不该看到的东西:
A 列 paid 单 → 16 条,越界 8 条
一个客户的后台里,混进了另一个客户的订单。HTTP 200,日志一行异常都没有,监控大盘干干净净。
这篇是「Go 服务生产化实战」的第 01 篇。我打算把这个项目从 0 跑到本地完全跑通,顺手把这条链路上最容易埋的雷拆开讲清楚:租户漏传为什么不会报错,以及怎么让它在编译期和 CI 里就必须报错。
实验代码在 /tmp/tenancy-lab,全部实际执行过。环境:Go 1.27.0(本机默认工具链是 1.23.3,模块里写 go 1.27.0 后由 GOTOOLCHAIN=auto 自动拉取)、Apple M4 / 10 核 / darwin-arm64、modernc.org/sqlite v1.60.1(纯 Go 驱动,不需要 cgo;生产里这里应该换成 Postgres,后面第九节会讲 Postgres 该怎么写)。
一、骨架到「能跑」,差的是三件事
先说清楚起点。上一季收官时那套骨架有什么、没什么:
| 部分 |
骨架里 |
这一篇要补的 |
| HTTP 层 |
有(中间件链、drain、readyz) |
加租户约定 |
| 业务层 |
有(order/inventory/payment 三个模块) |
不用动 |
| 数据层 |
内存 map,进程重启就没了 |
换成真库、加迁移、加 seed |
| 租户 |
没有 |
这是这一篇的正题 |
| 自检 |
没有 |
一个 5 分钟跑完的跨租户自检 |
| CI 检查 |
没有 |
一个盯 SQL 的静态检查器 |
补数据层是体力活,真正花时间的是后面三行。我给这个项目定了个约定:请求头 X-Tenant-ID 带租户(正式版要换成 JWT claim,那是后面鉴权那篇的事),中间件校验通过之后,整个进程里只有一处代码允许读它。
先把这条线的全貌画出来,后面每一节都在填这张图里的一个格子:
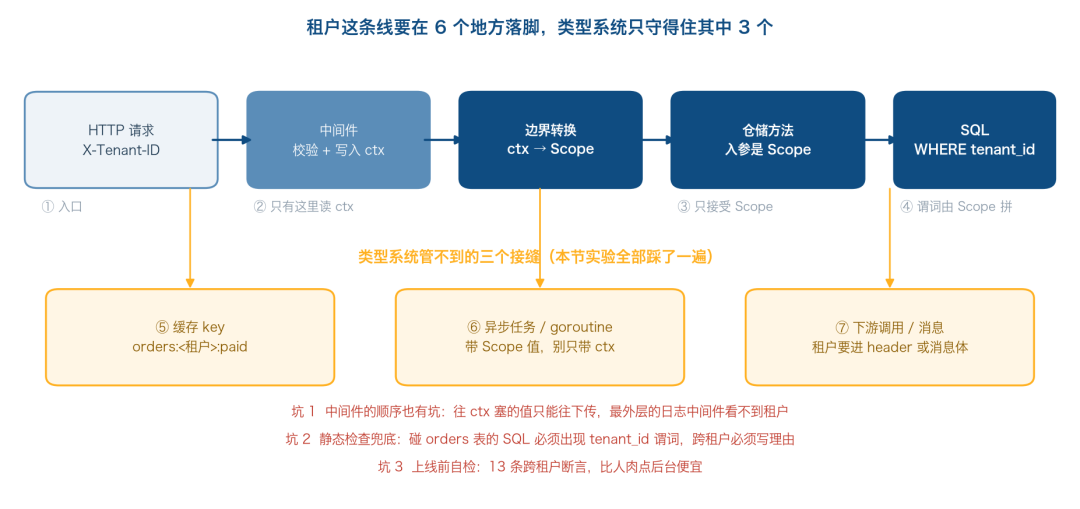
从请求进来到 SQL 出门,租户要在入口、中间件、边界转换、仓储方法、SQL 谓词这五个位置「落地」;而缓存 key、异步任务、跨进程调用这三个接缝,类型系统是管不到的,只能靠约定、工具和自检。
先看项目结构:
tenancy-lab/
├── cmd/
│   ├── server/        # 本地起服务
│   ├── selfcheck/     # 上线前的跨租户自检
│   ├── tenantlint/    # CI 里的静态检查器(go/ast 手写)
│   ├── adminreport/   # 合法的跨租户出口(后台报表)
│   └── lab-e1/ e2/ e3 # 三个实验,对应本文的实测数据
└── internal/
    ├── tenant/        # 租户 ID + 唯一的 ctx 读取口
    ├── store/         # Scope + 仓储(SQL 都在这里)
    ├── cache/         # 20 行的 TTL 缓存
    └── api/           # HTTP 边界
go.mod 就两行有用信息:
module tenlab

go 1.27.0

require modernc.org/sqlite v1.60.1 // 纯 Go 实现,不用装 cgo
顺带说一句:Go 1.27 把 uuid 收进了标准库(RFC 9562),这个项目没有再引 github.com/google/uuid。用法和第三方库几乎一样,uuid.NewV7() 生成时间有序的 v7,拿它当订单主键,B+ 树的局部性比 v4 随机值好,单表里「按创建时间排」这件事主键自己就带上了。
二、最小可运行:一次下单链路跑通
库只有一个 orders 表,租户就是其中一列:
CREATE TABLE IF NOT EXISTS orders (
  id           TEXT PRIMARY KEY,
  tenant_id    TEXT NOT NULL,
  customer     TEXT NOT NULL,
  amount_cents INTEGER NOT NULL CHECK (amount_cents >= 0),
  status       TEXT NOT NULL,
  created_at   TEXT NOT NULL
);
打开库的时候有个坑值得单独说:连接池我设成 1 条连接。
func open(dsn string, maxConns int) (*sql.DB, error) {
  full := dsn + "?_pragma=busy_timeout(5000)&_pragma=journal_mode(WAL)&_pragma=synchronous(NORMAL)"
  db, err := sql.Open("sqlite", full)
  if err != nil {
    return nil, err
  }
  db.SetMaxOpenConns(maxConns)
  return db, nil
}
SQLite 同一时刻只允许一个写者。池子开大了,同进程内的多个连接会互相抢写锁,直接拿到 database is locked (5) (SQLITE_BUSY)。上一季末尾我在这方面栽过一次——4 条连接、68% 的请求 409。所以这里写服务用 1 条,纯读的压测路径另开一个 8 连接的池子。这条经验在 Postgres 上不存在,但「连接池大小要和存储的并发模型对齐」这件事到哪都一样。
启动、造数据、跑请求:
go run ./cmd/server -db data/orders.db -seed -addr 127.0.0.1:8080
GET  /api/orders            (不带租户头)        → HTTP 400
GET  /api/orders?status=paid(租户头 A)          → 200,8 条,租户集合 {0199a5c8}
POST /api/orders            (租户头 A)          → 201
     {"id":"01a14730-0082-7d37-b952-5b0a4fa693ee","tenant_id":"0199a5c8-…-0001",
      "customer":"新客户-001","amount_cents":18800,"status":"pending", …}
GET  /api/orders/{上面这个 id}(租户头 B)        → HTTP 404
GET  /api/orders/{上面这个 id}(租户头 A)        → HTTP 200
POST 请求体里塞 {"tenant_id":"B"}(租户头 A)     → 201,落库 tenant_id 是 A
四条边界都对了:没租户的请求进不来,别人的订单看不见(而且是 404,不是 403),请求体里的 tenant_id 被彻底忽略。到这里「能跑」了。
三、然后我故意漏传了一次租户 ID
真实项目里,「漏传」不会以 tenantID = "" 这么显眼的形式出现。它一般长这样:
// 第一版写法:仓储方法收一个 string
func (d *DB) ListOrdersV1(ctx context.Context, tenantID, status string) ([]Order, error)

// 某个 handler 里,租户是这么来的(当时还没中间件)
tenantID := r.URL.Query().Get("tenant")   // 拿不到就是 ""
"" 是完全合法的 string,SQL 也完全合法,编译器、vet、单元测试都不会眨眼。我做了一张对照实验,把「漏传」放进 8 个场景里跑一遍(每个场景都是真请求、真库、真数据,A 的身份发起,库里有 A/B 两个租户各 12 单):
| 场景 |
实测结果 |
表现 |
v1 · 漏传租户(SQL 里有 tenant_id = ?) |
200 / 0 条 |
静默(空结果) |
| v1 · 空租户当「看全部」(后台便利写法) |
200 / 16 条 / 越界 8 条 |
静默(串数据) |
v1 · goroutine 里用 context.Background() |
统计 24 条(应为 12 条) |
静默(口径变大) |
| v2 · 请求不带租户头 |
400 |
拦住 |
| v2 · 用 B 的订单 id、A 的身份访问 |
404 |
拦住(与「不存在」同形) |
v2 · 请求体里塞 tenant_id |
201,写入 A |
忽略 |
| v2 · 正常请求 |
200 / 8 条 / 越界 0 |
正确 |
| v2 · goroutine 里带 Scope 值 |
统计 12 条 |
正确 |
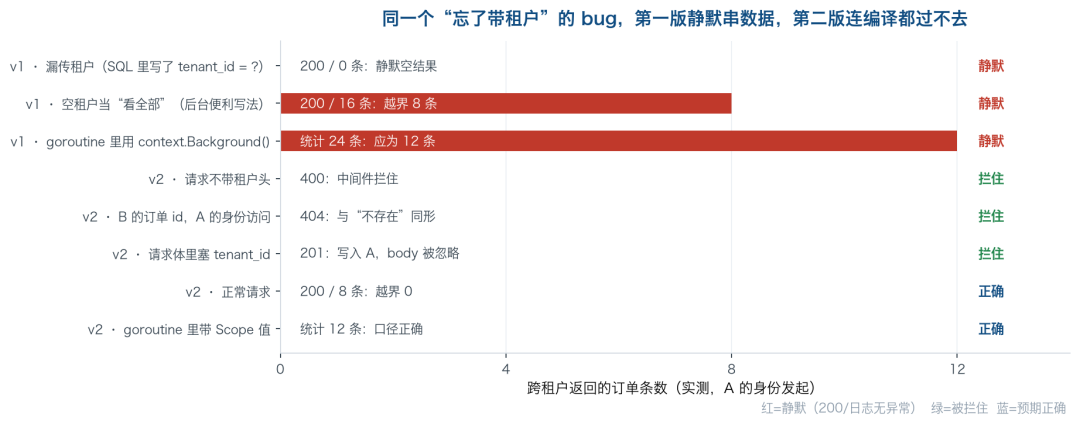
三种「静默」结局,各自长得不一样,但都属于同一类问题:
-
静默空结果:SQL 老老实实写了 tenant_id = ?,只是参数是空串。tenant_id = '' 匹配 0 行,语法完全正确。用户看到的是「我的订单不见了」,你查日志什么都查不出来,因为一切正常。
-
静默串数据:有人为了后台方便,加了一句「空租户就是看全部」。这种代码写上去的当天就能跑通,还能通过 code review——因为它的意图(后台看全量)是合理的。它唯一的问题是把「忘记传」和「故意看全部」合并成了同一个信号。
-
静默口径变大:异步任务里租户靠 ctx 传,而 worker 用的是自己新起的 context.Background()。统计出来的「某租户单量」变成全库单量。指标看起来只是「有点高」,没人会去查。
三类加起来就一句话:漏传租户不会让程序崩溃,只会让程序换一种便宜的方式继续跑。
四、为什么会这样:string 的空值是合法值
把这个问题抽象一层,它的根因不在 SQL,也不在 ORM,而在类型。
tenantID string 这个签名表达的是「我需要一个字符串」。它没有表达「我需要一个有效的、非空的租户」,而 "" 恰好满足「一个字符串」这个要求。于是契约在类型层面被放宽了,剩下的就全靠人记得传。
想清这一点之后,方案就清楚了:不是加一条注释写「⚠️ 必须传租户」,也不是写单元测试穷举所有调用点,而是把租户从 string 换成一个「要么有效、要么不存在」的类型,并且让数据层只接受这个类型。
五、把租户搬进类型:Scope
Scope 是我这次唯一觉得「值得写进骨架、以后每个多租户项目都这么干」的东西:
// Scope 是「这次操作允许碰哪些租户」的唯一凭证。
// 字段不导出,包外没法用 struct literal 拼出一个可用的 Scope。
type Scope struct {
  tenant tenant.ID
  all    bool
  reason string
}

var ErrNoScope = errors.New("store: 没有有效的租户 Scope,拒绝执行")

func ForTenant(id tenant.ID) (Scope, error) {
  if !id.Valid() {
    return Scope{}, fmt.Errorf("%w (拿到的租户 ID = %q)", ErrNoScope, string(id))
  }
  return Scope{tenant: id}, nil
}

// 跨租户 Scope 必须写理由,理由会跟着查询进日志。
func AllTenants(reason string) (Scope, error) {
  if strings.TrimSpace(reason) == "" {
    return Scope{}, errors.New("store.AllTenants: 必须写明跨租户的理由")
  }
  return Scope{all: true, reason: reason}, nil
}

// 每个数据访问方法的第一个动作。
func (s Scope) check() error {
  if s.all {
    return nil
  }
  if !s.tenant.Valid() {
    return ErrNoScope
  }
  return nil
}
仓储方法签名跟着变:
func (d *DB) ListOrders(ctx context.Context, s Scope, status string) ([]Order, error)
func (d *DB) GetOrder(ctx context.Context, s Scope, id string) (Order, error)
func (d *DB) CountOrders(ctx context.Context, s Scope, status string) (int, error)
写完第一版调用方之后,我试了一下「按老习惯传一个 string」,编译器是这么回我的——这段是真实编译输出,不是我编的:
cmd/badcall/main.go:14:45: cannot use "0199a5c8-1c00-7a01-9f8e-000000000001"
  (untyped string constant) as store.Scope value in argument to db.ListOrders
这个报错比任何注释都值钱。 它出现在编译期(也就是 CI 的第一分钟),而不是出现在某个客户的投诉里。
但必须说实话:Scope 不是「造不出来」,是「造出来也没用」
我写了段探针把边界试了一遍,结果有一条需要如实说明:
ForTenant("")            → err = store: 没有有效的租户 Scope,拒绝执行 (拿到的租户 ID = "")
外部 store.Scope{}        → 编译通过(零值字面量是允许的)
用零值 Scope 查询          → err = store: 没有有效的租户 Scope,拒绝执行(fail closed)
AllTenants("  ")          → err = store.AllTenants: 必须写明跨租户的理由
AllTenants(带理由)         → CrossTenant = true, reason = "月度盘点:只聚合计数"
用跨租户 Scope 写单        → err = CreateOrder: 不允许用跨租户 Scope 写入
store.Scope{} 是能编译通过的——Go 允许外部包写零值复合字面量,只要求你不碰未导出字段。所以这套设计的保证不是「租户漏传不可能发生」,而是「漏传之后一定是报错,不是静默的空结果或全量结果」(fail closed)。
我觉得这个差别值得强调,因为它决定了你怎么写测试:不要试图证明「没人能造出坏 Scope」,要断言「造出坏 Scope 之后,数据层必须拒绝」。这两件事的验证成本差一个数量级。
顺带一个细节:跨租户 Scope 不能写数据。CreateOrder 里明确拒绝 CrossTenant() 的 Scope——读的越权和写的越权不是一个量级,后台报表需要看全量,但没有任何业务需要用「看不见的租户」去建单。
六、ctx 里的租户,只留一个口子
租户从 HTTP 头进来,到仓储层要变成一个值。中间那段路我走 ctx:
func (s *Server) tenantMW(next http.Handler) http.Handler {
  return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
    id, err := tenant.Parse(r.Header.Get("X-Tenant-ID"))
    if err != nil {
      writeErr(w, http.StatusBadRequest, "missing_or_invalid_tenant", err)
      return
    }
    next.ServeHTTP(w, r.WithContext(tenant.WithID(r.Context(), id)))
  })
}

// 全项目读租户的地方,只有这一个函数。
func (s *Server) scope(r *http.Request) (store.Scope, error) {
  id, err := tenant.FromContext(r.Context())
  if err != nil {
    return store.Scope{}, err
  }
  return store.ForTenant(id)
}
tenant.FromContext 我特意设计成返回 error,而不是返回零值 ID:
func FromContext(ctx context.Context) (ID, error) {
  id, ok := ctx.Value(ctxKey{}).(ID)
  if !ok || !id.Valid() {
    return "", ErrMissing // 绝不返回 "" 让你去判空
  }
  return id, nil
}
理由很实在:一个返回 "" 的取值函数,迟早有人忘了判空;而忘了判空的那一次,通常就是线上串租户的那一次。让它返回 error,忘了处理的人至少会看到 id 是空字符串而不是「正常值」。
这里要补一句自我修正。这个号前面写过 context,那篇的结论是「context 不是用来传业务值的」。租户算不算例外?我的判断是:算,但只算一半。
- 租户不是业务参数,它是「这个请求的环境事实」——和
trace_id、deadline 同类,所有下游都关心,不属于某一层业务逻辑。
- 但它的生命周期必须极短:从中间件进来到 handler 那一次转换,之后就变成显式的
Scope 值往下传。
- 判断标准很简单:如果全项目读 ctx 中租户的地方超过 1 处,这套设计就开始散了。 用
grep 一数就知道,不需要靠自觉。
七、实验二:三个接缝里,最先翻车的是缓存
把 SQL 那层守住之后,我很有安全感。然后把缓存加上了——立刻串了。
缓存是这样的(20 行 TTL map),出错的是 key:
// 第一版:key 只有业务维度
return "orders:" + status // "orders:paid"

// 第二版:key 带上租户
return "orders:" + string(id) + ":" + status // "orders:<租户>:paid"
实验二把 A、B 两个租户交替请求同一个路径 24 次:
| key 形态 |
请求数 |
串租户响应 |
串过去的条数 |
命中/未命中 |
"orders:paid" |
24 |
12 |
96 |
23 / 1 |
"orders:<租户>:paid" |
24 |
0 |
0 |
22 / 2 |
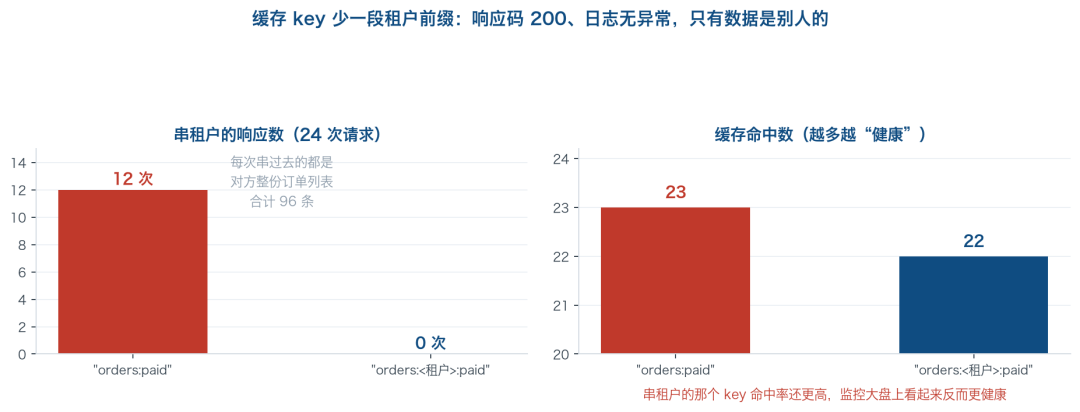
两件事值得单独拎出来:
第一,串租户的那一版命中率更高(23 比 22)。因为 A 和 B 本来不是同一份数据,现在共用了一个 key,等于凭空多了一次命中。如果你在监控上看缓存命中率,那个有 bug 的版本看起来更「健康」。
第二,这个 bug 是类型系统管不到的。cacheKey(id, status) 里的 id 参数我不会忘传(忘了编译不过),但「key 里到底包含哪些维度」这件事,类型检查器不会管,code review 也容易漏——因为 "orders:paid" 这个字符串看起来完全正常。
同一类接缝还有两个,实验一已经量过了:
-
异步任务 / goroutine。第一版里统计单量的 worker 用 context.Background() 重起了 ctx,租户丢了,统计出来 24 条(全库);第二版把 Scope 当普通值塞进 job 结构体,goroutine 换不换 ctx 都无所谓,统计出来 12 条。这就是「把租户放进类型」的第二个收益:值传递天然能穿过 goroutine 边界,而 ctx 不能。
-
下游调用和消息。调别的服务、投消息,租户得进 header 或者消息体。这一块是后面 webhook 推送那篇的内容,这里先留个记号:凡是跨进程的边界,租户都要显式带上,且接收方必须校验。
八、实验三:多租户表的索引(读快 83 倍,写慢 6.5 倍)
数据层还剩一个必须量一下的东西:tenant_id 这个新维度怎么建索引。
10 万条订单、200 个租户,跑同一条热查询——按租户取最近 20 条已支付订单,300 次查询、8 并发:
SELECT id, tenant_id, customer, amount_cents, status, created_at
FROM orders
WHERE tenant_id = ? AND status = ?
ORDER BY created_at DESC LIMIT 20
| 索引 |
p50 |
p99 |
查询计划 |
| 无(只有主键) |
18.666ms |
22.213ms |
SCAN orders + USE TEMP B-TREE FOR ORDER BY |
单列 (tenant_id) |
0.309ms |
0.955ms |
SEARCH orders USING INDEX idx_orders_tenant + USE TEMP B-TREE |
复合 (tenant_id, created_at DESC) |
0.225ms |
0.699ms |
SEARCH orders USING INDEX idx_orders_tenant_created |
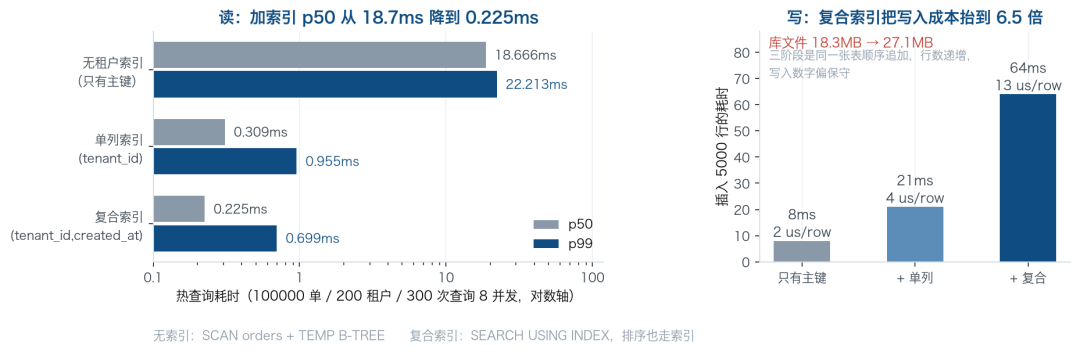
三个观察:
-
tenant_id 没索引是灾难。p50 从 18.7ms 掉到 0.225ms,差了 83 倍。原因很直白:没有租户索引时,一次请求要在 10 万行里全表扫描,再对命中的行做临时排序。多租户系统里,tenant_id 几乎总是最重要的那个索引前缀,因为每个请求的业务条件前面,天然都带着一个租户条件。
-
复合索引的收益主要在排序。单列索引已经解决了「过滤」,但 p99 还有 0.955ms;把 created_at DESC 加进去之后,USE TEMP B-TREE FOR ORDER BY 这一行从计划里消失了——排序直接走索引顺序,p99 到 0.699ms。如果你的接口都是「按时间倒序取前 N 条」,这个复合索引值得加。
-
写是要还的。同一张表顺序追加 5000 行:只有主键 8ms(2 µs/行),加单列索引 21ms(4 µs/行),再加复合索引 64ms(13 µs/行),库文件从 18.3MB 涨到 27.1MB。读多写少的订单表可以放心加,写入密集的表(日志、事件流)就要想清楚。 补一句公道的:这三个阶段是同一张表顺序追加,行数递增、后一阶段更吃亏,所以写入倍率偏保守,不能当精确 benchmark 看。
配索引的时候我还踩了个小坑:连接会缓存已编译的语句。我建完索引直接用原来的连接跑 EXPLAIN QUERY PLAN,拿到的是上一轮的查询计划——单列索引那一栏显示「SCAN orders」,复合索引那一栏显示的是已经被删掉的单列索引。改成「每次改完索引重开一个连接池再 EXPLAIN」之后,计划才对得上。凡是「改完结构立刻看计划」的场景,都要注意这一点。
九、生产环境怎么做:Postgres 的 RLS 是第二道防线
本文用 SQLite 是为了本地一跑就通。真上生产,绝大多数多租户系统用的是 Postgres,它有一个这个场景专用的功能:行级安全(Row Level Security)。核心是把租户过滤从应用层下沉到数据库:
ALTER TABLE orders ENABLE ROW LEVEL SECURITY;
ALTER TABLE orders FORCE ROW LEVEL SECURITY;   -- 关键:否则表 owner 静默绕过策略

CREATE POLICY orders_tenant_isolation ON orders
USING       (tenant_id = current_setting('app.tenant_id')::uuid)
WITH CHECK  (tenant_id = current_setting('app.tenant_id')::uuid);

-- 每个请求/事务开始处
BEGIN;
SET LOCAL app.tenant_id = '0199a5c8-1c00-7a01-9f8e-000000000001';
-- 之后这个事务里的所有查询自动带上租户条件
COMMIT;
和本文的方案对照着看,有几条经验是通用的,也有几条是 Postgres 特有的坑:
| 关注点 |
本文方案(应用层 Scope) |
Postgres RLS |
| 谁在过滤 |
每个仓储方法,谓词由 Scope 拼 |
数据库自动重写每一条查询 |
| 漏写的后果 |
编译错误 / 运行时报错 |
数据库层兜住,返回 0 行 |
| 写入约束 |
NewOrder 里没有 TenantID 字段 |
必须写 WITH CHECK,只写 USING 挡不住 INSERT |
| 连接池陷阱 |
goroutine 里换成 Background() 丢 ctx |
用 SET 而不是 SET LOCAL,租户会残留在连接上被下一个请求继承 |
| 静默失效风险 |
— |
连接角色是表 owner 或带 BYPASSRLS 时,策略不生效;要 FORCE + 专用应用角色 |
| 性能 |
依赖 tenant_id 索引 |
同样依赖 tenant_id 索引,策略里别放子查询 |
我最想强调的是表里倒数第二行那个「静默失效」:RLS 装上了不代表它在工作。策略生效与否,取决于当前连接的角色有没有绕过权限,而这属于「改了连接配置就悄悄失效、症状和正常工作一模一样」的那一类问题。所以下面一节那个自检,在 RLS 环境里要用应用角色跑,不能用管理员账号跑——否则你验证的是「管理员能看见所有数据」,那当然能看见。
还有一点:应用层和数据库层两套都做,不是重复劳动。 应用层的 Scope 是主防线(错误出现在编译期和 CI,最便宜);RLS 是兜底(挡住人写的原生 SQL、运维脚本、报表工具)。成本是每张租户表一条策略加一个索引,我认为值。
至于「每租户独立库 / 独立 schema」什么时候选,那是后面《多租户数据隔离》那篇的正题,这里不展开,只说一句判断:租户数量过千、且需要跨租户聚合查询时,共享表加租户列几乎是唯一选择;独立库适合租户少、合规要求高、单租户数据量大的场景。
十、静态检查:手写一个 200 行的 tenantlint
到这一步,SQL 层有 Scope 守着,缓存 key 有约定守着,但还有一类地方谁也管不到:直接写在代码里的 SQL、以及合法的跨租户查询。靠人 review 是守不住的,所以我用 go/ast 写了个检查器,只有两条规则:
- 碰
orders 表的 SQL,读/改/删必须有 tenant_id 谓词,写入必须带 tenant_id 列;
- 调用
store.AllTenants(...) 必须带一行标记,确认这是有意为之。
有违规就退出码 1,直接挂到 CI 上。真实运行结果:
# A. 生产代码(跳过对照实验文件)
扫描 16 个 Go 文件
tenantlint: 16 个文件,0 处违规           ← 退出码 0

# B. 连第一版的对照文件一起扫
internal/store/orders_v1.go:16: [SQL_NO_TENANT_PREDICATE] 没有 tenant_id 谓词: SELECT id, tenant_id, …
internal/store/orders_v1.go:17: [SQL_NO_TENANT_PREDICATE] 没有 tenant_id 谓词: SELECT COUNT(*) FROM orders WHERE 1 = 1
tenantlint: 17 个文件,2 处违规             ← 退出码 1

# C. 把 4 处「跨租户标记」全删掉,模拟有人赶需求抄近路
tenantlint: 17 个文件,9 处违规             ← 退出码 1
写这个检查器的过程本身也踩了一个坑,值得说说。第一版规则是「SQL 字符串里出现 tenant_id 就算过」,结果被 SELECT 列名骗了:SELECT id, tenant_id, customer, … FROM orders WHERE 1 = 1 这条查询明明没有任何租户谓词,却因为列名里带 tenant_id 而通过检查。15 个文件里它只报出 1 处,漏了另一处。改成「必须出现真正的谓词形态」(tenant_id = ? / tenant_id IN (…))之后才报对:
// 必须像谓词,而不是只出现在列名里
predicateRe = regexp.MustCompile(`(?i)tenant_id\s*(=|<>|<|>|\bin\b)\s*[?$:'"]`)
// 写入单独判:租户必须落在列里
insertRe = regexp.MustCompile(`(?i)^insert\s+into\s+orders\b`)
这里还有一条更普遍的教训:字符串拼接的 SQL 让静态检查基本没法做。 第一版代码里 SQL 是这样长出来的:
query := `SELECT … FROM orders WHERE 1 = 1`
if tenantID != "" { query += ` AND tenant_id = ?` }   // 空租户 = 看全部
if status != ""   { query += ` AND status = ?` }
query += ` ORDER BY created_at DESC LIMIT 200`
检查器只能看到一个孤零零的 WHERE 1 = 1,它没法判断后面还会拼上什么。所以我把生产代码里的 SQL 全部改成单条字面量常量,一个语句一个常量,动态分支用不同常量而不是拼接。一半为了可读,一半是为了让工具能真的看懂它。顺带还避掉一个 bug:第一版那种拼接,ORDER BY 加在 LIMIT 之后的顺序稍有差错,SQL 直接语法错误——我在实验里就写出过 … LIMIT 200 AND status = ? 这种东西。
跨租户查询的处理方式,我用了类似 //nolint 的行内标记,顺手把「理由」变成了强制字段:
qListCross = `SELECT … FROM orders WHERE 1 = 1 ORDER BY created_at DESC LIMIT 200` // tenantlint:allow-cross-tenant
调用方也必须写清楚为什么:
// tenantlint:allow-cross-tenant 运营月度盘点,需要全量口径,只聚合不返回明细
sc, err := store.AllTenants("月度运营盘点:全租户单量聚合,只输出计数")
这段代码会在日志里留下 跨租户读取理由: 月度运营盘点…。多租户系统里「谁在什么时候拉了全量数据」是必须能回答的问题,让写代码的人当场写下来,比事后审计文件便宜得多。
十一、上线前 5 分钟:一个自检命令
最后一块是自检。我不想每次改完租户相关代码都靠人肉点后台,所以写了个命令,起一个真实 HTTP 服务,把所有跨租户路径挨个试一遍,任何一项不过就退出码 1:
go run ./cmd/selfcheck
== 多租户自检 · tenant isolation self-check ==
PASS 健康检查可匿名访问                GET /healthz
PASS 缺租户头 → 400                    status=400
PASS 非法租户 ID → 400                 status=400
PASS A 列单 → 200                      共 12 条,越界 0 条
PASS B 列单无 A 的数据                  共 12 条,越界 0 条
PASS A 访问 B 的订单 → 404              status=404
PASS B 访问自己的订单 → 200              status=200
PASS 不存在的订单和别人的订单同形         status=404
PASS 请求体塞 tenant_id 无效,仍写进 A    status=201
PASS 缓存不串租户                       A/B 交替 6 轮,越界 0 条
PASS 异步任务租户边界                   A 的 paid 单量 = 8
PASS 库层面复核 A 的单量                 库里 A = 13,列表 12 + 新建 1

自检通过:所有跨租户路径都被挡住
其中「库层面复核」那一条是我特意加的:它不走 HTTP,直接用 Scope 查库计数,和 HTTP 返回的列表长度对齐。接口层的测试和存储层的断言要能对得上,否则两边的 bug 会互相掩盖。
再往上加一层并发测试。多租户的串数据不一定来自漏写谓词,也可能来自并发——比如请求级别的状态被塞进了共享变量。这条测试 3 个租户、8 个 goroutine、300 次请求,断言返回的每一条订单都属于请求者:
go test -race -v ./internal/api/
--- PASS: TestTenantIsolationUnderConcurrency   并发 300 次请求,返回 3600 条订单,跨租户 0 条
--- PASS: TestLegacyCacheKeyLeaks                旧缓存 key 下串租户 48 条(这正是我们想拦住的东西)
--- PASS: TestMissingTenantRejected              5 个子用例全部通过
第二条是反例测试,它比第一条更重要:把缓存 key 换回旧写法,同一条测试必须失败。一条永远不会失败的隔离测试等于没写,所以我留了一条「故意让它红」的路径,用来证明测试真的在覆盖这条链路。
顺带量了一下租户校验的开销,结论是可以忽略:
BenchmarkListOrders/scope_check_only-10     73766644    16.21 ns/op     0 B/op    0 allocs/op
BenchmarkListOrders/list_orders-10             82448     14361 ns/op   5256 B/op  133 allocs/op
每次请求多做一次租户校验是 16 纳秒、零分配,而一次真实的取数查询是 14.4 微秒——校验成本约等于查询的 0.1%。这是我在设计这类「多加一层抽象」的东西时最常被问到的问题(「这不会影响性能吗」),答案基本都是:先量一下,量完就不用争了。
十二、我的三条判断
写到这儿,把这次从骨架到跑通的关键判断收一下:
-
多租户系统的核心不是「记得加 WHERE」,而是让「记得」这件事不依赖人。 租户漏传不会崩、不会报错、不会涨日志,只会把 A 的数据发给 B——这类 bug 的成本(客户信任)和它的隐蔽程度完全不匹配。所以我宁可要「编译期报错」这种笨办法,也不要「注释里写清楚必须传」这种聪明办法。
-
租户可以是「值」,但绝不能是「字符串」。 string 的空值是合法的,这就是整条链路上所有静默 bug 的入口。把它换成 Scope 这样一个「要么有效、要么构造失败」的类型之后,错误的位置从「客户的投诉」前移到了「CI 的第一分钟」。要承认的是,这并没有让漏传变得不可能(零值字面量还是能写出来),只是把它变成了必然报错——做工程要的是后者,不是前者。
-
类型系统守住主链路,剩下三个接缝要靠约定 + 工具 + 自检。 缓存 key、异步任务、跨进程调用,这三处类型系统都管不到;静态检查可以覆盖 SQL 和跨租户出口;缓存维度和消息体,只能靠 code review 加一条会失败的自检测试。三个层次一起上,覆盖才算完整。
总结
把骨架变成一个能跑的多租户订单服务,数据库和 CRUD 只是前半段;真正决定它能不能上生产的,是租户这条线有没有在入口、数据层、缓存、异步、跨进程五个位置都落地。我的做法是:入口把 X-Tenant-ID 一次性转成 Scope 值,数据层只接受 Scope 并在构造期拒绝空租户,其余三处用静态检查(tenantlint)+ 上线自检(13 条断言)+ 并发隔离测试(-race)兜住。编译错误、400、404、fail closed——这些看起来笨的失败方式,比「静默地继续跑」要好一百倍。
tenant_id 的索引别忘加:10 万行下 p50 从 18.7ms 到 0.225ms,代价是写入从 2 µs/行 涨到 13 µs/行。
两种主流做法的资源成本和迁移代价,下篇会放到一张表上对比:共享表加租户列(应用层 Scope + 索引隔离,本文这套),还是每租户独立库或独立 schema(物理隔离换运维复杂度)。选型时值得仔细权衡。
这一套设计——Scope 那 40 行代码、tenantlint 的两条规则、自检命令的 13 条断言——都可以直接搬到新项目中。以后新起多租户服务时回来翻一遍,比重新想一次快。
下篇预告
「Go 服务生产化实战」第 02 篇——配置与密钥管理。这个项目现在的租户、数据库路径都是启动参数,AppSecret 之类的东西还躺在环境变量里没管;下一篇把配置的分层(默认值 / 文件 / 环境变量 / 远程配置)、密钥不进仓库、配置变更不重启这几件事讲清楚。
参考资料
- Go 官方文档:database/sql、net/http、log/slog、go/ast
- Go 1.27 Release Notes:go.dev/doc/go1.27(标准库新增
uuid、goroutineleak profile 转正)
- RFC 9562:Universally Unique IDentifiers (UUIDs)(v7 时间有序)
- PostgreSQL 官方文档:Row Security Policies、CREATE POLICY
- SQLite 官方文档:EXPLAIN QUERY PLAN、Write-Ahead Logging
modernc.org/sqlite v1.60.1(纯 Go 驱动)- 本机实测代码与原始输出:
/tmp/tenancy-lab(results/e1.txt、e2.txt、e3.txt、selfcheck.txt、bench.txt、lint-*.txt、compile-error.txt、server.log)
 发表于 3 小时前
|
查看: 7|
回复: 0
 /1


