这两年做浏览器,路子基本就两条。要么在 Chromium 上套一层壳,改改 UI 就叫自研;要么给 WebKit 打补丁。技术上没毛病,只是都在别人家院子里搞装修。
Lightpanda 走了第三条路。Chromium 不碰,WebKit 也不碰,拿 Zig 从零写了个浏览器内核。Zig 你可能没听过,语法长得像 C,但没有 C 那些历史包袱,内存不归 GC 管,这几年在写系统软件的人里挺吃香。
三千七百多个提交,作者是几个法国人,AGPL-3.0 协议。不过他们盯着的,不是你我桌面上那块屏幕。
它砍掉了什么
先看它长啥样。这是项目自家的 Logo,一只熊猫:
一个浏览器,居然没有图形渲染引擎。没 UI,不做排版合成,一个像素都不画。它就干一件事:把网页跑起来,再按你要的格式吐出去。
拆掉这么多,功能听着像残废,其实是故意的。因为吃资源最狠的是「把 DOM 画成画面」那一整套流程——布局、栅格化、合成、光栅缓存,每一步都在吃内存和 CPU。JS 引擎在这面前反倒算省油的。如果你是个爬虫、是个 Agent、是跑 E2E 的脚本,你压根不需要画面,只要结果。
画面一砍,剩下的事就轻了:解析 HTML、跑 JS、维护 DOM。内部依赖也挺克制,用的是 V8(跟 Chrome 同一个 JS 引擎,跑 JS 的结果跟 Chrome 一致)、Libcurl、html5ever。
一行命令就能试
不用装 SDK,一个可执行文件就能跑:
# 抓一个页面,直接吐成 markdown
lightpanda fetch --dump markdown https://example.com

# 也能吐成 html / png / pdf / structured_data
lightpanda fetch --dump html https://example.com
加上 --with-base 之类的参数能处理相对路径,--obey-robots 让它老老实实守 robots.txt,这点算它良心。
快 9 倍、省 16 倍
光聊架构没劲,上数据。项目方在 README 里放了两个基准测试,环境是 AWS EC2 m5.large,跑 933 个真实网页,取并发 100 页时的峰值。
先看时间,这是官方出的图,我原样搬过来:
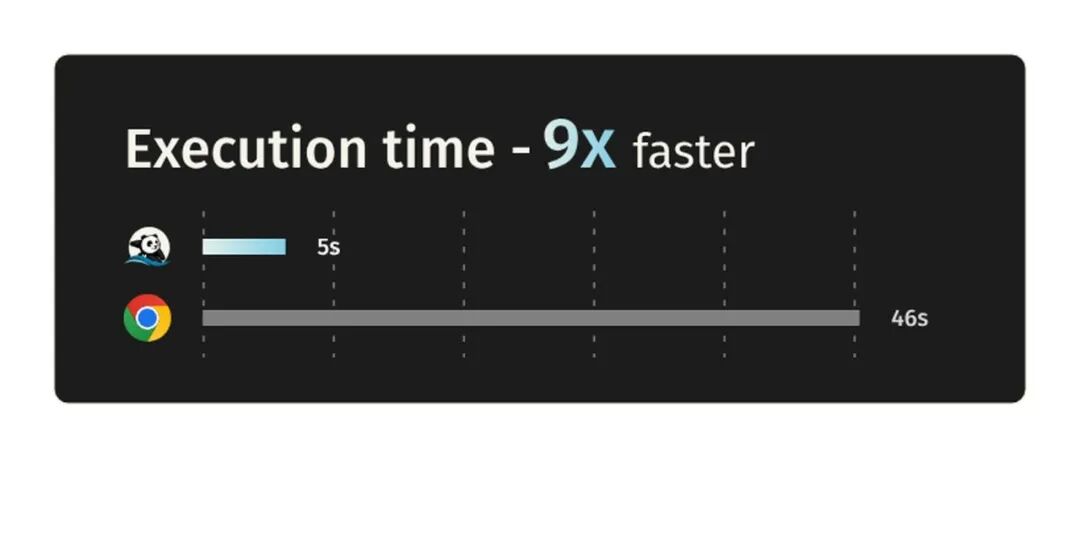
同一批页面,Lightpanda 5 秒跑完,Chrome 用了 46 秒。快 9 倍。
再看内存:
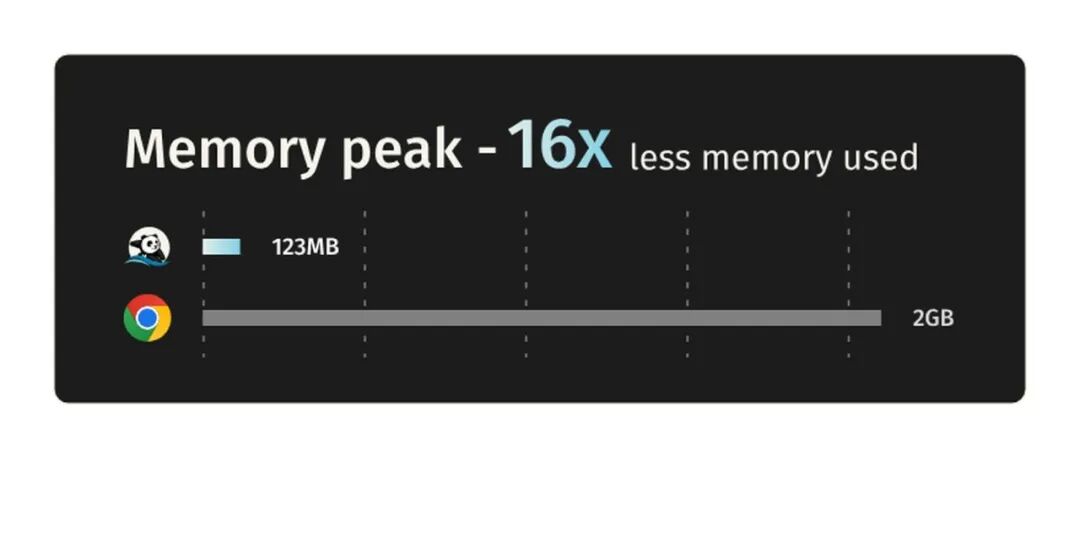
100 页的峰值内存,Lightpanda 123MB,Chrome 2GB。省 16 倍。
这两个数搁一块看,性质就变了。轻一点点不足以形容,这相当于同一件事换了个机器量级。你原先要开 4 台 4GB 的机器跑采集,现在一台 1GB 的就能应付。
这两张图是项目方自己出的基准,环境 m5.large,样本 933 个真实网页。我没在本地复现过,所以按「官方说法」看,别当第三方测评的结论用。
Agent 那块才是重点
要说它只是个省内存的爬虫,火不到这个程度。真正让我想写一写的,是它对 AI Agent 的态度。
现在让 AI 上网,主流做法是塞个无头 Chrome 进去,让模型来回看图、点按钮、读 DOM。这套流程又慢又烧 token,模型盯着截图猜下一步,十步错三步,而且每跑一次结果都不一样,根本没法复现。
Lightpanda 有两个专门干这个的模块。头一个是 agent 模式:
lightpanda agent "去这个页面上把价格抓下来"
它跑完不只给你结果,还落一份 PandaScript——一段能回放的脚本。这设计挺狠:第一次让模型费脑子,之后每次都直接放脚本,运行时零 token,结果还是确定的。要花钱的只有第一步。
第二个是原生 MCP server。Claude Code、Cursor 这类工具可以直接把它当浏览器工具调,胶水代码你不用自己写:
lightpanda mcp --port 3000
stdio 和 HTTP 两种传输都支持,HTTP 模式下用 Mcp-Session-Id 头做会话隔离,几个客户端连着互不打架。这点比不少早期 MCP 实现做得细。
泼盆冷水
夸完了,有三件事你上手前得先知道。
坑一:默认开着 telemetry,得手动关
这个我不太喜欢。它默认上报使用数据,想关得自己设环境变量:
export LIGHTPANDA_DISABLE_TELEMETRY=true
一个无头浏览器,开箱就带数据上报,这事搁谁心里都不太舒服。上生产之前先设上,别怪我没提醒。
坑二:它不渲染画面,也跑不了完整前端
依赖 canvas 的图表、WebGL 的 3D、靠布局结果算逻辑的前端框架,跑出来的东西跟用户看到的可能对不上。你要验的是「页面长啥样」,它不合适;你要拿的是「页面里的数据」,它很合适。
坑三:AGPL-3.0,商用前想清楚
AGPL 这条线卡得比较死。拿它做成 SaaS 对外提供服务的,按协议改动得开源。自己内部跑、不对外提供网络服务,那没事。真要做商业产品,去问律师,别问网友。
该不该上
分场景说,四种情况:
- 采集、爬取、批处理 → 强烈推荐,省下来的机器钱是实打实的
- AI Agent 的浏览器工具 → 推荐,PandaScript 那个思路太值了
- E2E 测试 → 可以试,但别指望它兼容一切前端框架
- 想替代桌面浏览器 → 不可能,它压根没画界面
写在最后
我喜欢这项目的态度。它不去抢 Chrome 的地盘,它承认大部分程序要的东西特别朴素,就是一个能把网页跑起来的运行时。这需求一直都在,只是过去没得选,只能拖一个两三百兆的大家伙上阵。
38k 星说明这判断被不少人认了。至于能不能撑住,两说。Zig 生态还在早期,AGPL 又挡住一片商业场景,这两条都是真门槛。但方向摆在那儿,后面照着抄的只会更多。
你是拿它做采集还是接 Agent?欢迎来云栈社区分享你的玩法。
项目地址: https://github.com/lightpanda-io/browser
 发表于 昨天 20:26
|
查看: 3|
回复: 0
 /1


