一个看番的 App,最脆弱的地方从来不是播放器,是片源。站一换域名,内置源全废,用户只能等作者更新。Kazumi 反过来做:它自己不带片源,只给你一张空表,五行 XPath 填进去,它去那个站点的网页里把列表、链接、剧集,以及藏在页面深处的那条视频流,一层层捞出来。
这篇不教怎么用。要讲的是它怎么搭起来的:跑在哪些平台上、用什么写的、一条番剧从名字到画面要过几道关、数据到底怎么抓、最后交给谁播。
装完,打开,规则列表是空的。
多数人第一反应是「坏了」,第二反应是「这玩意怎么用」。这两个反应错在同一个前提上:以为片源是 App 的一部分。
它从来不是。片源在别人服务器上,随时换域名、换路径结构、加一层验证。任何把源写死进安装包的 App,本质上是在赌那些站点不变——而它们一定会变。
Kazumi 的选择是不赌。它把「站点长什么样」这件事,做成用户能自己填的一行行选择器。
一个名字要走五道关
先看全局,后面每一节都能挂回到这张图上。
Kazumi 里有两条几乎不相干的数据线。
第一条管「番剧是什么」:名字、封面、简介、评分、播出时间表、分集标题、关联作品、评论。这些全部来自 Bangumi 的公开接口(api.bgm.tv 的 v0 API)。这条线是标准的 REST 消费,和任何一个番剧资料 App 做的事没区别,跟「抓」一点关系都没有。
第二条管「片源在哪」。这才是它唯一真正难的地方。
两条线之间只靠一根很细的销子连着:番剧名这个字符串。
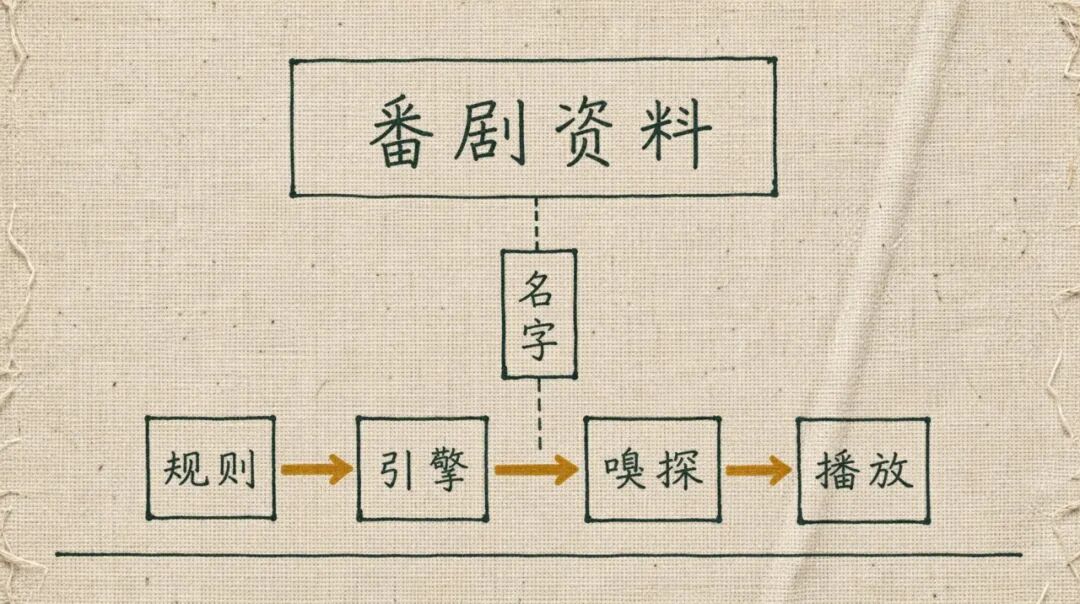
从这个视角看,一条番剧从名字走到画面,要过五道关:
| 关 |
要解决的事 |
谁在干 |
| 一 |
把「这个站点长什么样」写成配置 |
五行 XPath,或者 JSONPath |
| 二 |
照配置发请求、把结果解析出来 |
三段式 RuleEngine + 策略切换 |
| 三 |
站点不配合时,先过掉拦截 |
挑战检测 + WebView + cookie |
| 四 |
在真浏览器里蹲到视频流地址 |
隐藏 WebView + 注入脚本 |
| 五 |
把这条流播出来 |
libmpv(经 media-kit) |
中间那个「再搜一次」值得单独提一句。Bangumi 的条目 id 和规则站点的搜索结果之间没有任何映射关系,App 手里只有一个名字。这一步本质上是按名字猜。
猜错了不会报错,你会看到一条完全不相干的搜索结果,或者零条。后面很多「莫名其妙」的根源都在这里——链路没断,是销子对不上。
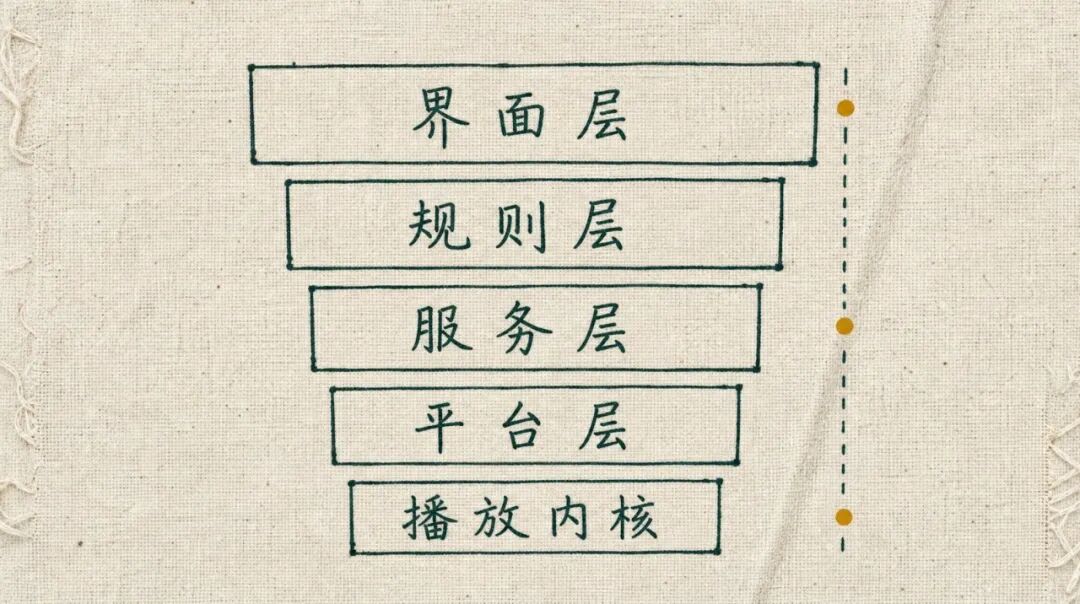
代码分层也顺着这条链切的:pages 只管界面和模型,repositories 管收藏、历史这类本地数据,services 装能力(网络、播放、嗅探、同步、存储、着色器),webview 单独一层收掉平台差异,plugins 是规则的数据模型。UI 层里看不到一行 XPath。
能装在哪,从哪装
这类 App 的平台问题比一般软件要紧,因为它要的是「一个真的浏览器环境」,而这个能力在各平台上参差不齐。
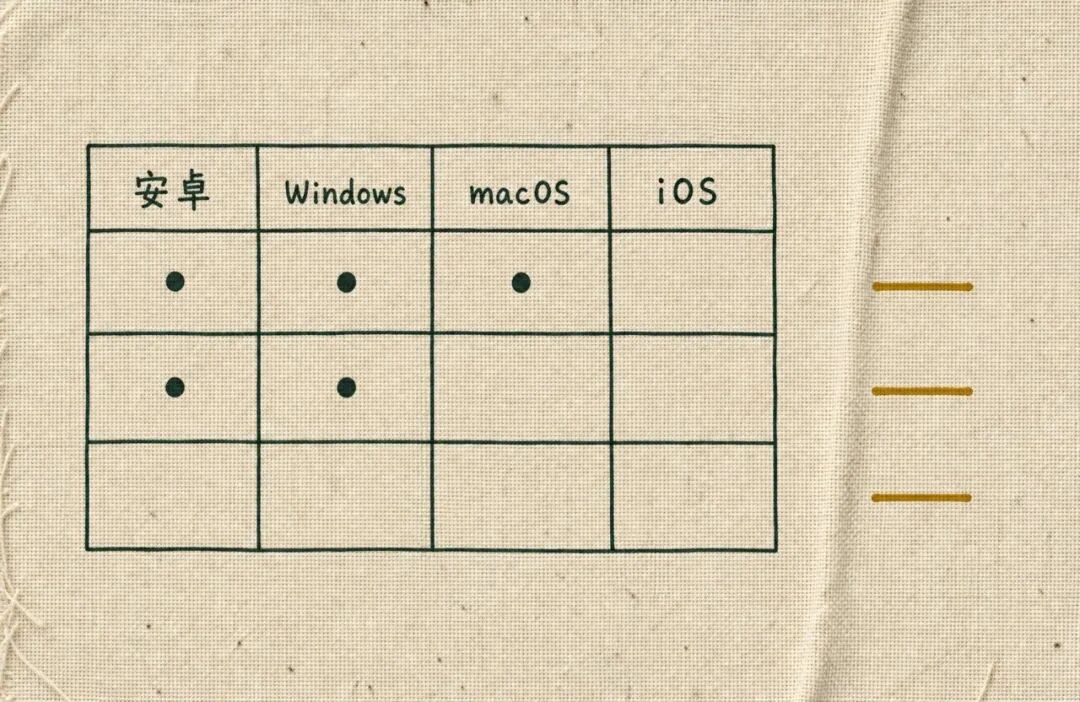
| 平台 |
门槛 |
从哪装 |
实际状态 |
| Android |
10 及以上 |
F-Droid、GitHub Releases |
主力 |
| Windows |
10 及以上 |
GitHub Releases |
主力 |
| macOS |
10.15 及以上 |
GitHub Releases |
主力 |
| Linux |
— |
Flathub、AUR、deb |
实验性 |
| iOS |
13 及以上 |
侧载 |
能跑,上不了架 |
| HarmonyOS |
5.0 及以上 |
侧载,分支仓库 |
分支维护 |
| 浏览器 |
— |
分支仓库 + 自建服务端 |
同局域网访问 |
「侧载」这两个字,就是这类工具在移动端的真实处境:功能没问题,上不了架。
Android 走的是 F-Droid——那个只收开源应用的商店,不进 Google Play。Linux 走 Flathub,Arch 的 AUR 上另有两个包(kazumi 从源码构建,kazumi-bin 装二进制)。Windows 与 macOS 靠 GitHub Releases 直接下。
Linux 后面那个「实验性」有具体所指,不是客套:用 .deb 装才有图标和托盘,tar.gz 版先天缺这两样。README 自己写着,tar.gz 只是「方便二次打包」。这不是功能缺失,是打包格式决定的。
Web 那一条最绕。主仓库里留着一个 web 目录,但真正能跑的 Web 版在另一个分支仓库,而且需要一台电脑或者 Docker 起服务端,同局域网里的设备再用浏览器访问。
它不是「打开网页就能看」,是「一台机器在跑,别的设备借它的手」。这个形态不是偷懒,是被第四道关逼出来的——它必须有一个能跑 JS、能拦响应的真浏览器环境。
用什么搭的
一门语言:Dart,跑在 Flutter 上。pubspec.yaml 里钉的 SDK 下限是 Dart 3.10,Flutter 3.47.9。
选 Flutter 的理由不难猜——一套 UI 铺到这么多平台。但真正决定它长成现在这样的,是下面这些不太显眼的选择:
| 用途 |
依赖 |
为什么是它 |
| 模块化与注入 |
flutter_modular |
按页面切模块,播放、设置、下载各自独立注入 |
| 状态管理 |
mobx / flutter_mobx |
播放进度一秒变几次,需要可观察对象做细粒度刷新 |
| 本地存储 |
hive_ce |
纯 Dart 键值库,不依赖 SQLite,各平台行为一致 |
| HTTP |
dio + cookie_jar |
拦截器好写,cookie 能持久化——第三道关全靠它 |
| XPath |
xpath_selector + xpath_selector_html_parser |
纯 Dart 解析 HTML,不用真浏览器就能跑选择器 |
| JSONPath |
json_path |
外面另套了自己写的白名单校验 |
| 播放 |
media_kit(libmpv 绑定) |
一个后端吃遍 m3u8 与 mp4,还能塞 GLSL |
| WebView |
flutter_inappwebview 加两个社区实现 |
平台差异太大,没有一套能通吃 |
| 弹幕 |
canvas_danmaku |
Canvas 直绘,几千条弹幕不建 Widget |
| 同步 |
webdav_client |
服务端就是个网盘,不用自己写后端 |
| 投屏 |
dlna_dart |
把地址丢给电视,协议本身很薄 |
这张表里有两处值得多说。
第一处:它接管了自己的依赖。
media_kit 用的不是官方版本,是作者自己维护的分支;Windows 的 WebView 换成作者自己维护的 flutter-webview-windows,Linux 换成同样自己维护的 linux_webview_window;连后台音频那两条平台桥(MPRIS 与 Windows 媒体会话)都是自己接手改过的版本。
原因不复杂:它要的能力太偏。WebView 得在文档开始前注入脚本、拦请求、在不显示的情况下把 JS 跑完;播放器得运行时改 mpv 属性、往 glsl-shaders 塞文件路径。上游要么没有,要么各平台不一致。
代价是所有上游的 bug 和更新都得自己接。这是个很重的决定,但对着它要做的事,几乎没得选。
第二处:没有后端。
除了一个放文档和规则仓库的静态站,它没有自己的服务器:番剧数据借 Bangumi 的,弹幕借弹弹 play 的,同步借你自己的 WebDAV。
好处是连「服务挂了」这种故障都不会有——因为它没有服务。反过来,任何一环外部接口变了,它也只能跟着变。
规则仓库那边有个很现实的处理:国内直连 raw.githubusercontent.com 经常不通,所以内置了三个镜像(gh-proxy、ghfast、GitCode),设置里可切。这种细节不会出现在任何架构图里,但它决定了是「点一下就装上」还是「转圈转到放弃」。
顺带说清一件容易误会的事:Flutter 只解决了 UI 那一层。
WebView 在每个平台上都是另一套东西,所以它给 WebView 写了四份实现——Android、Apple(iOS 与 macOS 共用)、Linux、Windows,外加一个抽象基类。同一段「加载页面、注入脚本、等流地址」的流程,四份实现各对接各自的原生能力。嗅探那段注入的 JS,也因此存在四份拷贝。代理同样分平台:Android 走系统的 PROXY_OVERRIDE,其余各走各的。
第一关:把站点写成五行
规则长什么样?仓库里一条真实的长这样:
{
  "name": "LMM",
  "version": "1.2",
  "baseURL": "https://www.lmm92.com/",
  "searchURL": "https://www.lmm92.com/vod/search.html?wd=@keyword",
  "searchList": "//div[1]/div/div/section/div//div",
  "searchName": "//div/div[2]/h6/a",
  "searchResult": "//div/div[2]/h6/a",
  "chapterRoads": "//div[1]/div[2]/div/div[1]/section[2]",
  "chapterResult": "//a"
}
就这些。剩下的字段(版本号、UA、是否用 POST、是否走旧解析器)都有默认值,不填也能跑。
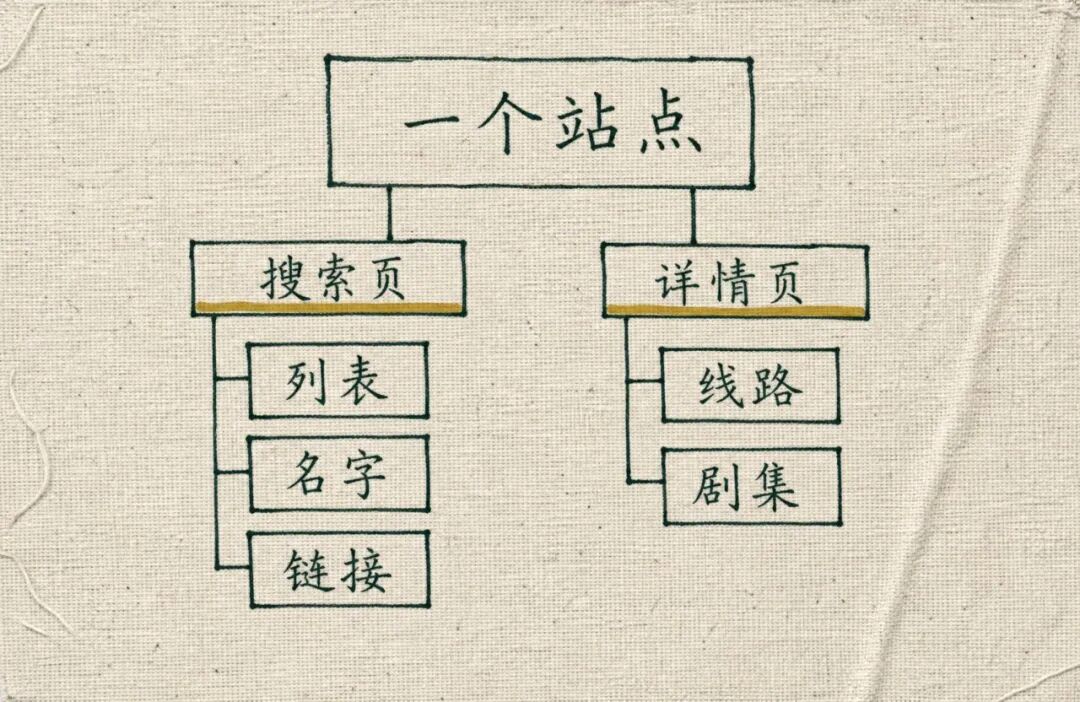
社区里有个说法:用最多五行 XPath 就能描述一个站点。这个「五行」不是随口说的,数一下正好:
| 行 |
字段 |
管什么 |
| 1 |
searchList |
搜索结果里,一个结果对应一个节点,把这一批选出来 |
| 2 |
searchName |
在单个结果节点内部,取番剧名 |
| 3 |
searchResult |
在单个结果节点内部,取详情页链接 |
| 4 |
chapterRoads |
详情页里,一条播放线路对应一个节点 |
| 5 |
chapterResult |
在单条线路节点内部,取每一集的链接 |
searchURL 不算在选择器里,它是网址模板。所以「五行」这个说法卡得很准。
看懂这张表,就看懂了这套设计的关键:它是两级的。第一级选出一批节点,第二级在每个节点内部再选。所以第二条和第三条写的 //div/div[2]/h6/a,不是「从整个页面找」,而是「从我手上这个结果节点往下找」。
在代码里一目了然:
final nodes = root.queryXPath(config.searchList).nodes;
for (final node in nodes) {
  final name = node.queryXPath(config.searchName).node?.text?.trim();
  final source = node.queryXPath(config.searchResult).node
      ?.attributes['href']?.trim();
}
两级的好处是规则写得短,坏处是写错一级,整条规则静默失效——不报错,只是搜出零条。所以引擎里塞了一堆诊断:哪个节点缺名字、哪个节点缺链接、哪条线路一集都没抓到,都会记一条日志。
规则里有个细节容易被扫过去:
"searchName":   "//div/div[2]/h6/a",
"searchResult": "//div/div[2]/h6/a"
两条一模一样。不是写错了。同一条 XPath 选中的是同一个 <a>,取它的 text 就是番剧名,取它的 href 就是详情页地址。这个设计省了一行选择器,也解释了为什么五行够用——名字和链接在网页里通常就长在同一个链接上。
真正省不下来的是章节那两行。线路和剧集是包含关系:一个详情页可能有三条线路,每条下面挂几十集。所以 chapterRoads 选线路容器,chapterResult 在容器内部选 <a>。结果是每条线路被命名成「播放线路 1」「播放线路 2」,每集的名字取链接文本,文本为空就退化成「第 3 集」这类序号名——这些都不是站点给的,是引擎自己补的,因为站点经常给不全。
为什么是五行,不是一段脚本
这里有个值得停一下的问题:既然规则是用来抓网页的,为什么不直接让人写一段脚本?
因为脚本一旦能跑,规则就不再是「配置」了。
你从群里收到一条别人分享的规则,粘进去。如果它能执行代码,那它就能读你的 cookie、翻你的文件、往外面发请求。你根本没法审计——它长得和正常抓取逻辑一模一样。
声明式的五行 JSON 没有这个问题。你打开文件,一眼能看到它只做三件事:请求这一个网址、按这五条路径取节点、取文本或 href。没有循环,没有条件,没有函数调用。能做的事被限制死了,所以能看懂了。
代价也很直接:表达力不够。有些站点要多翻一层、要先取 id 再拼地址、要按某个字段过滤,五行写不出来。这时候有两条路——要么退回 API 模式让接口自己过滤,要么这个站点就不支持。中间没有「写点小逻辑」的灰色地带。
这个取舍在开源工具里很常见,但很少有人把它说破:限制规则的能力,保护的是使用规则的人。
再补一个几乎没人提的限制:它对 XPath 的支持是子集,只认以 // 开头的表达式。绝对路径(/html/body/div)、显式相对路径(./div)、各种轴(following-sibling::)都用不了。所以规则仓库里每一条规则无一例外都以 // 开头——不是大家的编码习惯,是解析器只吃这一种。
这个限制反倒帮了忙。// 的意思是「从任意位置往下找」,天然不依赖层级;绝对路径只要中间插进一个 <div> 就全废。与其支持完整的 XPath 让人写出脆规则,不如只开一条路,逼所有人写宽松的。
第二关:引擎只做三段
规则是数据,得有个东西把它跑起来。这个东西叫 RuleEngine,做的事情拆开只有三段:
准备请求。 把 searchURL 里的 @keyword 替换成用户输入的关键词,做 URL 编码;如果规则声明了用 POST,就把 query 参数挪到表单体里。
执行请求。 带上 referer、cookie、UA,发出去,拿到 HTML 或 JSON 原文。这一步失败分两类:网络层失败,和「返回了但内容是验证页」。
解析响应。 按 searchMode 或 chapterMode 交给对应策略,XPath 的交给 XPath 策略,API 的交给 API 策略。
三段串起来,任何一段抛异常,都会被包装成带插件名的错误类型(SearchErrorException、ChapterErrorException),这样界面上能说清是「LMM 这条规则搜不动」而不是「出错了」。
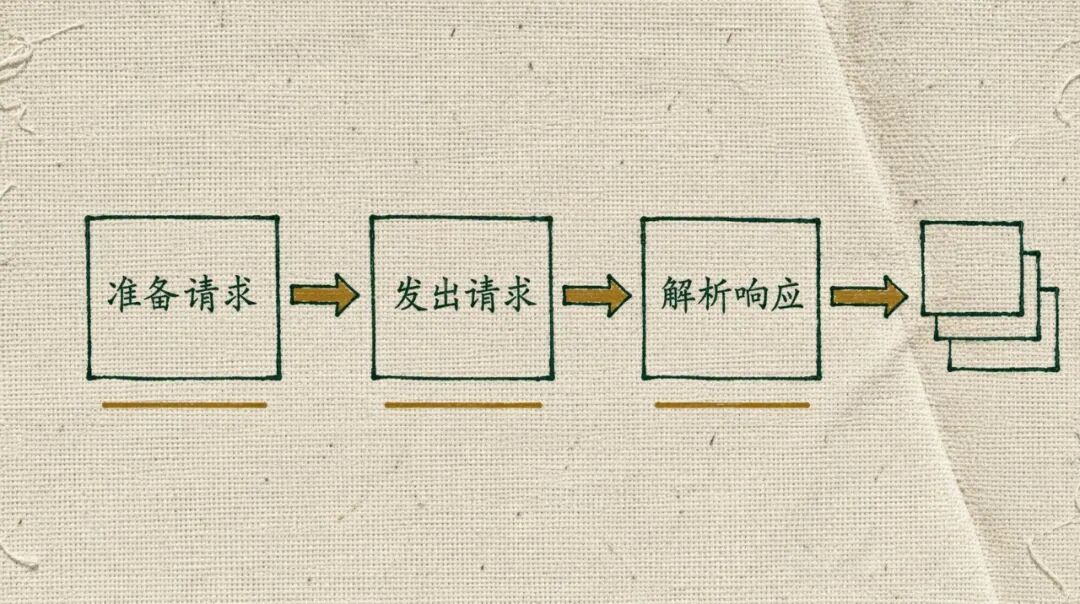
关键在设计上的一点:搜索和章节可以走不同的策略。
searchMode 和 chapterMode 是两个独立字段。所以完全可能「搜索走 XPath 抓网页,章节走 API 拿 JSON」。这不是炫技,是因为很多站点就是这样:列表页服务端渲染,接口另一套 JSON。
有些站只给 JSON
XPath 模式的前提是「你能拿到 HTML」。碰上一整站前端渲染、接口返回 JSON 的,XPath 一行都写不了。
于是有了第二套:API 模式。规则里要写请求模板和三个 JSONPath:
{
  "searchMode": "api",
  "searchApiConfig": {
    "request": {
      "method": "GET",
      "url": "https://example.com/api/search",
      "query": { "kw": "@keyword" }
    },
    "listPath": "$.data",
    "namePath": "$.name",
    "sourcePath": "$.url"
  }
}
method 只认 GET 和 POST,POST 的 body 支持 JSON 与表单两种编码,请求头、query 都能在规则里写死。listPath 选出数组,namePath 和 sourcePath 在这条记录内部取值——和 XPath 模式一样是两级的。
还有个 sourceTemplate:接口返回一串 id,详情页得自己拼 URL,就把模板写成 https://example.com/detail/@source,@source 会被替换。空着就原样用。
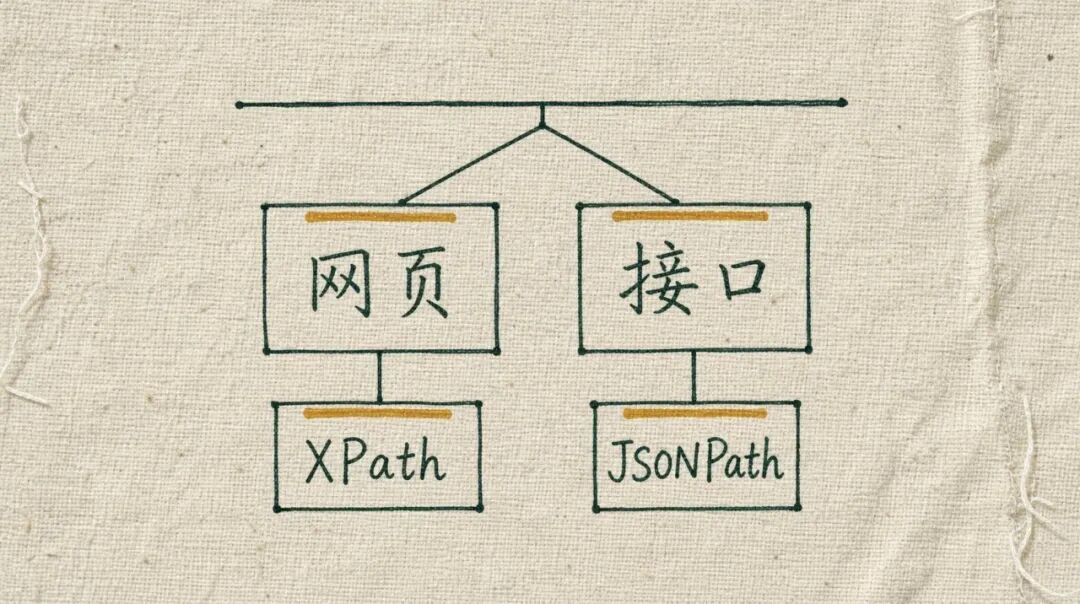
这套 JSONPath 有个很不寻常的地方:它自己写了个校验器,先验语法,再执行。白名单只有四种——. 后跟字段名、[0] 这种下标、['key'] 这种带引号的键。
别的写法一律抛异常。
if (!isIndex && !isWildcard && !isQuoted) {
  throw ApiRuleFormatException('不支持的 JSONPath 片段: [$content]');
}
为什么这么抠?因为完整的 JSONPath 支持过滤表达式,比如 $.data[?(@.type == 'tv')]。这一句在很多实现里会被当成一小段代码去求值。
而规则是别人写的、可以从外部导入的。一旦允许过滤表达式在本地跑,规则就不再是「配置」,而是「可以执行的逻辑」。这道门一开,后面就没底了。只放四种写法,够覆盖「取列表、取字段、取某个下标」这些真实需求,又把求值挡在外面。这不是限制功能,是限制攻击面。
第三关:站点不一定给
规则写对了,站点也不一定给你数据。
现在很多资源站前面挂了一层挑战页:先证明你是浏览器,才给你真页面。这类拦截对 XPath 是致命的——你请求拿到的是挑战页,解析出来零条,看起来像规则写错了。
Kazumi 的处理是把这件事显式建模成一类错误:CaptchaRequiredException。
检测有三条路,规则里选一条:
- XPath:页面上存在某个元素就算挑战(比如某个特定的
div#challenge)
- 文本:响应原文里包含某段字符串
- 正则:响应原文匹配某个模式
除了这层页面级检测,代码里还有一道更硬的判据:看响应头里有没有 cf-mitigated: challenge。这个头是 Cloudflare 托管挑战自己标的,碰上响应体为空、被压缩坏、或者 Dio 在某些平台上拿不到 body 的情况,它是唯一还活着的线索。
final cfMitigated = response?.headers.value('cf-mitigated');
if (cfMitigated?.toLowerCase() == 'challenge') return true;
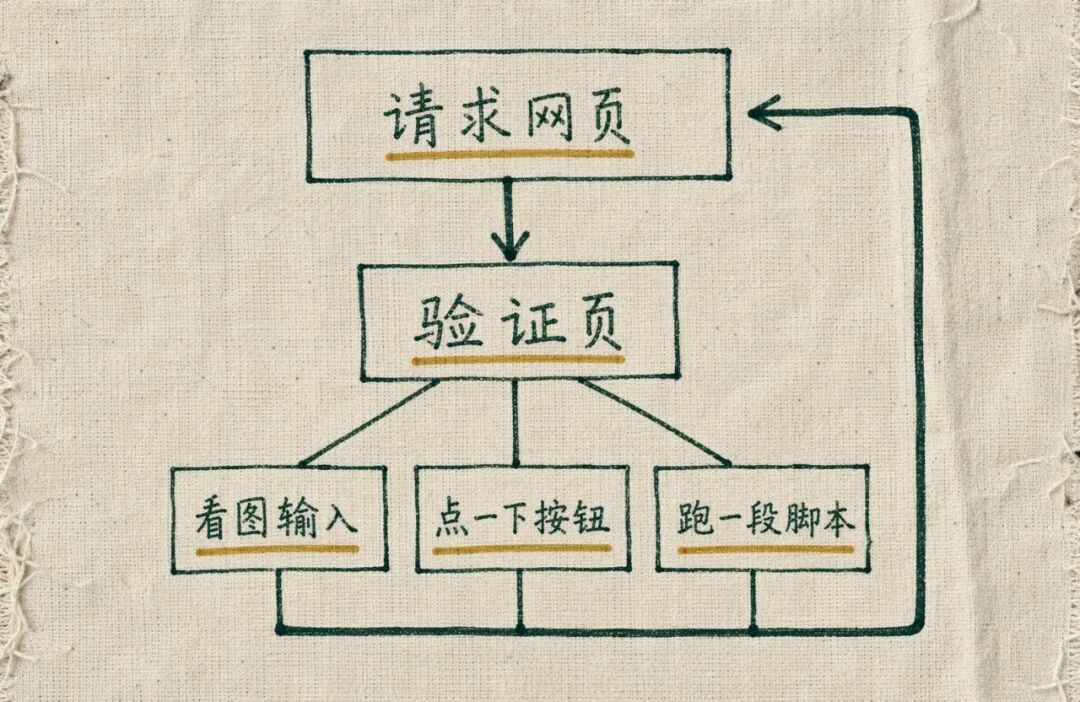
判定为挑战之后,流程切到 WebView:把搜索页真的加载出来,让人看见挑战长什么样,再按规则指定的方式过掉它。过法有三种——图片验证码(抓像素给用户看,用户输入,程序去填输入框、点提交)、自动点击「我不是机器人」这类按钮、以及规则里直接给一段自定义 JavaScript。
过了之后,cookie 存下来,回头重试那次 XPath 搜索。这时请求带着凭证,拿到的就是真页面。
这里有一段是整篇里最像「踩过坑的人写的」。
Cloudflare 发的清除 cookie,是绑定 User-Agent 的。它记住的是「这个 UA 刚才过了验证」,换一个 UA 来,等于没验证过。
而 Kazumi 的规则里允许写自己的 userAgent,代码里还会在没有规则 UA 时随机挑一个。于是出现必然的矛盾:验证时用的是 A 浏览器、UA 是 A;验证完发 XPath 请求,规则说 UA 用 B。站点一看凭证和 UA 对不上,又给你一张挑战页。
解法直白得有点狠:
// Clearance cookies are bound to the User-Agent they were issued to,
// so the verified UA overrides the rule's own; sending a different one
// would make the site serve the challenge page again.
if (verifiedUserAgent != null) 'user-agent': verifiedUserAgent;
验过证的 UA,优先级高于规则里写的 UA。 规则作者想指定 UA 的自由,在通过验证之后被剥夺了——因为不剥夺就必然复发挑战页。同一个函数里还有个细节:请求头全部转成小写键,这样规则里写 User-Agent 和我们写 user-agent 会撞在一起被后者覆盖,而不是发出两个互相打架的头。
还有一处更像历史遗留:XPath 的搜索请求带 cookie,章节请求不带。代码注释写得很坦白——「历史上章节请求就是不带 cookie 的,只有搜索带」。这种句子一看就是被现有行为逼出来的,不是设计出来的。
第四关:剧集页里没有视频地址
到这里,最容易被误解的一步来了。
很多人以为抓完剧集链接,下一步就是从那个链接里取出 mp4 地址。不是。
剧集页面里通常没有视频地址。它是一个播放页:页面加载后跑一段 JS,拉播放器脚本,播放器再去请求播放列表,最后才把流地址塞进 <video> 或者喂给 MediaSource。
你能抓到的,是一个会自己长出视频地址的网页,而不是一个视频地址。
所以 Kazumi 的做法是:开一个不显示的 WebView,把剧集页真的加载出来,让页面自己跑,然后在它跑的过程中把地址截下来。
自己用 HTTP 客户端请求那个页面,拿到的只是一堆带 onclick 的 HTML,JS 不会执行,播放器不会初始化,流地址永远不会出现。就算能执行,很多站还会校验 referer、校验 cookie、校验某个只在浏览器里才有的对象。你得有一个真的浏览器环境,才有资格看见那条流。
WebView 的配置也能看出目的:随机 UA、禁图片(blockNetworkImage 和 loadsImagesAutomatically 都关掉)、关缓存。禁图这一条尤其说明问题——它根本不需要给你看,只需要页面把 JS 跑完。
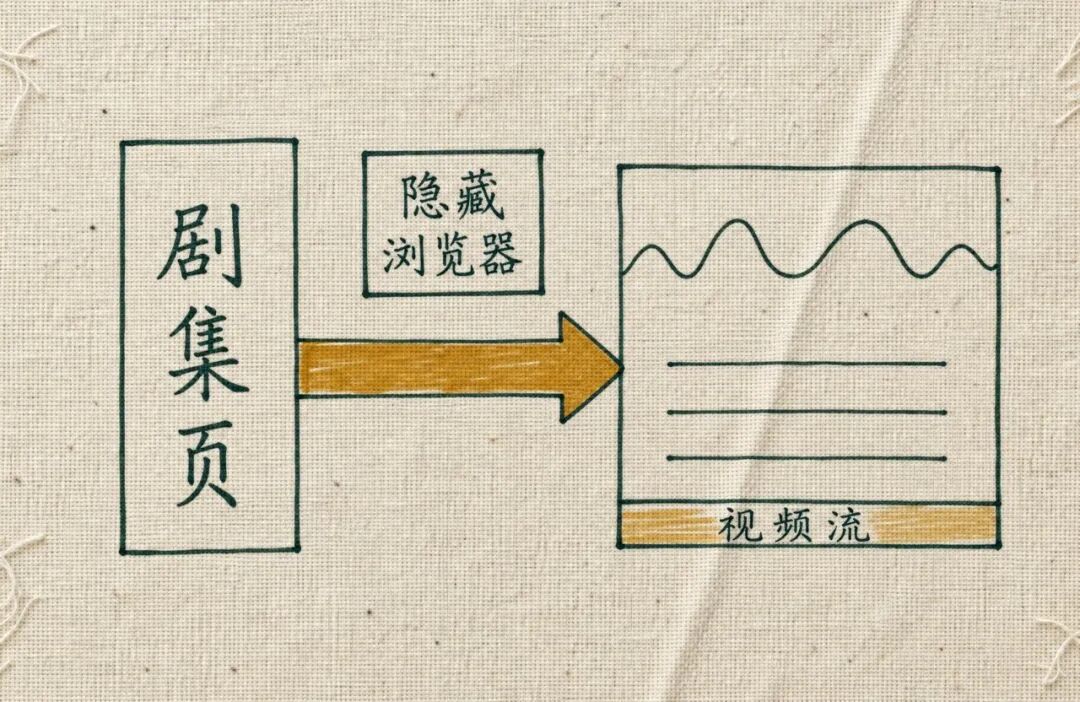
截流的具体手法,是注入了两段脚本,都在文档开始时注入(AT_DOCUMENT_START),赶在页面自己的脚本之前把自己挂上去。
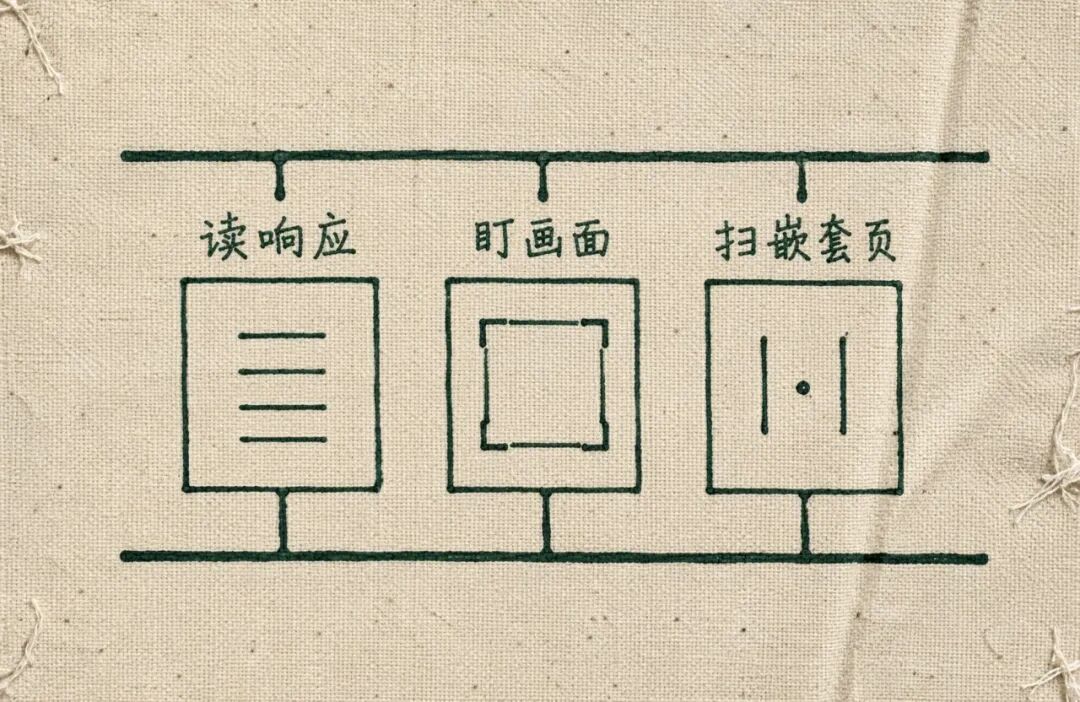
第一条:劫持响应读取。
const _r_text = window.Response.prototype.text;
window.Response.prototype.text = function () {
  return new Promise((resolve, reject) => {
    _r_text.call(this).then((text) => {
      resolve(text);
      if (text.trim().startsWith("#EXTM3U")) {
        window.flutter_inappwebview.callHandler('VideoBridgeDebug', this.url);
      }
    }).catch(reject);
  });
};
同一段里还把 XMLHttpRequest.prototype.open 包了一层,监听 load 事件读 responseText,同样的判据。
判据是 #EXTM3U——m3u8 播放列表的第一行。不看 URL 后缀,原因很简单:大量源的地址长得像 https://x.com/hls/abc123?sign=...,一个 .m3u8 都没有。看内容开头比看地址可靠得多。
第二条:盯 video 标签。
用 MutationObserver 监听整个文档树的属性变化和新增节点,盯着 <video src> 和 <source src>。拿到非空、不是 blob:、不含 googleads 的地址就收工,顺手把 observer 断开。
跳过 blob: 是必须的——用 MediaSource 播放的页面,video.src 永远是 blob:https://... 这种本地伪地址,真正的流在别处。所以对这类页面,第一条劫持才是唯一出路。
第三条:老路子,扫 iframe。
规则里的 useLegacyParser 打开时,注入的是另一段脚本:盯所有 <iframe> 的 src,拿到就回抛。Dart 侧再用正则从 iframe 地址的查询参数里抠出真正的地址:
final regExp = RegExp(r'(http[s]?://.*?\.m3u8)|(http[s]?://.*?\.mp4)',
    caseSensitive: false);
params.forEach((key, value) {
  if (regExp.hasMatch(value)) matchedUrl = value;
});
逻辑很朴素:有些站把播放页整个套在 iframe 里,iframe 地址带着一堆参数,其中一个参数的值就是 .m3u8。挨个参数试一遍,谁匹配取谁。它显然是给「地址带后缀」的老站点准备的,所以被标成了 legacy。
拿到 .m3u8 也不等于拿到干净内容。HLS 的播放列表是一份纯文本清单,按时间顺序列着一堆分片,有些站会把广告剪成几个分片直接插进去——它和正片在同一条流里,跳过键没用,画面识别也无从下手。
Kazumi 的处理在清单层,靠 EXT-X-DISCONTINUITY。这个标签本来是给「分段之间编码参数变了」准备的:正片切广告再切回正片,前后时间戳不连续,就得标一个。但正因为广告插播一定造成不连续,它顺手成了广告的指纹。
判据很朴素:按 discontinuity 分组把清单切成若干段,算出每段总时长,最长的那段当正片,其余段里明显偏短的判为广告,剔掉。注释写着这是「模仿 FFmpeg 的 hls_ad_filter」——思路确实不是它发明的,转码工具里早有同名滤镜干同样的事,区别只是 FFmpeg 跑在服务端,它跑在客户端。
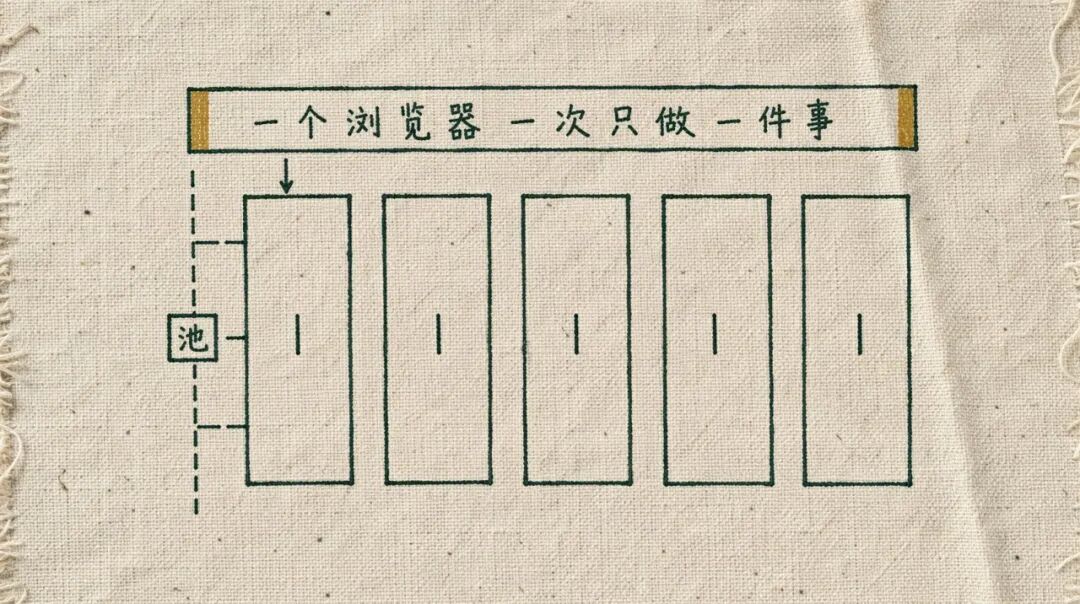
一个 WebView 只能干一件事
截流这套办法有个硬约束:一个 WebView 同一时刻只能加载一个页面。
而用户可能同时在切集、在下载、在预载下一集。全挤在一个 WebView 里,会互相踩。
代码里的处理是两层:单实例内串行,实例之间并行。
单实例内,用一个 Future 链把请求排成队:
final resolveFuture = resolveTail.then((_) => _runResolve(...));
_resolveTail = resolveFuture.then<void>((_) {}, onError: (_) {});
后一个请求挂在前一个的尾巴上,前一个失败也不影响后一个排队。同时,新请求进来会先把上一个标记取消——不是等它跑完,是让它在下一次检查点时自己抛出去。
实例之间是一个池子:VideoSourceResolverPool,上限五个 worker,用租约(lease)管。同一个 key(同一集)已经有租约在手,第二次请求直接拿不到,避免重复解析。租约释放时,如果这个 worker 该退休了,就顺手销毁,不留着占内存。
每个解析还带着超时,默认 15 秒。实现方式是把「解析完成」和「取消信号」两个 Future 扔进 Future.any 竞速,谁先到算谁。页面加载完立刻 unloadPage() 跳去 about:blank 把资源放掉——WebView 实例留着复用,页面不留在内存里。
第五关:播放器是 libmpv
拿到流地址之后,事情才交回播放器。
播放这块的底层是 mpv,通过 media_kit 这层 Dart 绑定接进 Flutter。这里要说清一件事:mpv 不是一个「播放控件」,它是一个完整的播放内核——解封装、解码、渲染全在自己身上,自带的 ffmpeg 负责读 m3u8 和 mp4,不借系统解码器。
这解释了它为什么敢接一堆来源杂乱的流:系统的 ExoPlayer、AVPlayer 对畸形清单和异常时间戳的容忍度,跟 ffmpeg 那套不是一回事。也解释了它为什么非得自己塞一个播放器进来——用系统播放器,等于放弃一半的源。
代码里的初始化只有一行 MediaKit.ensureInitialized(),之后所有行为都是运行时改属性。招数不多,但都很实在:
选渲染器。 Android 上分三档:gpu(OpenGL)、gpu-next(Vulkan)、mediacodec_embed(硬件解码直出)。默认 auto,判断条件是系统版本——Android 14 及以上走 gpu-next,以下走 gpu。注释把理由写明白了:Vulkan 1.2 在着色器上表现更好,但 Android 13 及以下有些机型支持不佳,会直接黑屏。这不是「新系统就上新技术」的偏好,是被黑屏教育出来的分界线。
降功耗。 选了 mediacodec_embed 就同时把 hwdec 设成 mediacodec,并且强制把超分关掉——不是提示一句「可能不支持」,是直接把档位拧到 off。因为硬件解码直出把画面直接交给显示层,中间没有可以插 shader 的位置,这个组合在结构上就不成立。
保音调。 倍速用 scaletempo2=max-speed=8,变速不变调,上限八倍。Android 上音频输出还要显式指定 ao(audiotrack 或 opensles),否则某些机型会掉到静音。
控缓存。 demuxer-max-bytes 与 demuxer-max-back-bytes 默认放到 1.5 GB,这就是 README 里「播放时内存占用较高」的来源——它在拿内存换拖进度条时的顺滑。开了低内存模式、或者检测到走的是计量网络(手机热点),这两个值会掉到 2 MB。
四件事没有一件是「换个 Widget 就能做到」的。它们全是 mpv 的属性,说明这个播放器在这里被当成一台可编程的引擎在用。
超分的实现同样「mpv」:把 Anime4K 的 GLSL 文件拷到一个可读目录,运行时发命令:
await pp.command(['change-list', 'glsl-shaders', 'set', shaderPathList]);
// 关闭时
await pp.command(['change-list', 'glsl-shaders', 'clr', '']);
shaderPathList 是把若干个 .glsl 的绝对路径拼成一个字符串,Windows 用 ; 分隔,其他平台用 :。这就是 mpv 的原生约定,Kazumi 只是照着拼。
两档滤镜,串法不一样:
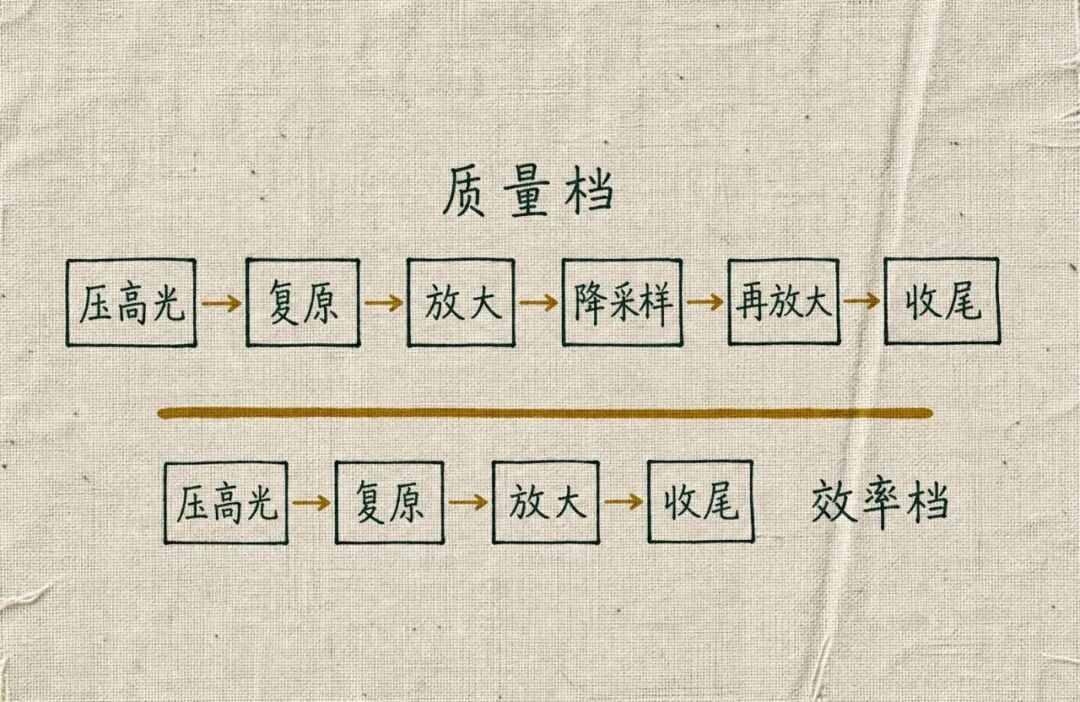
质量档:先压高光,再上 VL 档的 CNN 复原,再 VL 档的 2 倍上采样,然后根据目标分辨率自动降采样,最后补一道 M 档上采样。
效率档:压高光,M 档和 S 档各复原一次,M 档上采样,自动降采样,再补一道 S 档上采样。
VL / M / S 是 Anime4K 的三档网络体量,越大的恢复细节越多、算得越慢。质量档用 VL 打头阵,效率档用 M+S 堆叠——用两道小网络换一道大网络的活,这是移动端常见的省算法。那些 GLSL 是真长,VL 那档的复原着色器里塞的是训练出来的卷积权重,不是手写的数学公式。
超分不是免费的。
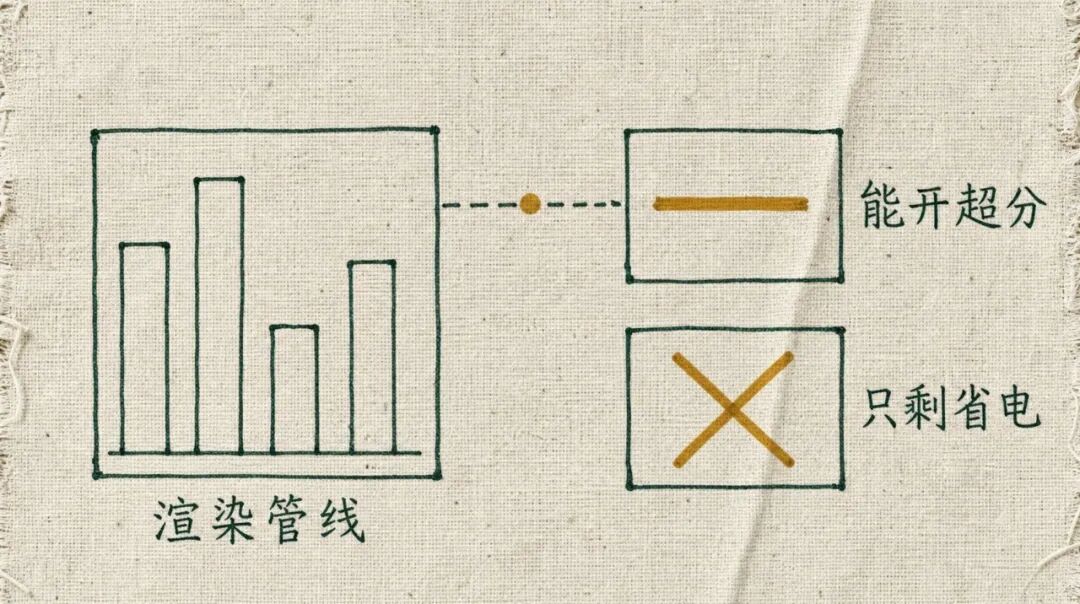
播放器设置里有四种渲染器,选项说明里只有 mediacodec_embed 那一条后面明写着:功耗最低,不支持超分辨率。
不是「可能不支持」,是结构上不可能。超分是在解码后的画面上插一道全屏卷积,画面得先进 GPU 的渲染管线;硬件解码直出是把结果直接交给显示层,中间没有那个可以插 shader 的地方。
所以想开超分,就必须放弃最低功耗那条路。想在低端机上省电,就得关掉超分。这两件事只能选一个。这笔账在移动端特别贵——VL 档的卷积不是一次,是每一帧都跑一遍;4K 输出意味着每个像素都在算。结果是发热、掉帧、耗电三件事一起上来。效率档存在的意义,就是给这条线留个退路。
播放器这一层还接着几根管子:后台播放用一套跨平台音频服务,桌面上各自对接系统媒体控制(Linux 的 MPRIS、Windows 的媒体会话),系统面板上按暂停能真的暂停;投屏走 DLNA,把地址丢给电视;外部播放器则是把 URL 和 referer 一起交出去。
这些能力全是「把地址交出去」的变体。所以前面那句「反盗链的源给不了外部播放器」在这里会露出来:DLNA 和外部播放器都拿不到那个已经验证过的浏览器环境,地址出门就失效。
只有内置播放器能带着整套上下文去请求。这也是这套架构的本质——它的能力来自「我模拟了一个浏览器」,而不是「我破解了地址」。 一旦离开那个环境,地址就废了。
除这五关,还有几件事
弹幕不自己攒。 走弹弹 play 的开放接口:按番剧名和集数去匹配,匹配上了把列表拉回来。格式是 m 加 p 两段,m 是内容,p 是逗号分隔的四段——时间、类型、颜色、来源,一条长这样:{"m": "来了来了", "p": "12.345,1,16777215,BiliBili"}。类型里 1 是滚动、4 是底部、5 是顶部;颜色是 RGB 整数。这个格式几乎是照着 B 站早期 XML 弹幕抄的,好处是现成的弹幕库都能直接吃。
匹配这一步是整条链路里最容易无声失败的地方。番剧名差一个字、季数标错、集数编号从 0 还是从 1 开始,都可能匹配到别的番,或者干脆匹配不到。匹配不到时界面不报错,就是一条弹幕都没有——你得自己判断是「这集确实没人发」还是「认错番了」。
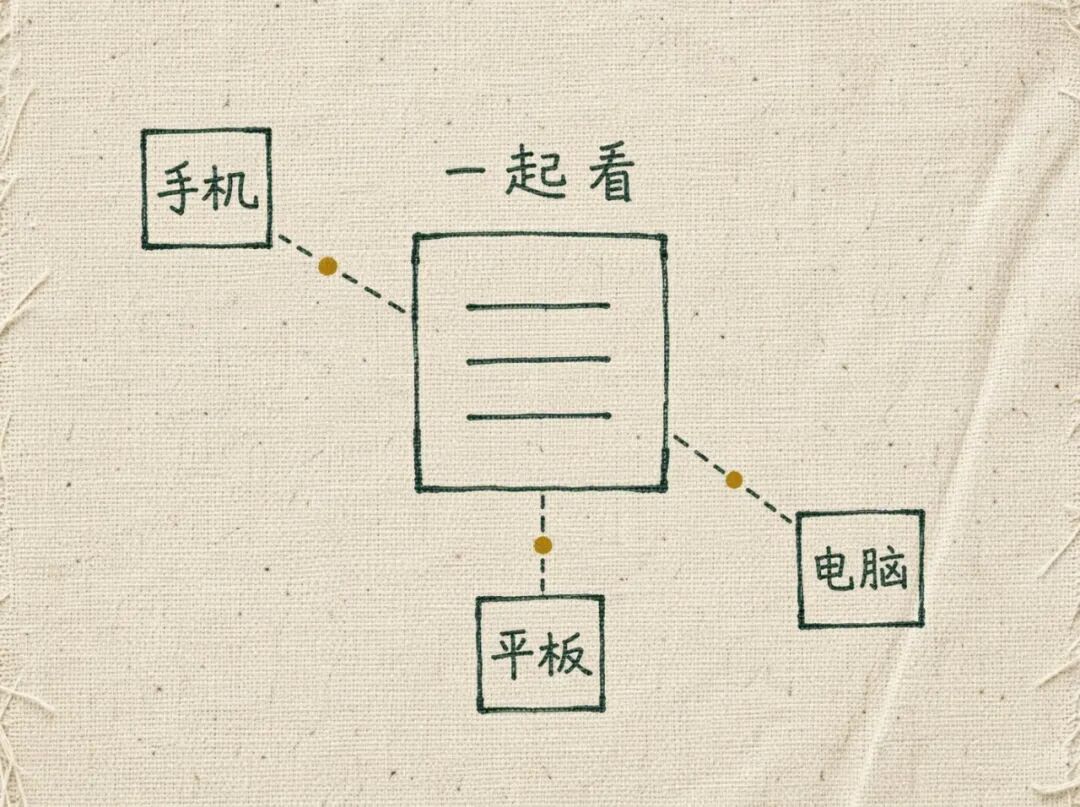
一起看靠一个老协议。 走的是 SyncPlay,一个专门为「多人同步播放本地文件」设计的开源协议。握手是 Hello:报房间名、用户名、自己支持哪些特性。之后不断交换 State:播到第几秒、是不是暂停、这次改动是谁发起的。再加 Ping 往返测延迟。
代码里有个细节值得单独说:RTT 用滑动平均算,新样本权重 0.85。意思是「以历史为主,新值只修一点点」。这样网络抖一下,同步不会跟着跳一下;代价是真变慢时,要过好几拍才追上来。一秒钟的漂移没人注意,一秒钟的抖动所有人都能感觉到——所以他们选了怕抖动。
追番记录不存状态,存事件。 同一个功能,两台设备各看了一半,怎么合并?
最直觉的做法是「后写的覆盖先写的」。一旦涉及进度,这条规则马上就错——你在手机看到第 8 分钟,电脑看到第 12 分钟,按时间戳取大的,看上去对。但如果你在手机上往后拖了一下又退回去,这个动作也会刷新时间戳,结果电脑上那段真看的进度被一条假进度覆盖了。
Kazumi 的做法是每次进度变化往一个 .jsonl 文件里追加一行事件:哪个设备(deviceId)、第几个序号(seq)、哪一集、哪条线路、进度到哪、什么时候改的。
{"device":"a1b2c3","seq":418,"ep":7,"road":1,"progressMs":735000,"time":1762000000}
用事件而不是状态,合并就变成一次重放:把两台设备的日志按设备分组、按 seq 排序,逐条应用,最后得到的状态是确定的。没有「谁覆盖谁」的歧义,因为从来没有覆盖,只有追加。
代价是文件会一直长。所以有个阈值:日志超过 1 MB 就做一次压实——把所有事件重放成一份快照,日志清空,从零开始记。压实不能占 UI 线程,得扔进 isolate。同步本身走 WebDAV,服务端就是一个网盘,什么逻辑都没有,所有合并在客户端完成。这也解释了为什么合并逻辑必须写得足够确定:它没有第二道保险。
它能干什么,不能干什么
把功能摊开,它其实是个相当完整的播放器:多源切换、选集、倍速、字幕、弹幕、投屏、外部播放器、下载、追番列表、跨设备同步、超分、一起看。
但边界同样清楚,而且每一条都能从代码里找到依据。
它不生产内容,也不托管内容。 规则指向哪个站,它就去哪个站取。站点有没有授权、片源合不合法,都不在它手里。
它不保证源可用。 规则是社区维护的,站点改版就失效。App 能做的只是标个「搜索有效」——那条标签背后是一次真请求、真解析,它没法知道你没在骗它。
它管不了广告。 README 里写得直白:项目本身没插广告,看到广告是视频源塞的。有些规则会开 adBlocker,但那是逐站适配,不是通用能力。
不是所有源都能给外部播放器。 一部分源用了反盗链,Kazumi 能过(因为它有一个真浏览器环境),把地址交给外部播放器就过不了。
三本账
时间账。 写一条规则,快则十分钟,慢则一小时。要打开站点、翻开发者工具、把结构看懂、写出五行、试错几次。规则仓库里有现成的可以抄,但抄来的东西别人能维护,你不一定能。
维护账。 站点改版是常态,不是意外。一条规则活了半年算长寿。这意味着「配好就不用管」是幻觉,实际是「隔一段时间就得回去看一眼」。这也是为什么规则要带版本号、要能一键更新,为什么规则里还要声明一个 api 版本——新规则被老客户端拿到时会响亮地拒绝,而不是解析出一半、在播放时才莫名其妙地失败。
合规账。 这一本最重,也最容易被跳过。它是一个「采集 + 播放」的框架,采集对象是别人网站上的内容。技术中立不等于使用中立,怎么用它,责任在使用的人。写这篇是拆技术,不是推荐用法。
三本账加起来,能得出一个不算好听的结论:这类工具的价值不在「省了会员费」,在「你能不能接受长期维护一份自己写的抓取配置」。
如果我来改,会先动这三处
读代码时记了几笔,不属于「bug」,属于「当初这么写有道理,现在该还了」。
第一处:把章节请求的 cookie 补上。 现在是搜索带 cookie、章节不带,注释写着这是历史行为。结果是一种很难查的状态——搜索通了,点进去章节列表空白,用户会以为规则写错了。这条债拖得越久,改的时候越怕影响别的站点。
第二处:把 UA 接管做成显式的。 通过验证之后,规则里写的 UA 被静默覆盖,规则作者完全不知道。至少应该在界面上标一下「本站已接管 UA」,别让人对着自己写的字段怀疑人生。
第三处:把嗅探脚本从四份实现里抽出来。 同一段 JS 在四个平台各有一份,改一处要改四处,还得保证行为一致。这类重复不会马上出事,但会慢慢长成「改了三处忘了第四处」的经典现场。
这三条有个共同点:都不是能力问题,是可维护性问题。一个项目能跑起来靠的是能力,能活五年靠的是这个。
结语
回到开头那个空界面。
装上之后什么都没有,这是它最不讨喜的地方,也是它唯一诚实的地方。
它没有假装自己知道片源在哪。它把这件事交出来:站点长什么样,你告诉我;怎么从里面取,我照做。
这套设计的每一处都在为「别人会变」做准备——规则带版本、引擎分三段、策略可切换、反爬做成配置、嗅探留三条路、解析器留一个 legacy。这些都不是优雅的设计,是应对变化的补丁。补丁摞补丁,就成了一个能用的东西。
而它真正做的事,其实只有一句话:把「网页里能看见的东西」翻译成「播放器能用的东西」。
翻译这件事,从来没有一劳永逸的版本。所有靠规则活着的工具,最后维护的都不是代码,是别人网站的耐心。这也是在 云栈社区 里不少做工具开发的人常聊到的一点——规则会过时,架构得能扛。
参考
- Kazumi 仓库:
https://github.com/Predidit/Kazumi — 规则模型、解析策略、WebView 嗅探与超分的一手材料
- 规则仓库:
https://github.com/Predidit/KazumiRules — 各站点的真实规则,可以对照着看五行怎么写
- 规则开发文档:
https://kazumi.app/docs/rules/develop-rules — 字段含义与编写流程的官方说明
- Anime4K:
https://github.com/bloc97/Anime4K — 实时超分着色器的原始项目与档位说明
 发表于 15 小时前
|
查看: 1|
回复: 0
 /1


