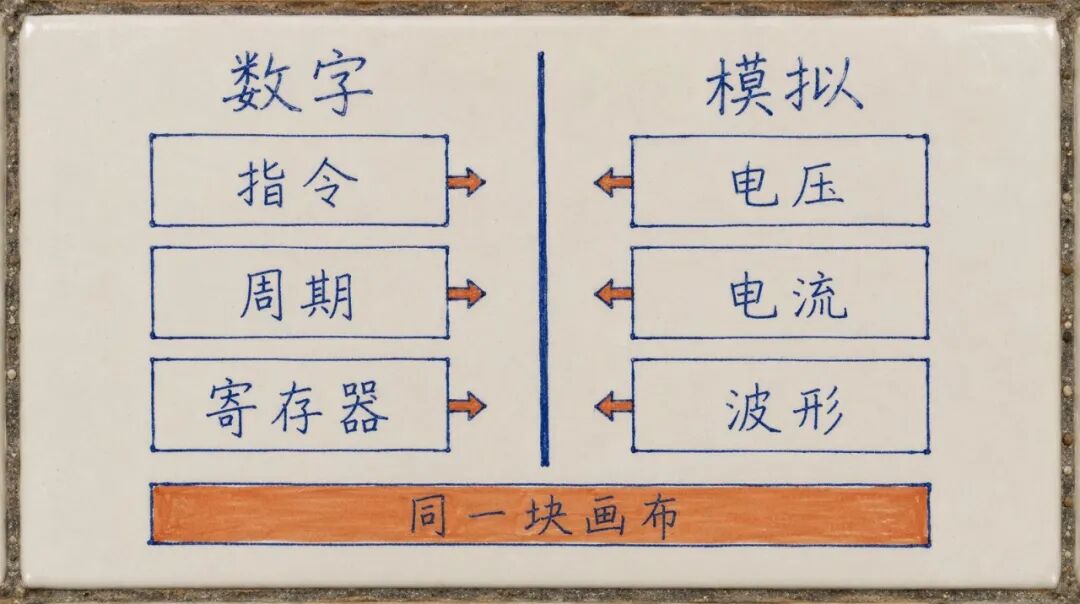
你在浏览器里接一块面包板:一个电位器、一颗 LED、一个单片机。拖动电位器,LED 亮起来,旁边的电压表跳出一个数字。整个过程没有真硬件,也没有联网。这件事听着像把「仿真」两个字贴上去就完了,难的地方在别处:单片机按指令周期往前走,电路按微分方程求稳态,这两个时钟根本不是一回事。Velxio 要做的,是让它们在同一个画面里对上。这篇文章拆它怎么对,以及在哪里对不上。
先说结论:这类工具真正难的不是「准不准」,是两个引擎的时间怎么对齐。
大多数人听到「浏览器里跑单片机」,第一反应是「模拟器写得像不像」。好像只要指令集覆盖全、外设做够,东西就对了。
真卡人的是另一层。单片机的世界是离散的:一条指令几个周期,一个循环跑几十万次。电路的世界是连续的:电容充电是指数曲线,电流随电压非线性变化。你让这两套东西互相喂数据,就必须回答一个问题——多久同步一次。
同步太密,算不动;同步太疏,行为就假。
Velxio 的答案是一个叫「准静态」的折中:每一毫秒握一次手。这个数字不是随便定的,它决定了这个工具能做什么、不能做什么。
先把它不是什么说清楚
这个词得先剔干净,否则后面全白讲。
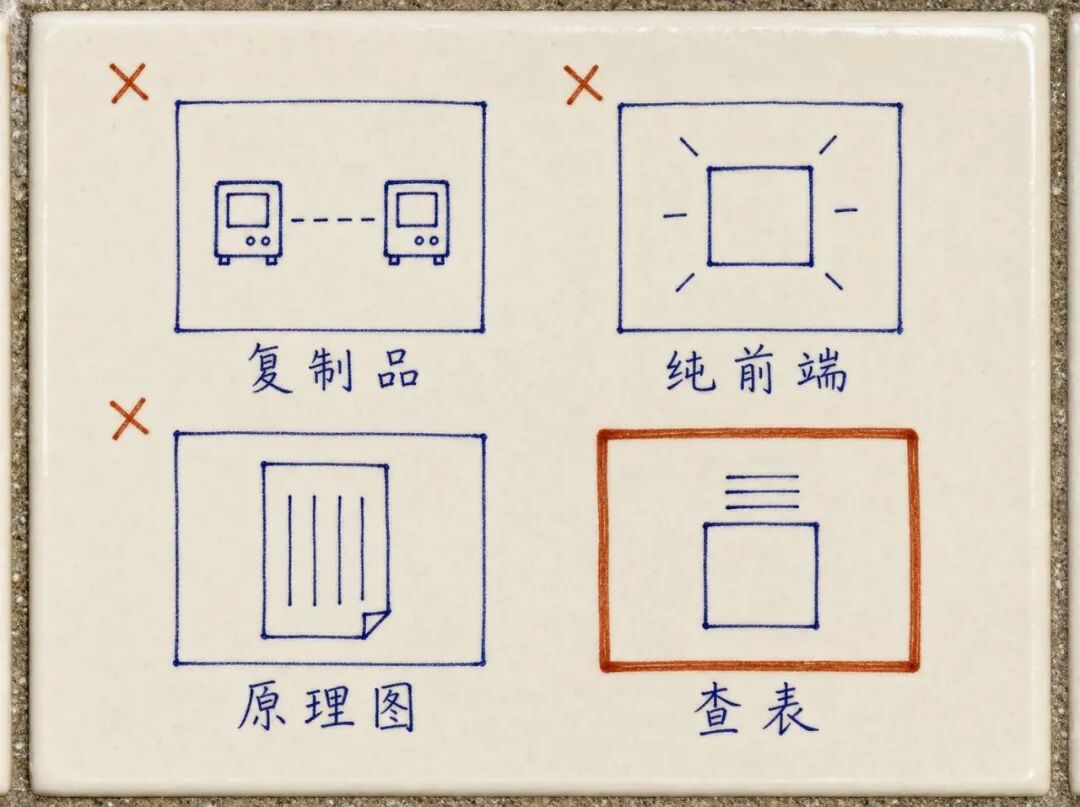
它不是 Wokwi 的复制品。 它大量依赖 Wokwi 生态——元件库用的是 wokwi-elements,AVR 和 RP2040 的模拟器分别是 avr8js 和 rp2040js,连项目文件格式都做了 diagram.json 的导入导出。但这些只是零件,把它拼成一个能跑模拟电路的整体,是另一件事。
它不是纯前端。 首页写着「全部在本地跑,数据不出你的机器」,这句话只对一半板卡成立。AVR 和 RP2040 确实在页面里跑;ESP32、STM32、树莓派那条线,后端真的开了一台 QEMU 虚拟机。
它也不是电路仿真软件。 它不是给你画原理图、跑 AC 扫频、做 PCB 前仿真的那类工具。它的中心是「一块能跑代码的板子」,电路是板子的外部世界。
它更不是一个教学玩具。 五个 CPU 家族全是真指令集执行,不是查表模拟高低电平。
那它是什么?一句话:一块把所有引脚都接到模拟电路上的虚拟开发板,代码真的在跑,电压真的在解。
拆成三块看:一块负责「跑代码」,一块负责「算电路」,还有一块最不起眼但最要命——负责让前两块在时间上对齐。
五类 CPU,两个住址
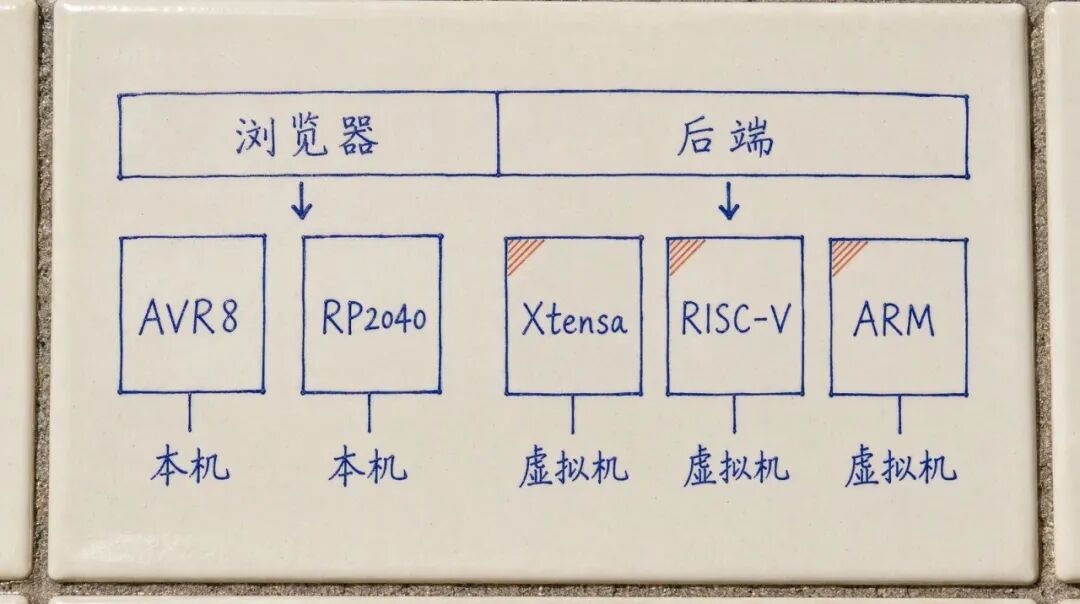
它支持五类 CPU,但跑的地方只有两个,而且分得很有道理。
| CPU 家族 |
板卡举例 |
跑在哪 |
| AVR8(ATmega / ATtiny) |
Uno、Nano、Mega 2560、ATtiny85 |
浏览器 |
| ARM Cortex-M0+(RP2040) |
Pico、Pico W |
浏览器 |
| Xtensa LX6 / LX7 |
ESP32、ESP32-S3、ESP32-CAM |
后端 QEMU |
| RISC-V |
ESP32-C3、ESP32-C6 |
后端 QEMU |
| ARM Cortex-A |
树莓派 Zero 到 5 |
后端 QEMU |
分界线不是「新不新」,是有没有人用 JavaScript 把这颗芯片写到指令级。
AVR 有 avr8js,RP2040 有 rp2040js,都是社区多年打磨的成果,能一条条指令执行、能挂 IO 端口监听、能精确到定时器寄存器。这两类放进浏览器,页面一打开就能跑,不用等服务器。
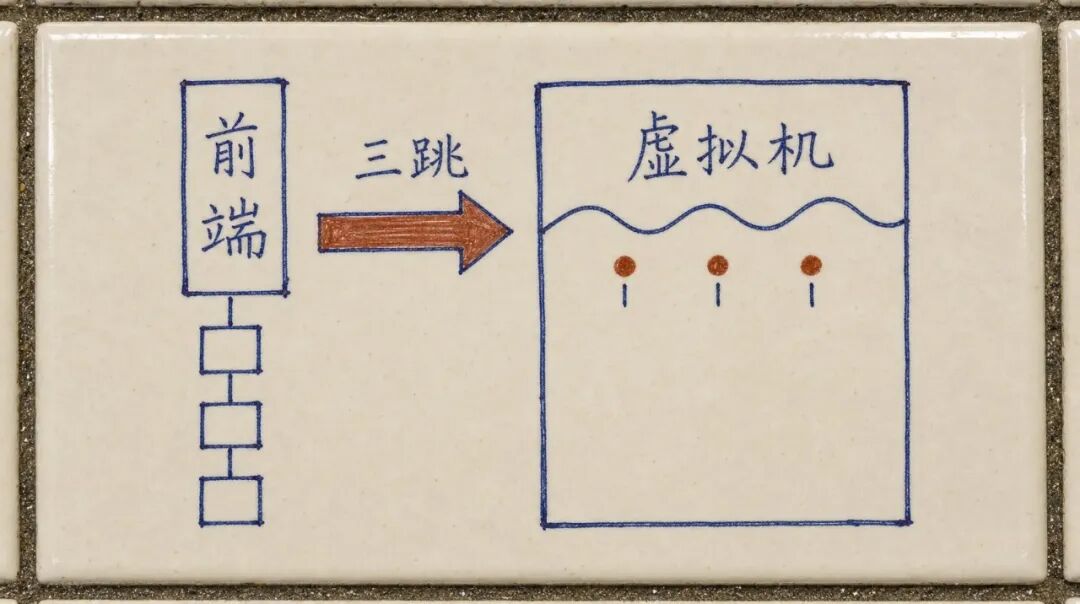
Xtensa 没有这样的东西,树莓派更没法谈——它要跑一整个 Linux。这两类只能交给后端:真的编译一份 QEMU,真的启动一台机器,把 GPIO 和串口从里面捞出来,通过 WebSocket 推回浏览器。
所以「本地优先」这个说法要分板卡看。你在 Uno 上写的东西确实一个字节都没离开浏览器;你在 ESP32 上写的东西,固件是发到服务器编译的,运行也是在那台服务器上的一台虚拟机里。
同一个门面,五个后端
有意思的地方在于,对上层来说这两个住址几乎没有区别。
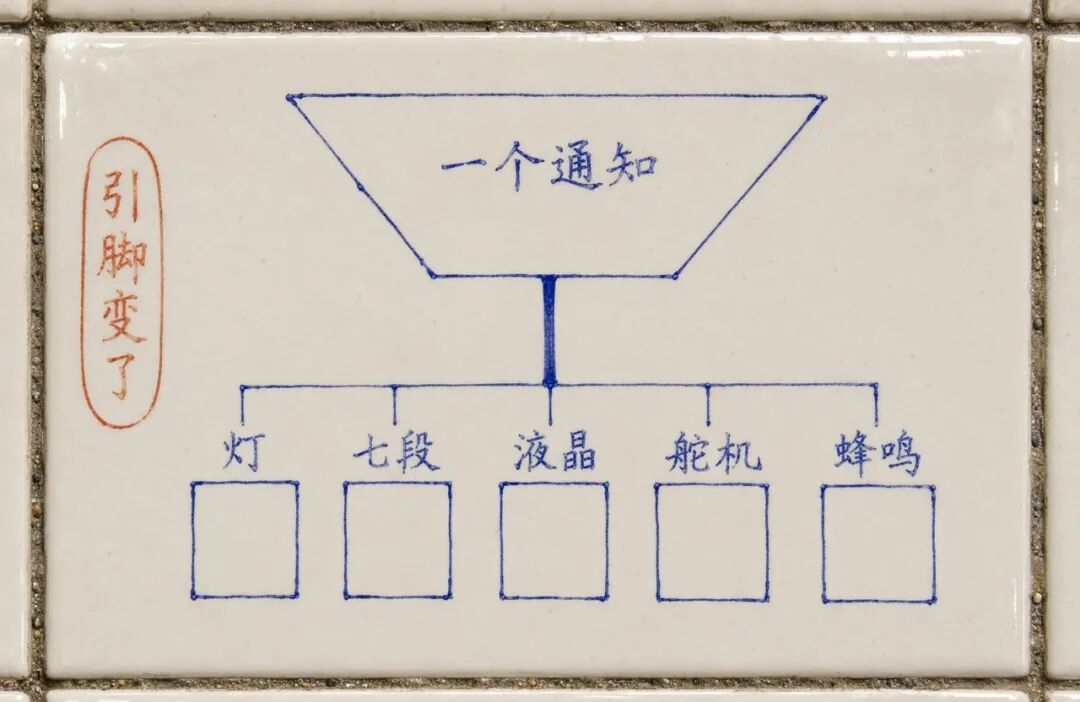
五个后端都实现同一套接口:启动、停止、设置某根引脚的电平、监听引脚变化。上面盖一层叫 PinManager 的门面,再往上是 PartSimulationRegistry——一个只管「引脚变了要通知谁」的注册表。
于是画布上的 LED 不知道自己连的是 JS 里的 AVR,还是三跳之外 QEMU 里的 Xtensa。它只收到一个通知:这个引脚从低变高了。
这套解耦做得很干净。加一种新元件,只需要写两个可选钩子:onPinStateChange(引脚变化时更新元件外观)和 attachEvents(用户操作元件时反向设置引脚)。不用碰画布代码。
已经挂上去的有十几类:LED 与 RGB LED、十段光柱、七段数码管、按键与拨码开关、电位器(数字模式下注 ADC 电压,模拟模式下变成一颗电阻)、摇杆、舵机(轮询定时器的比较寄存器换算角度)、蜂鸣器(读定时器寄存器驱动 Web Audio)、1602 与 2004 液晶(完整 HD44780 四位协议)、NeoPixel(解 RMT 的 24 位帧)、墨水屏。
值得注意的是最后那几类:示波器、电压表、电流表、函数发生器。它们不是「元件」,是探针——直接读写模拟引擎解出来的节点电压。
一帧跑两百多万个周期
AVR 在浏览器里怎么跑?按帧跑。
页面用 requestAnimationFrame,大约每秒六十帧。RP2040 的主频是 125 MHz,于是每帧要执行 125000000 / 60 ≈ 208 万个周期,一个周期对应 8 纳秒。
每帧的循环长这样:累加已执行的周期,到目标就停;没到就执行一条指令,把这条指令消耗的周期加进时钟。
问题来了。delay(1000) 在真机上是一亿两千五百万个周期的空转。如果老老实实一条条执行,浏览器会在这一秒里彻底卡死,而且这一秒的墙钟时间根本不够跑完——你等的是十倍以上的真实时间。
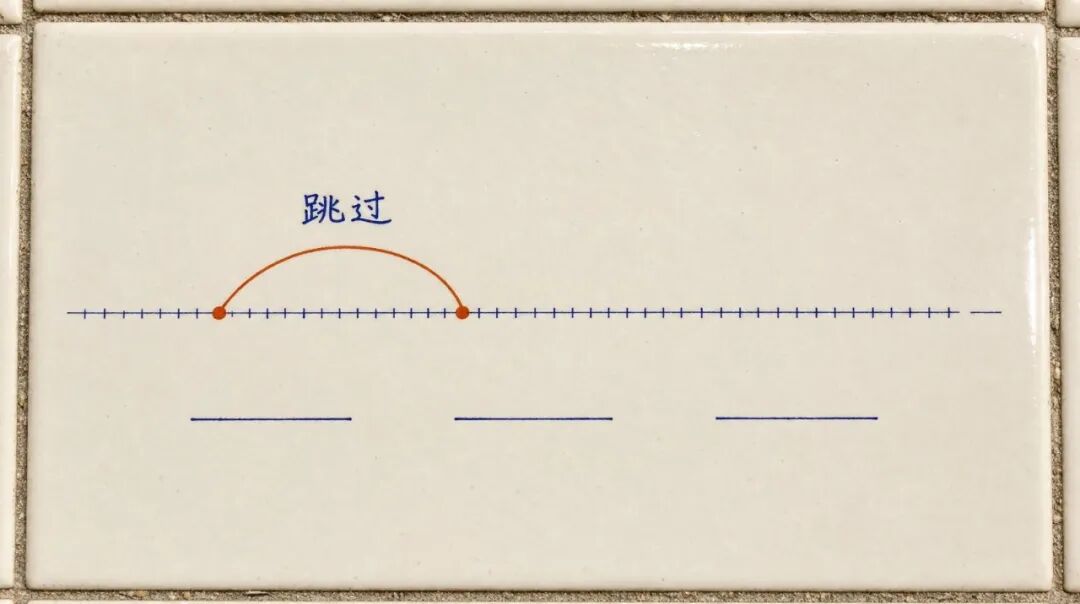
所以必须有「跳过」。
把等待直接跳过去
ARM 核在等中断时会执行一条 WFI 指令。真机上它就是睡着,等定时器把它叫醒。模拟器看到这条指令,不该去执行「睡着的空转」,而应该直接跳到下一个定时器闹钟。
代码里的判断很短:核心处于等待状态时,取「距离下一个闹钟还有多少纳秒」,把时钟直接推到那里,顺手把跳过的周期数记上。delay(1000) 于是只花几微秒的墙钟时间,而不是模拟一整亿个周期。
但还有第二种空转。很多 Arduino 的 delay() 实现并不是 WFI,而是一个「读时钟、比较、再读」的忙等循环。这种循环在模拟器眼里是一堆有副作用的指令,不能简单当成睡眠。
Velxio 的做法是加一个检测器:观察程序计数器和引脚快照,如果连续若干次都在同一小段代码里打转、而且引脚没有任何变化,就判定这是「无副作用的自旋」,把时钟快进过去。
跳过这件事本身会搞坏程序
这是我看这个项目时最服气的一个细节。
如果程序自己就在测时间,你替它跳过,它就测错了。
举个具体的:一段软件 UART 的发送代码,靠「循环几次」来凑出一个比特的宽度。模拟器一看,这段循环里引脚没有变化、PC 在小范围打转——判定为自旋,跳过去。结果就是每个比特都被跳过,每个脉冲宽度变得一样,接收端收到的全是乱的。
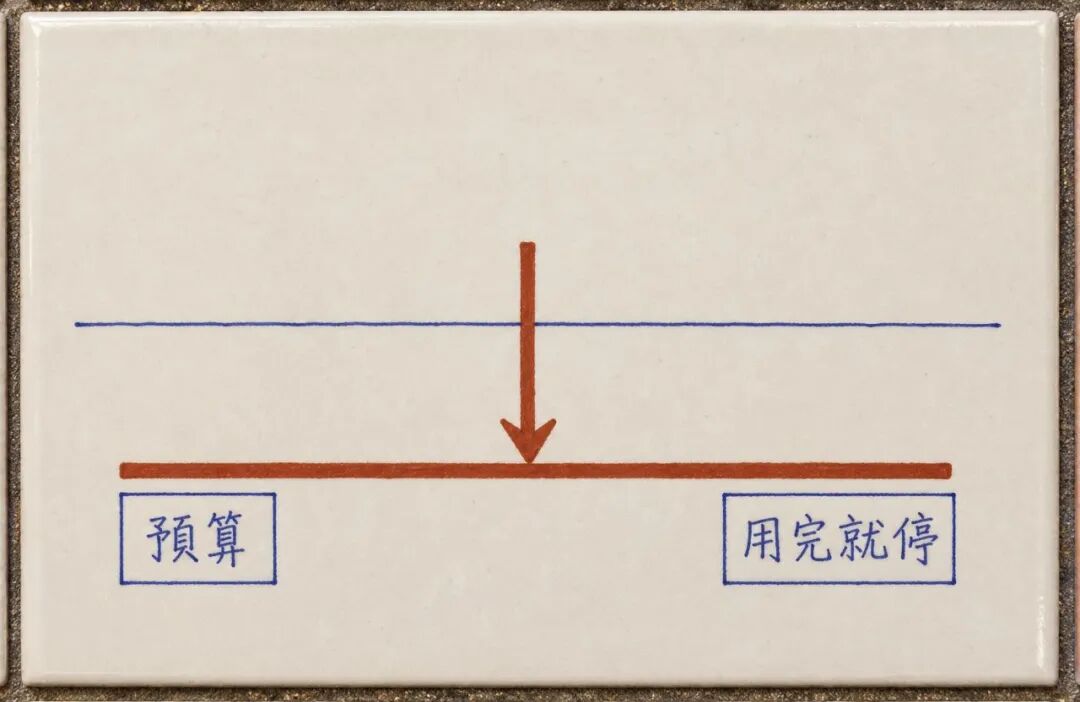
于是快进必须有个「地板」:当线路上有自定时的事务在进行时,跳过是有预算的,预算归零就只能老老实实执行那一条指令。
代码里那个 skipBudget 和 LineTimeline 就是干这个的。注释写得很清楚:WFI 那条分支不受限制,因为睡着的核心本来就不产生任何行为;但执行中的跳过必须服从地板,否则靠数自己循环次数来计时的固件会全部失真。
这个取舍很有代表性。模拟器的每一次「优化」,都在拿「像不像」换「跑不跑得动」,而判断哪里能省、哪里不能省,靠的是对真实程序行为的理解,不是性能分析器。
电路那边:一个三十九兆的引擎
数字侧靠 JS 模拟器,模拟侧靠什么?
靠 ngspice——那个被工业界用了三十多年的 SPICE 引擎,编译成 WebAssembly 塞进浏览器。这个东西的体积是三十九兆,启动要四百毫秒左右。
所以它不能是默认加载项。做法是懒加载:页面上有一个「电气仿真」的开关,用户点下去,浏览器才开始下载、初始化,四百毫秒之后才有东西可算。
这笔账很实在。如果把它做成硬依赖,每个访客一进页面就要拖三十九兆;做成开关,只有真正要算电路的人付这个成本。
顺带一提,这个包不是外部依赖,是打进 JS 模块里的,所以构建产物体积会直接涨这么多。这种「一个功能换一个数量级的包体」的决定,在小工具里很难下,在主打开放式模拟器的产品里又必须下。
网表是算出来的,不是画出来的
电路从哪来?从画布上那堆导线来。
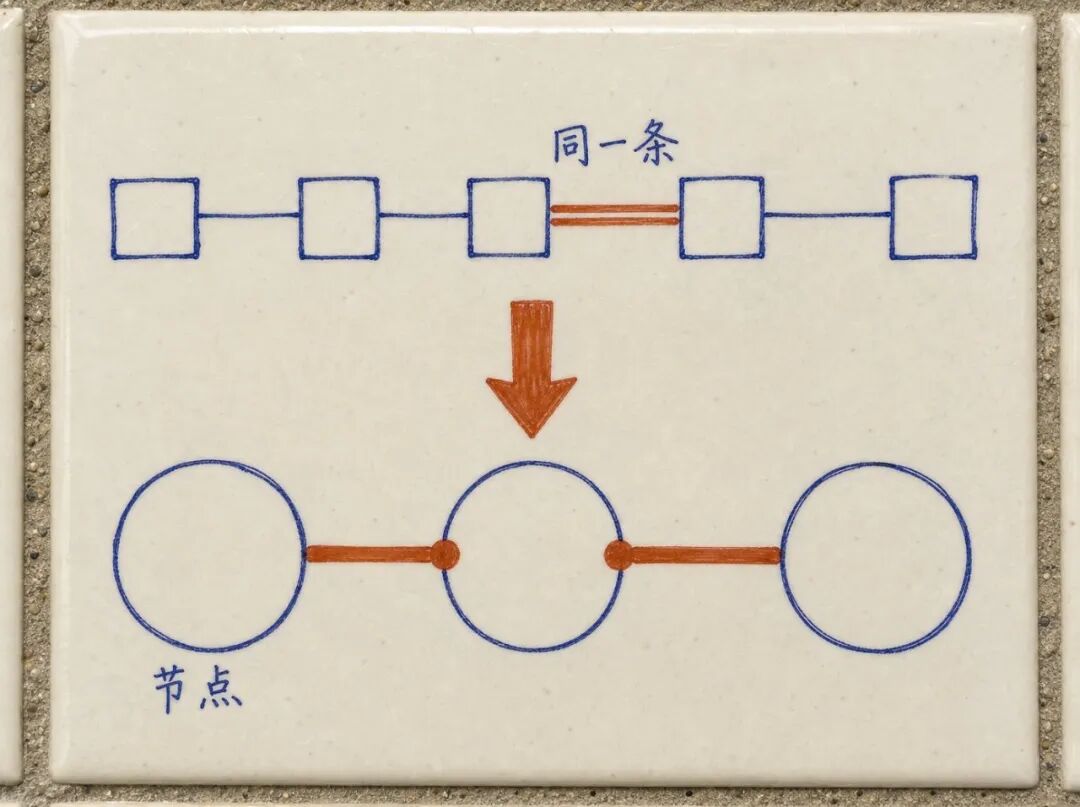
用户在画布上拉一条线,只是两个引脚之间的一条贝塞尔或折线;但 SPICE 要的是「哪些点属于同一个电气节点」。中间得有人做这个转换。
做法是并查集:把所有导线两两合并,最后得到若干个集合,每个集合就是一个节点;接地的那个集合不进矩阵。然后每个元件按自己的类型,往矩阵里「盖章」——电阻盖四分之一,电压源多开一行,电容在瞬态里换成伴随模型。
这一步听起来平淡,但它是整个模拟侧的地基。画布是给人看的,网表是给解算器看的,两者的语义差着一层。
数字引脚怎么变成一个电压源
真正把两边缝起来的是这一步。
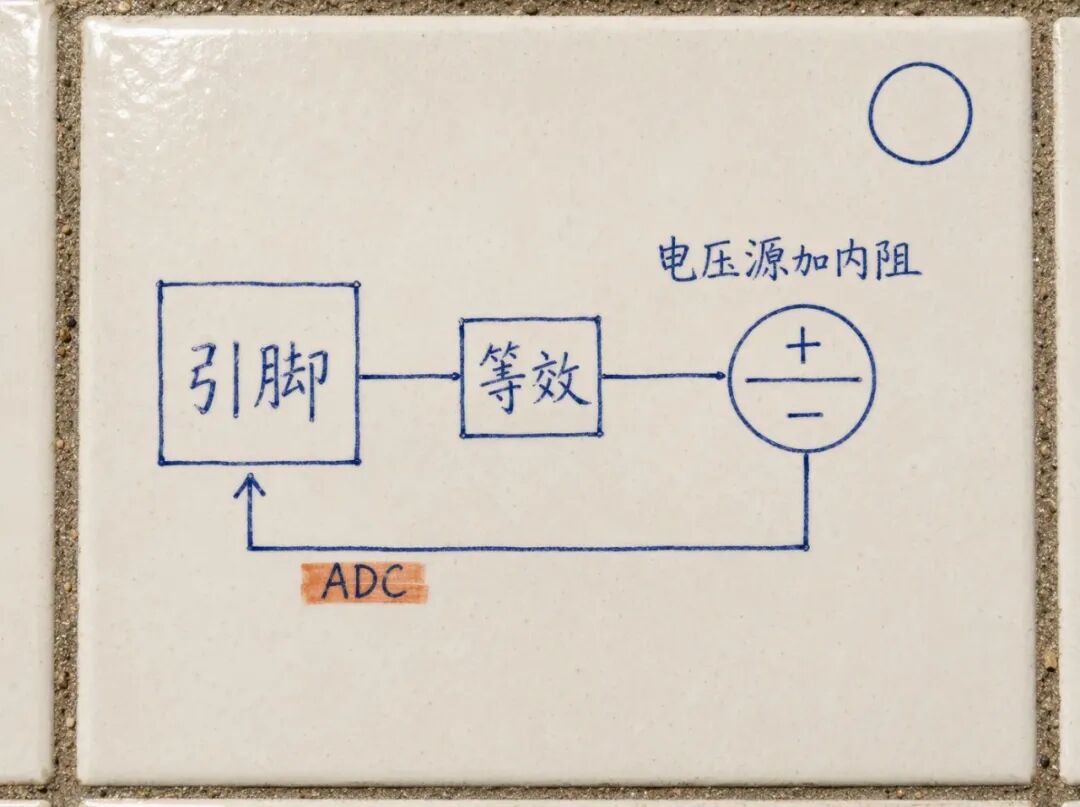
单片机的引脚输出高电平,在数字世界里就是「1」。但在电路里,它不是一个理想的 5 伏电池——它有输出内阻,拉电流时会掉压,和别的源并联时会分流。
所以每个数字引脚进网表时,都被建模成一个戴维南等效源:一个电压源串一个电阻,电压值取端口驱动状态(高电平、低电平、或者 PWM 的占空比折算出来的平均电压),电阻取驱动模型的内阻。
PWM 的处理尤其简单粗暴但有效:占空比 0.5 的 5 伏 PWM,直接当 2.5 伏的直流源送进去。对 RC 滤波这类慢速负载,这完全够用;对需要看纹波的场合,它就不够了。
ADC 回来的方向同理:解出来的节点电压,除以参考电压、乘上量化级数,写进 ADC 通道。于是 analogRead() 拿到的是解方程解出来的数,不是查表估出来的数。
一毫秒握一次手
现在回到开头那个问题:两个时钟怎么对齐。
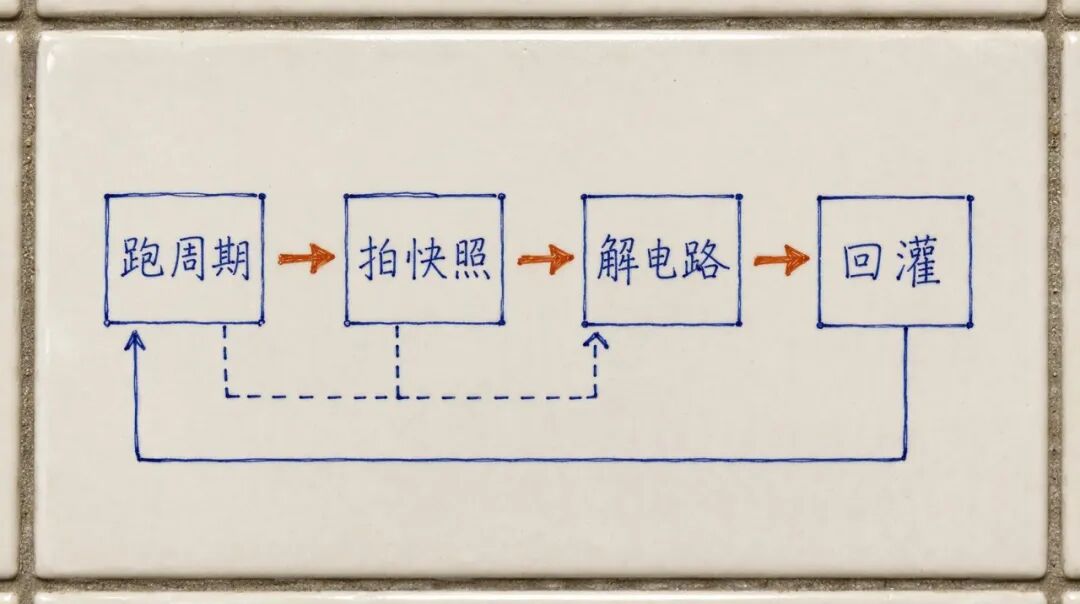
Velxio 的方案叫准静态共仿真,一毫秒一个时间片。每个片子里四步:
- 让 AVR 跑一万六千个周期(16 MHz 下的一毫秒),收集新的引脚状态和 PWM 占空比
- 把这些状态拍成一个快照
- 用快照建一张网表,跑一段
10 微秒步长、一毫秒时长 的瞬态分析
- 把每个模拟通道的最终电压,回灌给 AVR 的 ADC
注意第 3 步:这一毫秒里的模拟过程被完整算过一遍,但单片机只能看到最后那一个值。中间那一百个采样点被丢掉了。
这就是「准静态」的含义:在一毫秒的尺度上,假设模拟电路的动作快到可以当成瞬间稳定。
这个假设在很多场合成立。热敏电阻读温度、光敏电阻读光照、电位器读位置——这些物理量本身的变化时间常数是秒级的,一毫秒内几乎是直的。
但它也明确划出了做不到的事:音频速率的反馈环、模拟侧驱动数字侧再反过来影响模拟侧的振荡器、噪声与抖动分析。这些都需要两个引擎逐事件地互相让步,而不是每毫秒交一次班。
七十倍的账
代价是可以量化的。
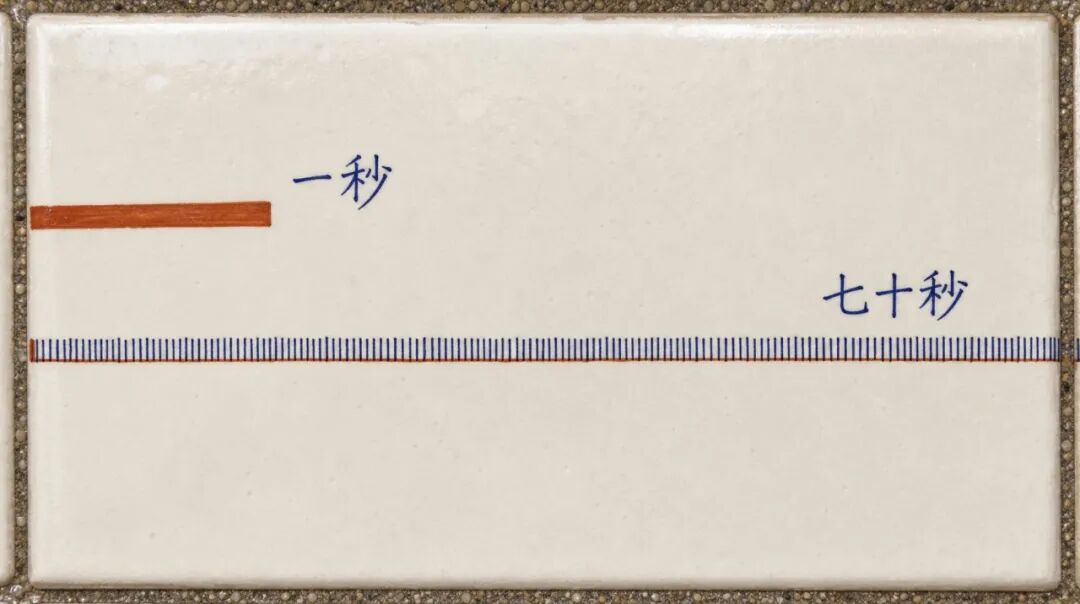
一次时间片里,AVR 跑一万六千个周期大约三毫秒,建网表不到一毫秒,ngspice 跑那段瞬态要四十到一百毫秒,注入回来几乎不耗时。合起来一拍四十五到一百零五毫秒。
于是一秒钟的单片机时间,要花大约七十秒墙钟。七十倍。
文档里对这件事的态度很坦率:测试场景可以接受,实时交互太慢。后面跟着五条缓解办法——把时间片放大到十毫秒、引脚没变就不重算、默认只跑直流工作点、网表缓存、把引擎丢进 Web Worker。
第五条最实际。不管算得多慢,只要它在 Worker 里,主线程就不会卡,拖动元件的动画照样顺。
这个数字也解释了为什么它敢把「电气仿真」做成一个开关而不是默认项:开着它,仿真速度就掉一个数量级。
自己写一个 SPICE 图什么
到这里有个反常的地方:已经用了工业级 ngspice,为什么还要在测试目录里手写一个求解器?
文档给了三条理由,每条都很实在。
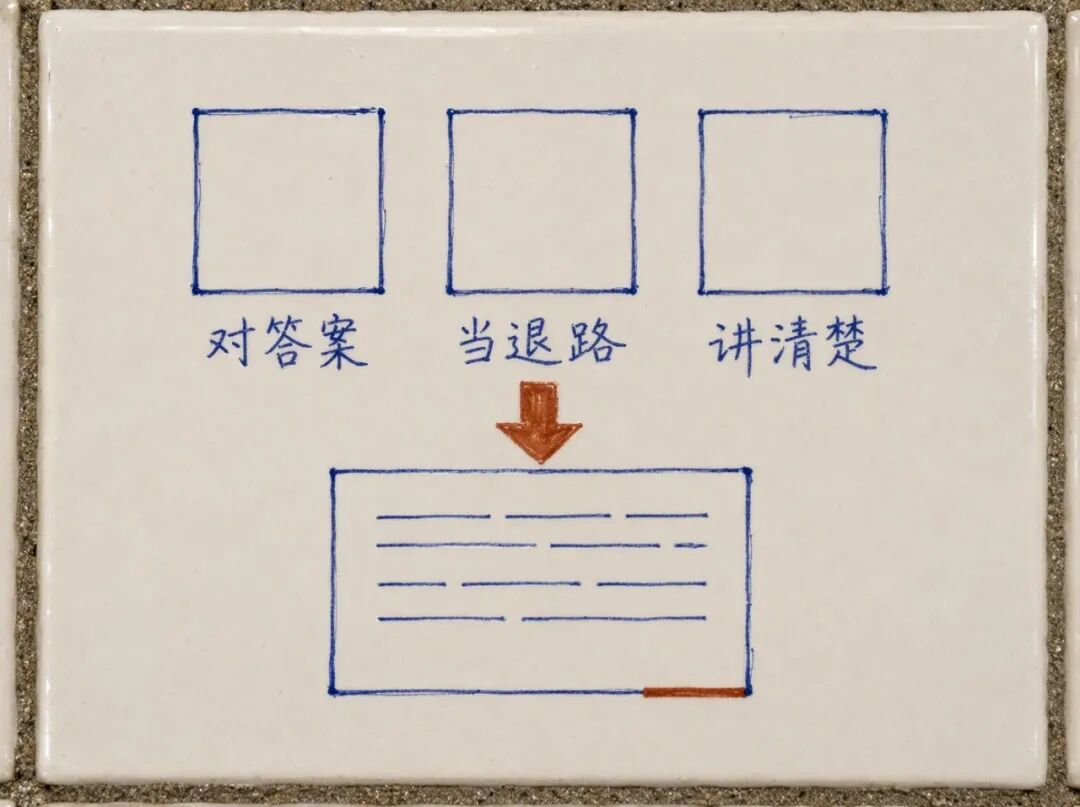
第一,当基线。 ngspice 是个黑盒,你给它网表它给你数。手写一个能读懂每一行的版本,才能在玩具电路上对答案。分压器两边都算出 6.000000 伏,你才知道自己没搞错。
第二,当退路。 三十九兆的 WASM 在某些环境里加载不了——离线包、内嵌场景、受限的浏览器。这时候需要一个零依赖的备用引擎,哪怕它只能算小电路。
第三,教学价值。 一个读得完的求解器,能把「SPICE 在干什么」这件事讲清楚。
它实现的是标准的改进节点法:N 个非地节点加 M 个电压源,组成一个 (N+M) 阶的矩阵,右边是注入电流和电源电压,一次高斯消元解出来。线性电路一轮就收敛,非线性电路用牛顿迭代逼近。
矩阵是稠密的,消元是 O(n³)。文档自己说得很清楚:五十个节点以上就该换稀疏求解器了,现在能撑住是因为目标电路小。
手写求解器里的五个坑
这部分是我读得最细的,因为每个坑都是真踩出来的。
坑一:地不进矩阵。 地节点的电位恒为零,不该是一个未知数。所以任何元件往「地」上盖章时,这一行一列直接跳过。听起来是小事,但漏了这一句,矩阵永远多一个奇异维度。
坑二:奇异矩阵。 如果一个节点只接了电容、或者只接了理想电压源,直流通路是不存在的,矩阵会退化。办法是每个节点的自导纳上加一个极小的电导,量级在 $10^{-12}$。够小,不影响结果;够大,能让方程有解。
坑三:电容在直流里是什么。 直流分析时电容是开路,但开路会让矩阵奇异。所以它在直流里被当成一个阻值极大的电阻——同样是那个极小电导的量级。到了瞬态,它换成后向欧拉的伴随模型:等效电导是电容除以步长,再并一个等值电流源,电流值由上一时刻的电压决定。
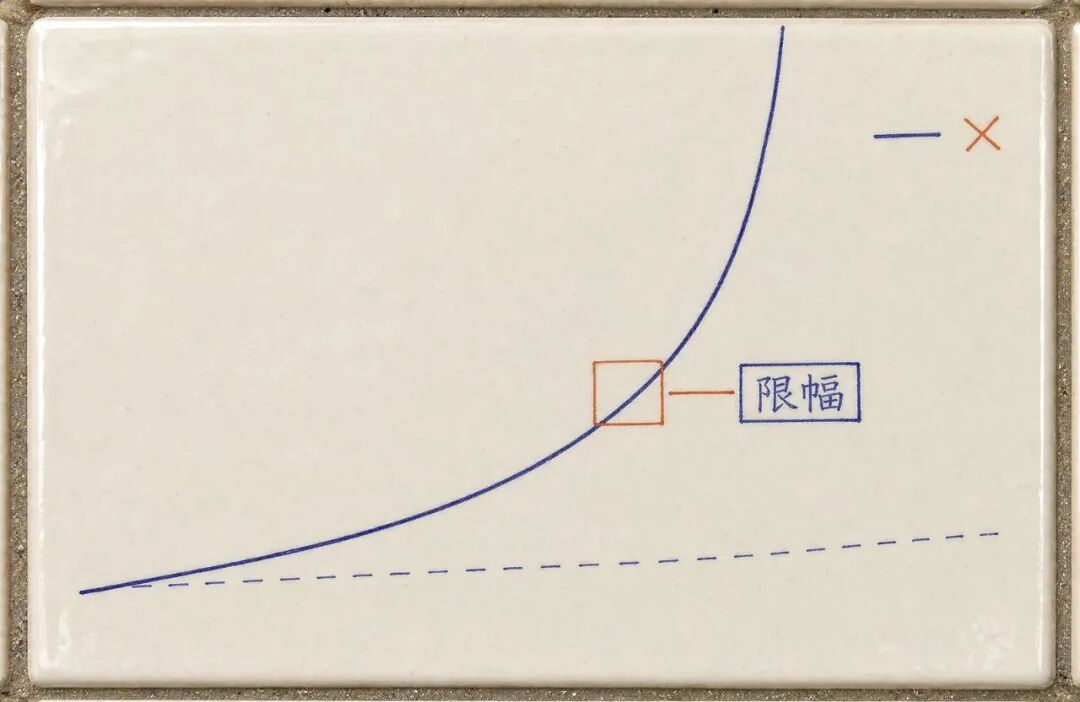
坑四:二极管的指数爆炸。 这条最要命。二极管的电流是 Is·(exp(V/nVt) − 1)。牛顿迭代第一轮,猜测电压是零,算出来的电导极小,二极管等于断路,于是解出来的电压直接就是电源电压,五伏。第二轮,把五伏代进指数里:exp(5 / 0.026) 是 $10^{84}$。浮点溢出,整条链路变 NaN。
SPICE 的老办法叫 pnjlim:第一轮先把电压钳在临界值上(默认二极管大约 0.73 伏),后面几轮如果电压想跳超过两倍热电压,就用对数压缩。加了这一步,二极管电路四到八轮稳定收敛。
坑五:初始条件不能先解一次直流。 有个 bug 是这样的:瞬态开始前先跑一次直流工作点,电容被当成开路,输出直接等于电源电压;这个错误的值成了「上一时刻」,第一次瞬态步进就从一个「已经充好电」的电容出发,整条充电曲线全错。正确做法是直接把电容的初始电压当作上一时刻,不做那次直流。
这五个坑没有一个是「算法不会」,全是「边界没想清楚」。这也正是自己写一遍的价值——用 ngspice 的人不会有这些知识,也不需要;但一旦你要在浏览器里解释「为什么这里跳了一下」,这些知识就是唯一的抓手。
两个引擎,同一道题
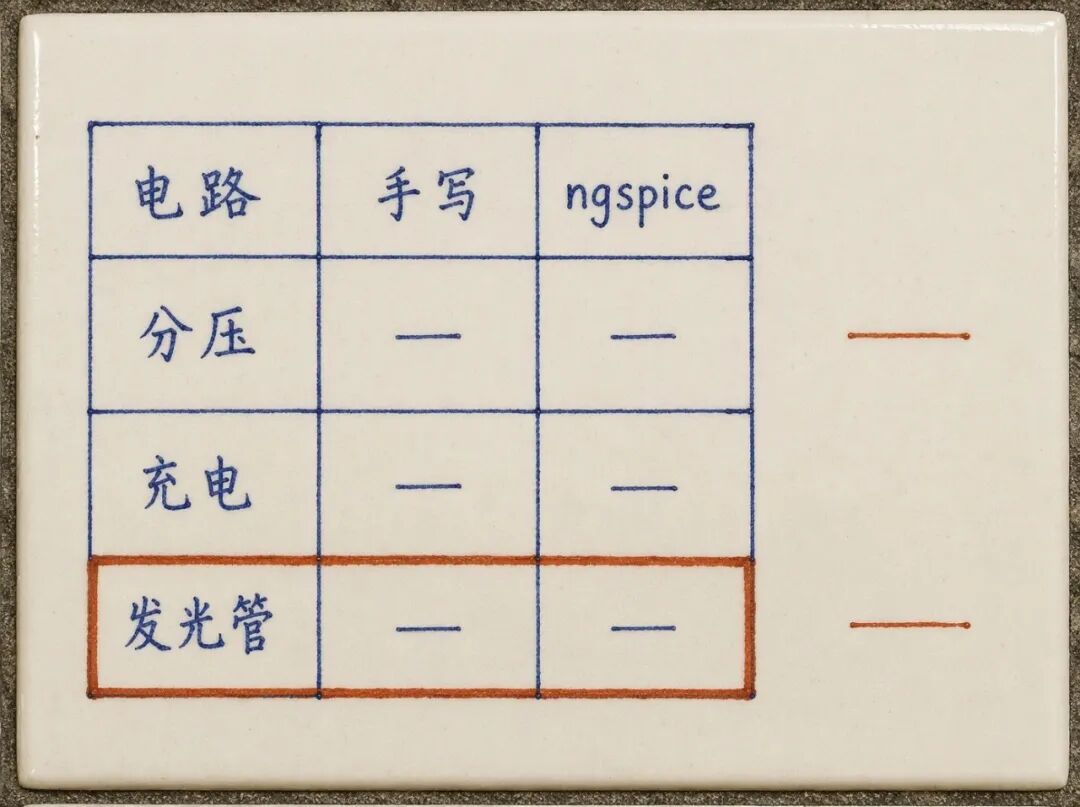
手写版和 ngspice 摆在同一个电路上,结果挺有意思。
分压器(9 伏、1k 与 2k):两边都是 6.000000 伏。手写版零点几毫秒,ngspice 冷启动要四百一十毫秒(含启动),热起来八毫秒。
RC 充电到 1 个时间常数:两边都是 3.16 伏,误差都在千分之三以内。
LED 串 220 欧接 5 伏:手写版算出正向压降 2.00 伏、电流 13.6 毫安;ngspice 用 1N4148 的模型算出 0.68 伏、4.3 毫安。这两个数不可比——一个是按发光二极管调过的参数,一个是普通小信号二极管。文档老老实实写了「不同模型,不可比较」。
我喜欢这张表的原因是它没有作弊。它没有挑一个「手写版更好」的例子来证明自己,也没有藏起那个不可比的行。
结论也很克制:无源电路上两者小数点后多位一致;非线性电路上取决于模型参数;手写版在小电路上快十倍,但节点一多就落后,而且根本没有交流分析。
后端的板卡,得把波形送进虚拟机
ESP32 在 QEMU 里跑,情况就难得多。
AVR 和 RP2040 都在 JS 里,想改 ADC 返回值,直接改一下 onADCRead 就行。ESP32 在 QEMU 的一个子进程里,JS 根本够不着它的 ADC 外设。
如果只往里面灌一个直流值,会发生什么?ADC 每次读都拿到同一个数。可真实的 ADC 是每次转换都重新采样的。一个 50 赫兹的正弦波,你按每秒几千次去读,每次读到的值都应该不一样。灌直流就等于把所有采样都锁死在同一时刻,波形彻底没了——这就是混叠。
Velxio 的办法很硬:把整条波形压进 QEMU。
前端把瞬态分析的结果按参考电压量化成 12 位整数,连同周期长度一起,base64 编码送给后端;后端通过子进程的标准输入把命令递进去,用 ctypes 调 QEMU 里新加的一个 C 函数;这个函数在设备状态里存下一张查找表,并记下当前的虚拟时钟。
之后每次客户机读 ADC 寄存器,QEMU 都用 QEMU_CLOCK_VIRTUAL 算出「现在处在波形的哪个位置」,在相邻两个采样点之间线性插值,把结果写进数据寄存器。
对客户机来说,它只是发现每次转换的结果都略有不同——就像真的一样。
没有瞬态结果的时候,它退回原来的直流注入路径。传空数组或零周期就清掉查找表,重新走直流。这个 fallback 让老例子完全不受影响。
带宽也算过了:八百字节一通道,八个通道六点四 KB,一次求解推一遍;限速到每秒五次,最坏三十二 KB/s。本地 WebSocket 上完全不是问题。
编译:从五分钟到两秒
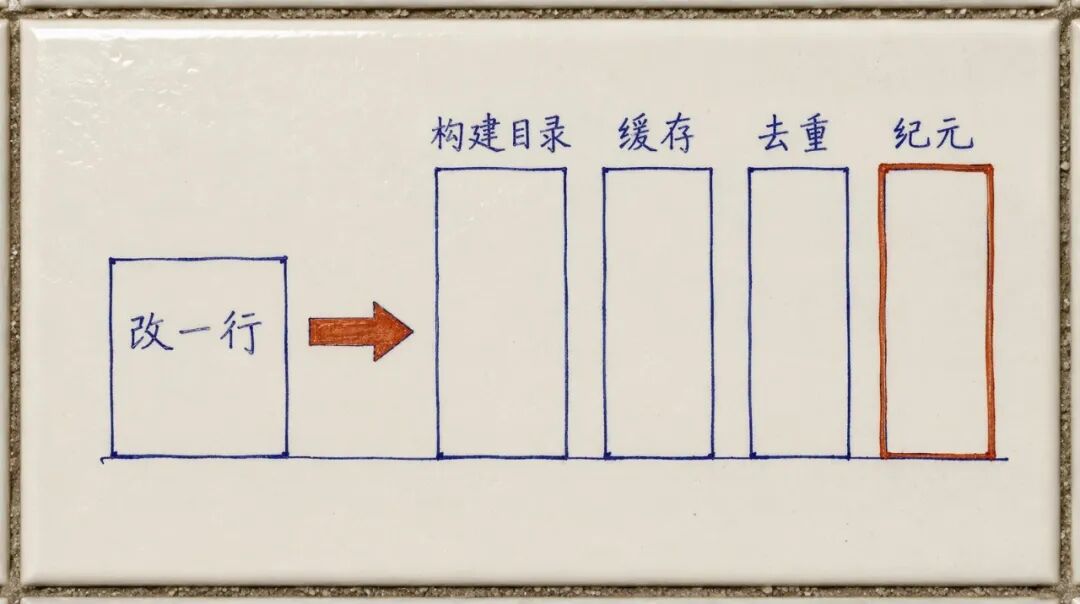
写 ESP32 的人都知道那个痛苦:改一行,等五分钟。
这件事 Velxio 处理得很认真,四个手段叠起来。
持久构建目录。 ESP-IDF 用 ninja,构建目录里留着所有中间产物。把它挂到容器外的一个卷上,没改动的部分就能全部跳过。文档说得很具体:一个没改过的 sketch 重新编译,两到五秒。
编译器缓存。 ccache 单独一个卷。第一次是空的,用着用着就热了。
任务去重。 同样的代码加同样的板卡,哈希一样,直接复用同一个编译任务,不用排两次队。
工具链纪元。 这个最容易被忽略。缓存键除了代码,还要包含「工具链本身的哈希」——编译器服务模块的字节,加上整个 ESP-IDF 模板目录的路径与内容。
为什么?因为有过一次真实的坑:只改了模板里的配置(把 FatFs 的长文件名打开),工具链代码一行没动,缓存键没变,于是所有已经编过的 sketch 继续拿到旧镜像,新配置只对那些从没编过的人生效。发现的时候是九月。
这类 bug 的特点是「测试全绿、用户全错」——因为测试用的是新编译,而用户命中的是缓存。
排队比编译更难
服务器开始有真实流量之后,瓶颈从「编得多快」变成「谁先编」。
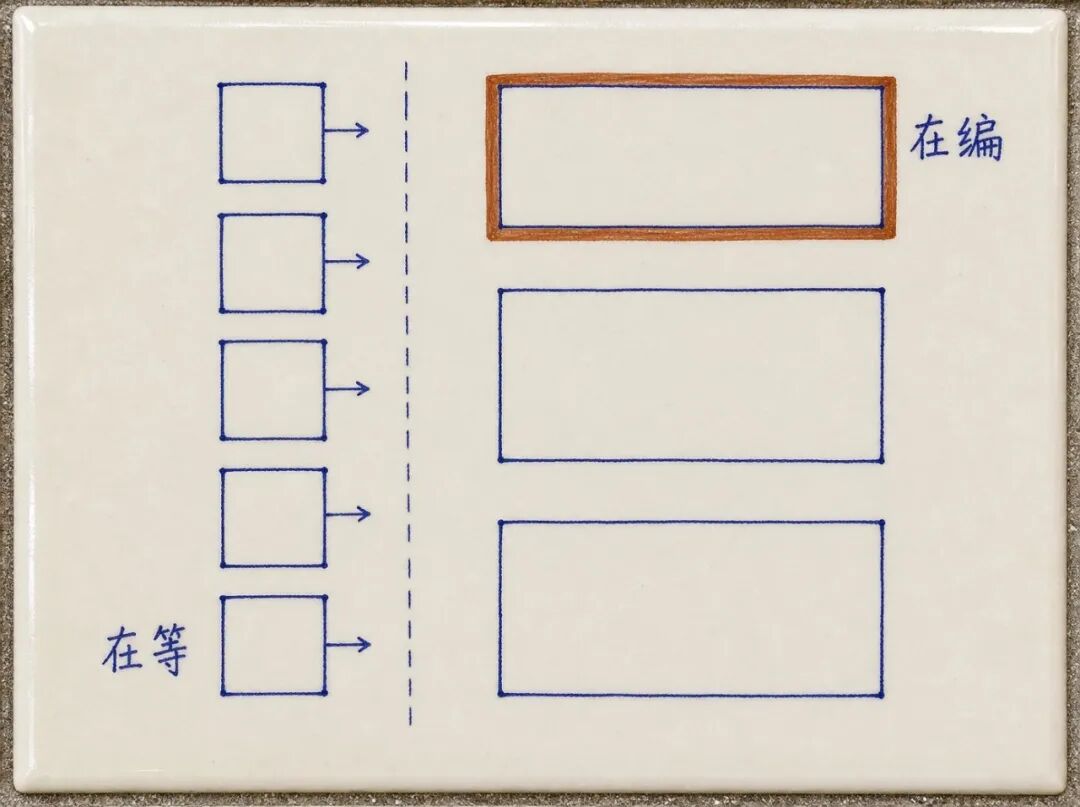
原来的做法是一个信号量,限两个并发。信号量严格先进先出,而且它不知道谁在等——付费用户和随手点开画廊的匿名访客排在同一条队里,前者没有任何办法插到前面;更糟的是,用户完全不知道自己为什么还没轮到,前端只能看到「锁着」。
后来换成了一个显式的等待队列,按「优先级 + 到达时间」排序。它故意做成无界的:任何任务都不会被拒绝、不会被丢弃,最多只是等得久一点。
纯按优先级排会饿死免费用户,所以每个通道留了几个「保留位」——只要还有普通任务在等,高优先级任务就不能占满全部名额,剩下的位置给等得最久的那个普通任务。
还有一个「优先级爆发」:通道满的时候可以临时多放一个进来,只有高优先级能用。代价是多跑一个构建几秒钟。
这套东西跟模拟器没关系,但它是这类项目绕不过去的一段:技术做完了,接下来全是运营。
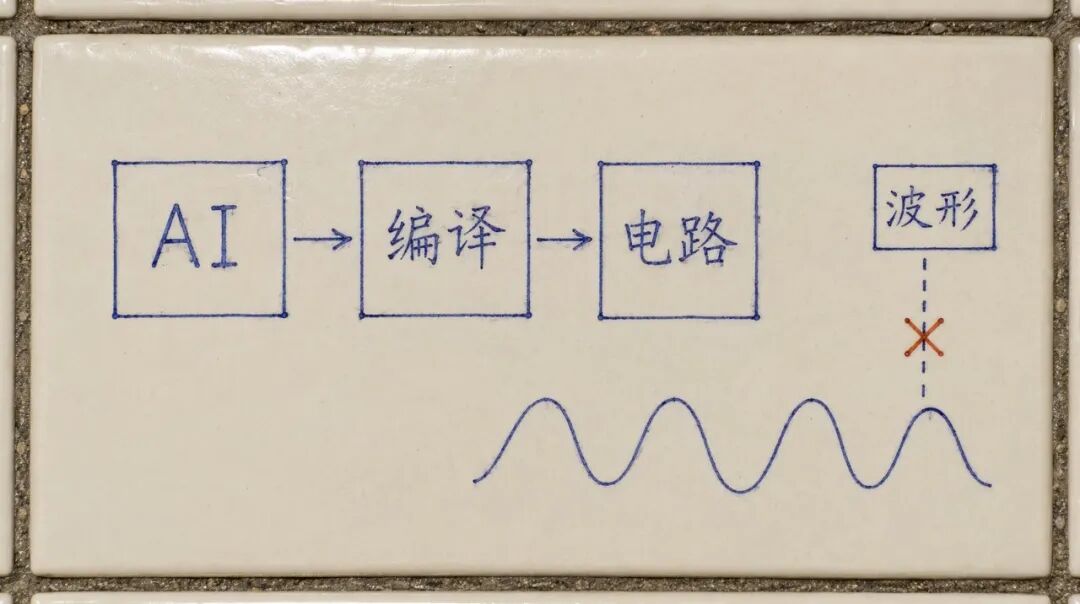
MCP:AI 能画电路,但看不见波形
它还有一个 MCP 服务器,能让 Claude、Cursor 这类客户端直接操作它。
工具不多,七个:编译项目、编译并标记为可仿真、导入 Wokwi 的 diagram.json、导出成 diagram.json、新建电路、改电路、按电路生成初始代码。
这套组合能做的事其实不小:AI 可以让它「搭一个 ESP32 加一个 DHT22 和一个 OLED」,拿到电路结构,生成代码,编译出固件。对「先给我一个能跑的骨架」这个需求,闭环是通的。
但有一条边界很清楚。那个叫 run_project 的工具,名字看着像「跑起来」,实际上它只是编译完在返回里加一个 simulation_ready 标记——真正的执行仍然发生在浏览器里,要人点一下 Play。
所以 AI 现在的位置是「画图的和写代码的」,不是「看波形的」。它能把一份电路交到你手上,但读不出那个电容上的电压是不是对。
这条线将来会不会挪,取决于两件事:跑起来这件事能不能被搬到服务端(能,但要占一台 QEMU),以及波形能不能被压缩成 AI 读得懂的摘要(能,但要定义什么叫「异常波形」)。两件都不难,但都没做。
五笔代价
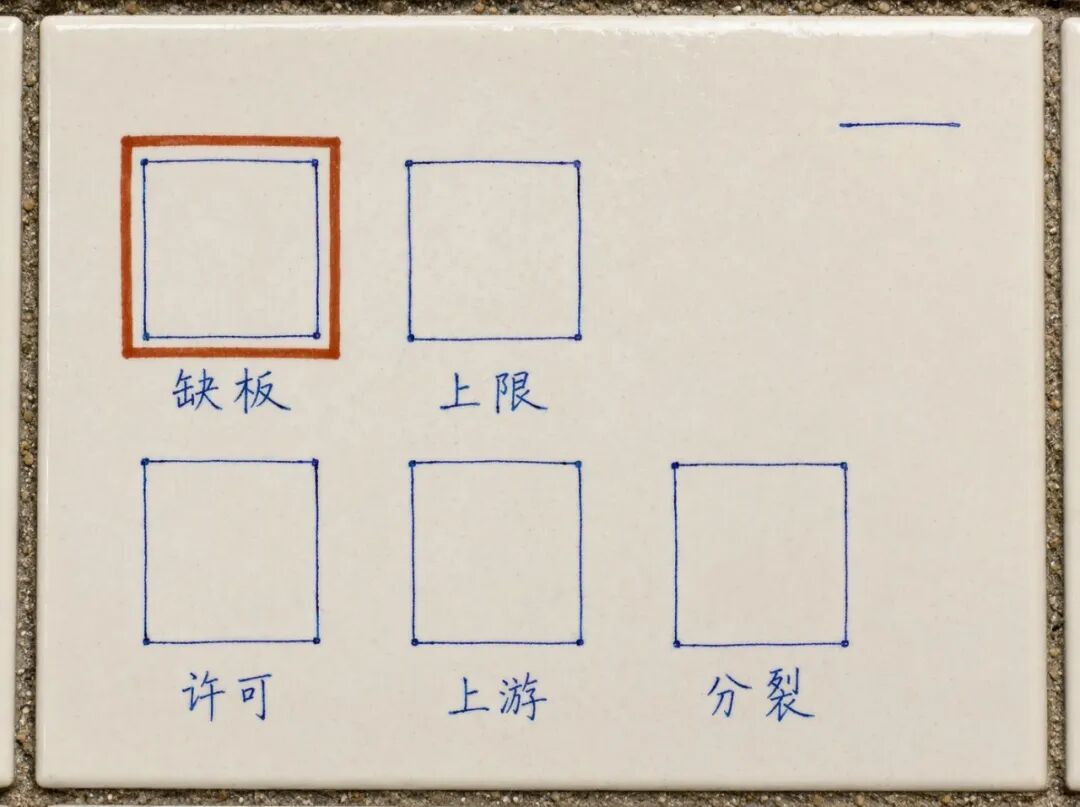
第一笔:自托管的版本是残缺的。 官方镜像只带前五个家族,STM32、树莓派 Linux、ESP32-C6 和那些品牌板卡只在 velxio.dev 上有。理由很实在——要授权模拟器二进制,还要几个 GB 的启动镜像。但这意味着你在自己机器上装的那个,和宣传页上看到的不是同一个东西。
第二笔:准静态是有天花板的。 一毫秒一次的握手,决定了它算不了音频反馈、算不了振荡器、算不了噪声。你想做一个真正需要模拟与数字紧耦合的项目,它会告诉你「大概对」,然后你会发现波形不对。七十倍的减速也意味着长跑测试不现实。
第三笔:许可。 AGPLv3 加商业双许可,加 CLA。个人、教学、开源项目用免费;要做闭源产品或 SaaS,得买。这不是拦路,但要提前看清楚——AGPL 对「网络部署也算分发」这条,做 SaaS 的人不能装看不见。
第四笔:它站在 Wokwi 的肩膀上。 元件库、两个 JS 模拟器、文件格式,都来自那个生态。这省了几年时间,代价是自己的元件渲染与行为模型跟上游绑在一起。上游怎么变,它就得跟着变。
第五笔:两套心智。 同一块画布上,有的板子在本机跑、有的在服务器跑。对用户是透明的,对排查问题的人不是——同样是「引脚没反应」,浏览器板卡要去翻前端控制台,后端板卡要去看 WebSocket 和 QEMU。这个分裂没有办法消除,只能靠文档写清楚。
结语
回到开头那个场景:拖动电位器,LED 亮,电压表跳数字。
这件事的每一层都是近似的。单片机的时间被跳过、被快进;模拟电路一毫秒才算一次;PWM 被折算成一个平均电压;二极管的指数被对数压住;ADC 拿到的是插值出来的整数。
但所有这些近似叠在一起,结果在一个相当大的范围里是对的——对到足以让你在没有硬件的情况下,把一个想法验证到八成。
这就是模拟器的本分。它不承诺给你真实世界,它承诺给你一个便宜到可以随便犯错的世界。而一个便宜的、可以随便犯错的世界,恰恰是学东西最快的地方。
模拟器从来不是让机器变真,是把「错一次」的成本降到零。
参考
- Velxio 仓库:https://github.com/davidmonterocrespo24/velxio — 架构、CPU 后端、编译与部署的一手材料
- 项目架构文档:https://github.com/davidmonterocrespo24/velxio/blob/main/docs/ARCHITECTURE.md — 五后端与 PinManager 门面的分层说明
- 电路仿真细节:https://github.com/davidmonterocrespo24/velxio/blob/main/docs/wiki/circuit-emulation-mna-solver.md — 手写求解器的盖章目录与五个坑
- ESP32 波形注入:https://github.com/davidmonterocrespo24/velxio/blob/main/docs/wiki/circuit-emulation-esp32-qemu.md — 从 JS 到 QEMU 的完整链路
 发表于 3 小时前
|
查看: 8|
回复: 0
 /1


