曼德博集合深度缩放:左边 double 糊成马赛克,右边 Real 依然清晰
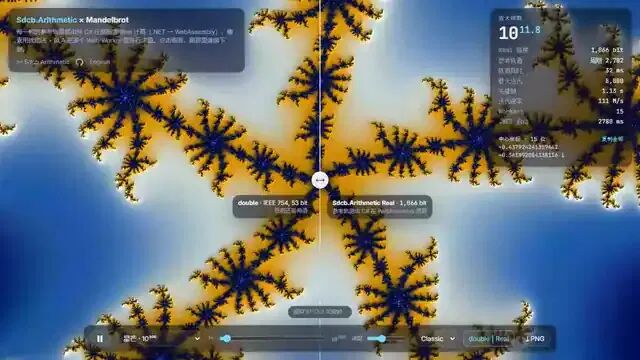
上面这张图是曼德博集合的深度缩放,从 $10^{12}$ 一路放大到 $10^{16}$。左半边是 double,到 $10^{14}$ 左右就开始糊成马赛克,再往下就只剩色块;右半边则一直清晰,而且还能继续放大到 $10^{290}$。右边的每一帧,都是新开源项目 Sdcb.Arithmetic 里的 Real 类型在浏览器里算出来的:纯 C#,编译成 WebAssembly,没有任何原生依赖。
一个欠了三年的愿望
2023 年 7 月,我写过一篇《超越.NET极限:我打造的高精度数值计算库》(https://www.cnblogs.com/sdcb/p/20230725-sdcb-arithmetic-intro.html),把 GMP 和 MPFR 封装成了 .NET 能用的 Sdcb.Arithmetic。今年 1 月,我又写了《不服跑个分?.NET 10 大整数计算对阵 Java》(https://www.cnblogs.com/sdcb/p/19484525/20261113-big-integer-dotnet-10-vs-java),结论是 BigInteger 够用但不算快,而原生的 GMP 能把它甩开一大截。
那个库是好用的,但它有个我一直很不爽的地方:它只是个封装。
- 每个平台都要一个原生运行时包,新平台就要重新编译;
- Native AOT、WebAssembly 这些场景,要么麻烦,要么干脆没法用;
- 想看看某个算法是怎么实现的,得去翻 C 代码和汇编。
我一直想要一个纯 .NET 的版本,API 是 C# 风格的,实现是托管的,能 AOT,能进浏览器。但这个工作量太大了:大数乘法、除法、开方、最大公约数、素性判定,再加上一整套正确舍入的任意精度浮点,光想想就让人想拖到明年。
直到 AI 时代到来。
许愿
这个项目其实从 8 月底就开始了,前期一直是我私下在折腾:陆续请 Fable 5 帮我"许愿",做各种尝试;这次最终成型,主要用的是 Claude Opus 5.5。这类大模型辅助编码的工作流,对于需要快速验证算法思路的场景来说,效率确实比纯手写高出一个量级。
大致的节奏是这样的:
| 日期 |
做了什么 |
| 9 月 1 日 |
第一批:底层大数内核、BigInt、BigRational,以及正确舍入的 Real;开始和 System.Numerics.BigInteger、原生库对拍 |
| 9 月 30 日 |
SIMD 加速,以及基于 NTT 的大数乘法 |
| 10 月 4 日 |
亚二次复杂度的 GCD、完整的函数覆盖、逐位对拍的校验工具 |
| 10 月 25 日 |
合并成单个 Sdcb.Arithmetic 项目,实现 .NET 泛型数学,API 改成 C# 风格,加 CI,发布到 NuGet |
| 10 月 26 日 |
用 Chudnovsky 算法重写 Real.Pi,百万位提速约 4 倍 |
至于花费:前前后后加起来,GitHub Copilot 的用量折合大约 200 美元(不太精确,但数量级差不多)。
对比一下它做的事:整个库约 1.7 万行 C#,50 个源文件,配上 23 个测试文件。如果这是我一个人手写的,大概到明年也未必写得完。
它长什么样
用法上,我希望它尽量"像 .NET 自己的类型":
using Sdcb.Arithmetic;

// 整数
BigInt a = BigInt.Parse("123456789012345678901234567890");
BigInt p = BigInt.Pow(2, 521) - 1;      // 梅森素数 M521
bool prime = p.IsProbablePrime();
BigInt m = BigInt.ModPow(a, p, BigInt.Pow(10, 30));

// 有理数,永远是最简分数
BigRational r = new BigRational(1, 3) + new BigRational(1, 6); // 1/2

// 任意精度浮点,结果是正确舍入的
Real.DefaultPrecision = 256;            // 单位:bit
Real pi = Real.Pi();
Real y = Real.Sin(Real.Parse("1.5"));
Real z = Real.Exp(y, precision: 512, RealRounding.TowardPositive);
三个类型分别对应任意精度整数、有理数、任意精度浮点,都实现了 .NET 的泛型数学接口(INumber<T>、IBinaryInteger<T>、IBinaryFloatingPointIeee754<T>),并且能和 System.Numerics.BigInteger 互相转换。浮点这边支持 5 种舍入模式、NaN、±∞、±0 和 100 多个函数。
安装只要一行:
dotnet add package Sdcb.Arithmetic
纯托管,.NET 10,x64 和 ARM64 都行,也能 AOT。
Show Case:让数字自己说话
光讲没意思。这个项目最想让大家看的,是专门做的在线 Show Case(https://sdcb.ai/arithmetic):
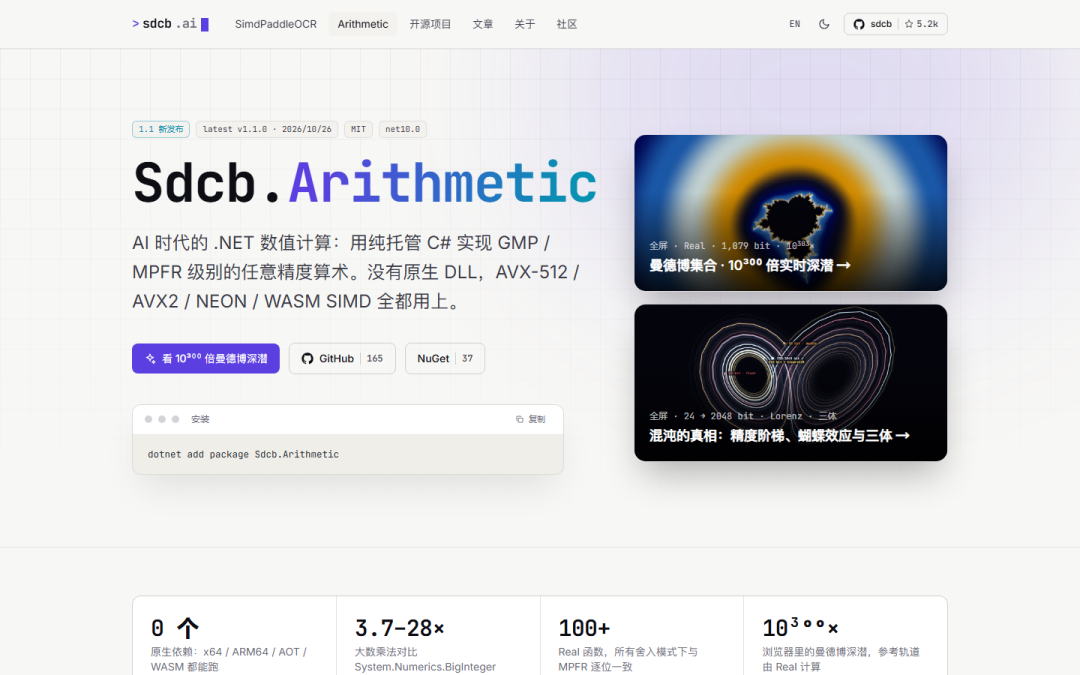
页面里每一个数字,都是 Sdcb.Arithmetic 编译成 WebAssembly 之后,在浏览器里现场算的。没有服务器,也没有预先算好的图。
① double 是怎么骗你的
先从最经典的开始。0.1 + 0.2 在 double 里是 0.30000000000000004,这个大家都知道。但你知道 double 其实还有更阴险的玩法吗?
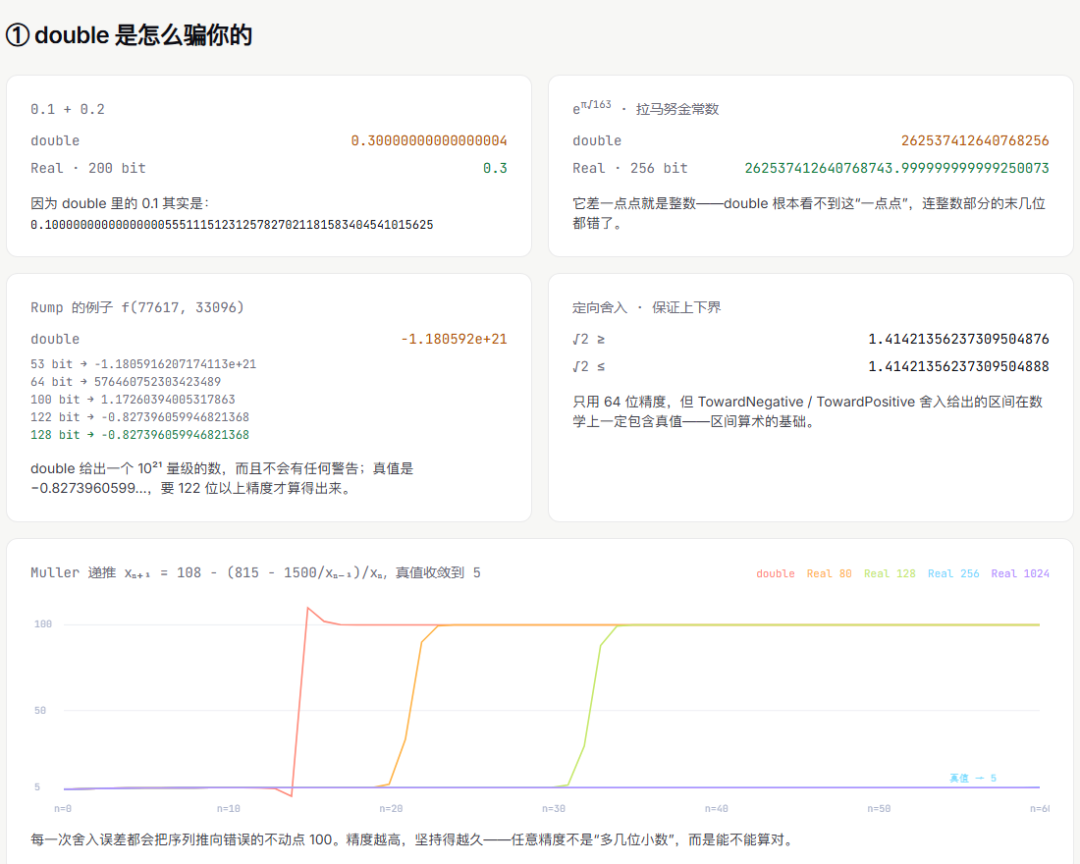
最有名的是 Rump 的例子,一个看上去人畜无害的多项式表达式,在 f(77617, 33096) 处的真值是 -0.827396059946821368…。用示例项目跑了一遍:
4. Rump's example f(77617, 33096); true value -0.827396059946821368...
   double           : -1.1805916207174113E+21
   Real,  64 bits   : 576460752303423489
   Real, 100 bits   : 1.17260394005317863
   Real, 122 bits   : -0.827396059946821368
   Real, 128 bits   : -0.827396059946821368
   Real, 200 bits   : -0.827396059946821368
double 给的是 -1.18 × 10²¹,错了二十多个数量级,连符号都不对,而且一点报错都没有。把精度逐步加上去:64 位是 5.7 × 10¹⁷,100 位是 1.17,到 122 位才终于收敛到正确答案。
② 混沌的真相
混沌系统是最能暴露精度问题的地方:初值差一点点,后面就完全不是一回事。
下面这个动图里,同一个起点、同一个 RK4 积分器,每条轨迹只有舍入的位数不同,看它们一条接一条地"叛逃"真值:
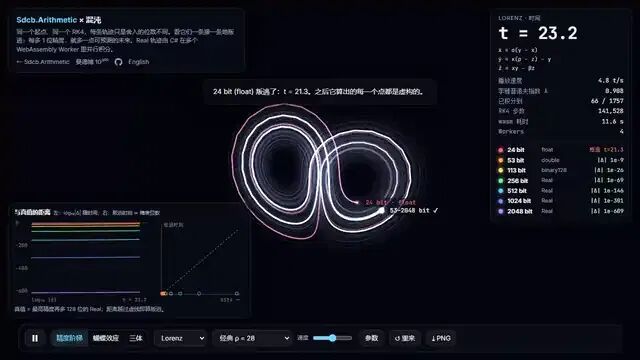
每多 1 位精度,就多一点可预测的未来。
再来一个更直观的"蝴蝶效应"。成千上万个粒子挤在一个极小的球里同时出发,几秒之后就被撒满了整个吸引子:
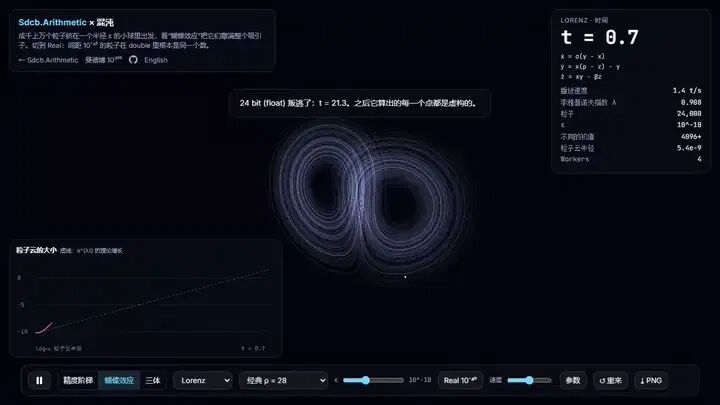
切到 Real,间距 $10^{-40}$ 的粒子在 double 里根本是同一个数,但在这里它们是不同的。
还有毕达哥拉斯三体问题:质量 3、4、5 的三颗星从静止出发,经过一连串近距离交会,最后有一颗会被甩出去:
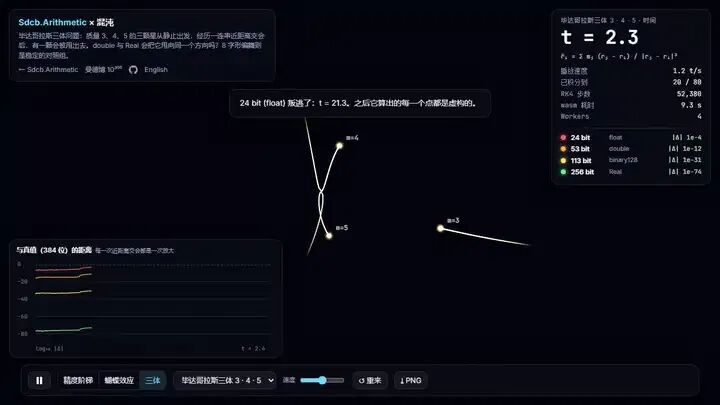
③ π 竞速
π 是高精度计算的老朋友。页面里可以直接在浏览器里算 π,并且同时开一个独立的 WebAssembly Worker,用另一套方法(Chudnovsky 公式)交叉验证:
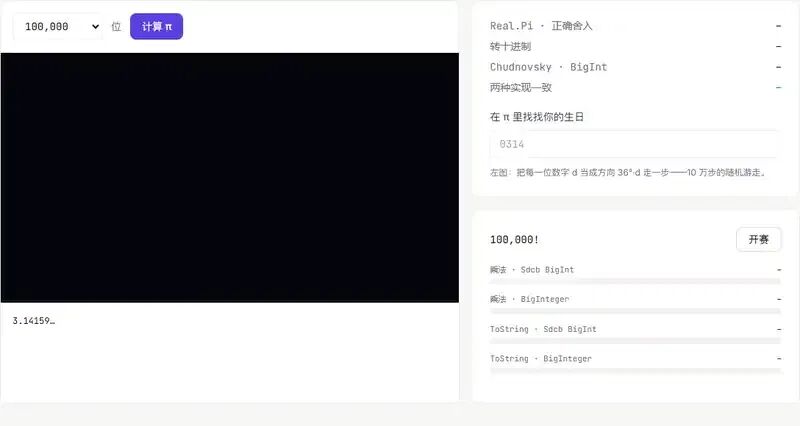
在本机的控制台里,同样的事情是这样的(dotnet run --project examples/Pi -c Release):
Real.Pi (3321993 bits)        :   1185 ms
Chudnovsky (71430 terms)      :    767 ms
agree on 1000000 digits       : True
π = 3.14159265358979323846264338327950288419716939937510...
digits 999991..1000000: 5779458151
100 万位,不到一秒,两种写法互相对得上。
④ 曼德博,下潜到 $10^{290}$
开头那个动图,是 Real 在每一帧里算出一条"参考轨道",再由 Web Worker 用扰动法加 BLA 并行算出每个像素。点一下画面,就朝那里继续下潜:
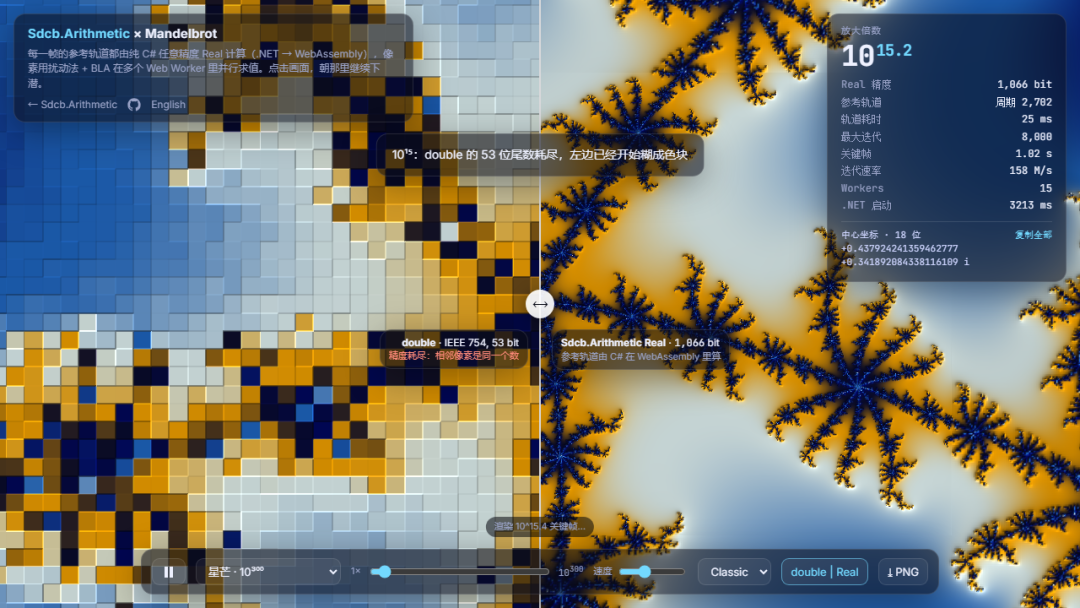
这个页面上还有 "double | Real" 的对比开关:切到 double 之后,能亲眼看着相邻像素变成同一个数,画面糊成方块。
想自己玩的话:曼德博(https://sdcb.ai/arithmetic/mandelbrot)和混沌(https://sdcb.ai/arithmetic/chaos)都能直接点开。
为什么敢相信 AI 写的数学库
看到这里肯定有疑问:让 AI 写数学库,对吗?
数学库最怕的就是"看上去对"。所以这个项目里最花功夫的,不是写算法,而是证明它是对的。我让 AI 做了这几层对拍:
- 90 多组基于属性的测试,用随机输入把每个
BigInt 操作和 System.Numerics.BigInteger 对拍,包括专门构造的进位链压力数据,以及各种乘法算法交叉尺寸的操作数;
BigInt 的每个操作,还和原生 GMP 逐项对拍(7,637 项检查,结果完全一致);Real 的每个函数,和原生 MPFR 逐位对拍(56,370 项检查,尾数、指数、特殊值全部比对,5 种舍入模式,精度从 2 位到 640 位);- 53 位精度下,
Real 的加减乘除、开方、融合乘加,和 IEEE double 的结果在数千组随机输入上逐位一致;
- 每一档 SIMD 指令集都得到一样的结果,CI 分别在 AVX-512、AVX2、128 位向量、纯标量下跑一遍,x64 和 ARM64 都跑。
这里要说明一下:GMP 和 MPFR 在这个项目里只是黑盒参照物,用来对拍和跑分。Sdcb.Arithmetic 是独立实现的,依据的是公开发表的论文(文献清单在 references.md:https://github.com/sdcb/Arithmetic/blob/main/docs/references.md),不包含它们的任何源代码。
性能:比 BigInteger 快很多,但追不上 GMP
纯 C# 的性能到底怎么样?测试环境是 AMD Ryzen 7 5800X + .NET 10,对比对象是 System.Numerics.BigInteger 和原生 GMP 6.3:
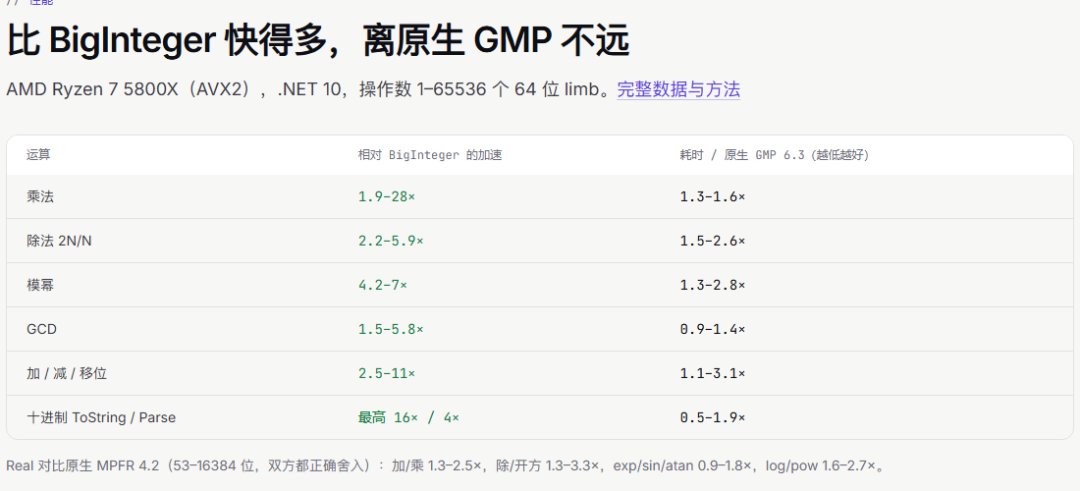
| 操作 |
比 BigInteger 快 |
耗时是原生 GMP 的 |
| 乘法 |
1.9–28 倍 |
1.3–1.6 倍(16 limb 以上) |
| 除法 2N/N |
2.2–5.9 倍 |
1.5–2.6 倍 |
| 模幂 |
4.2–7 倍 |
1.3–2.8 倍 |
| GCD |
1.5–5.8 倍 |
0.9–1.4 倍 |
| 加 / 减 / 移位 |
2.5–11 倍 |
1.1–3.1 倍 |
| 十进制 ToString / Parse |
最高 16 倍 / 4 倍 |
0.5–1.9 倍 / 0.6–1.4 倍 |
结论很实在:比 BigInteger 快得多,但整体仍比原生 GMP 慢一些,大多数操作落在 GMP 的 1.2 到 2.5 倍耗时之间。
为什么追不上?
有一部分差距是设计选择:BigInt 是不可变类型,每次运算都会分配新的结果,小操作数下这笔分配和 GC 开销很明显。
另一部分,是 .NET 目前表达不了的东西。原生实现的内层循环依赖 MULX、ADCX、ADOX 这几条指令,它们能同时维护两条互不干扰的进位链,让大整数乘加跑得很满。但在 C# 里,这几条指令没有对应的 intrinsic,写不出来。所以逐行累加这类标量核心循环,大约还落后 2 到 2.5 倍。
这件事其实有人早就提过:dotnet/runtime issue #80674,Ben Adams 在 2023 年 1 月提了一个 API 提案,要给 .NET 加上 ADCX 和 ADOX 的 intrinsics。到写这篇文章的时候,它仍然是 Open 状态。如果你也想让 .NET 的大数运算更快,欢迎去那个 issue 里点个 👍,或者说说你的使用场景。
没有这两条指令,是怎么把乘法追到 1.3 到 1.6 倍的?绕开它:乘法的基础块用 AVX2 的 vpmuludq,把 32×16 位的乘积在 64 位的通道里累加,天然没有进位,不需要进位链。更大的操作数,则靠 Karatsuba、Toom-3 和 SIMD 的 NTT 来拉开差距。
这些 SIMD 代码都有 Vector512 → Vector256 → Vector128 → 标量 的逐级回退,所以在 ARM64 甚至 WebAssembly 上也能跑:这恰恰是原生库做不到的部分。
最后
回头看,2023 年写第一版时,觉得"纯 C# 实现一整套 GMP 级别的库"是不现实的。三年后,这件事变成了一次从 8 月底到 10 月底、用 AI 协作完成的工程。
当然,它还很年轻:性能追不上原生,API 也可能还会调整。但"不用带原生依赖,在任何有 .NET 的地方,包括浏览器里,都能算高精度",这件事现在已经成立了。
想试试的话:
旧的 GMP / MPFR 封装并没有消失,已经迁到了 sdcb/Sdcb.Arithmetic(https://github.com/sdcb/Sdcb.Arithmetic),需要原生速度的话仍然可以用。
如果你对任意精度算术、大数乘法优化或者 .NET 高性能计算这个话题感兴趣,欢迎到云栈社区和更多开发者一起交流,那里有不少关于数值计算和 .NET 底层优化的讨论。
 发表于 昨天 22:02
|
查看: 5|
回复: 0
 /1


