你有没有过这种体验:临时要连一下测试库,改两条数据、看一眼表结构,于是去下个数据库客户端。下完发现安装包三百多兆,装完还得再装一个 Java 运行时。等一切就绪,你那条 SQL 已经忘了要写什么。
更离谱的是,第二天你要看 Kafka 里的消息,得再装一个工具;要看 Nacos 的配置,再装一个;要连 MongoDB,再装一个。查数据这件事本身只要十秒,准备工作花了半小时。
DBX 就是冲着这套「准备工作」来的。它的自我描述只有一句:100+ 个数据库,25 MB。桌面端、Docker、CLI、内置 AI 助手,还有一个 MCP Server。
它是什么
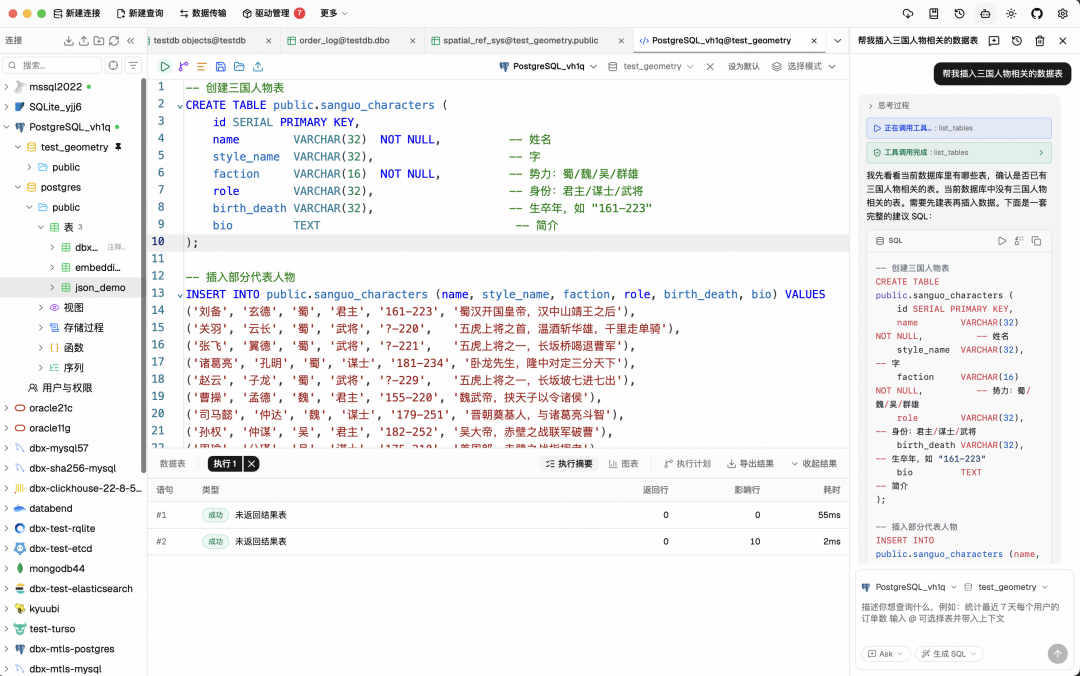
DBX 是一个用 Rust 写的轻量级数据库管理工具。技术栈是 Tauri 2 + Rust 后端 + Vue 3 前端,配 shadcn-vue、Tailwind 和 CodeMirror 6。整个应用打出来大约 25 MB。
这个数字的意义在于它什么都不带:不带 Java 运行时,不带 Python 虚拟环境,不带一个内嵌的 Chromium。下载、安装、连库,就这三步。对比一下,DBeaver 要 Java,TablePlus 是付费的 freemium 模式——DBX 是 Apache-2.0 协议的开源项目。
支持的数据库清单长到需要分段看。原生驱动覆盖 MySQL、PostgreSQL、SQLite、Cloudflare D1、Redis、MongoDB、DuckDB、ClickHouse、SQL Server、Oracle、Elasticsearch、Qdrant、Milvus、Weaviate、MariaDB、TiDB、StarRocks、Doris、SelectDB、CockroachDB、TDengine。国产库里,达梦、KingbaseES、OceanBase、openGauss、GaussDB、KWDB、Vastbase、GoldenDB、XuguDB、HighGo 都在列。剩下的 Snowflake、Trino、Hive、DB2、Neo4j、Cassandra、BigQuery、Databricks、SAP HANA 这类,走 agent 化 profile 或者自定义 JDBC 连接接进来。
它解决什么问题
第一层是体积和依赖。 这条不用多解释,25 MB 单二进制和「先装个 JRE」之间的差距,是很多人换工具的直接动机。
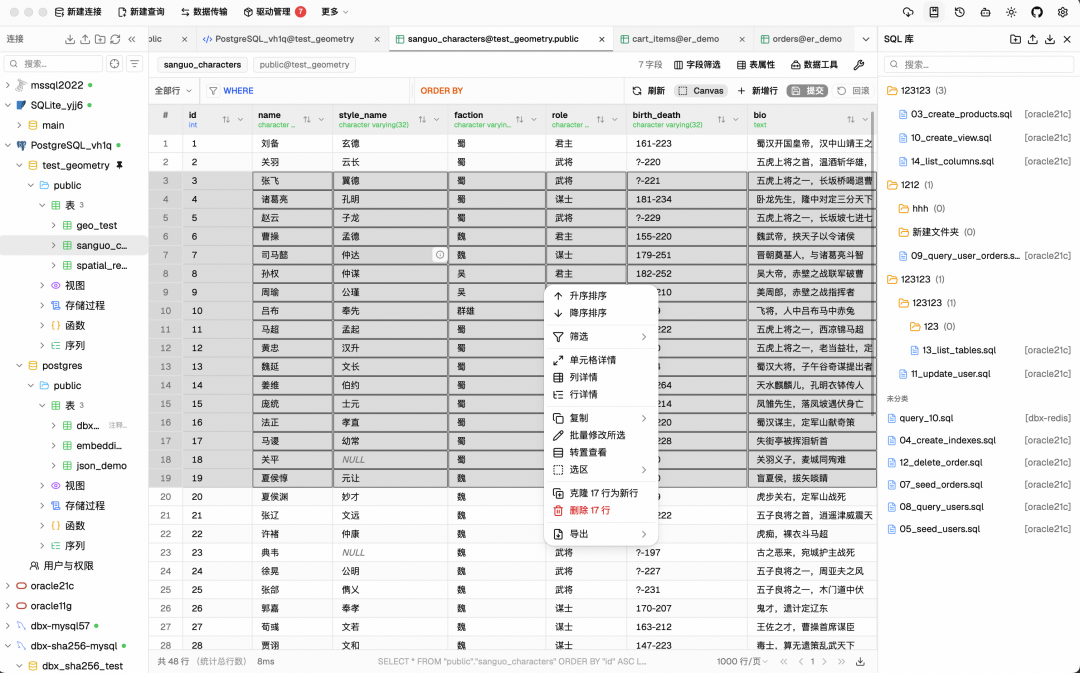
第二层是「工具太多」。 除了数据库,DBX 把消息队列和中间件的控制台也做进了同一个窗口:Kafka、RocketMQ、RabbitMQ、Pulsar、MQTT 的 topic、消费组、消息浏览、broker 监控;Nacos、Consul、ZooKeeper、etcd 的服务发现和 KV 配置。你的 topic 列表和你的数据表就在同一个侧边栏里,不用再来回切窗口。
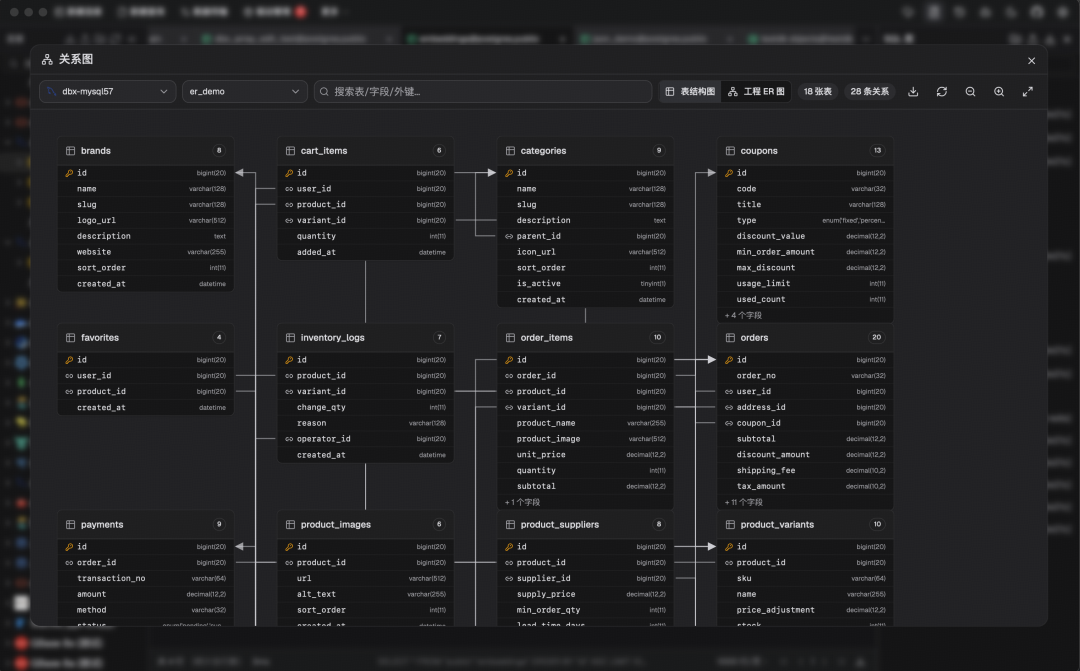
第三层是 AI 到底放在哪儿。 大多数工具的 AI 是一个独立的网页对话框:你把表名复制出去,把 SQL 复制回来。DBX 把 AI 直接放进编辑器——选中一张表,用自然语言描述想要什么,SQL 就出现在你正在写的地方。后端可以接 Claude、OpenAI、Ollama 本地模型,或者任何 OpenAI 兼容的端点。而且它跑 AI 生成的 SQL 之前会过一遍内置的安全检查。
第四层是给 Agent 用的接口。 DBX 单独发了一个 Rust 写的 MCP Server,让 Claude Code、Cursor、Windsurf 这类编码 Agent 直接查你已经在 DBX 里配好的连接:
npx @dbx-app/mcp-server
权限是分级的:只读、数据读写、完全访问,外加一份连接白名单。对应的机器可读值是 read_only、safe_write、high_risk_write。同时还发了一个 CLI 包(npm i -g @dbx-app/cli,或者 brew tap t8y2/tap && brew install dbx-cli),其中 dbx agent setup 会把官方的 Agent Skill 离线装到 ~/.agents/skills/dbx,让有 shell 能力的 Agent 知道该怎么安全地用这个 CLI。
值得关注的点
1. 它把「从竞品迁移」做成了产品功能
这是我觉得最聪明的一处设计。DBX 内置了连接配置导入,可以直接从 DBeaver 和 Navicat 里把连接 profile 搬过来。
数据库客户端的迁移成本从来不是「不会用新工具」,而是「我攒了三年的那两百个连接要重新配一遍」。把这一条抹平,换工具的门槛就只剩下载安装。愿意为迁移路径单独做功能,说明作者非常清楚自己抢的是谁的用户。
2. 插件系统和赞助商名单,透露了两套完全不同的变现思路
插件这块做得很规矩:连接类型和新工具以插件形式接入,S3 浏览、Kubernetes、LDAP 都在内置商店里;每个插件包安装前要验签,插件 UI 跑在自己的沙箱 sidecar 进程里;官方给了 Go 和 TypeScript 两套 SDK,用 npx @dbx-app/plugin-cli 脚手架起项目,发到 t8y2/dbx-store 上架。这是一个正经的生态设计。
但真正有意思的是 README 里那张赞助商表格。除了雨云、UCloud、七牛云这类云厂商,还排着好几家 Claude Code / Codex 中转站——其中一家直接写着「通过这个链接注册,首次充值八折,企业客户最高七五折」。一个开源数据库工具,把 AI 编码工具的中转服务当成了赞助位。 这大概是 2026 年中文开源项目特有的一种变现生态:用户画像高度重合,转化路径短到只需要一个邀请码。
3. 发布渠道铺得比功能还全
Homebrew cask、Scoop、WinGet、Flatpak、Docker 一个不缺,桌面端之外还有 Web 版和自托管方案,自托管可以直接团队共享同一套连接。另外拖一个 Parquet 或 CSV 文件进去能直接预览(底下是 DuckDB),这种小功能属于典型的「用一次就回不去」。
顺便说一句,仓库的 open issues 数量是 1,200 多。这个数字放在 21K Star 的项目上不算好看,但反过来看,五个月冲到两万星、支持一百多种数据库,兼容性测试的欠债大概率就堆在这里。
个人启发
DBX 让我重新想了一遍「工具类开源项目」的竞争位置。
数据库客户端是一个被 DBeaver、Navicat、TablePlus、DataGrip 反复犁过的赛道,看起来完全没有新玩家的空间。DBX 找到的缝隙不是功能——功能上它没有一样是别人没有的——而是交付形态:把「三百兆 + Java 运行时」变成「25 兆、双击就能用」,再把散落在五六个工具里的数据库、消息队列、注册中心收进同一个窗口。
当一个赛道所有玩家都在比功能多的时候,比「少」反而成了差异化。 少装一个运行时,少开一个窗口,少复制粘贴一次 SQL。这些都不是能写进 feature list 的卖点,但它们恰好是用户每天真正在忍受的东西。
第二个启发是关于「谁是你的用户」这件事的迁移。DBX 一边把 AI 放进编辑器服务人类用户,一边单独发 MCP Server 和 CLI、把 Agent Skill 装到 ~/.agents/skills 去服务 Agent 用户。同一个产品,两套入口,两套权限模型。 这不是顺手加个 AI 功能,而是承认了未来会有一半的调用方不是人。如果你在做的工具会被 Agent 调用,那「给 Agent 用的那份接口」值得被当成一等公民来设计,而不是导出个 API 了事。
GitHub: github.com/t8y2/dbx
这类轻量级数据库工具的讨论,在 云栈社区 经常能看到开发者分享真实的切换体验和踩坑记录,感兴趣可以过去翻翻。
 发表于 昨天 23:58
|
查看: 4|
回复: 0
 /1


