Proxmox 中的非特权 LXC(Linux 容器)无法直接看到 /dev/net/tun,因此 tailscaled 首次启动就会因为 CreateTUN("tailscale0") failed 而退出。解决这个问题不需要改用特权容器,也不需要第三方脚本:Proxmox 自带容器设备直通能力。执行一条 pct set 命令,或者在网页界面填写一个对话框,就能把 TUN 设备交给容器,让 Tailscale 在保持非特权模式的 LXC 中正常运行。
本文在非特权 Debian 13 容器内安装 Tailscale,分别通过 pct set --dev0 和网页界面的 Device Passthrough 直通 TUN 设备,再将容器配置为子网路由器和出口节点。同时介绍无法修改容器配置时的用户空间替代方案,以及实验中遇到的各类错误。以下命令来自 2026 年 11 月的实验:宿主为 Proxmox VE 9.2,Debian 13 容器内运行 Tailscale 1.104.4。
规划容器布局
实验在同一个 Proxmox 节点上使用四个容器,目的是从 tailnet(Tailscale 私有网络)中的另一台机器验证各项功能。关键设计在于第二座网桥:宿主没有在 vmbr1 上配置 IP,路由器容器是唯一同时连接两侧网络的容器,因此进入 10.20.20.0/24 网段的唯一通道就是 Tailscale 子网路由。
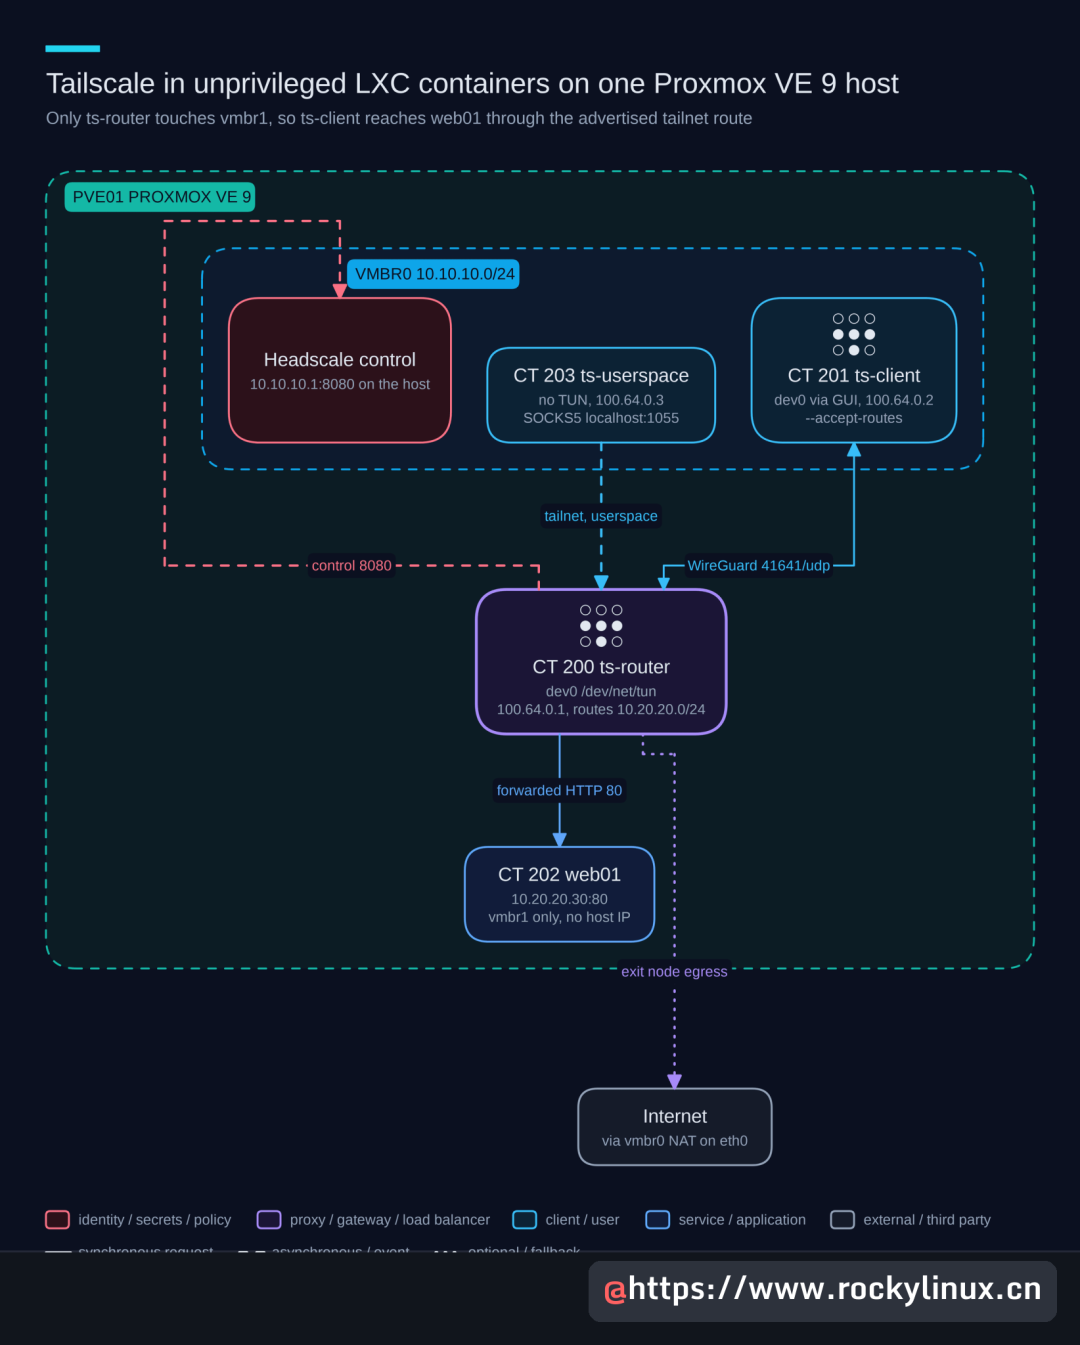
每个容器各司其职:
- CT 200
ts-router:通过 pct set 接入 TUN,充当子网路由器和出口节点,地址为 10.10.10.20、10.20.20.20。
- CT 201
ts-client:通过网页界面接入 TUN,接受子网路由,地址为 10.10.10.21。
- CT 202
web01:在 10.20.20.30 上提供普通 HTTP 服务,只连接 vmbr1。
- CT 203
ts-userspace:完全没有 TUN 设备,使用用户空间网络。
实验的 tailnet 由宿主上的自托管 Headscale 服务器协调,因此 tailscale up 带有 --login-server 参数,路由批准使用 headscale 命令。如果使用 Tailscale 托管服务,省去该参数,打开命令输出的登录地址,并在管理控制台批准路由即可,容器侧配置完全相同。
创建非特权容器
已有容器可以跳过本节。否则,先在 Proxmox 宿主上刷新模板列表,查找当前 Debian 13 镜像,模板文件名会随维护版本变化:
pveam update
pveam available --section system | grep debian-13
实验当天的 amd64 镜像为 debian-13-standard_13.6-1:
system          debian-13-standard_13.6-1_amd64.tar.zst                      amd64
system          debian-13-standard_13.6-1_arm64.tar.zst                      arm64
按 pveam available 实际输出的名称,将镜像下载到 local 存储:
pveam download local debian-13-standard_13.6-1_amd64.tar.zst
随后创建容器。本文关键参数是 --unprivileged 1;nesting=1 与网页界面 Create CT 向导的默认设置一致。实验节点把根磁盘放在本地目录存储,所以使用 local:4。通过 Proxmox ISO 安装的节点通常改用 local-lvm:4(ext4 或 xfs 安装)或 local-zfs:4(ZFS 安装)。请按实际网络环境修改网桥、地址和网关:
pct create 200 local:vztmpl/debian-13-standard_13.6-1_amd64.tar.zst \
  --hostname ts-router --unprivileged 1 --features nesting=1 \
  --cores 1 --memory 512 --rootfs local:4 \
  --net0 name=eth0,bridge=vmbr0,ip=10.10.10.20/24,gw=10.10.10.1 \
  --nameserver 1.1.1.1 --onboot 1 --start 1
确认容器正在运行且确实为非特权模式。宿主上已有 /dev/net/tun,但容器内部仍然找不到:
pct config 200 | grep -E "unprivileged|features"
pct exec 200 -- ls -l /dev/net/tun
配置正确、设备却缺失,这两行输出恰好概括了问题的本质。除非明确列出设备,Proxmox 不会把宿主设备交给非特权容器,所以要从宿主侧修复,而不是在容器内折腾:
features: nesting=1
unprivileged: 1
ls: cannot access '/dev/net/tun': No such file or directory
下文将容器 200 用作路由器,出现 200 的地方请替换为自己的 CTID。
在容器内安装 Tailscale
先安装软件包,再添加设备。这个顺序可以直观看到真实故障,也便于日后容器丢失设备时识别同类错误。从 Proxmox 宿主进入容器 shell:
pct enter 200
此时在容器内以 root 运行,无需 sudo。安装 curl,添加 Tailscale 的签名密钥和 Debian 13(trixie)软件仓库。使用软件仓库可以让 apt 在更新容器其余软件时一并维护 Tailscale:
apt update && apt install -y curl ca-certificates
curl -fsSL https://pkgs.tailscale.com/stable/debian/trixie.noarmor.gpg | tee /usr/share/keyrings/tailscale-archive-keyring.gpg >/dev/null
curl -fsSL https://pkgs.tailscale.com/stable/debian/trixie.tailscale-keyring.list | tee /etc/apt/sources.list.d/tailscale.list
第二条 tee 会回显写入的仓库配置。注意检查发行版代号:如果容器来自 Debian 12 模板,应使用对应的 bookworm 文件。发行版配置错误是 apt 找不到软件包的常见原因:
# Tailscale packages for debian trixie
deb [signed-by=/usr/share/keyrings/tailscale-archive-keyring.gpg] https://pkgs.tailscale.com/stable/debian trixie main
安装软件包并检查版本:
apt update && apt install -y tailscale
tailscale version
实验当天稳定通道提供 1.104.4。后续警告和健康检查均来自这个版本,旧版本的提示可能不同,甚至没有对应提示:
1.104.4
  tailscale commit: 9382131983ca16de1357091618fd903e35db3c4e
  long version: 1.104.4-t938213198-gd38c96d6a
  other commit: d38c96d6afce903d0a81e5f3e32d7048bc33b660
  go version: go1.27.3 (tailscale/go 7ef7b40364)
软件包安装后立即启用 tailscaled,但进程在一秒内失败,日志清楚指出了原因:
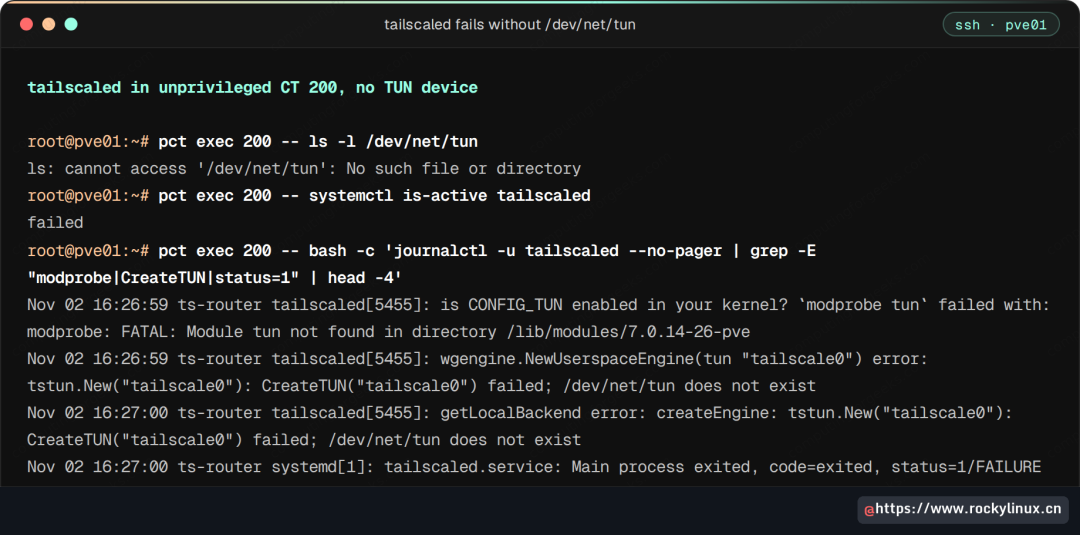
留意 modprobe 这一行,它很容易让人误判。实验使用的 Proxmox 内核 7.0.14-26-pve 配置为 CONFIG_TUN=y,TUN 已编译进内核,没有可加载的模块,所以 modprobe tun 找不到模块。宿主上已经有 /dev/net/tun,只是容器无权访问而已。不需要加载模块,也不需要切换到特权容器。
进入下一节前执行 exit 离开容器 shell,因为设备要在 Proxmox 宿主上添加。下面两种方法都会写入相同的 dev0 容器配置。
通过 pct set 直通 /dev/net/tun
容器选项 devN 在 pct(1) 中写为 --dev[n] [[path=]<Path>],可以设置 mode、uid、gid 和 deny-write。它替代了旧教程中直接写入 /etc/pve/lxc/<CTID>.conf 的 lxc.cgroup2.devices.allow、lxc.mount.entry 配置。Proxmox 会验证该选项并在网页界面显示;非 root 管理员恢复容器时也能保留它,而原始的 lxc.* 配置会在非 root 恢复时被跳过。在宿主上执行:
pct set 200 --dev0 /dev/net/tun
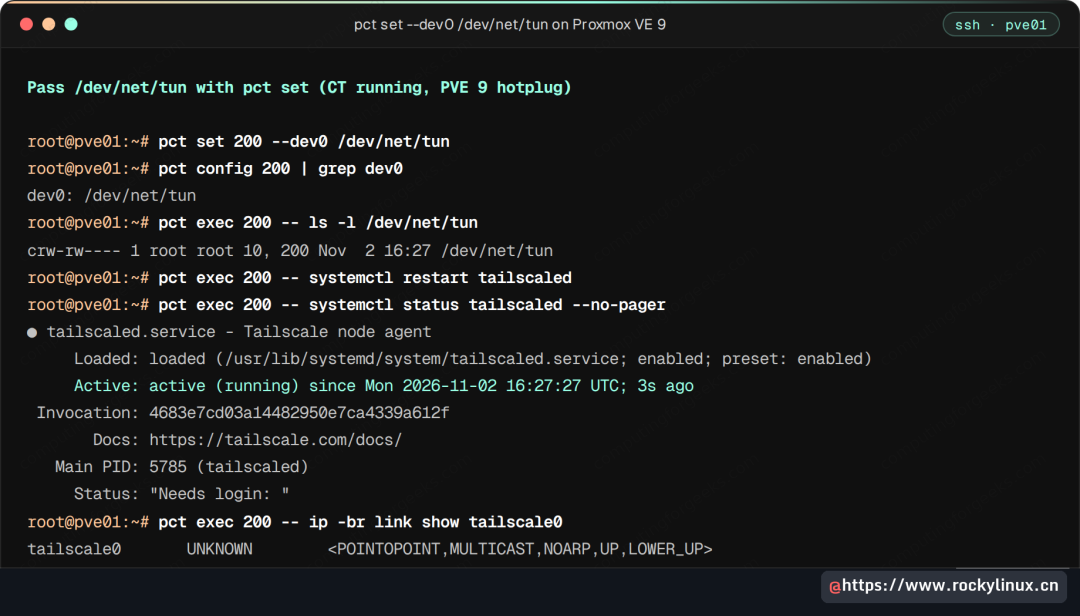
Proxmox VE 9 无需先停止容器。实验在容器运行时添加设备,设备立即出现在容器内,这与 9.0 引入的运行中设备热插拔功能一致。检查配置和容器:
pct config 200 | grep dev0
pct exec 200 -- ls -l /dev/net/tun
应该看到主设备号 10、次设备号 200 的字符设备。它们与宿主 /dev/net/tun 的设备号一致,说明容器看到的是正确的宿主设备节点:
dev0: /dev/net/tun
crw-rw---- 1 root root 10, 200 Nov  2 16:27 /dev/net/tun
热插拔后权限为 crw-rw----,完整重启容器后变成 crw-rw-rw-。动态添加和全新启动时权限可能不同;tailscaled 以 root 运行,两种权限都能正常工作。添加设备时,systemd 通常已经因为五次快速失败而停止重试,先清除失败状态再启动服务:
pct exec 200 -- systemctl reset-failed tailscaled
pct exec 200 -- systemctl restart tailscaled
pct exec 200 -- systemctl status tailscaled --no-pager
这次守护进程持续运行并显示 Needs login,容器内也出现了 tailscale0 接口:
Tailscale 的 LXC 文档还建议执行 pct set <CTID> --features keyctl=1,nesting=1。实验容器只有上面显示的 features: nesting=1,未启用 keyctl,但启动、加入网络、路由和重启后恢复都正常。仅当容器内其他软件确实需要时才添加。
通过网页界面添加 TUN 设备
网页界面同样写入 dev0 条目,适合已经在浏览器中管理节点的场景。实验将它用于 CT 201(ts-client),该容器此前与 CT 200 一样已安装 Tailscale 但启动失败。在资源树中选择容器,然后:
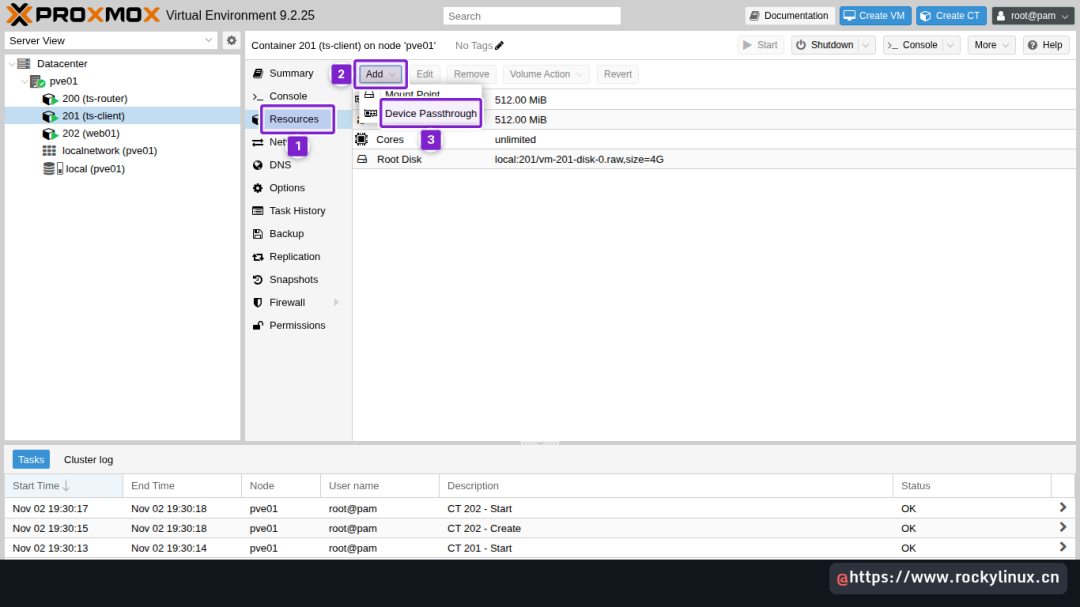
- 打开容器菜单的 Resources(资源)。
- 点击资源列表上方的 Add(添加)。
- 选择 Device Passthrough(设备直通)。
Add: Device 对话框只需填写一个值。除非需要指定权限或所有者,否则不要勾选 Advanced(高级):
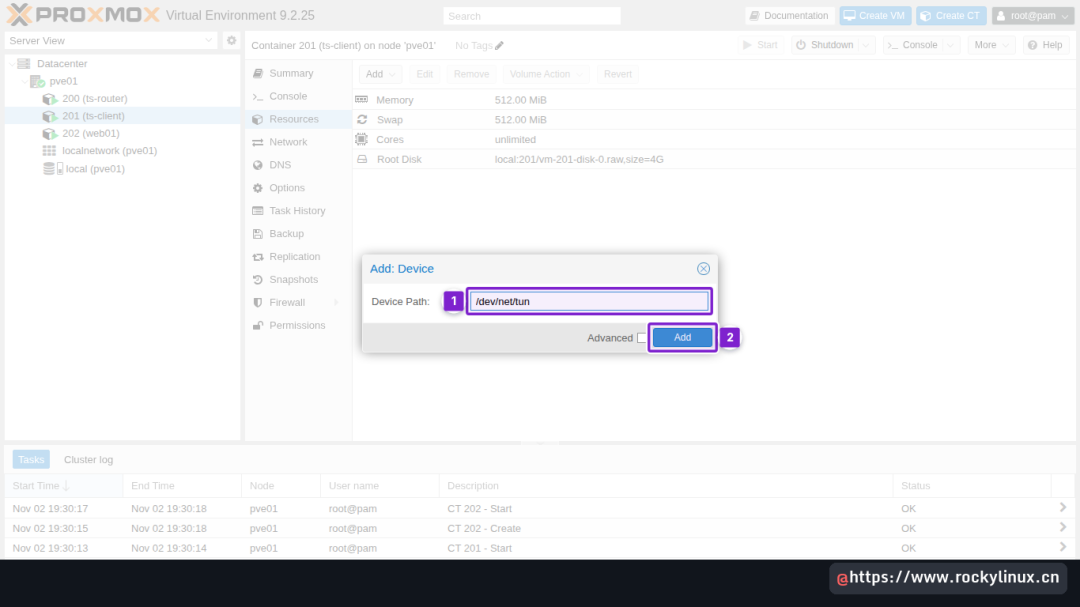
- 在 Device Path(设备路径)中输入
/dev/net/tun。
- 点击 Add 保存。
容器资源列表出现 Device (dev0)。与命令行方法一样,修改立即应用到运行中的容器,无需重启:
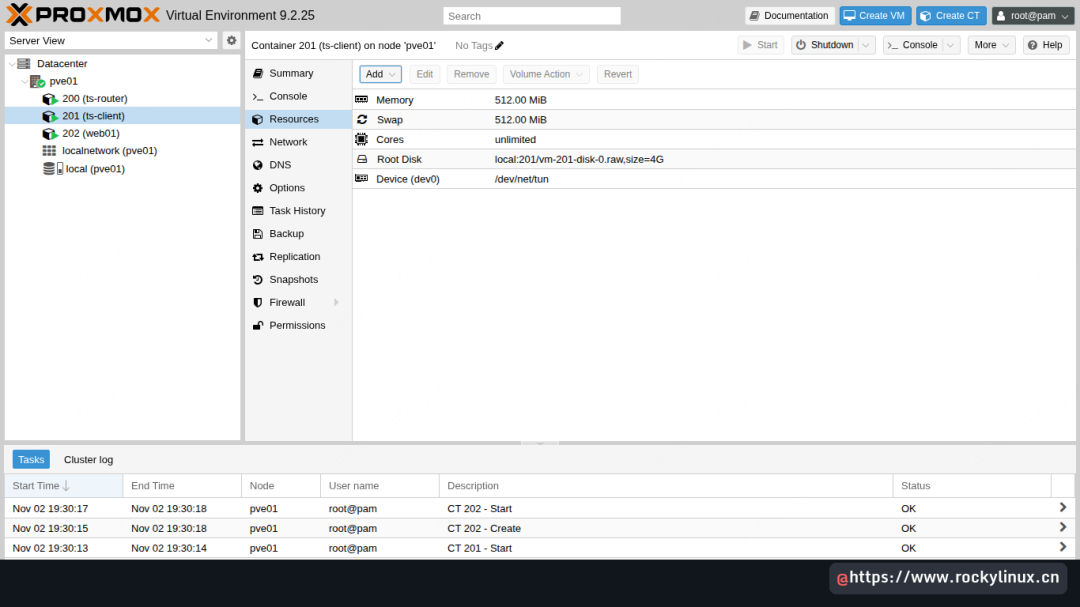
回到宿主,配置行与 pct set 写入的完全一致。清除失败状态后,tailscaled 即可启动:
pct config 201 | grep dev0
pct exec 201 -- systemctl reset-failed tailscaled
pct exec 201 -- systemctl restart tailscaled
pct exec 201 -- systemctl is-active tailscaled
CT 201 的两项检查均通过。网页界面和命令行写入的是同一个配置键,日后可以随时换用另一种管理方法,无需清理:
dev0: /dev/net/tun
active
按节点管理习惯选择即可。使用脚本或 Ansible 构建容器时,pct set 是可重复执行的幂等命令。单个容器适合网页界面操作;下次打开 Resources 时能直接看到设备,便于其他管理员理解配置。
将容器加入 tailnet
设备就绪后连接节点。使用 Tailscale 托管服务时,普通 tailscale up 会输出登录地址。实验控制服务器是 Headscale,所以添加 --login-server;同时通过 --hostname 固定节点名。在 CT 200 内执行:
tailscale up --login-server http://10.10.10.1:8080 --hostname ts-router
命令会等待节点获批,随后输出 Success. 并返回。保留这个 shell;获批前关闭它,下一次登录会生成新地址:
To authenticate, visit:

    http://10.10.10.1:8080/register/hskey-authreq-uzGc_Z6juYT1Y_s3mtZTOj4q

Success.
使用 Headscale 时,在控制服务器执行 headscale auth register --auth-id <登录地址中的 ID> --user josphat。使用 Tailscale 服务则打开输出地址并登录。无人值守容器可以通过 --auth-key 提供认证密钥,省去浏览器步骤。确认节点获得 tailnet 地址:
tailscale status
tailscale ip -4
ip -br addr show tailscale0
地址绑定到真实的内核接口,这就是 TUN 设备带来的本质区别。容器内任何程序都能通过普通套接字访问 tailnet 对端,ssh、curl 无需代理设置或专用参数:
100.64.0.1  ts-router  josphat  linux  -
100.64.0.1
tailscale0       UNKNOWN        100.64.0.1/32 fd7a:115c:a1e0::1/128 fe80::7bd5:fe25:e389:c5fa/64
Tailscale 可能接管容器内的 /etc/resolv.conf。实验中它写入了 nameserver 100.100.100.100,并注明由 Tailscale 生成;DNS 在容器重启后仍正常。若要保留 Proxmox 设置的解析器,可按 tailscale dns status 的提示执行 tailscale set --accept-dns=false。同样的安装和加入流程也适用于完整虚拟机或裸机。
将容器配置为子网路由器
子网路由器是 LXC 中运行 Tailscale 的常见用途:一个小容器就能让 tailnet 设备访问局域网、Proxmox 网页界面以及无法安装 Tailscale 的机器。普通部署只需通告容器 eth0 所在的局域网,可以跳过下一条命令。实验通告另一张隔离网络,以证明流量确实经过路由器:vmbr1 是没有物理端口和宿主地址的网桥,与 vmbr0 一样定义在宿主 /etc/network/interfaces 中;CT 202 web01 地址为 10.20.20.30。在宿主上为 CT 200 添加连接该网桥的第二个接口:
pct set 200 --net1 name=eth1,bridge=vmbr1,ip=10.20.20.20/24
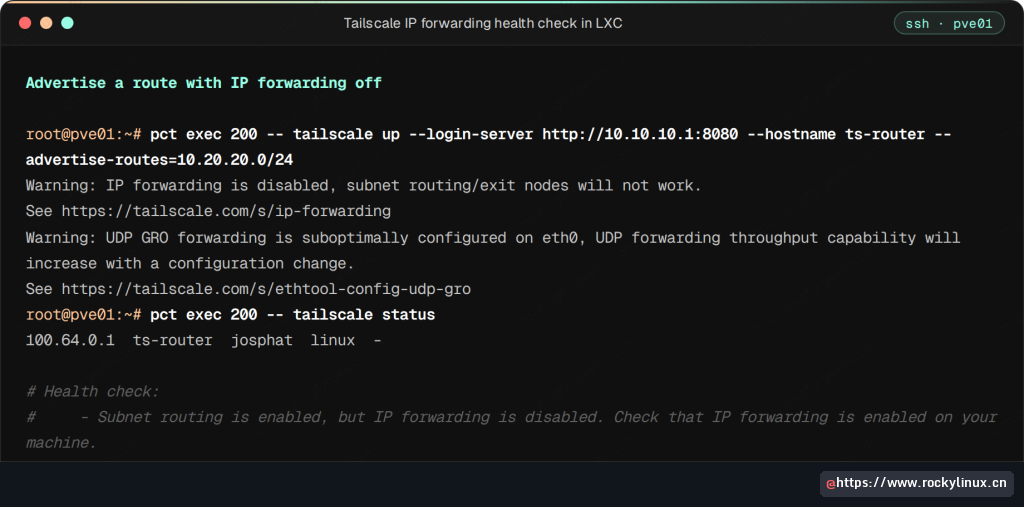
在容器内通告路由。实验先用 sysctl -w net.ipv4.ip_forward=0 关闭转发,以观察当前 Tailscale 的提示。自己的节点只有在转发确实关闭时才显示转发警告,GRO 警告则不受这一条件影响:
tailscale up --login-server http://10.10.10.1:8080 --hostname ts-router --advertise-routes=10.20.20.0/24
两条警告立即出现;转发问题修复前,tailscale status 会持续保留健康检查提示。相比只输出一次的 tailscale up 警告,这个状态提示更便于后续检查者发现问题:
实验节点上的新容器默认已有 net.ipv4.ip_forward = 1,但 net.ipv6.conf.all.forwarding = 0。每个非特权容器都有独立网络命名空间和 sysctl 设置,初始值取决于宿主,也可能随宿主重启变化。应在容器内把两项配置写入文件,使其持久生效:
echo 'net.ipv4.ip_forward = 1' | tee -a /etc/sysctl.d/99-tailscale.conf
echo 'net.ipv6.conf.all.forwarding = 1' | tee -a /etc/sysctl.d/99-tailscale.conf
sysctl -p /etc/sysctl.d/99-tailscale.conf
非特权容器允许修改这些参数,因此 sysctl -p 能成功回显新值。Proxmox 宿主的设置不受影响,同一节点上的其他来宾也不会因此改变:
net.ipv4.ip_forward = 1
net.ipv6.conf.all.forwarding = 1
第二条警告涉及 eth0 的 UDP GRO(通用接收卸载),它限制转发吞吐量,而不是让路由失效。实验原以为非特权容器会拒绝 ethtool 修改,但 veth 属于容器自己的命名空间,修改成功了。安装 ethtool,按 Tailscale 性能指南设置:
apt install -y ethtool
ethtool -K eth0 rx-udp-gro-forwarding on rx-gro-list off
ethtool -k eth0 | grep -E "rx-udp-gro-forwarding|rx-gro-list"
回读时两项功能均为预期值。如果自己的容器拒绝修改,路由仍然可用,可稍后再处理吞吐量优化:
rx-gro-list: off
rx-udp-gro-forwarding: on
ethtool 修改只持续到接口被重新创建;容器重启会重建 veth。在容器内添加一个 oneshot 单元,在 tailscaled 启动前重新应用设置。创建单元文件:
nano /etc/systemd/system/tailscale-gro.service
写入实验使用的配置:
[Unit]
Description=UDP GRO forwarding for Tailscale on eth0
After=network-online.target
Wants=network-online.target
Before=tailscaled.service

[Service]
Type=oneshot
ExecStart=/usr/sbin/ethtool -K eth0 rx-udp-gro-forwarding on rx-gro-list off

[Install]
WantedBy=multi-user.target
启用单元,然后从宿主重启容器,验证整套配置能自行恢复:
systemctl daemon-reload
systemctl enable tailscale-gro.service
在 Proxmox 宿主上重启 CT 200:
pct reboot 200
等待 10~15 秒完成启动,再检查设备、sysctl 和 GRO 标志。尤其注意 IPv6 转发:实验中新容器的 IPv4 转发本就开启,单独检查它无法证明配置文件生效:
pct exec 200 -- bash -c "ethtool -k eth0 | grep rx-udp-gro-forwarding; sysctl net.ipv4.ip_forward net.ipv6.conf.all.forwarding; ls -l /dev/net/tun"
重启后三项设置全部恢复。设备来自容器配置的 dev0,sysctl 来自 /etc/sysctl.d 文件,GRO 来自新单元;若某项缺失,可以分别找到对应配置位置:
rx-udp-gro-forwarding: on
net.ipv4.ip_forward = 1
net.ipv6.conf.all.forwarding = 1
crw-rw-rw- 1 root root 10, 200 Nov  2 16:53 /dev/net/tun
随后 systemctl status tailscale-gro 显示 inactive (dead)、status=0/SUCCESS,这是未设置 RemainAfterExit 的 oneshot 单元完成工作后退出的正常状态。重新执行相同的 tailscale up 已无警告,tailscale status 中的健康检查也消失了。
通告路由后仍需控制服务器批准。使用 Tailscale 服务时,在管理控制台的 Machines 中打开路由器菜单,选择 Edit route settings,勾选子网;同一个对话框还有后面要用的出口节点开关。Headscale 中,先用 headscale nodes list 查节点 ID(实验中 ts-router 为 1),再按 ID 批准路由:
headscale nodes approve-routes -i 1 -r 10.20.20.0/24
headscale nodes list-routes
留意最后三列:Available 表示节点已通告路由,Approved 表示控制服务器已接受,Serving 表示已通知对端使用。只有 Available 有值的路由仍在等待批准:
Node updated
ID | Hostname  | Approved      | Available     | Serving (Primary)
1  | ts-router | 10.20.20.0/24 | 10.20.20.0/24 | 10.20.20.0/24
Linux 客户端默认忽略子网路由,应在 CT 201 加入网络时设置 --accept-routes。此前 CT 201 到 10.20.20.30 的 curl 失败,因为它没有连接 vmbr1 的接口,宿主也没有可用于转发的该网段地址:
tailscale up --login-server http://10.10.10.1:8080 --hostname ts-client --accept-routes
批准 ts-client 后,路由出现在 Tailscale 路由表 52 中,隔离网络里的网页服务器可以经路由器访问:
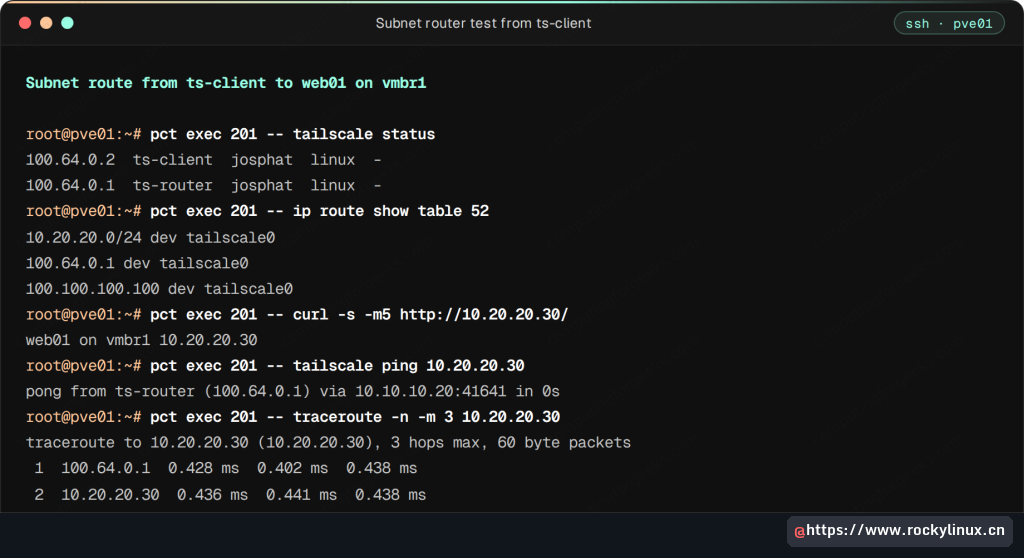
关键证据是 traceroute:第一跳为路由器的 tailnet 地址 100.64.0.1,第二跳为 web01。两个容器位于同一 Proxmox 节点,tailscale ping 找到经过 10.10.10.20:41641 的直接路径,没有使用中继。同样的模式也适用于 tailnet 中的 pfSense 主机,或需要通过单个节点访问的其他站点。
将容器用作出口节点
出口节点把客户端全部互联网流量经容器发出,适合在酒店或咖啡馆使用家里的网络出口。它与子网路由器需要相同的转发配置,因此 CT 200 已就绪。在容器内通告出口节点:
tailscale set --advertise-exit-node
在控制服务器批准。Tailscale 服务使用 Edit route settings 对话框中的出口节点选项。Headscale 中出口节点对应 0.0.0.0/0、::/0 两条路由;approve-routes 会替换路由列表,务必同时保留原有子网:
headscale nodes approve-routes -i 1 -r 10.20.20.0/24,0.0.0.0/0,::/0
客户端选择该路由器作为出口节点,并跟踪一个公网地址。实验客户端与路由器共用上行链路,不论是否经过出口节点,公网 IP 都相同,所以 traceroute 比查公网 IP 更有判别力。在 CT 201 内执行:
tailscale set --exit-node=ts-router
tailscale status
traceroute -n -m 3 1.1.1.1
tailscale status 将 ts-router 标记为活动出口节点;跟踪结果先经过它,再到宿主 NAT 网关:
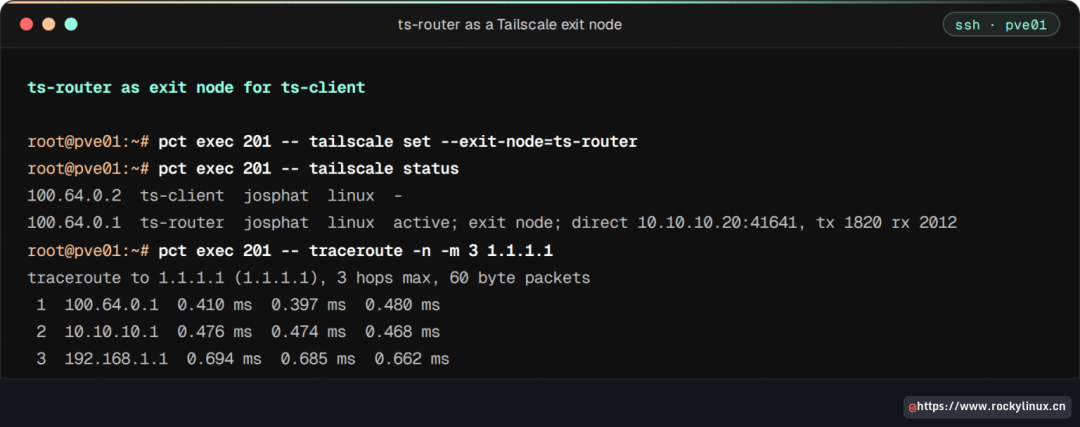
512 MB 内存的容器足以为几部手机和笔记本提供出口,但仍与节点上其他工作负载共享上行链路。若需要独立旅行设备,可参考 GL.iNet 出口节点配置及支持原生 Tailscale 的旅行路由器清单。
退回用户空间网络模式
有时无法修改容器配置,例如托管商提供的 LXC,或自己没有管理权限的节点。Tailscale 可以在用户空间处理数据包,不依赖 /dev/net/tun。实验 CT 203 完全没有设备;在容器内为 Debian 软件包启动时读取的 /etc/default/tailscaled 添加参数:
sed -i 's|^FLAGS=.*|FLAGS="--tun=userspace-networking --socks5-server=localhost:1055"|' /etc/default/tailscaled
systemctl reset-failed tailscaled
systemctl restart tailscaled
以相同的 tailscale up ... --accept-routes 加入后,取舍很明显:节点已加入 tailnet,tailscale ping 正常,但内核不知道 100.64.0.0/10 的路由,普通工具只有通过 SOCKS5 代理才能访问:
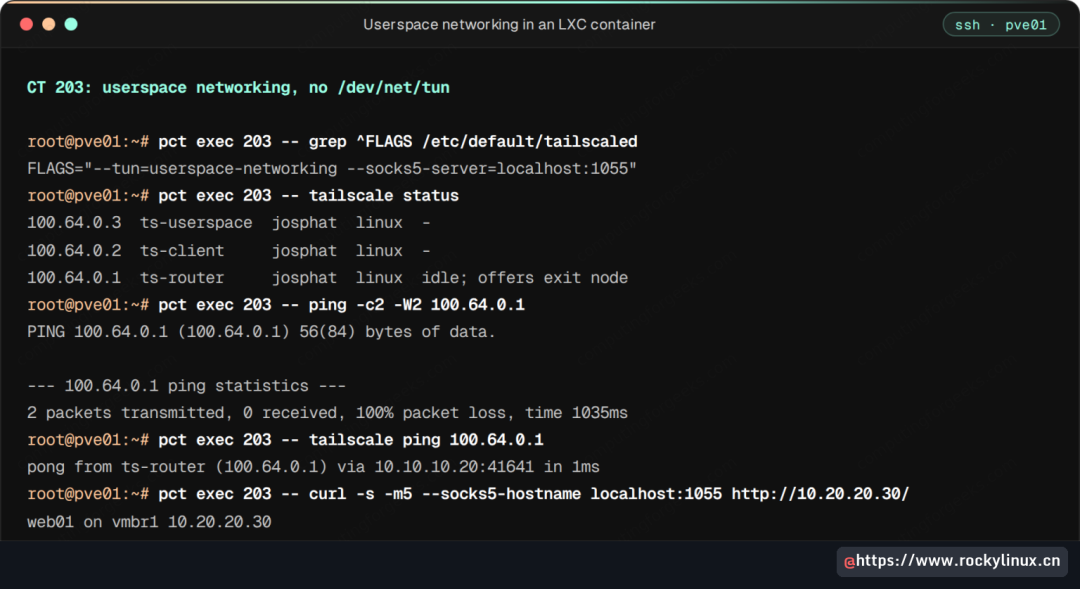
CT 203 直接运行 curl http://10.20.20.30/ 超时,退出码为 28;添加 --socks5-hostname localhost:1055 后,同一请求能经子网路由器取得页面。因此用户空间模式适合只需被访问,或只运行一个支持代理工具的容器;对于依赖普通套接字的应用则不合适。能添加设备时,应优先添加。
修复实验遇到的错误
以下错误均出现在 Proxmox VE 9.2、Tailscale 1.104.4 的实验中,提示文字保留终端原样。
CreateTUN("tailscale0") failed; /dev/net/tun does not exist
容器缺少 TUN 设备。用 pct set <CTID> --dev0 /dev/net/tun,或依次选择 Resources、Add、Device Passthrough 添加,再重置失败状态并重启 tailscaled。前面的 modprobe tun 错误只是 TUN 驱动已内置的结果,并非根因。
tailscaled.service: Start request repeated too quickly
五次快速失败后 systemd 会停止重试,仅添加设备不会恢复服务。先在容器内执行 systemctl reset-failed tailscaled,再运行 systemctl restart tailscaled;也可以直接重启容器。
failed to connect to local tailscaled; it doesn't appear to be running
任何原因导致守护进程停止时,tailscale 命令都会显示此错误。先检查 systemctl status tailscaled 和日志;容器中最常见的原因就是缺失 TUN 设备。
Warning: IP forwarding is disabled, subnet routing/exit nodes will not work
tailscale up 搭配 --advertise-routes 或 --advertise-exit-node 时输出此警告,tailscale status 也会持续保留健康检查。应在容器的 /etc/sysctl.d/99-tailscale.conf 中设置 IPv4、IPv6 两项转发参数,因为容器网络命名空间拥有独立的值。
不修复时仍然能路由,只是在高 UDP 负载下更慢。ethtool -K 可以在非特权容器内设置,上面的 oneshot 单元让它能在容器重启后继续生效。
 发表于 前天 00:20
|
查看: 95|
回复: 0
 /1


