一个拥有 2.78 万亿参数的大模型,通常意味着 TB 级模型文件和大量 GPU 资源。
随着大语言模型规模不断扩大,模型参数早已从百亿级跨入万亿级阶段。更大的模型带来了更强的能力,也带来了全新的部署挑战。
对于普通设备而言,限制大模型运行的往往不是模型本身的推理能力,而是庞大的权重规模、内存占用以及数据读取压力。
尤其是 Mixture-of-Experts(MoE,混合专家)架构模型,虽然每次推理只会激活部分专家,但完整模型仍然包含全部参数。如何避免一次性加载所有模型权重,让超大规模模型在有限硬件资源上运行,已经成为大模型推理系统优化中的关键方向。
最近,开发者 Fareed Khan 开源了 kimi-k3-in-c 项目,尝试用 C 语言重新实现超大规模模型推理。这个项目只有 176KB 纯 C99 代码,无需 GPU、PyTorch 或 BLAS,仅依靠单 CPU 和 8.24GB 内存,即可进行 Kimi K3 推理运行(2.78T 参数,1.56TB checkpoint)。
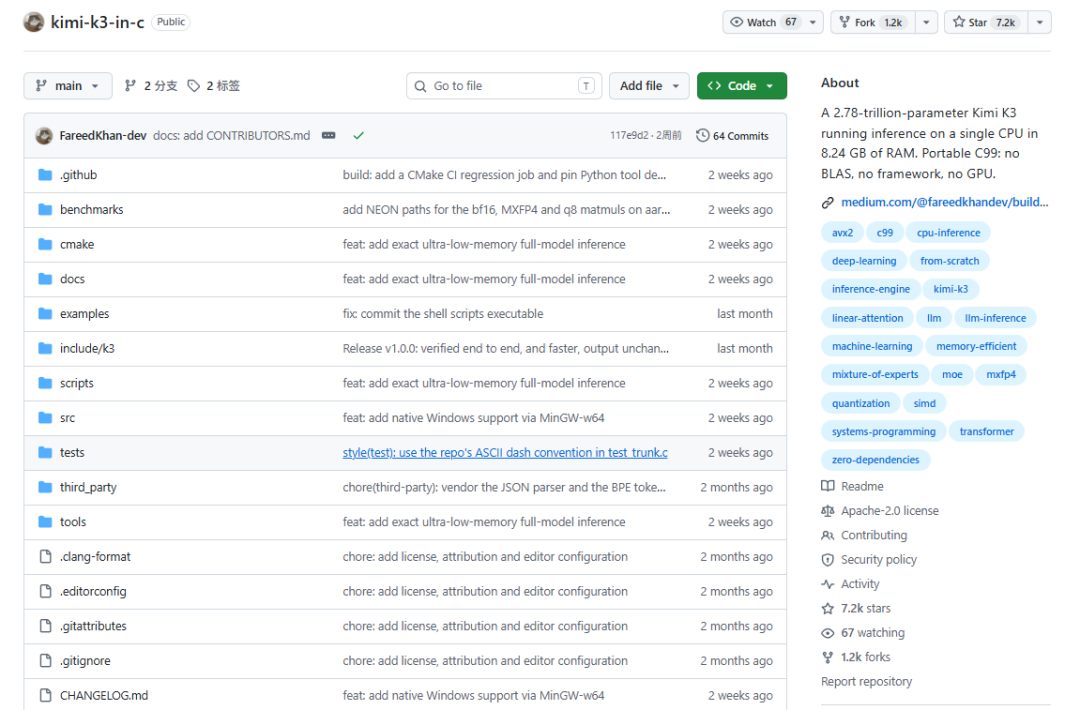
更关键的是,项目通过底层推理优化,让 8GB 环境下的运行结果与 224GB 环境达到字节级一致。它没有继续堆砌硬件资源,而是重新设计了模型读取、参数管理以及计算流程,让超大规模模型可以在更低资源环境中运行。
01 176KB纯C引擎直接运行 2.78T参数模型
过去运行大型语言模型,通常需要完整的推理框架。这些框架提供了丰富的算子优化、硬件适配以及运行管理能力,但同时也带来了额外的软件依赖和系统开销。
kimi-k3-in-c 选择了一条更底层的路线。项目直接使用 C99 语言编写推理引擎,将模型加载、计算执行以及内存管理控制到更细粒度。
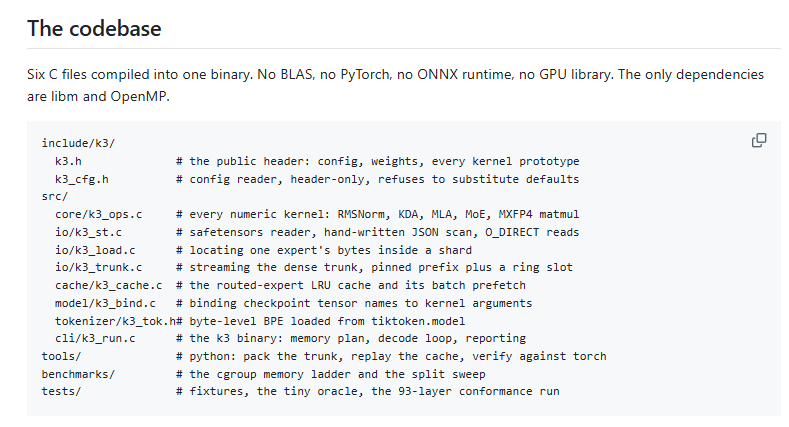
相比依赖大型推理框架,这种方式可以让开发者直接掌控模型运行过程中的数据流。对于普通规模模型来说,这种底层实现未必有明显优势;但对于 Kimi K3 这样的超大规模 MoE 模型,减少任何额外开销都可能显著影响最终运行成本。
作为超大规模 MoE 模型,Kimi K3 的完整 checkpoint 达到 1.56TB。如果按照传统方式加载模型,大量参数需要提前驻留内存,即使拥有较大硬件资源,也会面临巨大的存储和访问压力。因此,kimi-k3-in-c 的重点并不是改变模型结构,而是改变模型运行时的数据访问方式。
02 不加载全部参数,让2.78T模型进入8GB内存
kimi-k3-in-c 的核心并不是简单压缩模型,而是重新设计推理过程。
对于 MoE 模型来说,最大的问题之一就是专家参数规模。模型包含大量专家网络,但每一次推理只需要其中一部分 Expert 参与计算。如果提前加载所有专家,会造成大量无效内存占用。因此,项目采用专家流式加载(Expert Streaming Loading)——不会提前将全部专家加载到内存,而是在计算需要时读取对应专家,从而降低常驻内存压力。
但除了模型参数本身,长上下文推理中的缓存状态同样会占用大量资源。另一个关键变化来自 KDA 机制。传统 KV Cache 会随着上下文长度不断增加,长文本场景下很容易成为新的内存瓶颈。
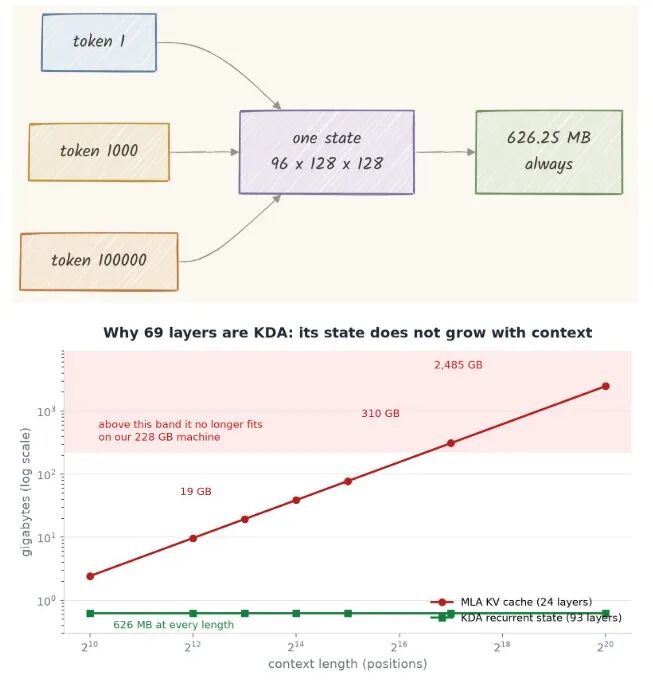
Kimi K3 中的 KDA 将部分计算状态固定下来,使状态规模不会随着输入 token 数量增加而持续增长。项目展示的数据中,KDA 状态约为 626MB,而传统 KV Cache 随着上下文增长可能达到数百 GB 甚至 TB 级别。这意味着模型运行时并不需要让所有状态都跟着上下文一起膨胀。
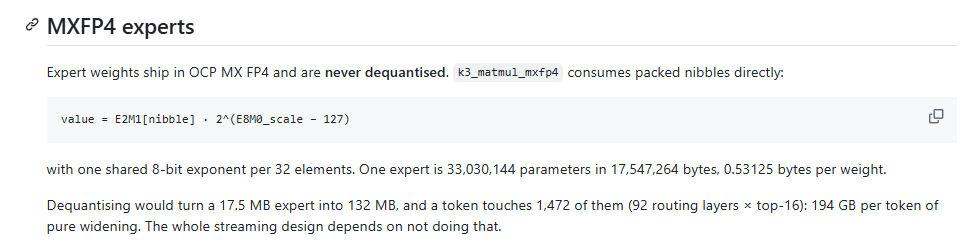
除了参数加载和状态管理,项目还优化了计算过程。在计算阶段,项目进一步采用 MXFP4 直接计算(Direct MXFP4 Computation)。传统量化推理通常需要先将低精度数据恢复为更高精度格式再参与计算,这一过程会增加额外的计算和存储开销。项目则尝试直接利用 MXFP4 格式参与计算,减少反量化过程带来的额外开销。
对于模型主体权重读取,项目采用 O_DIRECT 流式读取(O_DIRECT Streaming Read),减少缓存层额外占用,提高大规模权重读取效率。
这些优化覆盖了模型运行中的不同环节:专家参数按需加载减少常驻内存占用,KDA 避免状态规模随上下文增长,MXFP4 计算与 O_DIRECT 读取则降低了计算和数据访问开销。
03 8GB和224GB环境输出保持字节级一致
降低内存占用之后,另一个关键问题是:模型输出能否保持一致?
项目展示的结果给出了明确答案——在8.24GB 内存环境下运行 Kimi K3,可以与224GB 内存环境下的运行结果保持字节级一致。
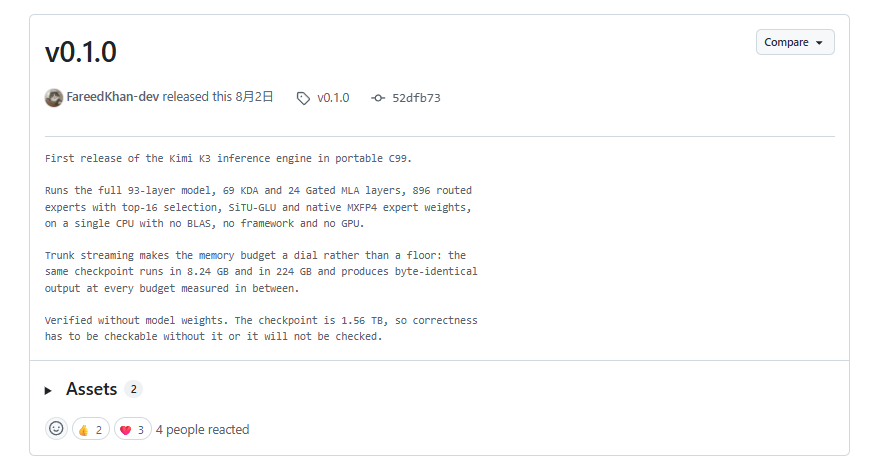
这说明项目并不是简单牺牲模型输出能力来换取低资源运行,而是在推理路径和数据访问方式上进行了重新设计。
过去,大模型部署更多依靠增加 GPU 数量、扩大显存规模。但随着模型规模持续提升,硬件扩展并不一定是唯一方向。kimi-k3-in-c 展示了一种不同的大模型部署思路:从推理系统本身寻找突破。通过更细粒度的内存管理、参数加载策略和计算优化,超大规模模型未来或许能进入更多低成本硬件环境。
这也说明,大模型时代不仅需要更大的算力,更需要更高效的推理系统。对这类底层推理引擎与系统优化方向感兴趣的开发者,不妨在云栈社区深入交流。
 发表于 4 天前
|
查看: 9|
回复: 0


