刚刚,DeepSeek 在 API 平台发布了一则公告:
V4.1 Flash 正式上线后,所有原本发往 V4 Pro 的请求,都会全部路由到 V4.1 Flash,并按照 V4.1 Flash 的价格计费。
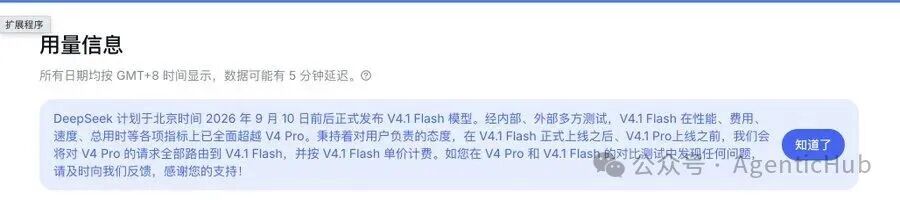
官方给出的理由非常直白:
经过内部和外部测试,V4.1 Flash 在性能、费用、速度、总用时等各项指标上,已经全面超过 V4 Pro。
也就是说,DeepSeek 不是让 Flash 和 Pro 并存一段时间慢慢过渡,而是准备直接让 Flash 接管 Pro 的全部流量。
一个 Flash 模型,把上一代 Pro 直接替掉了。这下 V4 Pro 基本可以提前退休了。
以往厂商更新模型,最常见的操作是:
- 新老模型并存
- 给用户充分迁移时间
- 生怕把已经调好的提示词和工作流弄崩
DeepSeek 这次却选择了更激进的方式。官方的核心判断很明确:继续用更高价格、更慢速度、更多算力去服务一个已经全面落后的模型,对用户并不合适。
所以干脆一步到位:请求全部路由到更强的 V4.1 Flash,价格还按更便宜的 Flash 标准收。
对用户来说,短期收益非常直观:
对 DeepSeek 来说,也能把算力资源更高效地集中到新架构上。
有人兴奋地直呼“太香了”,实测速度轻松跑到 300+ tokens/s,有的场景甚至更高。新架构 + 原生多模态加持下,日常对话、代码生成、简单 Agent 任务的体验都明显提升。
也有人比较谨慎:
- 已经针对 V4 Pro 调优的提示词和业务逻辑,突然切换可能出现行为差异
- 模型 ID 背后实际调用的模型随时可能变,可预期性下降
- ToB 场景里,速度突然变快又可能在 V4.1 Pro 上线后再次变化,不好向业务方解释
这些担忧并非多余。稳定性和可复现性,对生产环境同样关键。
DeepSeek 用实际行动告诉大家:V4.1 Flash 已经足够强,没必要再让用户为落后的版本多付钱、多等时间。 |  发表于 4 天前
|
查看: 13|
回复: 0


