Anthropic 正在冲刺两万亿美元的 IPO 估值预期。我的判断是:AI 应用成熟以后,80% 的日常推理任务会在本地完成——企业自己的服务器和个人的设备,而且其中多数是过去根本不会调用 AI 的新任务;云端留 20%,留最难、最值钱的那一块。上一次资本这样追捧基础设施是 2000 年,思科和 Sun 的市值冲到了顶;最后赚到大钱的,是 Google 和 Amazon,再后来是 Facebook 和 TikTok。
01 最贵的智能公司,会承包最多的智能工作吗
先看估值。Anthropic 最快 10 月上市,投资者给出的估值预期是两万亿美元。按这个数计算,它会超过 SpaceX 六月创下的 1.77 万亿纪录,成为估值最高的 IPO。支撑它的是二季度 115 亿美元的单季收入,是上年同期的 14 倍,年化收入超过 850 亿美元;路演材料里写的白领劳动力市场空间是 30 万亿美元。
大家都在争论 AI 泡沫有多大。我想起 2000 年那一轮互联网泡沫的历史,思科卖路由器,Sun 卖服务器,微软卖操作系统,它们是当时的"智能供应商"。后来路由器和服务器变成了谁都能买的标准件,主要收入转到了长在它们上面的应用公司手里。
这一轮的收入利润账已经有人算过。投资人 Apoorv Agrawal 把生成式 AI 拆成芯片、云基础设施、应用三层:2024 年芯片层拿走近九成毛利润,两年后仍有近八成;成熟云计算正好倒过来,七成在应用层。他把 OpenAI 和 Anthropic 也归在应用层。
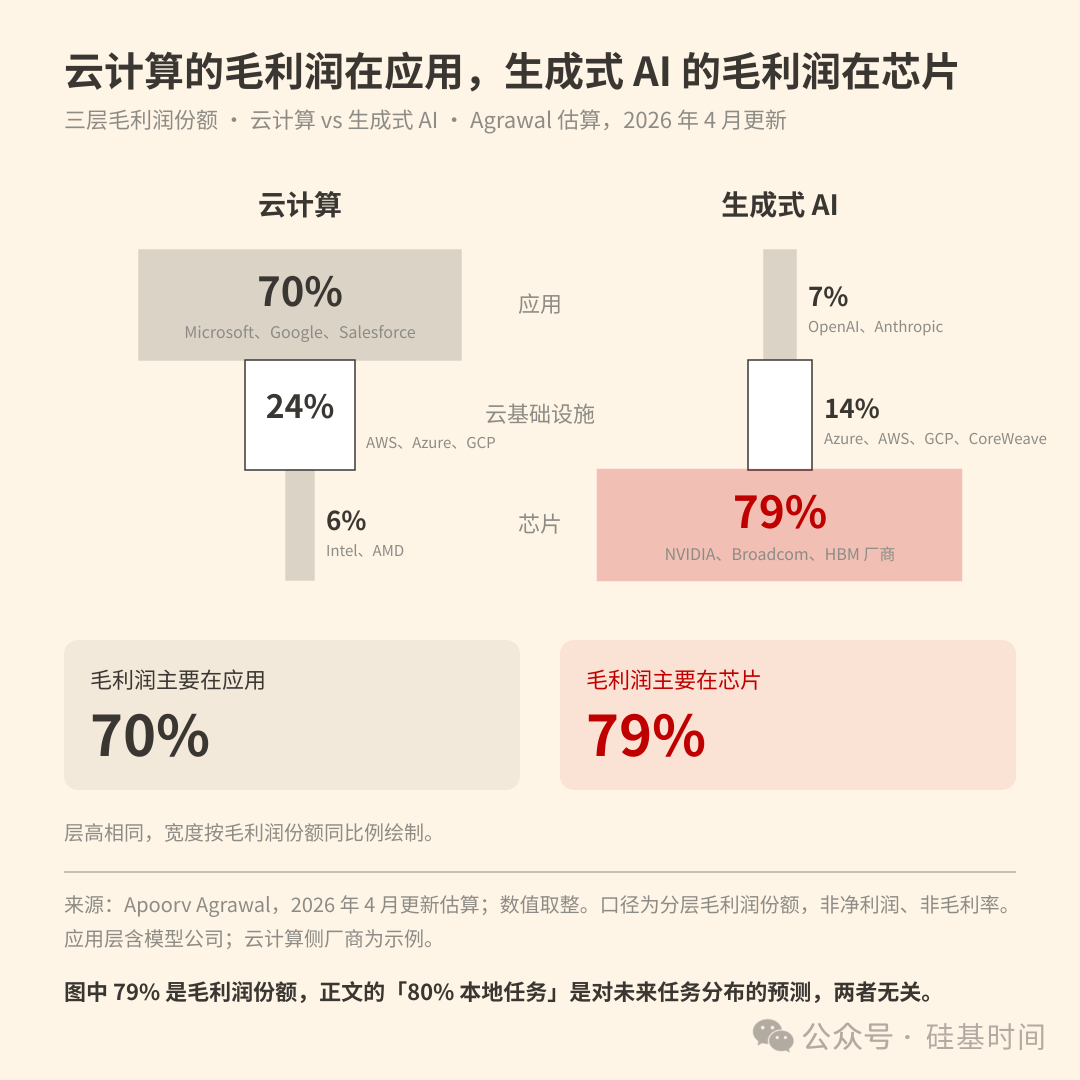
来源:Apoorv Agrawal 估算,2026 年 4 月更新
问题随之而来:生产智能这么贵、利润又这么集中,应用要怎么才能繁荣?Anthropic 和思科不一样,它卖订阅和 API,自己做应用,类似于微软下场做 Office;但两轮有一点相同——基础设施再值钱,也包办不了上面应用的价值。下一代入口格局,还没有定型。
利润倒挂要翻过来,得靠上游的降价一层层传到下游。上一轮靠两件事:
一是有替代的供应商,而且换起来不贵:AMD 没有压掉英特尔的利润,Linux 却压掉了 Unix 的溢价,差别就在换的成本。
二是开放的体系,让用户自己动手组织生产。这一轮对应的,是替代芯片,和开放权重加本地推理。本地化就算接不走全部任务,也会逼云端重新定价:客户能够自己生产,是供应商定价必须面对的一条边界。
我的判断是——
最强的模型会在云端,最多的日常任务会在本地。
AI 应用成熟以后,日常推理任务八成在本地、两成在云端——这是对任务分布的预测,不是对算力或收入的预测。盛大联合创始人、WiFi 万能钥匙创始人陈大年是我的老朋友,他在盛大创新院十八周年的聚会上也提出了一个 80% 的判断,列在他的"AI 时代的八条非共识"里。他说的是本地模型的市场份额,我说的是日常任务的完成位置。
他讲的是 Sun。当年 Sun 的服务器贵、门槛高,操作系统 Solaris 比 Linux 和 Windows Server 性能好很多,许多头部网站 eBay、Amazon 等用的都是它的服务器。2000 年 Sun 市值冲到两千亿美元;之后被 PC 服务器一点一点打掉,2010 年以 74 亿美元卖给了甲骨文,不到高峰市值的 4%。PC 服务器赢的不是单台性能,是便宜、够用、随用随扩。他的判断是:今天的云端大模型,就是 AI 时代的 Sun——高价的数据中心服务器,会被开源模型加本地 x86 服务器打败。他比我激进,认为本地会摧毁云端;我认为云端的那 20%,恰恰是最值钱的一块。
02 一万个 Agent 在云端,六个 Agent 在桌上
9 月 8 日,OpenAI 公布了纳维–斯托克斯方程相关问题的解法:把上万个 Agent 组成一个研究团队,互相交换、筛选结果,跑了 88 小时。证明还在审,谁先做出来也有争议,但做法已经清楚了。此前 5 月,它的内部模型自己推翻了困扰数学界 80 年的 Erdős 单位距离猜想,算下来花了不到 1,000 美元。
9 月 10 日,北京,AMD 锐龙 AI Max 媒体沙龙。一台 128GB 的桌面工作站,单个 Agent 每秒 45 个 Token,多 Agent 模式下六个 Agent 各带 95K 上下文同时跑——六路并发时跑多快、完成率多少,材料没有给。三个月前,英伟达和微软在台北发布 RTX Spark,128GB 统一内存,十月上市,微软同步一款在 Windows 上本地跑 AI 代理的软件。
两幅画面放在一起,分工就清楚了。前沿实验室负责把上限往上推;开源模型负责把成熟的能力做成谁都装得起的版本;桌上那台机器负责把每天的活干完。
问题从来不是"本地模型比 Opus 强不强",而是"你每天的任务需要不需要 Opus"。一个订单异常、一份周报、一段客服对话,验收标准是"做对了没有",不是"有没有突破"。
03 为什么我判断是本地 80%
三股力量。
第一,能力跨过了可用线。 这条线是 Opus 4.6 画的。2 月 5 日发布,Anthropic 把它做成了编程和 Agent 模型:一百万 Token 上下文,几个 Agent 组队干活,在大型代码库里自己规划、自己复查、自己改错。在开发者手里,AI 写代码从此不只是辅助,是交付——这是一个革命性的产品,编程能力惊艳,改变了开发者的工作方式。Claude Code 去年 5 月才向公众开放,到今年初年化收入已超过 25 亿美元,Opus 4.6 之后更是一骑绝尘。
六个月后,8 月 14 日开源的 Qwen3.8-27B,官方模型卡 24 项评测里 16 项超过 Opus 4.6 Max;电脑操作那一项 84.3 分,公开分数已经追到 5 月的旗舰 Opus 4.8。
它是 27B 稠密模型,4bit 量化后权重约 17.5GB,所测五项任务平均降分很小——一台 24GB 内存的笔记本装得下;跑得多快、上下文缓存要多少内存、能同时跑几路,另说。
同一个 27B 尺寸,4 月到 8 月两代,参数没动,编程 Agent 的分数涨了 8 分;按这个速度,年底一版 27B 就到 Opus 4.8 的水平,也就是今年 5 月的旗舰。到了这条线,本地模型就够应付大部分应用了。从这几项评测看,开源落后闭源约半年,测试条件不同,仍要业务验证。前沿也没停:METR 在软件任务上观察到,模型以五成成功率能完成的任务时长,大约每七个月翻一倍。所以我给这个判断一个能被推翻的条件:如果连续两代开源在编程 Agent 和电脑操作上的落差从半年拉到一年,80 这个数就下调。
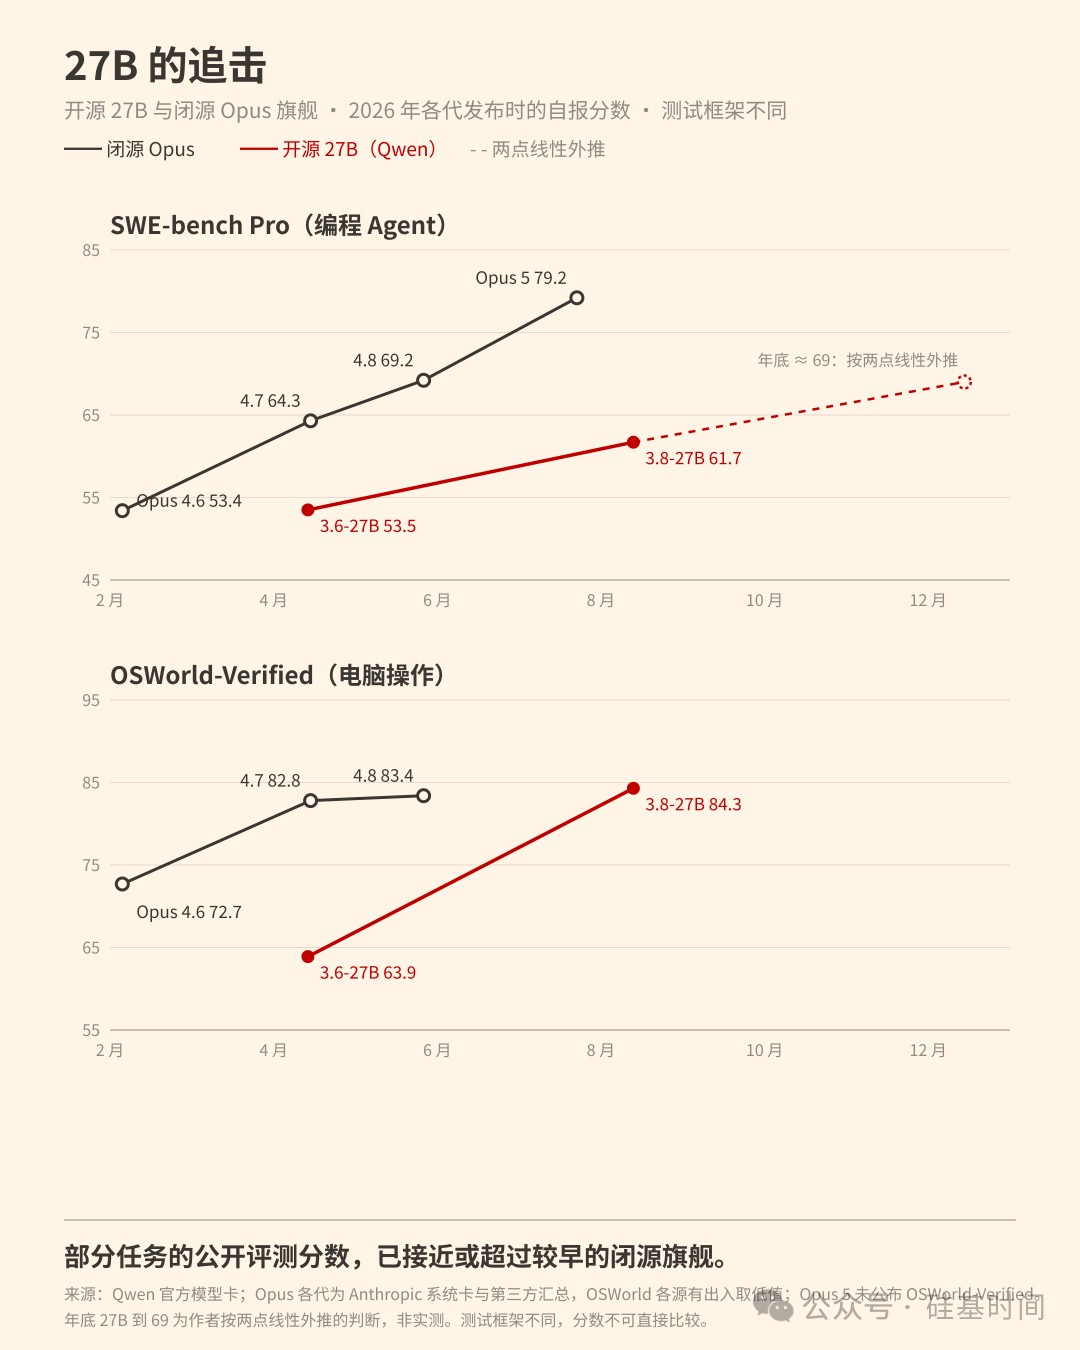
够用不等于全面追平。27B 追不上的是高难度学术推理那一层;它追得上的是编程 Agent、电脑操作、指令遵循,那是每天业务的活。长程规划两边都缺,本地的解法是把长任务拆短、把失败上云。
第二,高频使用改变了经济账。 一个语音应用,10 万日活,每人每天聊 10 分钟。按 OpenAI 实时语音的公开单价,只算新增音频、不含文本,一个月约 1,000 万元;换成阿里云百炼的 Qwen3.5 Omni Flash,约 137 万。
本地不是零成本,它改变的是成本的结构——低频、不确定的需求适合按量买,稳定、高频的工作让固定投入更容易摊薄。一台整机按 100 瓦、每秒 50 个 Token 算,不停跑 23 天生成一亿 Token,56 度电;同样一亿 Token 在云上,按开源模型的托管价,两千块上下。前者只计运行电耗,没算设备折旧、运维和纠错,两者不是完整成本的直接比较。这不是"本地一定便宜",是"用得越多,临界点来得越早"。应用越高频,越会往本地沉。
第三,智能会跟着数据、工具和权限走。 文件在哪、设备在哪、权限在哪,Agent 就在哪。去年初 DeepSeek 开源后几周,三桶油、国家电网、南方电网、中核、中广核、五大发电集团陆续宣布本地化部署,主要理由是数据不出门。
陈大年的例子更直白:他电脑里两个 T 的照片,不愿意传给 Claude 管,Claude 也不愿意收——Token 费收不了多少,占的带宽和存储却是海量。他另一条理由更扎心:以前平台对你的了解是一句话的画像,现在 AI 知道你大量的细节,被一个极其聪明的大脑每天盘一遍,"对一个人的压力是非常大的"。苹果的路线也是能在设备上处理就在设备上处理,复杂请求才送去它自己的云。
这条规律有时候站在云端那边——CRM、网盘、数据仓库已经在云上的企业,Agent 会去云上找数据,80% 不自动适用于它们。本地化的前提,是工作副本和工具权限已经在本地。
三股力量指向同一个方向。但——
这 80% 不是搬回来的,是长出来的。
今天云端每天处理的任务,假设是 100 项。本地机器不按次收钱、数据不出门,机器就会一直看、一直查、一直问——每小时扫一遍日志,每一封邮件进来先分一次类,每个工单先自己试一遍。这些活过去根本不会调用 AI,因为一次几分钱乘以一天几千次,账算不过来。把它们算进去:云端可能从 100 项涨到 200 项,本地新增 800 项,本地占八成,云端的任务量也翻了一倍。旧任务搬家,只是零头。
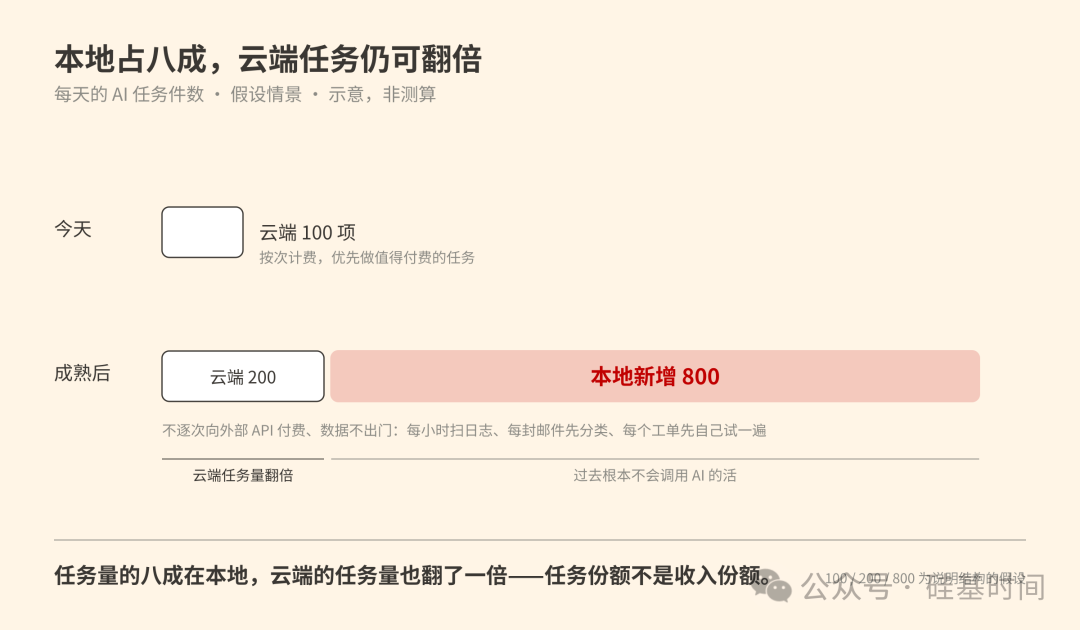
100 / 200 / 800 为说明结构的假设,任务份额不是收入份额。来源:硅基时间制图
04 80% 的判断,可能错在哪里
本地模型变便宜,不意味着它一定比云端划算。开源、量化和专用芯片,云服务商同样能用,还可以把不同客户的需求集中起来,提高设备利用率。真正要比较的,是完成同一项合格任务的总成本,包括设备、运维、人工纠错和云端兜底。AMD 开始用完工时长和单工作流支出衡量性能,也是这个道理。
如果云端在多数日常任务上持续保持明显的成本优势,而本地的数据控制、响应速度等优势不足以抵消差价,我会下调 80% 的判断。另一种情况是:开放模型的能力下放放缓,或者企业难以承担部署、更新和出错后的责任,本地普及就会比我预计的慢。
再说清一个区别:我算的是任务量,不是收入。一项任务,指有独立验收标准的一次业务交付——给一封邮件分类算一项,一次跑 88 小时的前沿研究也算一项;只要用到云端模型推理,就计入云端。两者消耗的算力、创造的价值差得很远,所以本地占八成,云端仍可能拿走很大一部分收入。
所以,这个判断最终要接受真实任务的检验。模型开放给企业增加的是选择权:哪些智能自己生产,哪些向云端购买。下一节要讨论的,就是这种选择权为什么可能成为这一轮产业变化的关键。
05 智能像电,但你可以下载它的生产配方
很多人把大模型比作电。这个比喻说对了需求这一头:电通用、无处不在、按量付费,每个行业都要用;智能也一样,每个行业都会用,而且会越用越多。
但供给这一头,比喻只对一半。电只能在电厂里集中生产,靠电网送到你家,你家里造不出一座电厂,所以电的结局是电网赢了——发电和输电握在少数公司手里,用户手里只有一个插座。大模型公司想要的就是这个结局:它们做电厂,你付电费。但是智能 Token 生产分发却不像电这么简单。
把智能生产拆成三个环节:训练、分发、推理。训练高度集中——万卡集群、持续的巨额投入,这一层像电厂。分发完全不像:发电机不能复制,模型权重是一个文件,Qwen、DeepSeek 的权重开放以后,全世界任何一台机器都可以拿到半年前的前沿能力。推理则可以在任何地方发生——云端、企业内部、桌上那台机器。
已经有人这么干了。法律 AI 公司 Harvey 过去每月十几万亿 Token 全部走 OpenAI、Anthropic 和 Google 的 API;今年 8 月,它从月之暗面开源的 Kimi K3 出发,用一百五十块 GPU、两个月,后训练出自己的法律模型 Tenet,在自建的法律 Agent 评测集上全通过率接近翻倍,官方称推理成本不到闭源旗舰的四分之一。配方下载下来,行业任务写进权重,旗舰 API 只留给最难的那一截。这是行业模型的自主定制,不是笔记本上的本地化:权重在 Harvey 手里,推理跑在哪,它没说。
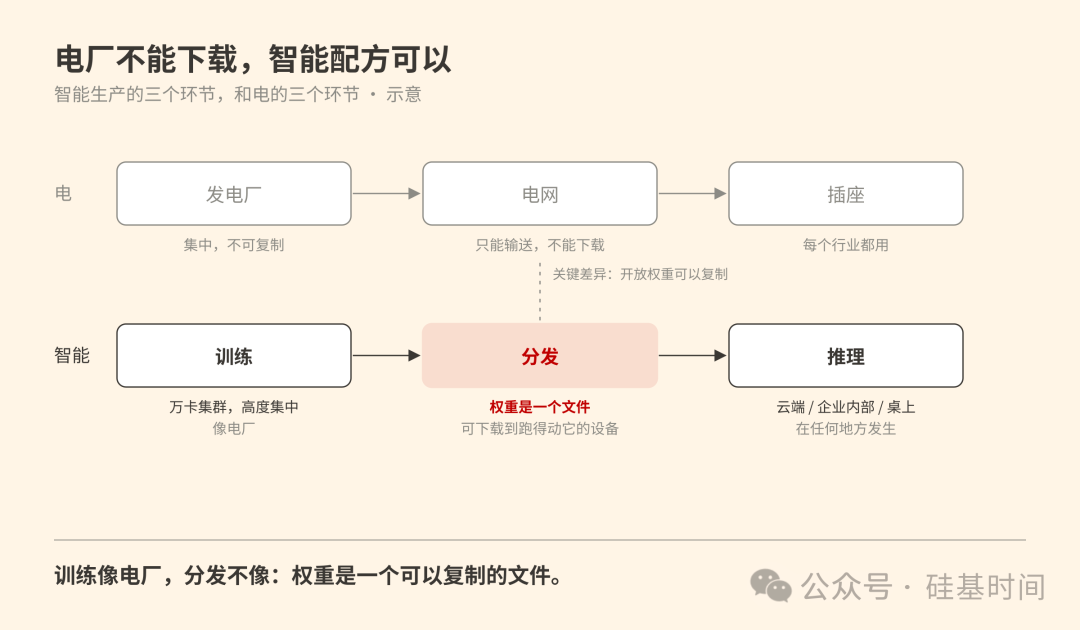
来源:硅基时间制图
你不能把一座电厂下载到公司,但可以把一种智能的生产配方下载到服务器。
开放权重延续了软件可以复制的特点,又让任务能力随文件一起分发:训练可以集中,使用却不必集中——这是智能和电最大的不同。计算在集中和分散之间来回了三次:大型机、PC、云。这次能不能停在分散这边,看生产配方能不能复制。
06 AI 应用的终局:从一句话,到持续交付
应用爆发的标志,是更多人开始买到过去买不起、得不到的服务。 Web 爆发的是网站,移动爆发的是 App,这一轮爆发的是 AI 应用。我判断,下一轮高频应用的爆发,会从企业和行业里的语音办事开始;C 端最大的应用会是娱乐和社交入口,那是另一篇的题目,这里先从企业场景展开。
设想一家工业配件企业。负责人说一句"把缺货补齐",系统就去查库存、对订单、询供应商,在授权范围内安排采购;价格超出预算时找人确认,到货延误时继续跟进。过去要打开几个系统、找几个人的事,现在交代给一个持续工作的助手。
高频服务能不能普及,既看办得好不好,也看长期用不用得起。这类应用每分钟都在花 Token,本地推理把按次付费变成设备投入和运行成本,让更多任务可以经常做、持续做——这叫"Token 自由"。先有 Token 自由,才有应用自由;应用自由,才是这一轮大爆发的起点。
接住需求的,是一层 Agent OS。它承载两种应用:个人的硅基分身,知识库记住资料和偏好,智能体代办事务;企业硅脑,知识库积累业务数据和经验,智能体调度工作、跟进交付。
Agent OS 管身份、记忆、权限和任务,组织不同的智能体协作。日常推理在本地完成,最难的部分调云端模型,再连接线上系统、线下商家和物理设备。
手机可以是入口,个人记忆和企业数据可以留在各自的本地设备上;这里的"本地"指模型推理的位置,调用订货、支付这类在线业务接口,不算调用云端模型。
语音让人更容易交代任务,硅基分身和企业硅脑负责把事情接着办下去。前端是一句话,后端是一整套持续办事的系统。
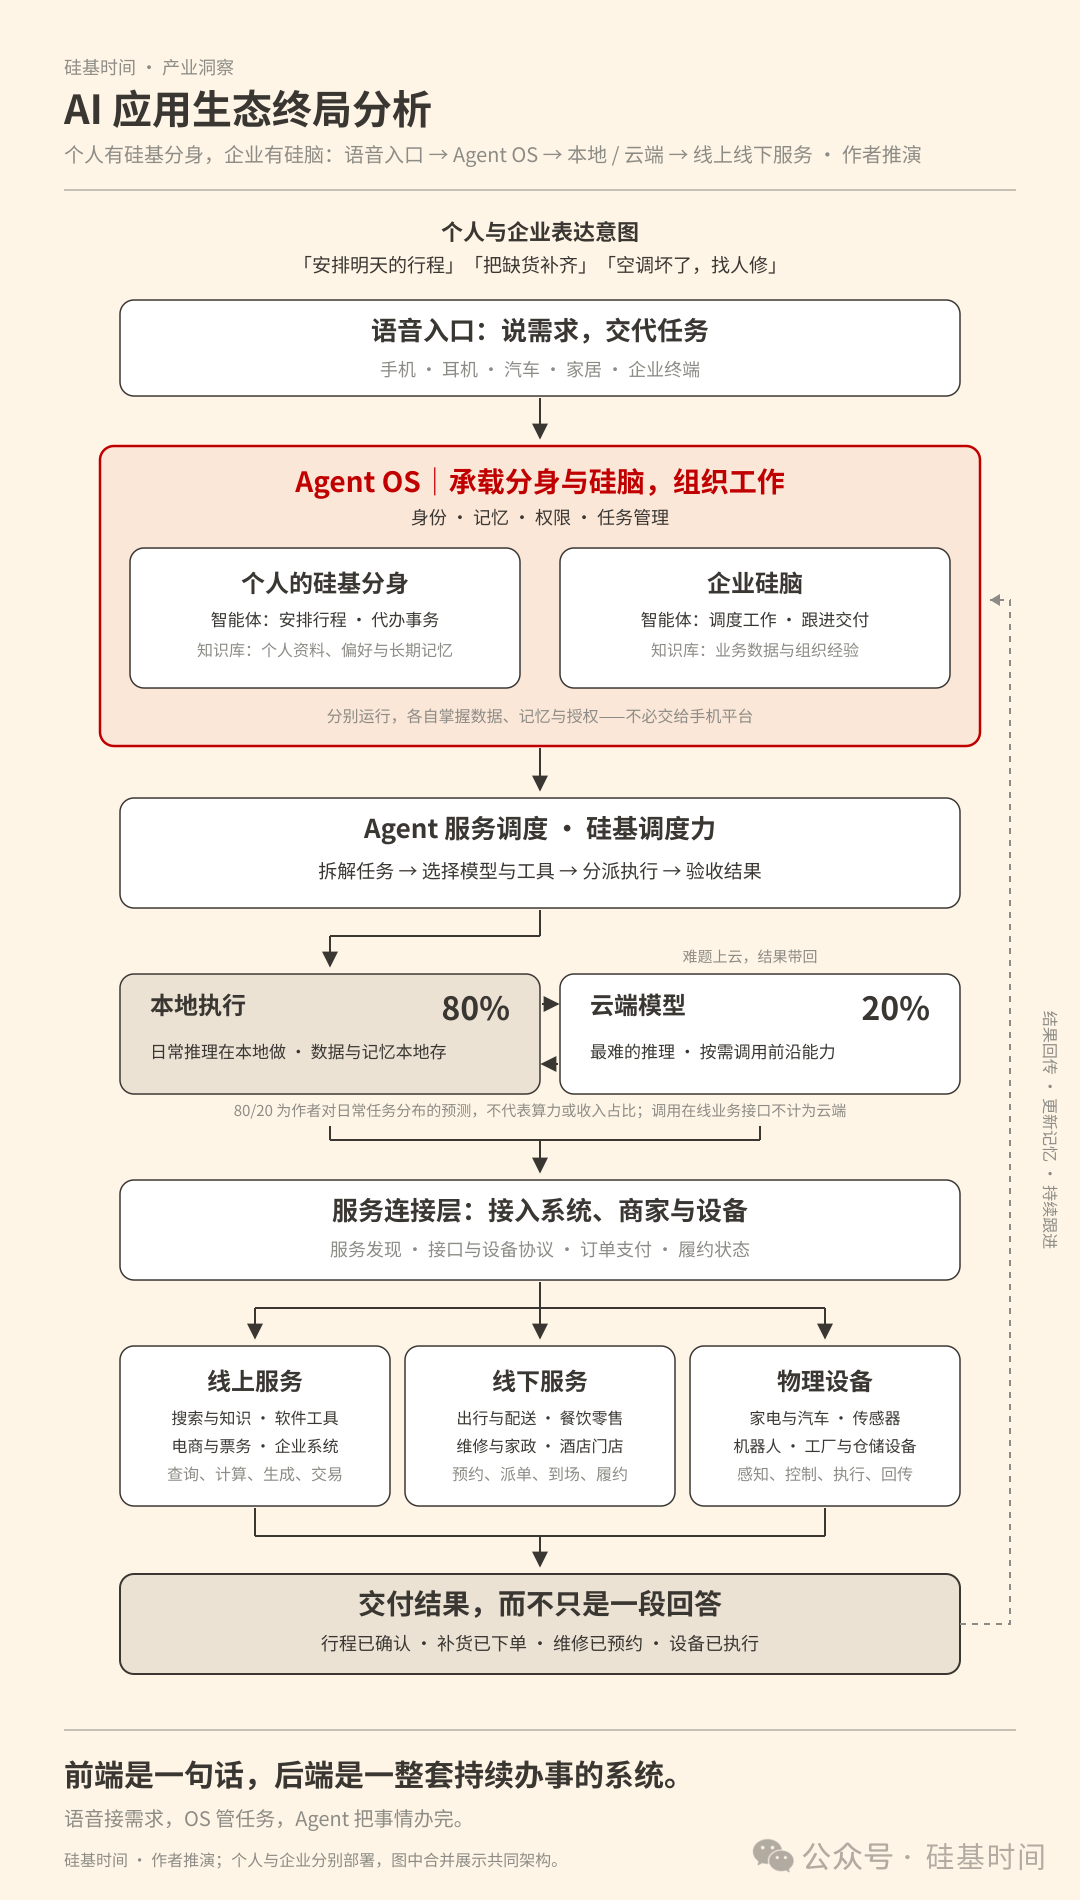
个人分身与企业硅脑分别部署,图中合并展示共同架构;80/20 为作者对模型推理任务分布的预测,不代表算力或收入占比。来源:硅基时间制图
07 谁拿到增量,谁留下利润
要支撑这一轮巨额投入,AI 必须长出大得多的应用市场——按今年 4 月那份估算,应用层现在只有六百亿美元;Anthropic 能不能兑现两万亿的估值预期,至少要获得 1500 亿美元以上收入。这笔收入从哪里来,哪些公司最终获益?我看三类机会:提供智能、掌握入口、交付结果。它们分别对应算力需求、客户关系和应用收入,但增长不一定带来利润。
第一,提供智能:需求会扩大,利润要看竞争。 AMD、英伟达,以及联想、惠普和内存、存储厂商,有机会承接本地推理的采购增量。但模型会变小,设备可以共享,80% 的任务在本地,不等于 80% 的设备需要换新。
模型公司也一样。Anthropic、OpenAI 要靠高难任务和企业服务覆盖研发与推理成本;Qwen、DeepSeek、Kimi 的开放路线,则要把采用量变成托管、定制或应用收入。模型被广泛使用,与公司能持续赚钱,中间还隔着一个商业模式。
第二,掌握入口:算力可以分散,客户关系仍可能集中。 入口是四件事:任务从谁那里进来,谁定"做对了没有"的标准,谁发权限,钱付给谁。模型权重能下载,这四件事下载不来。手机入口的竞争里,Google 和苹果有系统优势,正把 Agent 入口收进系统;微软、Salesforce、ServiceNow 有企业系统的基础;微信、飞书、企业微信、钉钉,也有承接需求的机会。要看用户是否持续把任务交给它们,以及它们能不能因此收费。
Agent 可能减少人工操作和账号,原来的按人头收费就会承压,平台要把客户关系转成持续的服务收入。Token 在哪里生成,不决定利润归谁;谁持续接到任务,谁就更接近收费的位置。
第三,交付结果:创业机会在具体行业,护城河在反复交付。 工业报价、采购对账、订单跟进、设备售后,都是可以切入的付费任务。中国的工厂、仓库和门店,为这类应用提供了最密的现场;创业者可以借行业软件商、设备商的渠道,从一项任务做起,再沿同一批客户扩展,每个行业都可能长出自己的 WorkBuddy——行业专属的工作助手。
判断它是不是一门好生意,只问一句:多服务一家客户,要不要增加同样多的交付人员?每单都要重新开发,规模越大,人力负担越大。线上线下服务同样如此:用户可能绕过平台首页,让 Agent 订酒店、找维修,但客房、师傅、库存和配送仍然需要;美团这样的服务平台和行业供应商能不能留下利润,看它们组织供给、完成履约的能力。
下一个 Google,可能长在接收需求的入口上;下一个 Amazon,可能长在组织供给与履约的网络里。最后一笔账留给投资者:这一轮最大的受益者,可能根本不是 AI 公司。智能变便宜,省下的钱大部分会留在用它的工厂、门店和消费者手里——就像电变便宜的时候,赚到大钱的不是发电厂。
80/20 预测的是智能生产的位置;硅基调度力,决定这些智能能不能成为持续的生意。
◇ ◆ ◇
财经报道:《金融时报》《彭博》《路透》关于 Anthropic IPO 估值预期与二季度财务的报道(2026.08–09);各公司定价页与公开披露。
模型与研究: Anthropic Claude Opus 4.6 / 4.8 系统卡与 Series G 公告;Qwen3.8-27B 官方模型卡(2026.08.14);Minima NVFP4 量化报告(2026.09);METR arXiv 2503.14499;Apoorv Agrawal《The Economics of Generative AI: Two Years Later》(2026.04);Kenney 等 PC 价值链研究(UC Davis)。
产业资料: AMD 锐龙 AI Max 媒体见面会材料(2026.09.10,北京);英伟达 GTC Taipei 2026;Harvey / Fireworks 关于 Tenet 的公告(2026.08);陈大年"我对于 AI 时代的八条非共识"(创新少年派整理);作者《Agent 入口保卫战》《Agent 入口战的中国变量》(2026.06)。80/20 为作者判断,无外部统计;分数均为厂商自报,测试条件不同,看趋势不看小数。
 发表于 3 天前
|
查看: 13|
回复: 0


