OpenAI 史上最快的模型,死了。
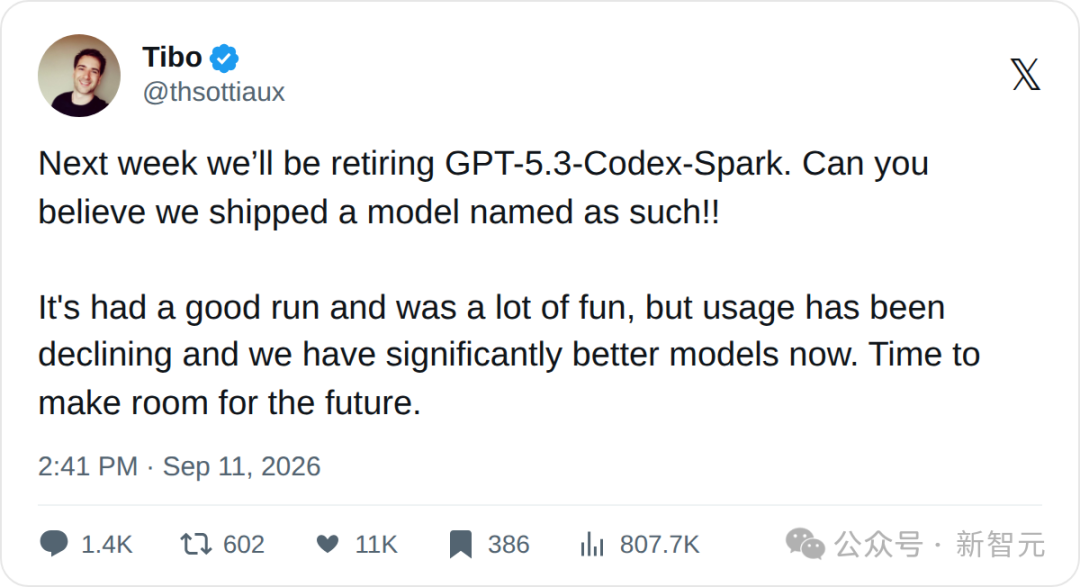
Codex 负责人 Tibo 发帖,GPT-5.3-Codex-Spark,下周退役。
每秒 1200 个 Token、OpenAI 第一个逃离英伟达的模型、750 兆瓦 Cerebras 大单的头一份交付,从发布到下线,只活了 7 个月。
Tibo 给的理由很简单,用量一直在往下掉,手上也已经有明显更好的模型了。「是时候给未来腾地方了。」
然后,他又在底下补了一刀,「真不敢相信,我们居然发布过名字这么长的模型!!」
告别式上,大家只关心「备用额度」
Spark 走得很安静,甚至显得有些尴尬。
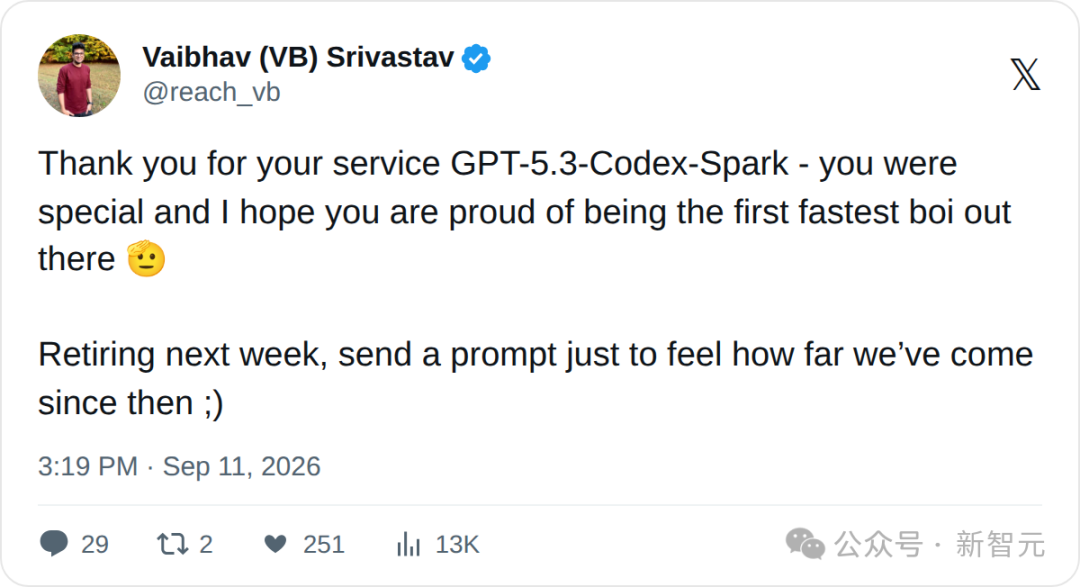
Hugging Face 的 Vaibhav Srivastav 试图在评论区留下一点温情。
感谢服役,你很特别,希望你为自己是第一个「最快的小子」而骄傲。下周退役前,发条 prompt 吧,感受一下我们从那时到现在走了多远。
紧随其后的热评,画风立刻变得犀利起来。
所以它到底是干嘛用的?前两天我还在跟同事讨论这个问题。
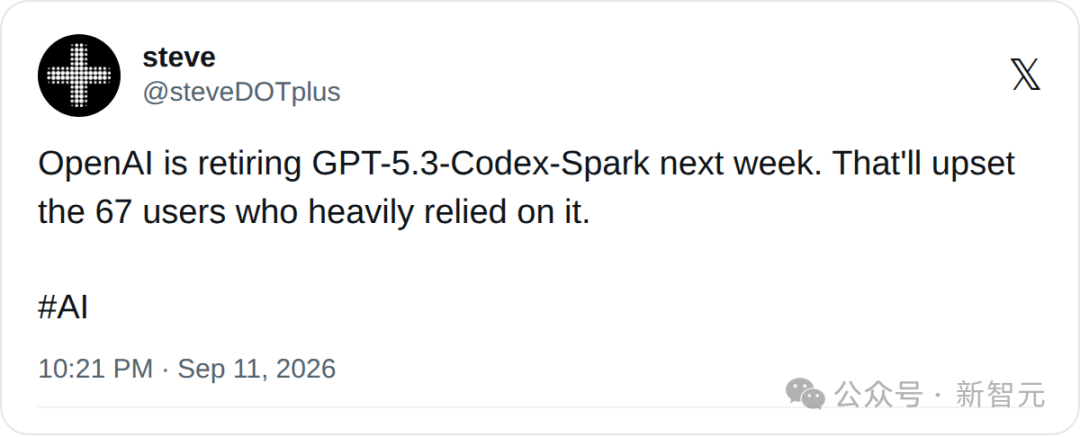
OpenAI 要退役 Codex-Spark 了,那仅存的 67 个重度用户该伤心了。
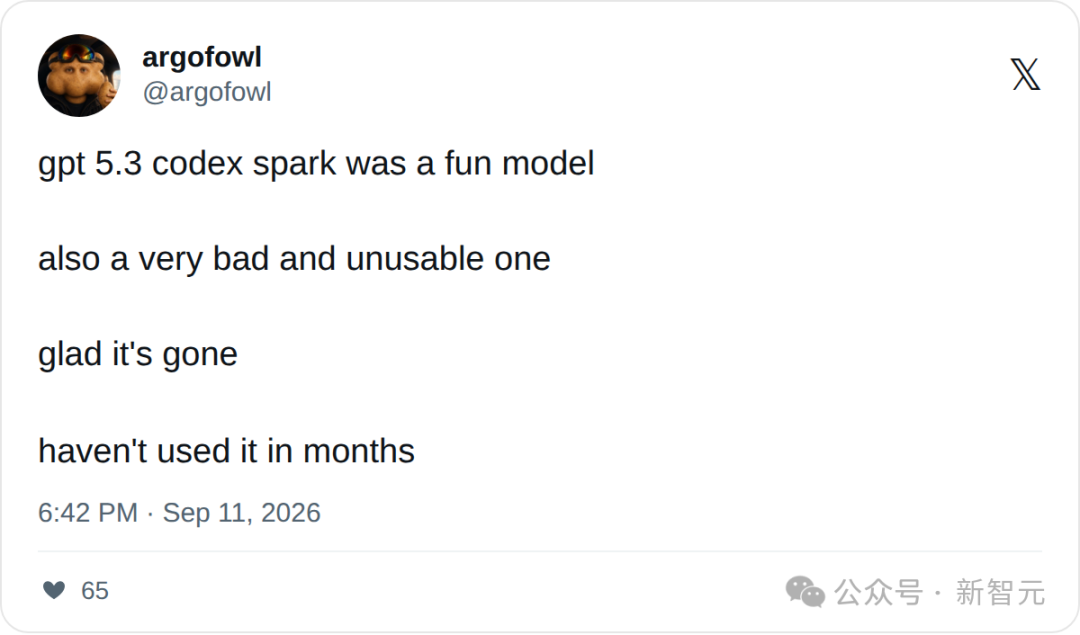
更致命的评价来自开发者 argofowl,「Spark 是个好玩的模型,也是个极度糟糕、根本没法用的模型。很高兴它走了,我好几个月没碰过了。」
还有开发者表示,几个规模不小的项目里,他几乎没用过 Spark,连理解项目上下文、分析日志这种基础任务,都会迅速把上下文窗口塞满,逼着他另开一个对话。
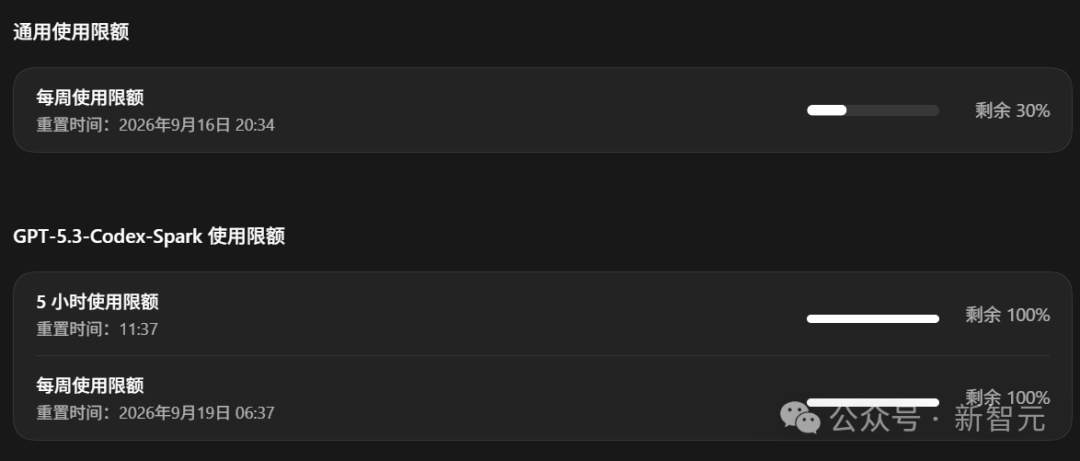
事实上,真正对 Spark 退役感到一丝惋惜的,惋惜的也并非模型本身,而是它附带的独立配额。
知名开发者 Chubby 坦言想要一个「GPT-6-Spark」,因为 Spark 拥有一份不占主额度的独立套餐。
在 Astra 额度极其紧张的当下,很多开发者是把 Spark 当作主额度耗尽后的「备用油箱」来顶一阵子。
7 个月前的「未来」,败给了「降智提速」
把时间拨回今年 2 月 12 日,Spark 上线那天的排场可谓盛大。
这是 OpenAI 第一个专为实时编程设计的模型,128k 上下文,每秒生成超过 1000 个 Token。
按官方给的数字,客户端和服务器之间的往返开销降了 80%,每个 Token 的处理开销降了 30%,首 Token 延迟砍掉一半。
代码不再一行一行往外蹦,整块整块地倾泻在屏幕上。
最早一批上手的开发者,反应也是真的兴奋。
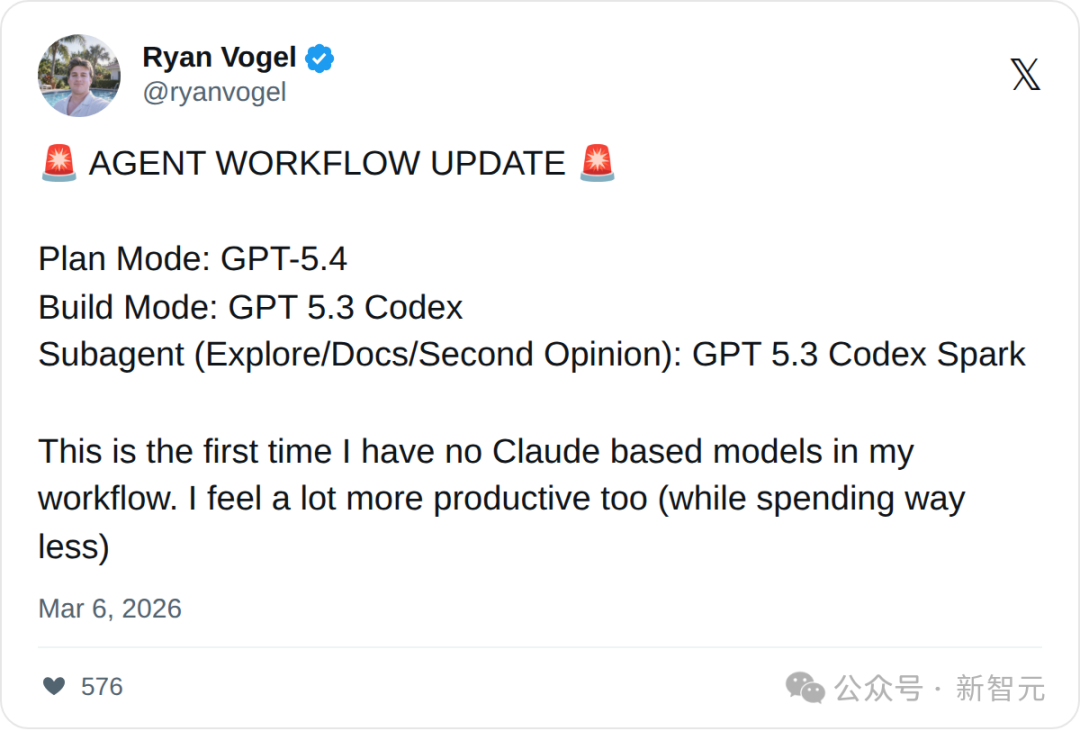
开发者 Ryan Vogel 直接把它编进了正式工作流,GPT-5.4 负责规划,GPT-5.3-Codex 负责构建,Spark 负责探索代码库、查文档、给第二意见。
他说这是自己第一次工作流里一个 Claude 模型都没有,「效率更高,花得更少」。
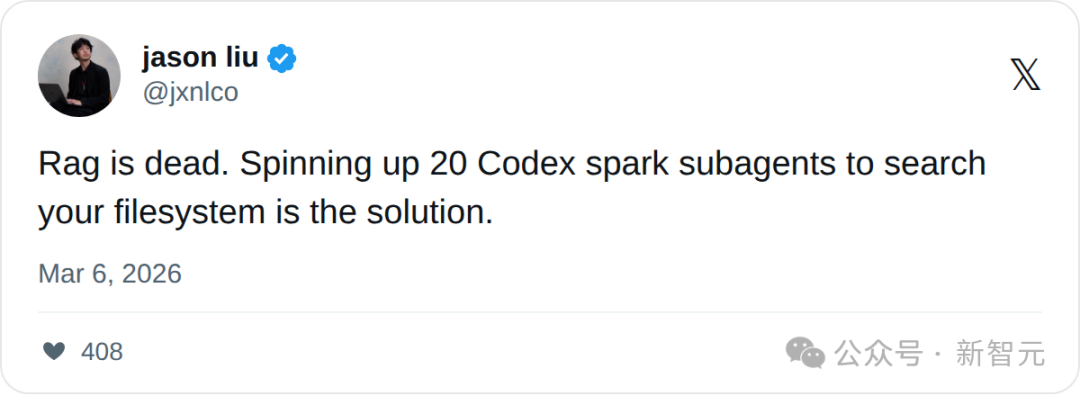
Instructor 作者 Jason Liu,直接开 20 个 Spark 子代理去搜文件系统,宣布「RAG 已死」。
然后,他就在不久之后加入了 OpenAI 的 Codex 团队。
更关键的是,Spark 承载着 OpenAI 摆脱单一硬件依赖的野心。
它是 OpenAI 第一个跑在英伟达技术栈之外的生产模型,底层算力来自初创公司 Cerebras 的晶圆级芯片 WSE-3。
它标志着 OpenAI 与 Cerebras 签下的那份 750 兆瓦、总价值超 200 亿美元算力大单,交出了第一份答卷。
但热度退得比涨得还要快。
Spark 的致命伤在于,一块晶圆装不下旗舰模型,它本质上是一个为了极致速度而妥协的「蒸馏版小模型」。
在 Terminal-Bench 2.0 评测中,Spark 仅获得 58.4% 的准确率,远低于完整版 GPT-5.3-Codex 的 77.3%。
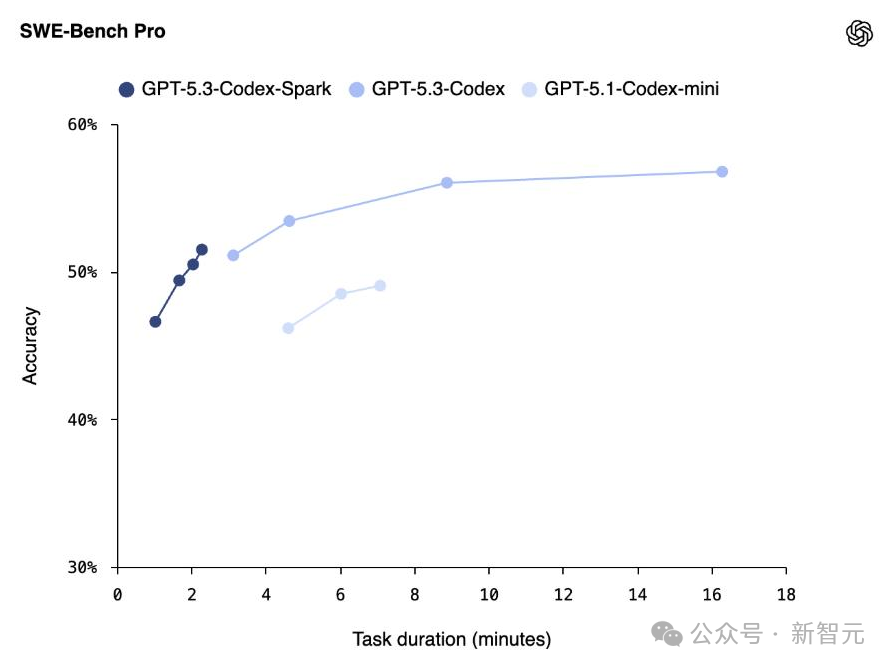
OpenAI 自己放出的 SWE-Bench Pro 曲线也显示——Spark 虽然能把任务时长压在 1 到 2 分钟,但准确率会停在 47% 到 51% 之间。相比之下,完整版 GPT-5.3-Codex 从 3 分钟起步就是 51%,拉到 9 分钟是 56%,16 分钟能到 57%。Spark 省下的那几分钟,换来的是往下掉五六个点。
宣传中的「15 倍提速」也被拆穿了。
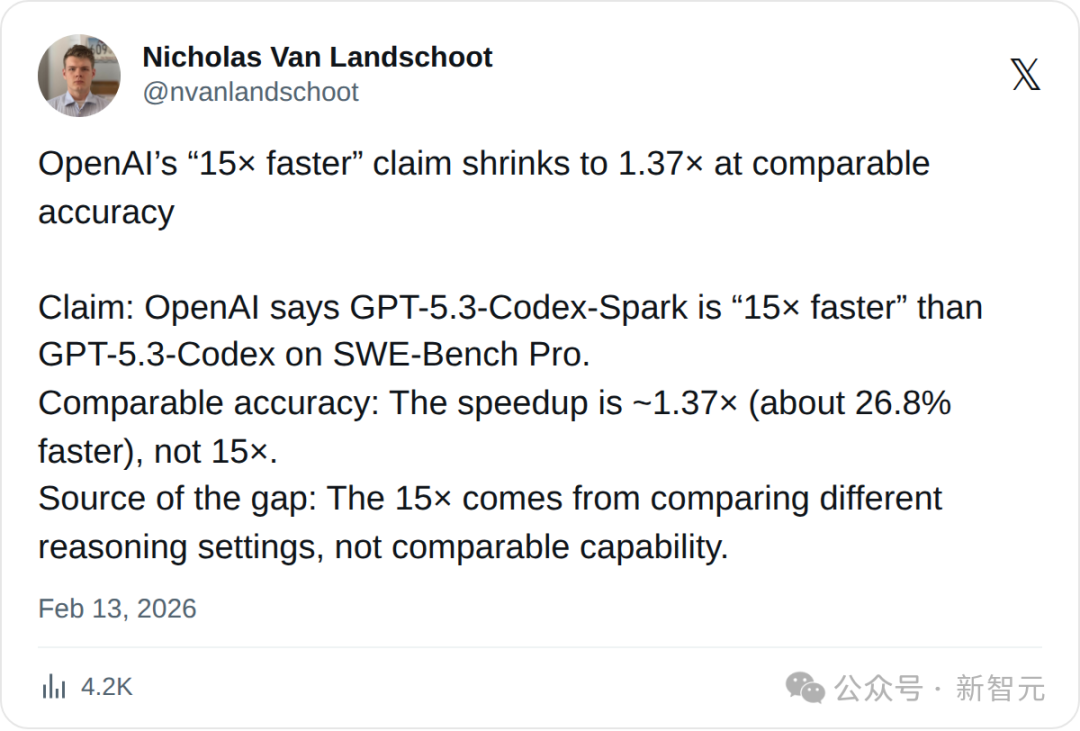
发布第二天,开发者 Nicholas Van Landschoot 就在 X 上发了篇长文,把 OpenAI 的对比条件扒了一遍,所谓 15 倍,是拿 Spark 去比开了最高推理强度的 GPT-5.3-Codex。在同等准确率下,Spark 其实只快了 1.37 倍。
在实际编码场景中,它的缺陷被无限放大,凭空捏造 API 端点,JSON 格式不稳定,多步任务极易跑偏。
培训机构 Turing College 对它的总结一针见血,「没有智能的速度,只是更快地失败。」
对于程序员而言,花 17 分钟等一个能跑通的代码,永远比花 2 分钟拿一个全是 Bug 的废品要划算。
于是,这款主打速度的模型,注定走向边缘化。
旗舰本尊下场,Ultrafast 终结了 Spark
而真正给 Spark 宣判死刑的,是 8 月 13 日 Cerebras 发布的 Ultrafast 模式。
这一次,跑在晶圆上的不再是缩水版的 Spark,而是旗舰模型 GPT-5.6 Sol 本尊。
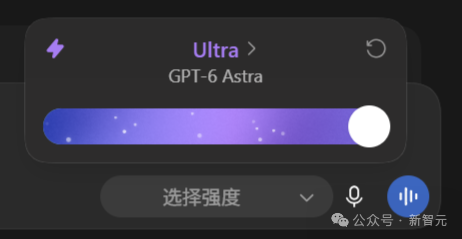
通过将庞大的旗舰模型按层切分,铺设在多台 CS-3 节点上形成流水线,Ultrafast 模式在保证「与标准版同等智能」的前提下,飙出了每秒 750 个 Token 的恐怖速度。
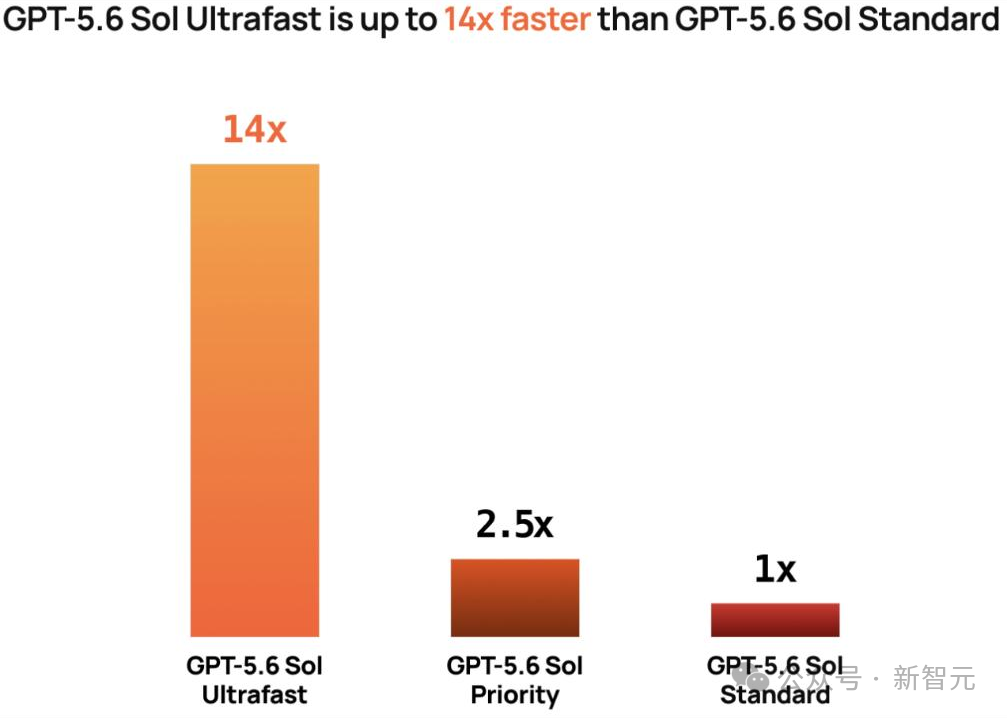
Cerebras 给的对比是,Ultrafast 比标准档快 14 倍,中间还有一档 Priority,只快 2.5 倍。
Cerebras CEO Andrew Feldman 对此的评价掷地有声,「速度与智能,不再互斥。」
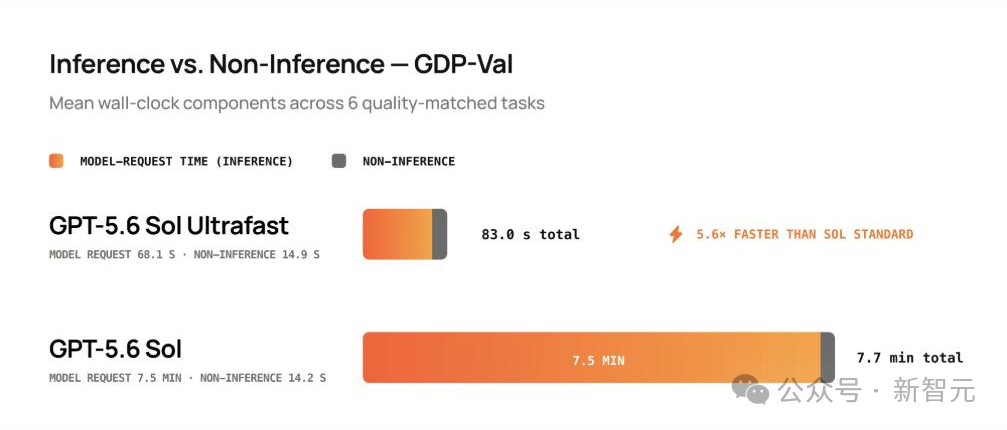
他们拿 GDP-Val 里 6 个质量对齐的任务做了一组耗时对比。标准档 Sol 平均要跑 7.7 分钟,其中 7.5 分钟花在模型生成上。换到 Ultrafast,同样的任务总共 83 秒,模型生成 68 秒,剩下的 15 秒是工具调用之类的非推理开销。端到端快了整整 5.6 倍,而且回答的质量也几乎没有差别。
这句话不仅宣告了技术突破,也直接抽干了 Spark 存在的全部意义。
Spark 的设计初衷就是「拿智能换速度」,而仅仅半年后,同一家公司的晶圆上已经能跑完整的旗舰模型,速度只慢了四分之一,能力却一分没少。
Cerebras 的产能是有限的。当无人问津的「缩小版」和排队疯抢的「旗舰版」挤在同一批晶圆上时,谁该为未来腾地方,答案不言而喻。
速度不再是「专属模型」,而是「付费档位」
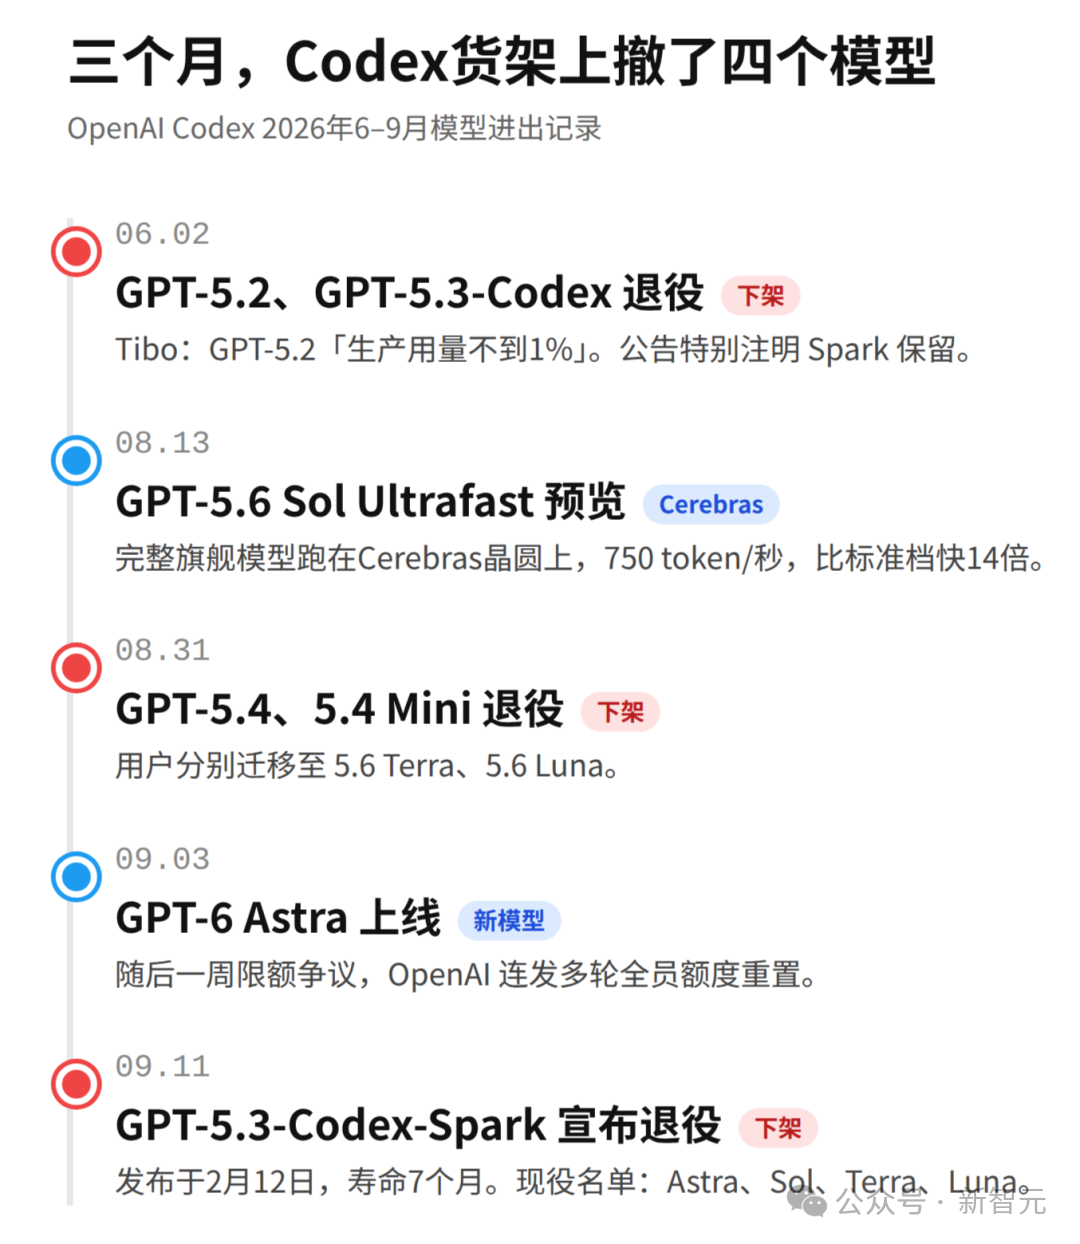
Spark 并非唯一被清理的历史包袱。过去三个月里,OpenAI 的模型库正在经历一场激进的「大换血」。
- 6 月 2 日,GPT-5.2 与 GPT-5.3-Codex 退役。
- 8 月 31 日,GPT-5.4 与 5.4 Mini 退役,用户整体迁移至 5.6 世代。
- 9 月 11 日,轮到 GPT-5.3-Codex-Spark。
伴随着旧世代的离场,Codex 迎来了 Sol(太阳)、Terra(大地)、Luna(月亮)、Astra(星辰)的全新命名纪元。「GPT-5.3-Codex-Spark」这种带有冗长版本号和产品线后缀的名字,确实已经像上一个时代的遗迹。
更深层的逻辑更迭在于,「快」这一属性,正在从一个独立的专用模型,演变为旗舰模型的一项标配「档位」。就像推理强度分为 Light 到 Max 一样,OpenAI 现在的速度也从 Standard、Priority 排到了 Ultrafast。速度与算力挂钩,按档付费的商业模式已经彻底跑通。
回头再看,Spark 完美地完成了它的历史使命。它作为一个过渡期的探路者,证明了 Cerebras 的晶圆足以扛住生成式 AI 的生产级流量,也证明了推理任务完全可以脱离英伟达的生态运行。当探路结束,大部队正式入驻,探路者的使命也就自然终结了。
「拿智能换速度」的歧途在今天被正式封死。随着各大平台开始竞逐底层硬件的极致利用率,下一轮的军备竞赛规则已经彻底改写。接下来要比的不再是谁能做出最快的阉割版模型,而是谁能把最强的旗舰模型,跑出最极限的速度。
参考资料:
https://x.com/thsottiaux/status/2098300998968357218
 发表于 7 天前
|
查看: 0|
回复: 0


