同样是一张表,有时要看谁贡献最多,有时要看变化发生在哪儿,有时还要判断:这个差异到底是业务变化,还是数据口径出了问题?
如果每次都从"找个好看的图"开始,往往改了半天颜色,最后还是说不清问题。
蓝星宇的《数据可视化设计指南:从数据到新知》(电子工业出版社,2023年)介绍了常见图表的选择、设计方法与实际应用,适合想把数据表达清楚的读者。这篇文章参考书中的思路,整理 50个案例,用 Python 完整实现,数据、代码和效果图都重新制作。
本文全部数据均为模拟数据。 收入、用户、价格、评分、环境读数和文本频次都不对应真实个人、机构或市场;模拟是为了让规律可控、计算可查,不能拿这些结果当作现实结论。
你可以把它当作一份按问题查找的长指南:先看要解决的事,再选图,最后改代码。每个案例都包含数据说明、实际效果、实现代码、读图结果和注意事项。50个案例不等于50种互不重叠的图表类型,同一种图形会在不同分析问题中承担不同任务。
一、先选工具,再把运行方式统一
这次使用哪些库
| 工具 |
在本文中的职责 |
适合的情况 |
| Matplotlib |
坐标、几何图元、注释与静态导出 |
需要细致控制版式和编码 |
| Seaborn |
分布、统计关系与矩阵图 |
希望用较少代码完成统计探索 |
| Plotly |
平行坐标、漏斗、蜡烛、曲面、气泡、旭日、桑基 |
需要悬浮提示、筛选、旋转或层级交互 |
| NetworkX |
树和网络结构、布局与中心性 |
先建模关系,再交给 Matplotlib 绘制 |
| squarify / wordcloud |
矩形布局 / 中文词云 |
处理专门图形的排布问题 |
| NumPy / pandas / SciPy |
模拟、整理、汇总与统计计算 |
为图提供可检查的数据和指标 |
不要把工具职责混起来:NetworkX 主要处理图结构,Kaleido 负责 Plotly 的静态导出,pandas 负责数据整理,它们并不都属于同一类绘图库。
本次实际运行环境锁定在资料包的 requirements_v1.0.0.txt 中。Matplotlib、Seaborn 和 Plotly 分别为 3.11.2、0.13.2、7.0.0,资料核对日期为 2026 年 9 月 13 日。锁定版本是为了复现本次结果,不代表读者必须一直使用这个版本。
库的用法依据官方资料:Matplotlib 示例库、Seaborn 接口、NetworkX 绘图说明。
下载后如何运行
配套资料地址: https://github.com/dxawdc/caige-wechat-articles/tree/main/articles/2026-09-13-python-visualization-50/v1.0.2
ZIP 下载: https://github.com/dxawdc/caige-wechat-articles/raw/refs/heads/main/downloads/python-visualization-50_v1.0.2.zip
文章中外链不便点击时,可以复制上面的完整地址到浏览器。资料包有 50 份独立案例脚本、模拟 CSV、PNG、SVG、指标记录和离线图表索引;7 个 Plotly 案例另外提供交互 HTML。源码与物料独立于本文保存。
在解压后的资料目录打开终端,Windows 使用:
python -m venv .venv
.venv\Scripts\python -m pip install -r requirements_v1.0.0.txt
.venv\Scripts\python run_all_v1_0_2.py
macOS/Linux 使用 .venv/bin/python 替换上述 Python 路径。只运行某个案例时,例如 03 和 45:
python run_all_v1_0_2.py 3 45
也可以直接运行 python cases/case_03_v1_0_2.py。本文代码与对应脚本一致,都依赖同目录的 common_v1_0_2.py,它负责公共导入、中文字体、统一样式和输出文件。公共模块完整代码放在文末附录,也已经包含在资料包里。
中文图表需要系统安装微软雅黑、思源黑体/Noto Sans CJK SC、黑体或苹方之一。资料包不携带商业字体。Plotly 导出 PNG/SVG 使用 Kaleido,并需要可用的 Chrome;可用 BROWSER_PATH 指向本机 Chrome。Plotly 静态导出文档说明了该依赖。
先明确四个规则
1、一行是什么。
用户、订单、日均值、关系边和文本词元不能混用一个计数口径。
2、分母是什么。
本月总量、初始用户、当前阶段人数,是不同的分母。
3、视觉通道是什么。
长度、面积、颜色、位置各自承担一个清楚的含义。
4、模拟能说明什么。
图形和计算可以复现,现实结论仍需要真实数据与合适的研究设计。
下面每例保留独立随机种子,运行顺序不会改变数据。确定性示例直接给出小表,带随机性的例子则明确分布与参数。输出 CSV 可用 Excel 查看,SVG 便于放大,交互 HTML 需要与同目录 plotly.min.js 一起保留。
二、50个案例,按分析问题查找
比较贡献与差异 · 01—10
01|排序条形图:先找出贡献最大的渠道
工具:Matplotlib。
渠道报表里有六个来源,我们先回答最直接的问题:谁贡献的已支付订单最多?数据是一行一个渠道,订单口径一致,既不混进访问量,也不把退款单重复计算。
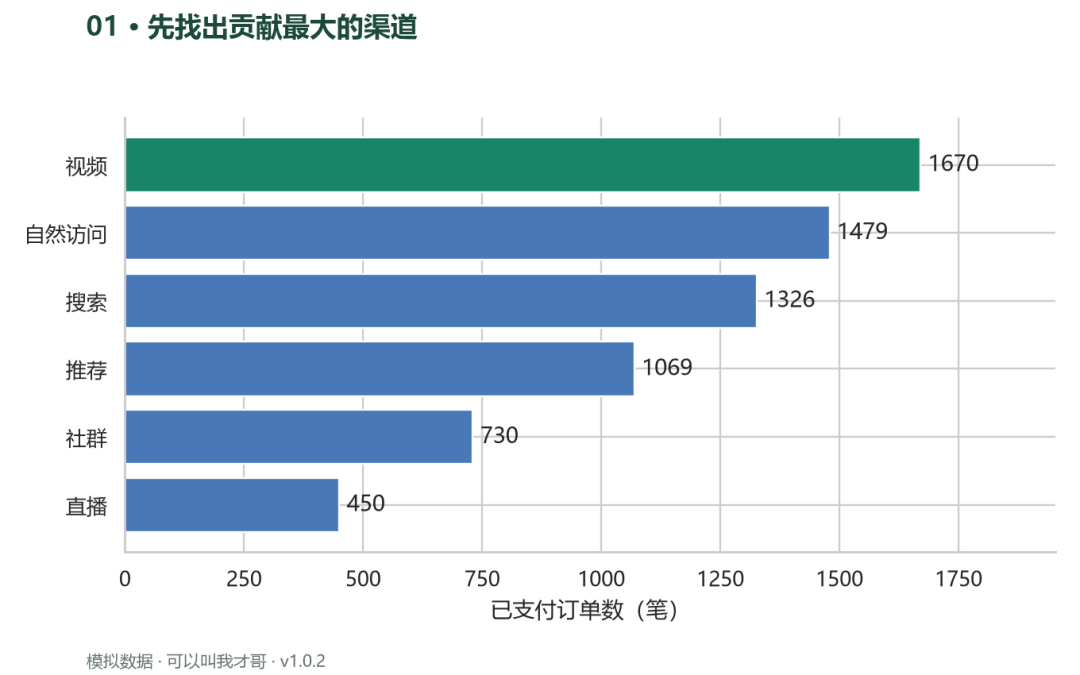
看图结果: 视频渠道以 1670 笔排在第一,直播为 450 笔。这个例子先呈现贡献量,尚未比较获客成本。
实现思路: 先按订单数升序排列,再调用 barh,最大值自然落在最上方。这里只强调第一名,其他渠道使用同一颜色,读者不用先认六种颜色再比较长短。bar_label 把具体数量补在右边,图和表的优势就结合起来了。
"""案例 01:先找出贡献最大的渠道 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(1, "")
df = pd.DataFrame(
    {
        "渠道": [
            "搜索",
            "社群",
            "视频",
            "推荐",
            "直播",
            "自然访问",
        ],
        "订单数": rng.integers(450, 1800, 6),
    }
).sort_values("订单数")
bars = ax.barh(
    df.渠道, df.订单数, color=[COLORS[1]] * 5 + [COLORS[0]]
)
ax.bar_label(bars, padding=4)
ax.set(
    xlabel="已支付订单数(笔)",
    xlim=(0, df.订单数.max() * 1.17),
)
finish(
    1,
    "先找出贡献最大的渠道",
    fig,
    df,
    {
        "最大渠道": df.iloc[-1].渠道,
        "订单总数": int(df.订单数.sum()),
    },
)
别忽略: 条形长度表示绝对数量,因此横轴从零开始。这个排名只能说明订单贡献,不能直接证明投放效率;要评估效率,还需要各渠道成本、客单价和转化口径。
02|分组柱状图:计划和实际,必须并排看
工具:Matplotlib。
假设四个团队各有计划交付量和实际交付量。我们关心的是每个团队完成了多少,以及实际是否达到计划,所以让两根柱子并排站在一起。
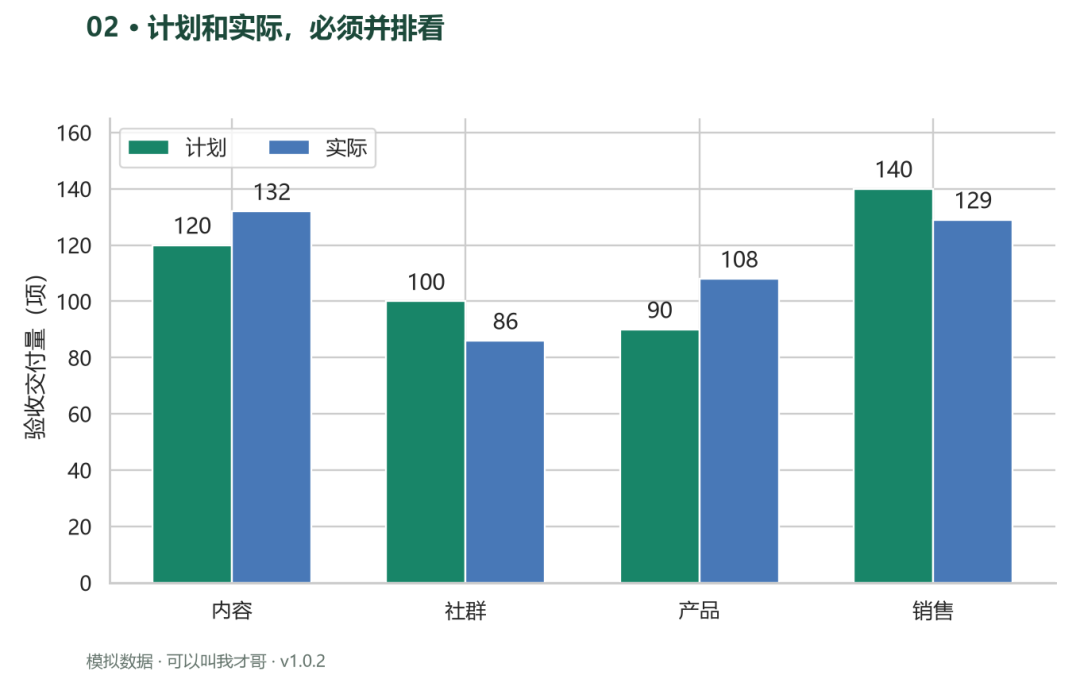
看图结果: 内容完成 132/120=110%,产品完成 108/90=120%;销售虽然绝对交付量较大,仍未达到 140 项计划。
实现思路: x 是团队位置,width 是柱宽,两个系列分别向左右偏移半个柱宽。这样每根柱子都从零开始,可以直接比较同一团队的计划和实际。颜色表示系列,不表示不同团队。
"""案例 02:计划和实际,必须并排看 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(2, "")
df = pd.DataFrame(
    {
        "团队": ["内容", "社群", "产品", "销售"],
        "计划": [120, 100, 90, 140],
        "实际": [132, 86, 108, 129],
    }
)
x = np.arange(len(df))
width = 0.34
for i, col in enumerate(["计划", "实际"]):
    bars = ax.bar(
        x + (i - 0.5) * width, df[col], width, label=col
    )
    ax.bar_label(bars, padding=3)
ax.set(
    xticks=x,
    xticklabels=df.团队,
    ylabel="验收交付量(项)",
    ylim=(0, 165),
)
ax.legend(ncol=2)
finish(
    2,
    "计划和实际,必须并排看",
    fig,
    df,
    {
        "完成率": dict(
            zip(df.团队, (df.实际 / df.计划).round(3))
        )
    },
)
别忽略: 这里不能把计划与实际堆叠,因为它们不是可以相加的两份业务量。原始表同时保留两列,完成率用实际除以计划另算,别把超额完成写成新增贡献。
03|堆叠柱状图:收入总量由谁贡献
工具:Matplotlib。
订阅、课程和咨询共同构成季度收入。此时我们既要看季度总收入,也想知道总量由哪些业务组成,堆叠柱状图就比较合适。
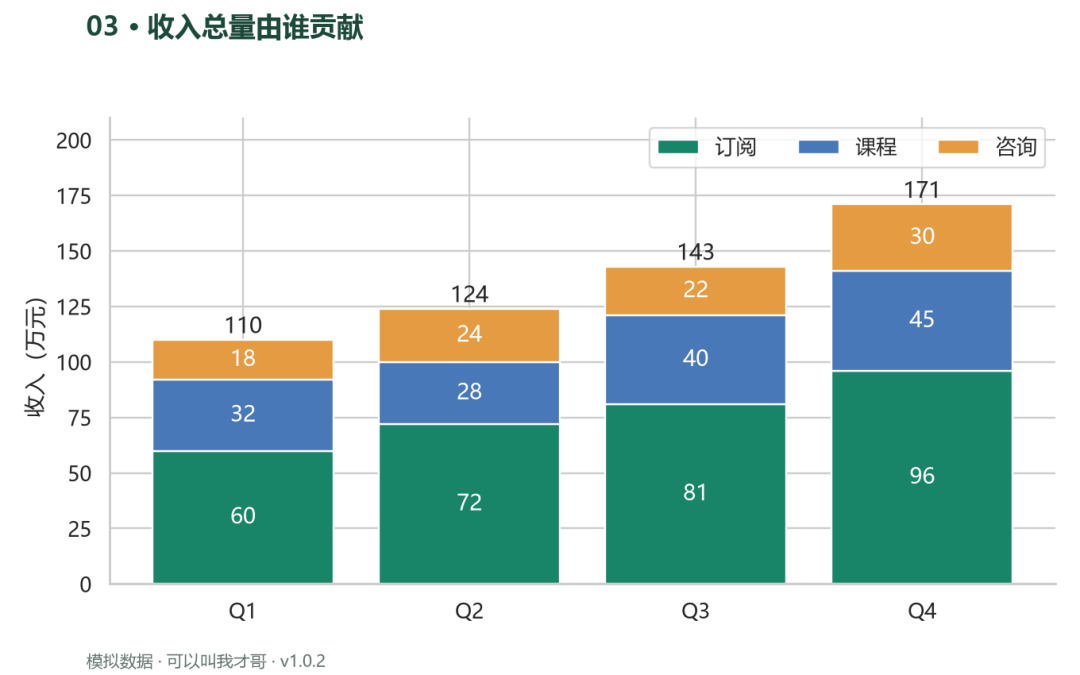
看图结果: 季度总收入依次为 110、124、143、171 万元。Q4 比 Q1 多 61 万元,其中订阅增加 36 万元。
实现思路: 关键不是连续调用三次 bar,而是让 bottom 随着已绘制的系列累加。代码会核对每个季度的最终高度是否等于三项收入之和,并在内部标分项、顶部标合计。
"""案例 03:收入总量由谁贡献 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(3, "")
df = pd.DataFrame(
    {
        "季度": ["Q1", "Q2", "Q3", "Q4"],
        "订阅": [60, 72, 81, 96],
        "课程": [32, 28, 40, 45],
        "咨询": [18, 24, 22, 30],
    }
)
bottom = np.zeros(len(df))
for col in ["订阅", "课程", "咨询"]:
    bars = ax.bar(df.季度, df[col], bottom=bottom, label=col)
    ax.bar_label(bars, label_type="center", color="white")
    bottom += df[col].to_numpy()
assert np.array_equal(bottom, df.iloc[:, 1:].sum(axis=1))
for x, total in enumerate(bottom):
    ax.text(x, total + 3, f"{total:g}", ha="center")
ax.set(ylabel="收入(万元)", ylim=(0, 210))
ax.legend(ncol=3)
finish(
    3,
    "收入总量由谁贡献",
    fig,
    df,
    {"季度合计": bottom.tolist()},
)
别忽略: 堆叠之后,除最底层外,各业务没有共同起点,细微差距不容易判断。需要精确比较咨询收入的季度变化时,应补一张折线图,不能只凭上层色块的位置判断增长。
04|哑铃图:一次改版,谁的等待时间下降最多
工具:Matplotlib。
一次流程改版涉及注册、审核、结算、退款和导出。这里用模拟的改版前后平均等待时间,观察哪条流程缩短最多,而不是把两张独立排名表来回对照。
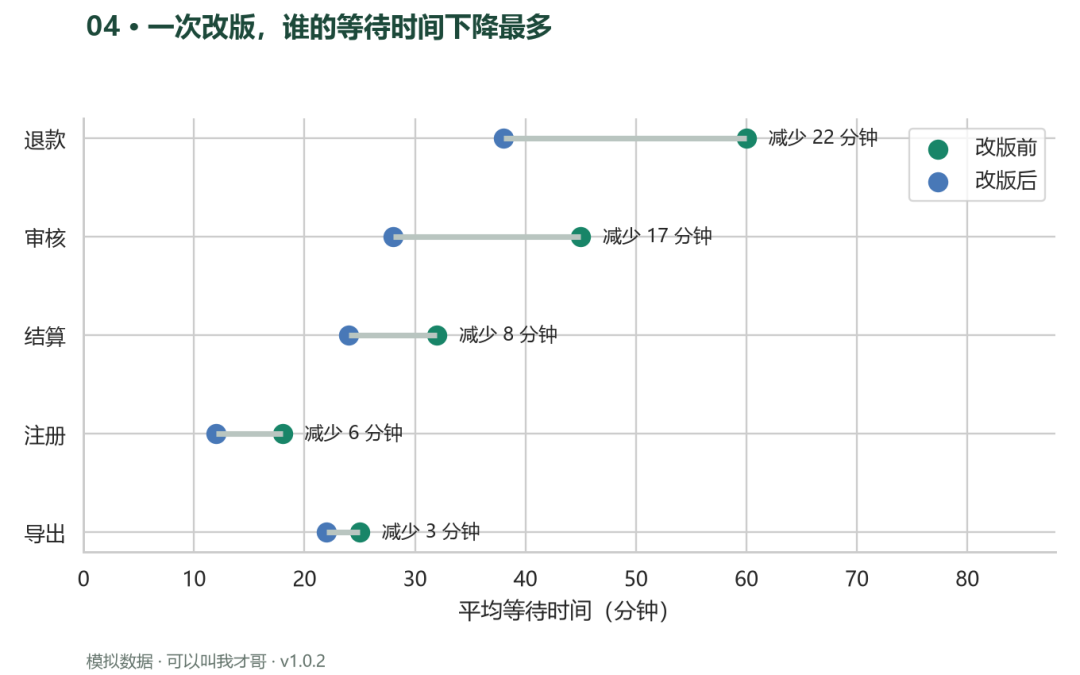
看图结果: 退款等待从 60 分钟降到 38 分钟,减少 22 分钟,是五条流程中变化最大的一条。
实现思路: 水平线连接同一流程的两个观测,两个端点分别代表改版前和改版后。按减少分钟数排序,可以把改善幅度这个问题直接放进视觉顺序里,右侧文字补足具体差值。
"""案例 04:一次改版,谁的等待时间下降最多 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(4, "")
df = pd.DataFrame(
    {
        "流程": ["注册", "审核", "结算", "退款", "导出"],
        "改版前": [18, 45, 32, 60, 25],
        "改版后": [12, 28, 24, 38, 22],
    }
)
df["减少分钟"] = df.改版前 - df.改版后
df = df.sort_values("减少分钟")
y = np.arange(len(df))
ax.hlines(y, df.改版后, df.改版前, color="#B9C5C0", linewidth=3)
ax.scatter(df.改版前, y, s=95, label="改版前")
ax.scatter(df.改版后, y, s=95, label="改版后")
for i, row in enumerate(df.itertuples()):
    ax.text(
        row.改版前 + 2,
        i,
        f"减少 {row.减少分钟} 分钟",
        va="center",
        fontsize=10,
    )
ax.set(
    yticks=y,
    yticklabels=df.流程,
    xlabel="平均等待时间(分钟)",
    xlim=(0, 88),
)
ax.legend()
finish(4, "一次改版,谁的等待时间下降最多", fig, df)
别忽略: 两端数据应来自可比时间窗口,平均值还可能受到用户结构变化影响。此图展示前后差异,不证明差异全部来自改版;真实评估最好同时记录样本数和请求分位数。
05|斜率图:两个月之间,渠道排名如何互换
工具:Matplotlib。
只比较一月和六月的渠道收入时,六个月的完整折线并不是必需的。斜率图保留两个时点,既能看方向,也能看渠道之间是否发生交叉。
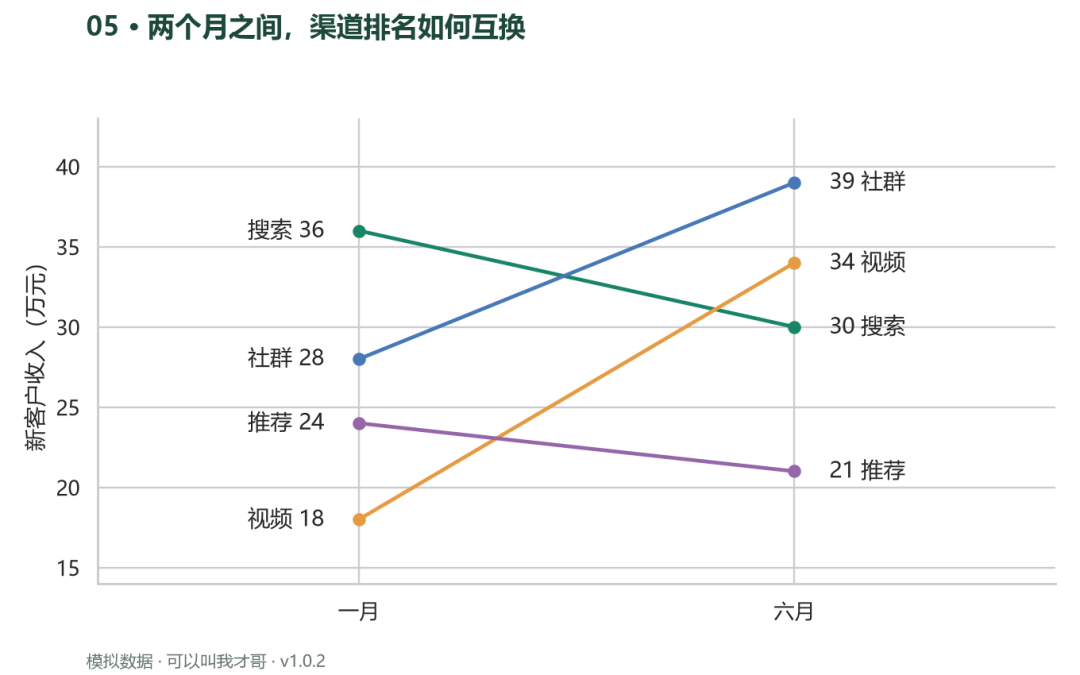
看图结果: 社群从 28 万元升至 39 万元,超过原先 36 万元的搜索;视频也从 18 万元升至 34 万元。
实现思路: 每个渠道只有两个端点,直接把名称和值写在两端,省去读者寻找图例的过程。社群和视频的上升线,与搜索的下降线形成了明显对比。
"""案例 05:两个月之间,渠道排名如何互换 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(5, "")
df = pd.DataFrame(
    {
        "渠道": ["搜索", "社群", "视频", "推荐"],
        "一月": [36, 28, 18, 24],
        "六月": [30, 39, 34, 21],
    }
)
for i, row in enumerate(df.itertuples()):
    ax.plot(
        [0, 1],
        [row.一月, row.六月],
        "o-",
        color=COLORS[i],
        lw=2,
    )
    ax.text(
        -0.08,
        row.一月,
        f"{row.渠道}{row.一月}",
        ha="right",
        va="center",
    )
    ax.text(
        1.08, row.六月, f"{row.六月}{row.渠道}", va="center"
    )
ax.set(
    xticks=[0, 1],
    xticklabels=["一月", "六月"],
    xlim=(-0.6, 1.6),
    ylim=(14, 43),
    ylabel="新客户收入(万元)",
)
finish(5, "两个月之间,渠道排名如何互换", fig, df)
别忽略: 两点之间的线只是连接关系,不代表中间月份线性增长。遇到端点密集的数据,应减少系列或错开标签,不能为了避让而改变真实纵坐标。
06|雷达图:选工具时,把能力放在同一把尺子上
工具:Matplotlib。
多维度选型时,先约定评价量表,比先挑一个漂亮雷达图更重要。本例比较两个虚构方案的易用、定制、交互、导出和协作得分,五项都采用 0 到 100 且越高越好的规则。
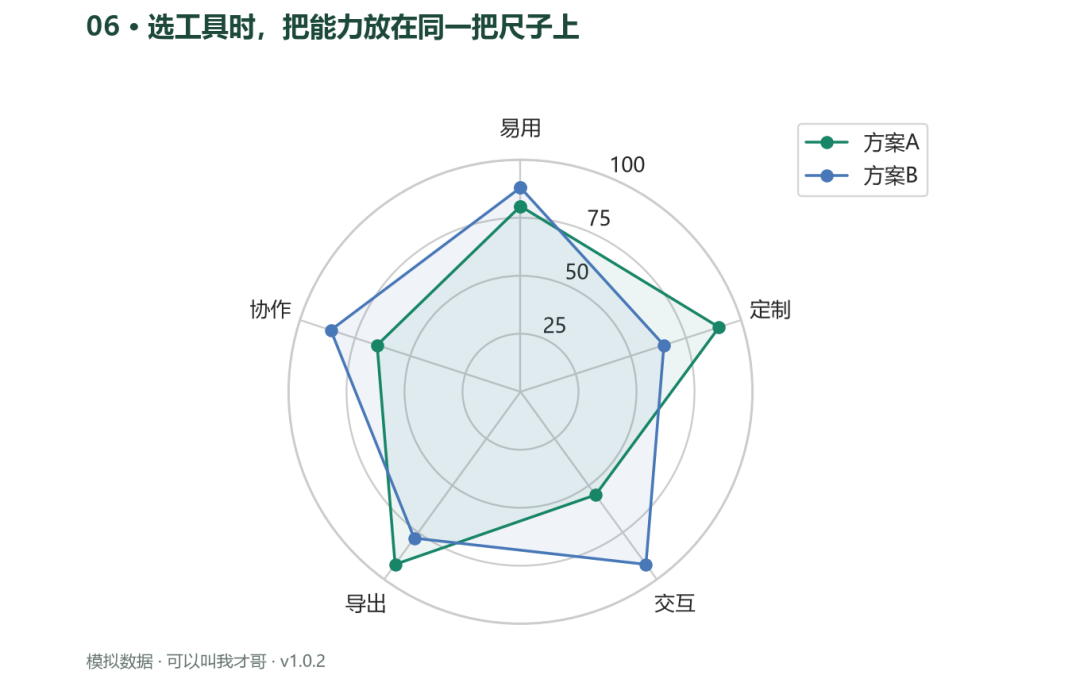
看图结果: 方案 A 在定制与导出上较高,方案 B 在交互与协作上较高。这只是演示评分表中的取舍,没有预设一个全能赢家。
实现思路: 五个维度均匀分布在圆周上,最后把第一个点接回去,轮廓才会闭合。轻透明填充只帮助区分方案,主要判断仍然来自每个维度的端点。
"""案例 06:选工具时,把能力放在同一把尺子上 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(6, "", subplot_kw={"projection": "polar"})
df = pd.DataFrame(
    {
        "维度": ["易用", "定制", "交互", "导出", "协作"],
        "方案A": [80, 90, 55, 92, 65],
        "方案B": [88, 65, 92, 78, 86],
    }
)
theta = np.linspace(0, 2 * np.pi, len(df), endpoint=False)
for name in ["方案A", "方案B"]:
    angles = np.r_[theta, theta[0]]
    values = np.r_[df[name], df[name].iloc[0]]
    ax.plot(angles, values, "o-", label=name)
    ax.fill(angles, values, alpha=0.08)
ax.set(
    theta_offset=np.pi / 2,
    theta_direction=-1,
    xticks=theta,
    xticklabels=df.维度,
    ylim=(0, 100),
)
ax.set_yticks([25, 50, 75, 100])
ax.legend(loc="upper right", bbox_to_anchor=(1.4, 1.1))
finish(6, "选工具时,把能力放在同一把尺子上", fig, df)
别忽略: 这些得分是演示用的主观评分,不能当成任何真实库的测评结果。雷达多边形面积会受到维度顺序影响,不适合用面积大小给方案做综合排名。
07|平行坐标图:平行坐标,寻找多指标的折中方案
工具:Plotly。
质量高、成本低、延迟小,三个目标通常需要取舍。我们构造 12 个方案,把原始质量、成本和延迟放在同一张图里寻找相近的折中方案。
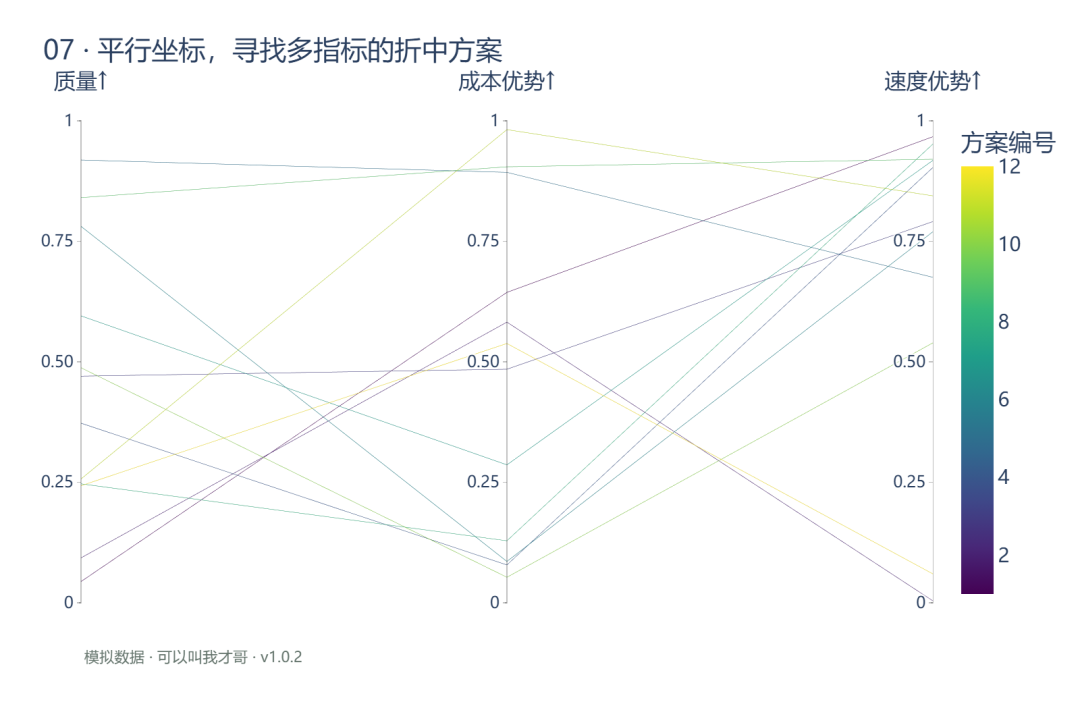
看图结果: 成本 10 至 30 万元映射为 1 至 0 的成本优势,延迟 100 至 800 毫秒映射为 1 至 0 的速度优势。三轴高处具有一致方向。
实现思路: 为了让方向一致,成本和延迟转换成优势分数,三条轴都表示越高越好。归一化使用事先约定的范围,而不是偷偷根据当前样本的最小最大值调整;原始数据和转换结果分别导出。
"""案例 07:平行坐标,寻找多指标的折中方案 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.graph_objects as go

rng = np.random.default_rng(20260920)
df = pd.DataFrame(
    {
        "方案": np.arange(1, 13),
        "质量": rng.uniform(70, 96, 12),
        "成本": rng.uniform(10, 30, 12),
        "延迟": rng.uniform(100, 800, 12),
    }
)
scaled = pd.DataFrame(
    {
        "质量↑": (df.质量 - 70) / 26,
        "成本优势↑": (30 - df.成本) / 20,
        "速度优势↑": (800 - df.延迟) / 700,
    }
)
fig = go.Figure(
    go.Parcoords(
        line=dict(
            color=df.方案,
            colorscale="Viridis",
            showscale=True,
            colorbar=dict(title="方案编号"),
        ),
        labelfont=dict(size=20),
        dimensions=[
            dict(
                label=c,
                values=scaled[c],
                range=[0, 1],
                tickvals=[0, 0.25, 0.5, 0.75, 1],
                ticktext=["0", "0.25", "0.50", "0.75", "1"],
            )
            for c in scaled
        ],
    )
)
finish(
    7,
    "平行坐标,寻找多指标的折中方案",
    fig,
    {"raw": df, "scaled": scaled},
)
别忽略: Plotly 的交互版可以拖动轴上的区间筛选方案。截图只能展示静态形状,颜色表示方案编号,没有好坏含义。归一化会隐藏原始单位,实际选型时必须回到原始成本与延迟表。
交互版在资料包 outputs/07_v1.0.2.html,可在本地浏览器打开。
08|比例圆面积图:圆面积编码,数值翻倍不能把半径翻倍
工具:Matplotlib。
四个项目的调用量分别为 100、200、400、800。我们希望圆的面积也呈现 1 比 2 比 4 比 8 的关系,而不是让最大值在视觉上被夸大。
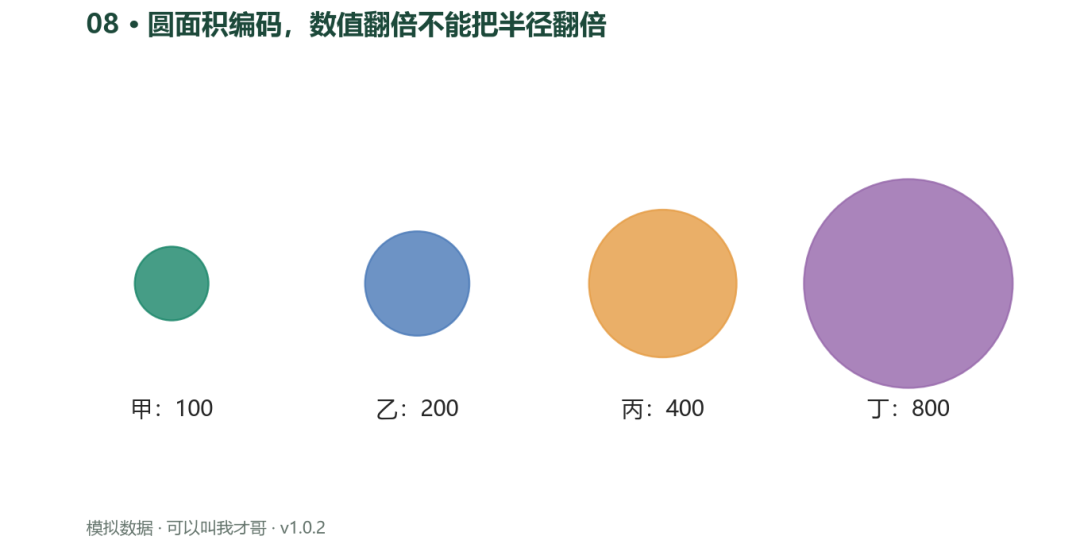
看图结果: 四个圆的面积比例为 1:2:4:8;最大圆半径约为最小圆的 2.83 倍,而不是 8 倍。
实现思路: 圆面积等于 πr²,所以半径必须和数值的平方根成正比。代码直接创建 Circle,使用相同坐标尺度,并对面积除以原值的结果做一致性检查。
"""案例 08:圆面积编码,数值翻倍不能把半径翻倍 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from matplotlib.patches import Circle

rng, fig, ax = start(8, "", size=(8, 4))
df = pd.DataFrame(
    {
        "项目": ["甲", "乙", "丙", "丁"],
        "调用量": [100, 200, 400, 800],
    }
)
df["半径"] = np.sqrt(df.调用量 / 800) * 0.85
for i, row in enumerate(df.itertuples()):
    ax.add_patch(
        Circle((i * 2, 0), row.半径, color=COLORS[i], alpha=0.8)
    )
    ax.text(
        i * 2, -1.08, f"{row.项目}:{row.调用量}", ha="center"
    )
assert np.allclose(
    np.pi * df.半径**2 / df.调用量, np.pi * 0.85**2 / 800
)
ax.set(xlim=(-1.2, 7.2), ylim=(-1.5, 1.2), aspect="equal")
ax.axis("off")
finish(
    8,
    "圆面积编码,数值翻倍不能把半径翻倍",
    fig,
    df,
    {"面积比例": "1:2:4:8", "半径比例": "1:√2:2:√8"},
)
别忽略: 如果把数值直接当半径,800 相对于 100 会产生 64 倍面积,而正确关系只有 8 倍。圆形适合表达量级与视觉焦点;需要精确排名时,排序条形图仍更容易读。
09|日历热力图:日历热力图,周末和工作日有何区别
工具:Seaborn。
访问量每天都有变化,但按日期画一条线,不一定能看清星期效应。日历热力图把日期排回每周七天,让周末与工作日自然对齐。
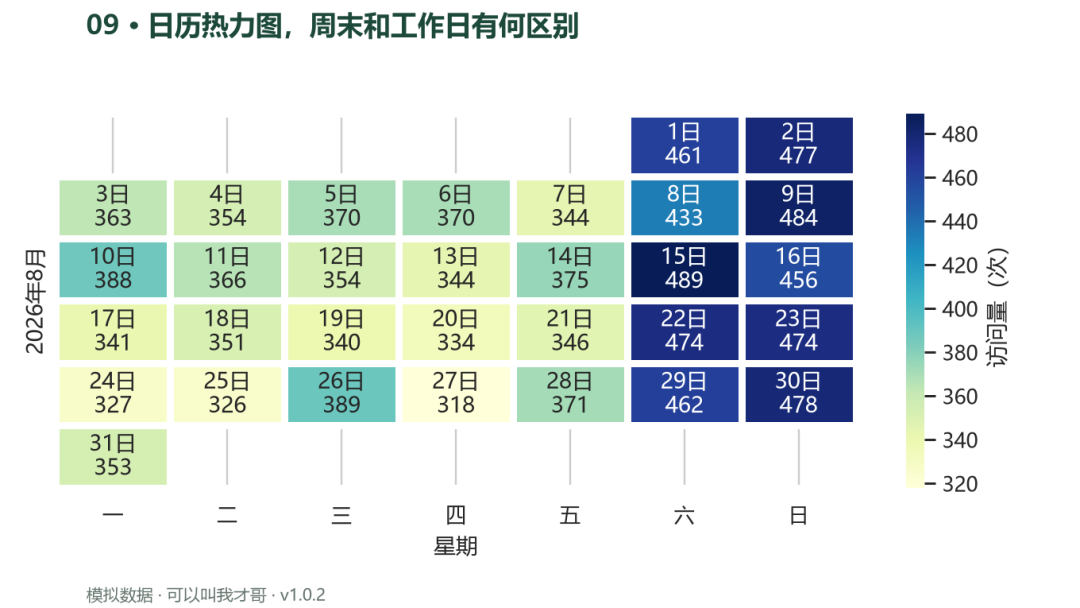
看图结果: 8 月 1 日是星期六,因此第一行只在周六、周日有日期。白色空位没有被当作零访问参与色阶。
实现思路: 第一天的星期偏移决定它落在哪个格子,因此不能把 1 号永远放在第一列。没有日期的格子保留 NaN 并遮罩,格内同时写日期和访问量,连续色阶只编码数量。
"""案例 09:日历热力图,周末和工作日有何区别 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(9, "", size=(8, 4.5))
dates = pd.date_range("2026-08-01", "2026-08-31")
df = pd.DataFrame(
    {
        "日期": dates,
        "访问量": rng.poisson(350, 31)
        + (dates.dayofweek >= 5) * 120,
    }
)
grid = np.full((6, 7), np.nan)
labels = np.full((6, 7), "", dtype=object)
for row in df.itertuples():
    pos = row.日期.day - 1 + dates[0].dayofweek
    r, c = divmod(pos, 7)
    grid[r, c] = row.访问量
    labels[r, c] = f"{row.日期.day}日\n{row.访问量}"
sns.heatmap(
    grid,
    annot=labels,
    fmt="",
    cmap="YlGnBu",
    mask=np.isnan(grid),
    ax=ax,
    linewidths=3,
    cbar_kws={"label": "访问量(次)"},
    xticklabels=list("一二三四五六日"),
    yticklabels=False,
)
ax.set(xlabel="星期", ylabel="2026年8月")
finish(9, "日历热力图,周末和工作日有何区别", fig, df)
别忽略: 模拟数据主动给周末增加了访问,因此图中出现周末更深的模式是生成机制的结果,不是对真实账号的观察。空白格不代表零访问,换月份时也要重新计算首日偏移。
10|单位点阵图:单位点阵,让交付量变得可数
工具:Matplotlib。
当数量不大时,把 24 项交付画成 24 个方块,比一根抽象的长柱子更容易逐个理解。这里一块就是一项验收交付,四个团队各自单独成组。
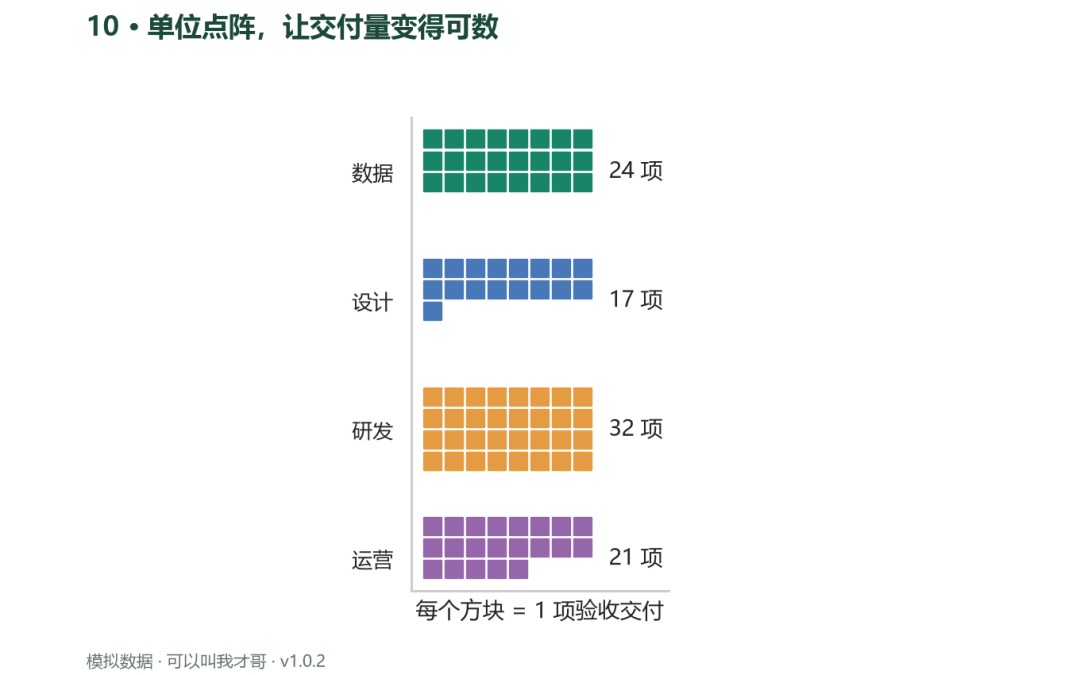
看图结果: 数据、设计、研发、运营分别对应 24、17、32、21 个方块,四组总计 94 项交付。
实现思路: 用取余计算列号,用整除计算行号,每行最多八个方块。团队间预留空行,让组别边界清楚;右侧总数为读者提供快速核对,不要求大家真的一个个数完。
"""案例 10:单位点阵,让交付量变得可数 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(10, "")
df = pd.DataFrame(
    {
        "团队": ["数据", "设计", "研发", "运营"],
        "交付量": [24, 17, 32, 21],
    }
)
for i, row in enumerate(df.itertuples()):
    k = np.arange(row.交付量)
    ax.scatter(
        k % 8, i * 6 + k // 8, s=90, marker="s", color=COLORS[i]
    )
    ax.text(8.2, i * 6 + 1.5, f"{row.交付量} 项", va="center")
ax.set(
    yticks=np.arange(4) * 6 + 1.5,
    yticklabels=df.团队,
    xticks=[],
    xlim=(-1, 11),
    aspect="equal",
)
ax.invert_yaxis()
ax.grid(False)
ax.set_xlabel("每个方块 = 1 项验收交付")
finish(10, "单位点阵,让交付量变得可数", fig, df)
别忽略: 这里的图标单位必须固定,不能有的团队一块代表一项,有的代表十项。点阵适合小数量与传播型解释,数万条明细应先汇总,别靠缩成密密麻麻的小点堆满画面。
观察时间与变化 · 11—20
11|折线与移动平均:趋势线先处理日期,再连接观测
工具:Matplotlib。
订单曲线同时包含增长、星期周期和随机波动。我们先保留每日原值,再叠加后向 7 日均值,分别回答每天发生什么和近期方向如何。
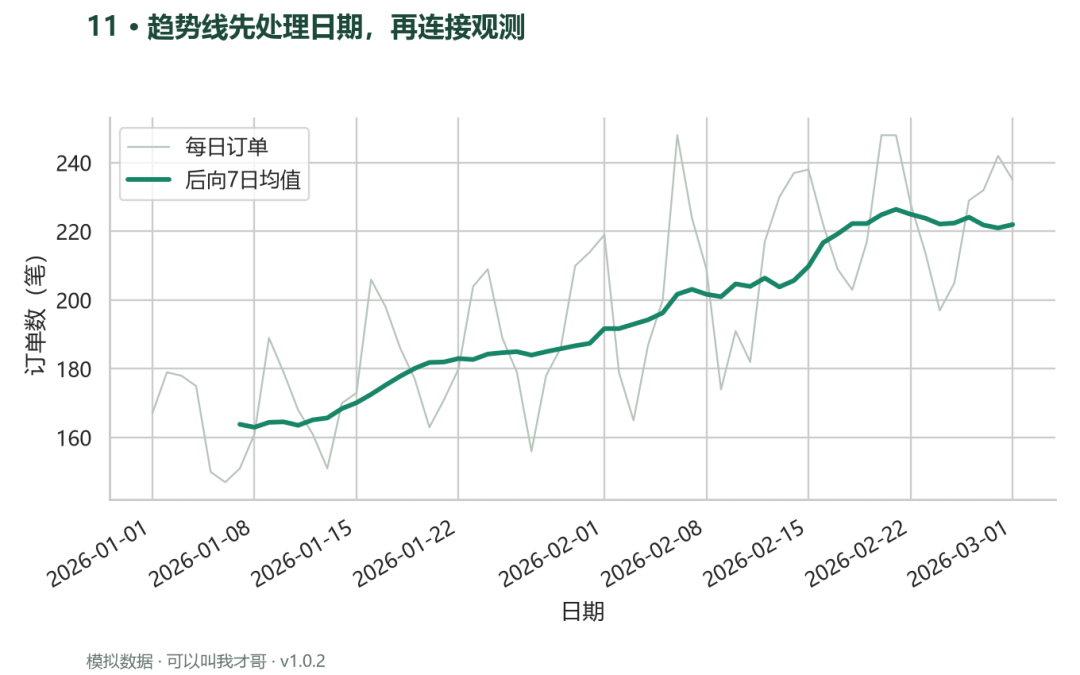
看图结果: 灰线保留星期波动,绿色 7 日均线更平稳。1 月 1 日至 6 日没有均线值,因为七日窗口尚不完整。
实现思路: rolling 的窗口包含当日及前六日,min_periods=7 要求满七个观测才给结果。前六天保持空值,避免读者以为整条平滑线使用了完全相同的样本窗口。
"""案例 11:趋势线先处理日期,再连接观测 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(11, "")
df = pd.DataFrame(
    {"日期": pd.date_range("2026-01-01", periods=60)}
)
df["订单"] = np.round(
    160
    + np.arange(60) * 1.2
    + 20 * np.sin(np.arange(60) * 2 * np.pi / 7)
    + rng.normal(0, 8, 60)
)
df["7日均值"] = df.订单.rolling(7, min_periods=7).mean()
ax.plot(
    df.日期, df.订单, color="#B6C5BC", lw=1, label="每日订单"
)
ax.plot(df.日期, df["7日均值"], lw=2.5, label="后向7日均值")
ax.set(ylabel="订单数(笔)", xlabel="日期")
ax.legend()
fig.autofmt_xdate()
finish(
    11,
    "趋势线先处理日期,再连接观测",
    fig,
    df,
    {"窗口": "包含当日及前6日;前6日均值留空"},
)
别忽略: 平滑会降低噪声,也会滞后于突变。它不预测未来,不应该跨缺失日期直接把七行当七天;真实日数据要先补齐日期索引,并明确缺测处理规则。
12|面积图:面积图强调规模,不用渐变伪装增长
工具:Matplotlib。
月末已使用存储量是一个库存指标,我们想强调的是每个月的容量规模。面积图从零填到曲线,读者能同时看到水平高低和变化方向。
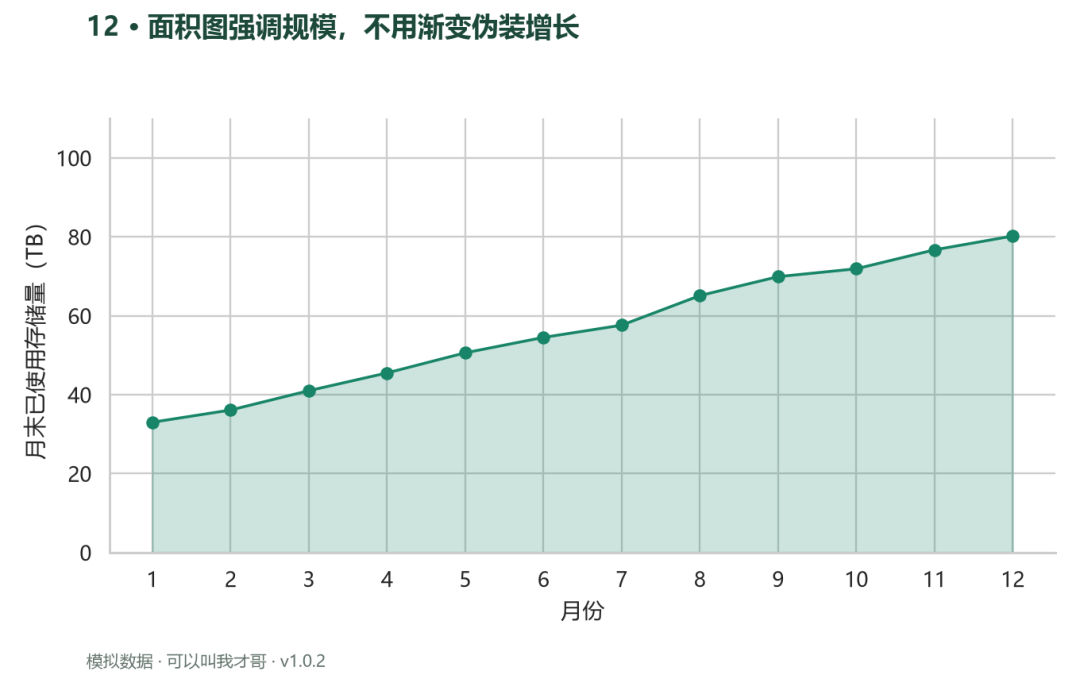
看图结果: 月末存储量从 33.0 TB 增加到 80.2 TB;这是存量路径,不是十二个月新增量的简单加总。
实现思路: 本例先模拟每个月的新增占用,再累加得到月末存量。fill_between 负责填充,plot 保留清晰轮廓,两个图层使用同一组数据,避免填充与折线错位。
"""案例 12:面积图强调规模,不用渐变伪装增长 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(12, "")
df = pd.DataFrame(
    {
        "月份": np.arange(1, 13),
        "存储量": np.round(
            30 + np.cumsum(rng.uniform(2, 8, 12)), 1
        ),
    }
)
ax.fill_between(df.月份, df.存储量, alpha=0.22, color=COLORS[0])
ax.plot(df.月份, df.存储量, "o-", color=COLORS[0])
ax.set(
    xlabel="月份",
    ylabel="月末已使用存储量(TB)",
    ylim=(0, 110),
    xticks=df.月份,
)
finish(12, "面积图强调规模,不用渐变伪装增长", fig, df)
别忽略: 月份是离散观测,曲线之间的填充只是视觉连续。不要把十二个月的存量相加当作全年新增,也不要在需要细看小波动时靠截断面积基线放大变化。
13|阶梯图:阶梯图忠实表达规则生效的时间
工具:Matplotlib。
免费请求额度在政策调整日才发生变化。普通折线会在两个调整日之间画出斜坡,好像额度每天都在缓慢增加,这与规则不符。
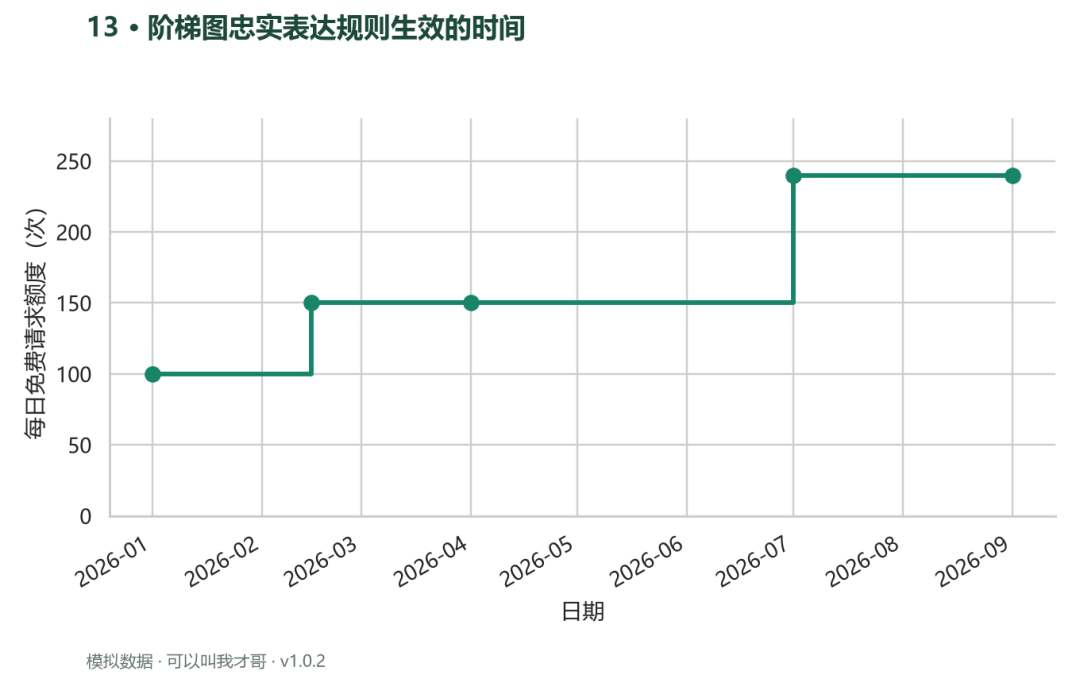
看图结果: 额度在 2 月 15 日从 100 次调到 150 次,7 月 1 日调到 240 次。两个调整日之间保持水平。
实现思路: step 的 where='post' 表示当前节点的额度持续到下一个节点之前。用显式生效日期作横轴,同样的 150 次额度可以跨多个时间节点保持不变。
"""案例 13:阶梯图忠实表达规则生效的时间 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(13, "")
df = pd.DataFrame(
    {
        "日期": pd.to_datetime(
            [
                "2026-01-01",
                "2026-02-15",
                "2026-04-01",
                "2026-07-01",
                "2026-09-01",
            ]
        ),
        "免费额度": [100, 150, 150, 240, 240],
    }
)
ax.step(df.日期, df.免费额度, where="post", lw=2.5)
ax.scatter(df.日期, df.免费额度, s=60)
ax.set(
    ylabel="每日免费请求额度(次)",
    xlabel="日期",
    ylim=(0, 280),
)
fig.autofmt_xdate()
finish(13, "阶梯图忠实表达规则生效的时间", fig, df)
别忽略: 边界约定要和业务一致:调整日当天已经执行新额度,还是次日执行?本例采用当天生效。最后一个日期也用于界定展示范围,不代表最后一档额度在该日停止。
14|极坐标周期折线:环形时间轴,比较一天中的访问节奏
工具:Matplotlib。
一天的 24 小时是周期数据,23 点之后会回到 0 点。把小时映射到圆周角度,可以把上午与晚间两段高峰放在同一圈里看。
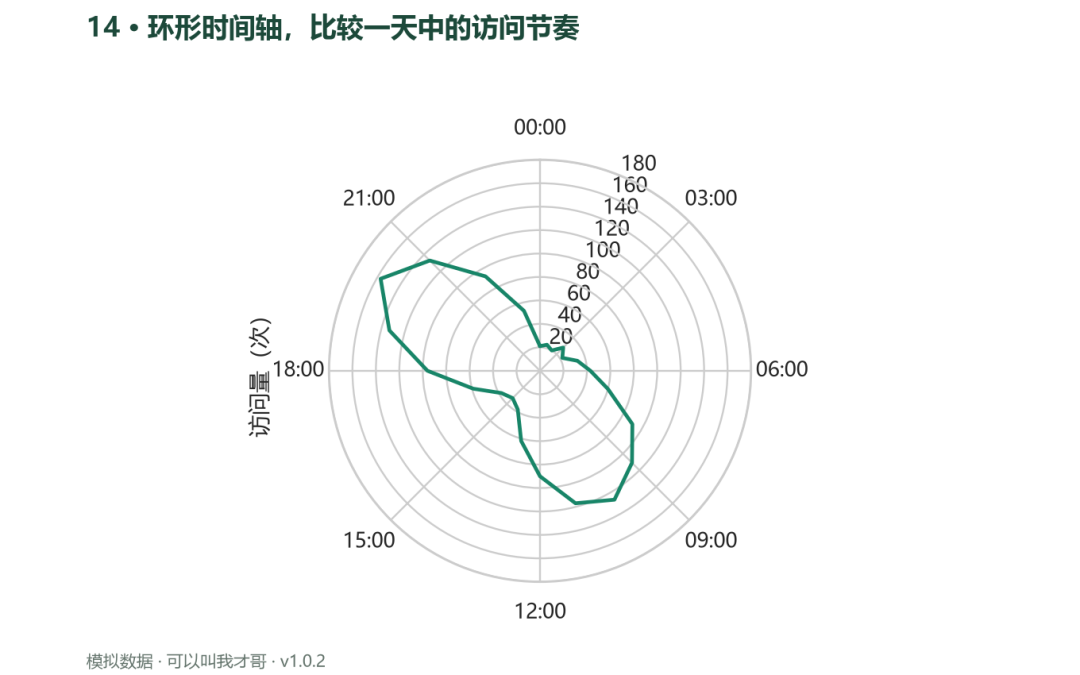
看图结果: 图中出现约 10 点与 20 点两个高峰,0 点和 23 点的边界被连续连接,符合一天的周期结构。
实现思路: 0 点放在上方,时间顺时针前进;半径表示访问量,最后复制 0 点的数值闭合周期。这里选择折线,不让填充面积承担额外的数量含义。
"""案例 14:环形时间轴,比较一天中的访问节奏 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(14, "", subplot_kw={"projection": "polar"})
h = np.arange(24)
v = (
    20
    + 100 * np.exp(-(((h - 10) / 3) ** 2))
    + 130 * np.exp(-(((h - 20) / 2.5) ** 2))
)
df = pd.DataFrame(
    {"小时": h, "访问量": np.round(v + rng.uniform(0, 8, 24))}
)
theta = h / 24 * 2 * np.pi
ax.plot(
    np.r_[theta, 2 * np.pi],
    np.r_[df.访问量, df.访问量.iloc[0]],
    lw=2,
)
ax.set(
    theta_offset=np.pi / 2,
    theta_direction=-1,
    xticks=np.arange(0, 24, 3) / 24 * 2 * np.pi,
    xticklabels=[f"{x:02d}:00" for x in range(0, 24, 3)],
    ylim=(0, 180),
)
ax.set_ylabel("访问量(次)", labelpad=30)
finish(14, "环形时间轴,比较一天中的访问节奏", fig, df)
别忽略: 环形布局适合真正的周期,不能把一段没有循环关系的年份强行首尾连接。想精确比较 9 点与 10 点的差距时,普通折线仍更直接。
15|堆叠面积图:堆叠面积,看渠道总量与结构一起变化
工具:Matplotlib。
搜索、社群和视频共同贡献每月获客量。本例把三个渠道的绝对数量叠起来,顶部轮廓表示总量,各层厚度表示各渠道贡献。
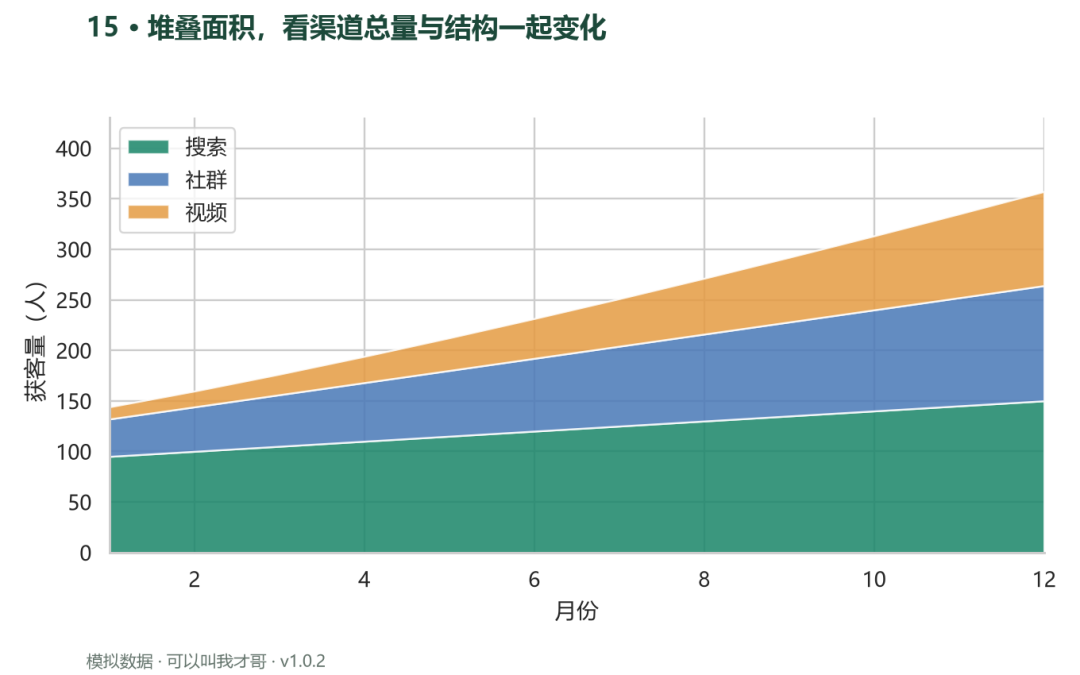
看图结果: 三类获客量都增加,社群增长更快。顶部总量上升与内部份额变化需要分开理解。
实现思路: stackplot 需要按月份顺序传入每一个系列。代码固定系列顺序和颜色,避免同一个渠道在不同月份突然换到另一层,让读者误以为结构发生变化。
"""案例 15:堆叠面积,看渠道总量与结构一起变化 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(15, "")
t = np.arange(1, 13)
df = pd.DataFrame(
    {
        "月份": t,
        "搜索": 90 + 5 * t,
        "社群": 30 + 7 * t,
        "视频": 10 + 2 * t**1.5,
    }
)
ax.stackplot(
    t,
    *[df[c] for c in ["搜索", "社群", "视频"]],
    labels=["搜索", "社群", "视频"],
    alpha=0.85
)
ax.set(
    xlabel="月份",
    ylabel="获客量(人)",
    xlim=(1, 12),
    ylim=(0, 430),
)
ax.legend(loc="upper left")
finish(15, "堆叠面积,看渠道总量与结构一起变化", fig, df)
别忽略: 上层边界的上升不一定意味着该渠道增加,它还可能来自底层增长。读渠道自身趋势要看带宽,读总量才看最上沿;如果关注份额,应先按月除以总量。
16|河流图:河流图观察主题热度如何消长
工具:Matplotlib。
入门、实战、部署三个话题的讨论热度,可能先后达到高峰。河流图通过连续色带展示主题如何接续出现,适合观察整体节奏。
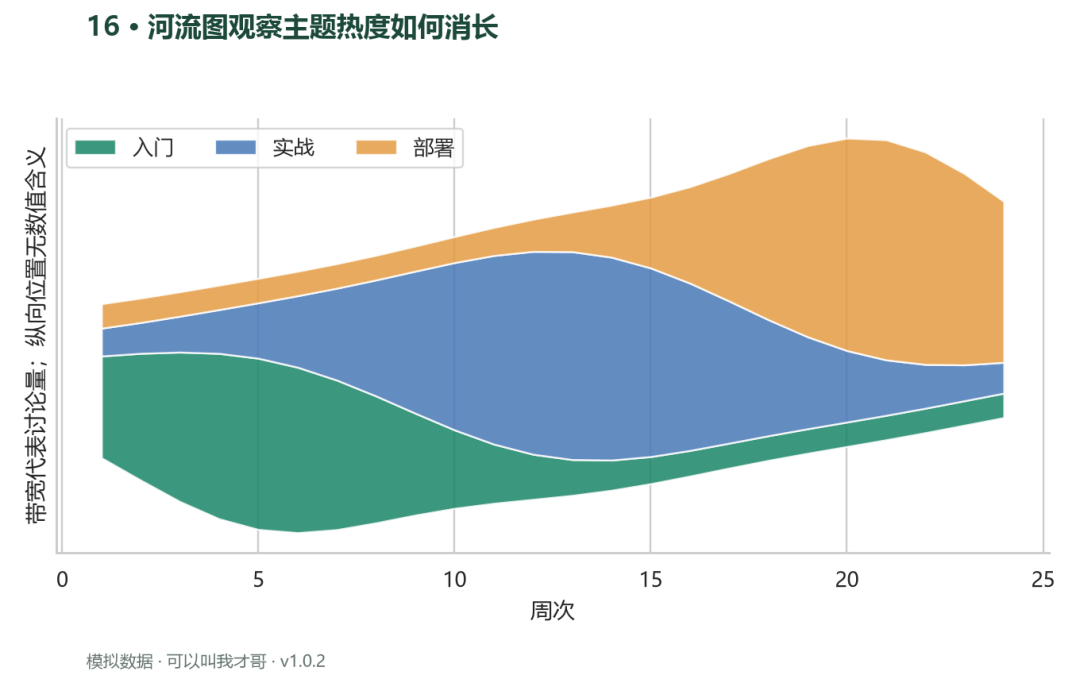
看图结果: 入门话题先达到高峰,实战居中,部署靠后。三条带子的厚度反映各自热度,中心线位置没有业务单位。
实现思路: baseline='wiggle' 会调整堆叠基线,让色带的整体起伏更平顺。数据仍是非负讨论量,带宽才对应数量,色带上下位置不再有可直接读取的绝对意义。
"""案例 16:河流图观察主题热度如何消长 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(16, "")
t = np.arange(24)
df = pd.DataFrame(
    {
        "周": t + 1,
        "入门": 60 * np.exp(-(((t - 4) / 5) ** 2)) + 10,
        "实战": 75 * np.exp(-(((t - 12) / 6) ** 2)) + 10,
        "部署": 80 * np.exp(-(((t - 20) / 5) ** 2)) + 10,
    }
)
ax.stackplot(
    df.周,
    df.入门,
    df.实战,
    df.部署,
    baseline="wiggle",
    labels=["入门", "实战", "部署"],
    alpha=0.85,
)
ax.set(
    xlabel="周次",
    ylabel="带宽代表讨论量;纵向位置无数值含义",
    yticks=[],
)
ax.legend(ncol=3, loc="upper left")
finish(16, "河流图观察主题热度如何消长", fig, df)
别忽略: 因此本图删除数值纵轴,并明确写出带宽含义。河流图不能胜任精确的逐周数值比较,也不能把负的基线坐标误解成负讨论量。
17|排名变化图:排名曲线,只回答位次问题
工具:Matplotlib。
收入增长不等于排名上升,因为其他团队可能增长更快。这里先保留四个团队的月收入,再逐月计算降序名次,单独回答谁超越了谁。
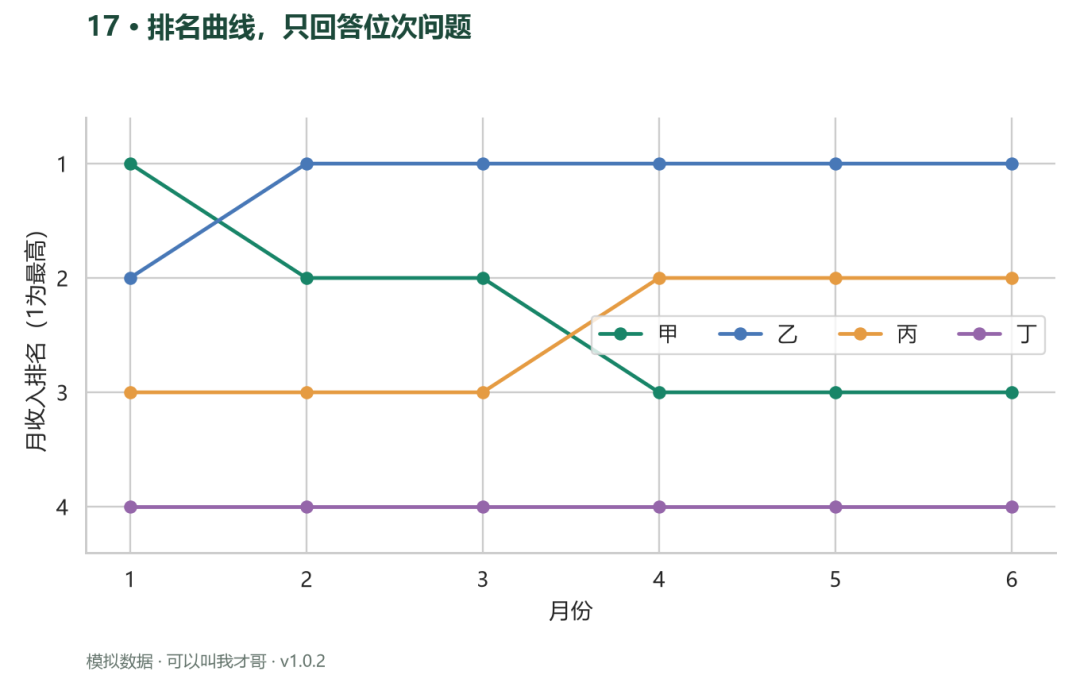
看图结果: 乙在第 2 个月升到第一,甲在第 4 个月降到第三。原始收入表仍然保留,排名图没有替代金额信息。
实现思路: rank 沿行比较同一月份,ascending=False 让最高收入成为第 1 名。纵轴反转以后,第 1 名始终在上方,连线交叉就意味着相对位次改变。
"""案例 17:排名曲线,只回答位次问题 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(17, "")
df = pd.DataFrame(
    {
        "月份": np.arange(1, 7),
        "甲": [100, 98, 95, 92, 96, 105],
        "乙": [90, 99, 101, 110, 115, 120],
        "丙": [80, 83, 90, 100, 101, 110],
        "丁": [70, 75, 88, 89, 93, 98],
    }
)
rank = df.set_index("月份").rank(
    axis=1, ascending=False, method="min"
)
for i, c in enumerate(rank):
    ax.plot(
        rank.index,
        rank[c],
        "o-",
        lw=2,
        label=c,
        color=COLORS[i],
    )
ax.set(
    yticks=[1, 2, 3, 4],
    xticks=df.月份,
    xlabel="月份",
    ylabel="月收入排名(1为最高)",
    ylim=(4.4, 0.6),
)
ax.legend(ncol=4)
finish(
    17,
    "排名曲线,只回答位次问题",
    fig,
    {"raw": df, "ranks": rank.reset_index()},
)
别忽略: 排名隐藏了收入差距:领先 1 万元和领先 100 万元可能只差一个名次。本例没有并列值;换成真实数据时,需要说明并列排名采用最小名次、平均名次还是其他规则。
18|甘特图:甘特图把开始时间与工期分开编码
工具:Matplotlib。
一个项目有需求、数据、开发、测试、上线五项任务。甘特图把开始日期放在横向位置,把持续天数放在长度上,可以看见并行工作与交接安排。
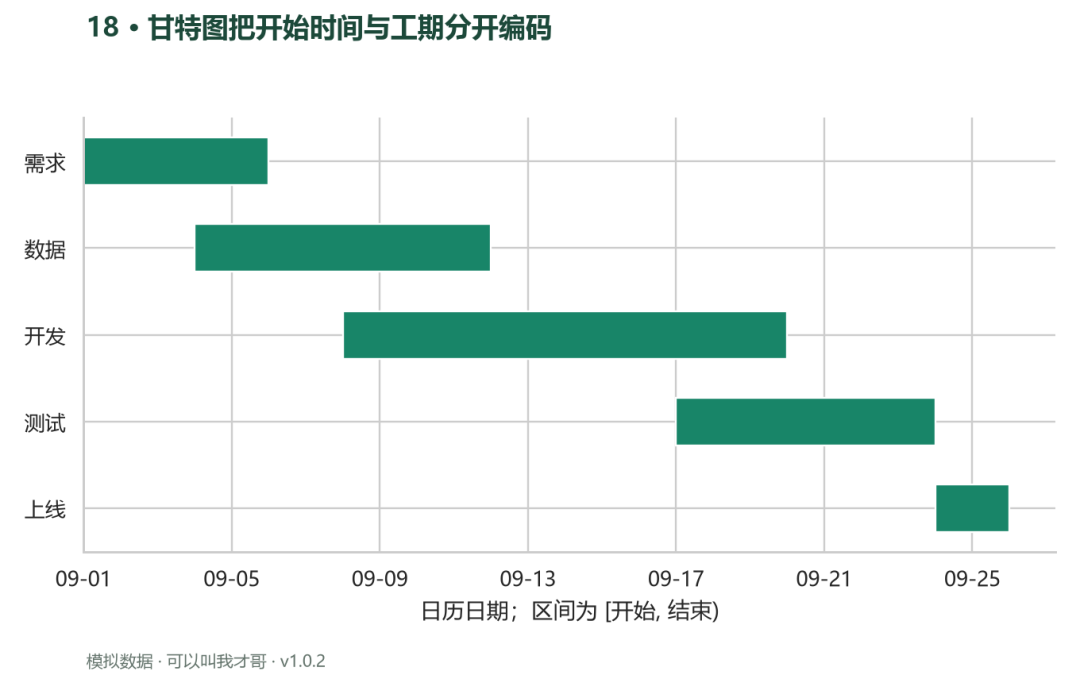
看图结果: 开发与测试在 9 月 17 日至 20 日之间重叠;上线任务为 9 月 24 日起的两天,即区间[24日,26日)。
实现思路: 日期先转成 Matplotlib 日期坐标,barh 的 left 接开始时间,width 接工期。结束日期按开始加天数计算,明确采用左闭右开的区间,避免多算一天。
"""案例 18:甘特图把开始时间与工期分开编码 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import matplotlib.dates as mdates

rng, fig, ax = start(18, "")
df = pd.DataFrame(
    {
        "任务": ["需求", "数据", "开发", "测试", "上线"],
        "开始": pd.to_datetime(
            [
                "2026-09-01",
                "2026-09-04",
                "2026-09-08",
                "2026-09-17",
                "2026-09-24",
            ]
        ),
        "天数": [5, 8, 12, 7, 2],
    }
)
df["结束"] = df.开始 + pd.to_timedelta(df.天数, unit="D")
ax.barh(
    df.任务, df.天数, left=mdates.date2num(df.开始), height=0.55
)
ax.xaxis_date()
ax.xaxis.set_major_formatter(mdates.DateFormatter("%m-%d"))
ax.invert_yaxis()
ax.set_xlabel("日历日期;区间为 [开始, 结束)")
finish(18, "甘特图把开始时间与工期分开编码", fig, df)
别忽略: 本例表达计划安排,没有建模人员容量、前置依赖或节假日。两根任务条重叠只能说明时间重叠,不能据此认定项目排程可执行。
19|瀑布图:瀑布图解释余额如何一步步变化
工具:Matplotlib。
期初有 100 万元,期间发生回款、采购、工资和租金,最后还剩多少?瀑布图把每次变动放在前一次余额的位置,形成一条能追溯的余额链。
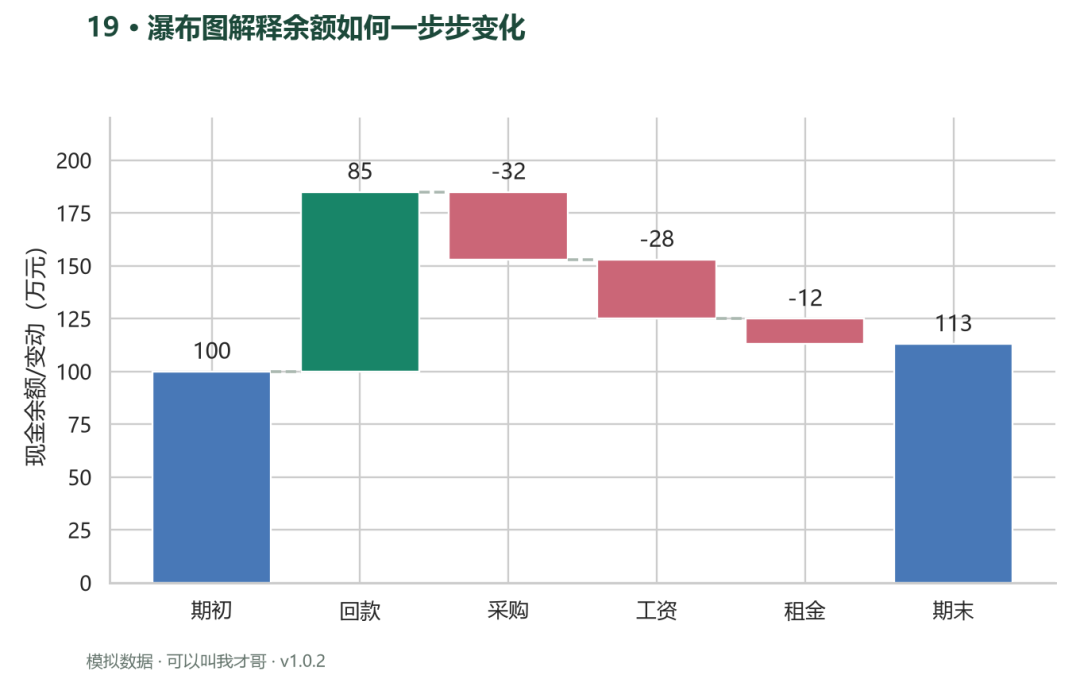
看图结果: 100+85−32−28−12=113 万元,期末总量柱和这条计算链完全一致。
实现思路: 正变动从旧余额向上长,负变动从新余额向上画,因此柱高用绝对值、底部取新旧余额的较小值。期初和期末是总量柱,从零起画。
"""案例 19:瀑布图解释余额如何一步步变化 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(19, "")
df = pd.DataFrame(
    {
        "项目": [
            "期初",
            "回款",
            "采购",
            "工资",
            "租金",
            "期末",
        ],
        "变动": [100, 85, -32, -28, -12, 0],
    }
)
balance = 100
endpoints = [balance]
ax.bar(0, balance, color=COLORS[1])
for i in range(1, 5):
    delta = df.变动.iloc[i]
    new = balance + delta
    ax.bar(
        i,
        abs(delta),
        bottom=min(balance, new),
        color=COLORS[0] if delta > 0 else COLORS[4],
    )
    ax.plot(
        [i - 1 + 0.4, i - 0.4],
        [balance, balance],
        color="#AAB8B0",
        ls="--",
    )
    balance = new
    endpoints.append(balance)
ax.bar(5, balance, color=COLORS[1])
endpoints.append(balance)
for i, v in enumerate(df.变动):
    ax.text(
        i,
        max(endpoints[i], endpoints[max(0, i - 1)]) + 6,
        str(balance if i == 5 else v),
        ha="center",
    )
assert balance == df.变动.iloc[:5].sum()
ax.set(
    xticks=range(6),
    xticklabels=df.项目,
    ylabel="现金余额/变动(万元)",
    ylim=(0, 220),
)
finish(
    19,
    "瀑布图解释余额如何一步步变化",
    fig,
    df,
    {"期末余额": balance},
)
别忽略: 连接虚线帮助核对前后承接,断言核对期末是否等于期初加净变动。它适合可加减的余额分解;不同分母的转化率、彼此重叠的影响因素不能直接塞进这条加法链。
20|蜡烛图:蜡烛图展示同一周期的四个价格
工具:Plotly。
同一天有开盘、收盘、最高、最低四个价格。蜡烛图把开收盘之间画成实体,最高最低之间画成细线,压缩了单个交易日的信息。
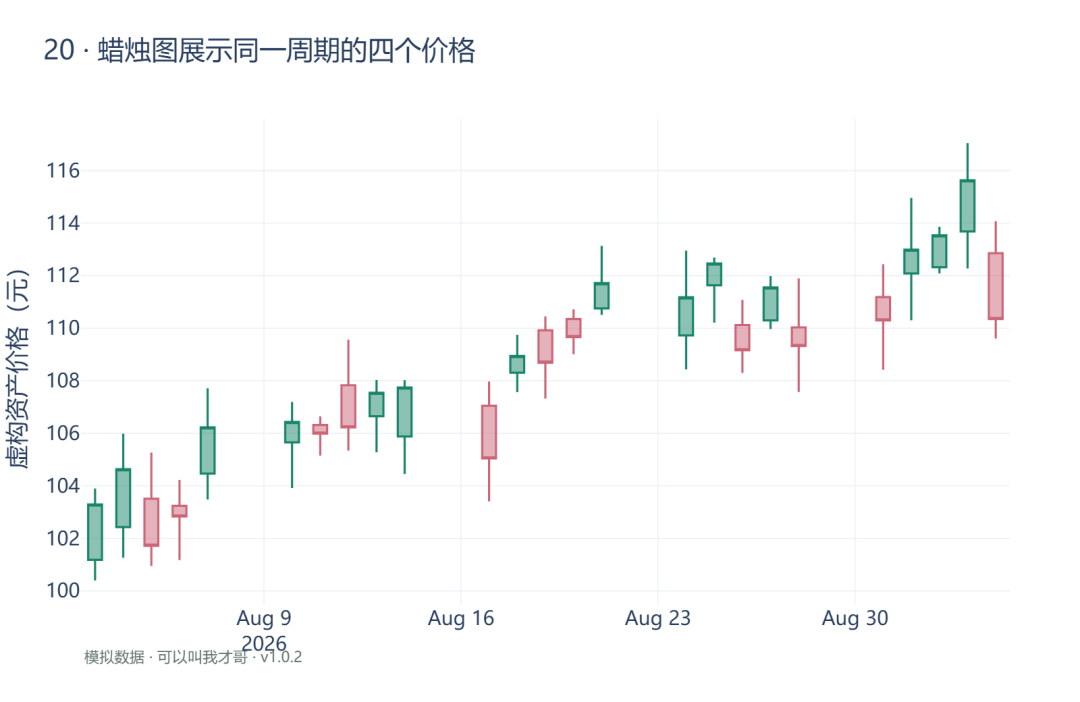
看图结果: 25 个工作日各有四个价格,最高与最低始终包住开盘和收盘。周末留白属于时间轴,不是缺失的交易记录。
实现思路: 模拟时先构造开收盘,再让最高不低于二者最大值、最低不高于二者最小值。两个条件写成断言,能挡住最高价比收盘价还低这类常见假数据错误。
"""案例 20:蜡烛图展示同一周期的四个价格 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.graph_objects as go

rng = np.random.default_rng(20260933)
n = 25
opens = 100 + np.cumsum(rng.normal(0, 1, n))
closes = opens + rng.normal(0, 1.4, n)
df = pd.DataFrame(
    {
        "日期": pd.bdate_range("2026-08-03", periods=n),
        "开盘": opens,
        "收盘": closes,
        "最高": np.maximum(opens, closes)
        + rng.uniform(0.2, 2, n),
        "最低": np.minimum(opens, closes)
        - rng.uniform(0.2, 2, n),
    }
)
assert (df.最高 >= df[["开盘", "收盘"]].max(axis=1)).all()
assert (df.最低 <= df[["开盘", "收盘"]].min(axis=1)).all()
fig = go.Figure(
    go.Candlestick(
        x=df.日期,
        open=df.开盘,
        high=df.最高,
        low=df.最低,
        close=df.收盘,
        increasing_line_color="#188568",
        decreasing_line_color="#CB6677",
    )
)
fig.update_layout(
    xaxis_rangeslider_visible=False,
    yaxis_title="虚构资产价格(元)",
)
finish(20, "蜡烛图展示同一周期的四个价格", fig, df)
别忽略: 本图绿色表示收盘高于开盘,红色表示下降,阅读前先确认配色习惯。数据对应虚构资产,只用于解释图形结构,不对应任何真实行情或交易建议。
交互版在资料包 outputs/20_v1.0.2.html,可在本地浏览器打开。
拆解构成与转化 · 21—25
21|环形占比图:环形图只放少量互斥类别
工具:Matplotlib。
收入只有四个互斥来源,总额明确为 100 万元时,环形图可以直观呈现整体构成。中间留白写总额,外侧写类别,百分比放在色带内部。
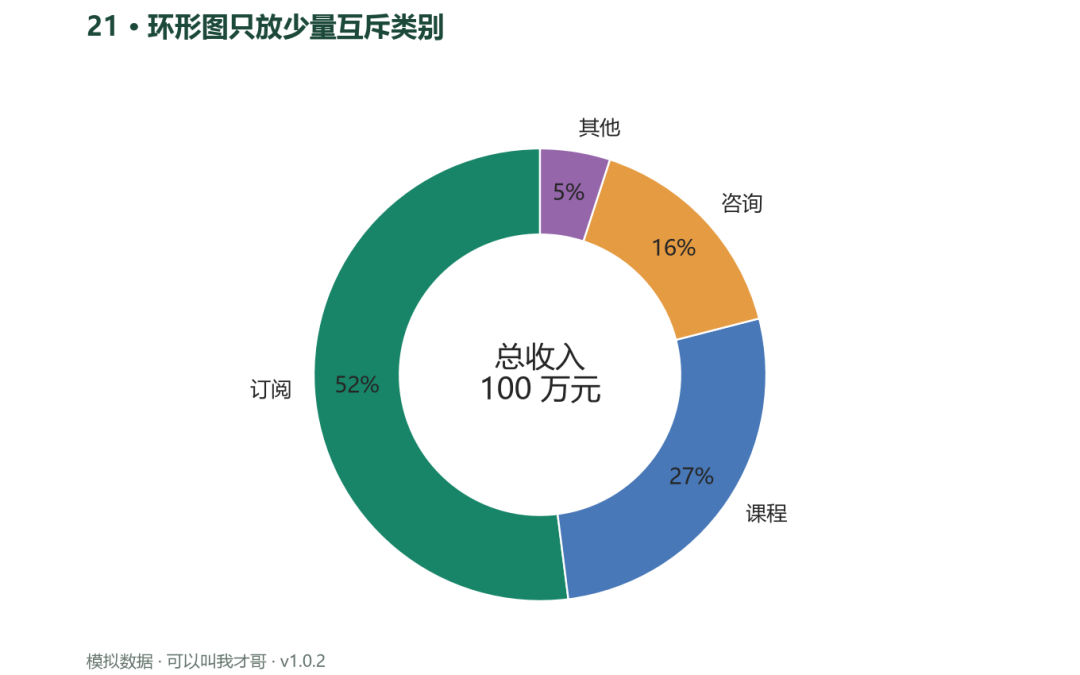
看图结果: 订阅占 52%,咨询占 16%;环中明确给出 100 万元总额,读者不必猜测分母。
实现思路: pie 的 wedgeprops 设置环宽,底层依然按照各类别占总体的角度比例绘制。把类别数控制在少量范围,能避免标签挤在一侧和小扇区难辨的问题。
"""案例 21:环形图只放少量互斥类别 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(21, "")
df = pd.DataFrame(
    {
        "来源": ["订阅", "课程", "咨询", "其他"],
        "收入": [52, 27, 16, 5],
    }
)
ax.pie(
    df.收入,
    labels=df.来源,
    autopct="%1.0f%%",
    startangle=90,
    wedgeprops={"width": 0.38, "edgecolor": "white"},
    pctdistance=0.81,
)
ax.text(
    0,
    0,
    "总收入\n100 万元",
    ha="center",
    va="center",
    fontsize=16,
)
ax.axis("equal")
finish(21, "环形图只放少量互斥类别", fig, df)
别忽略: 各项必须能相加且不重复。本例的 52% 既有占比,也有 100 万元这个分母;如果两个账户的总额不同,只比较圆环比例会遗漏规模差异。
22|100%堆叠条形图:百分比堆叠,规模不同也能比较结构
工具:Matplotlib。
四月到六月订单总量不同,但我们想比较新客与老客的结构,所以把每个月都归一到 100%。每条的长度一样,色块分界才是观察重点。
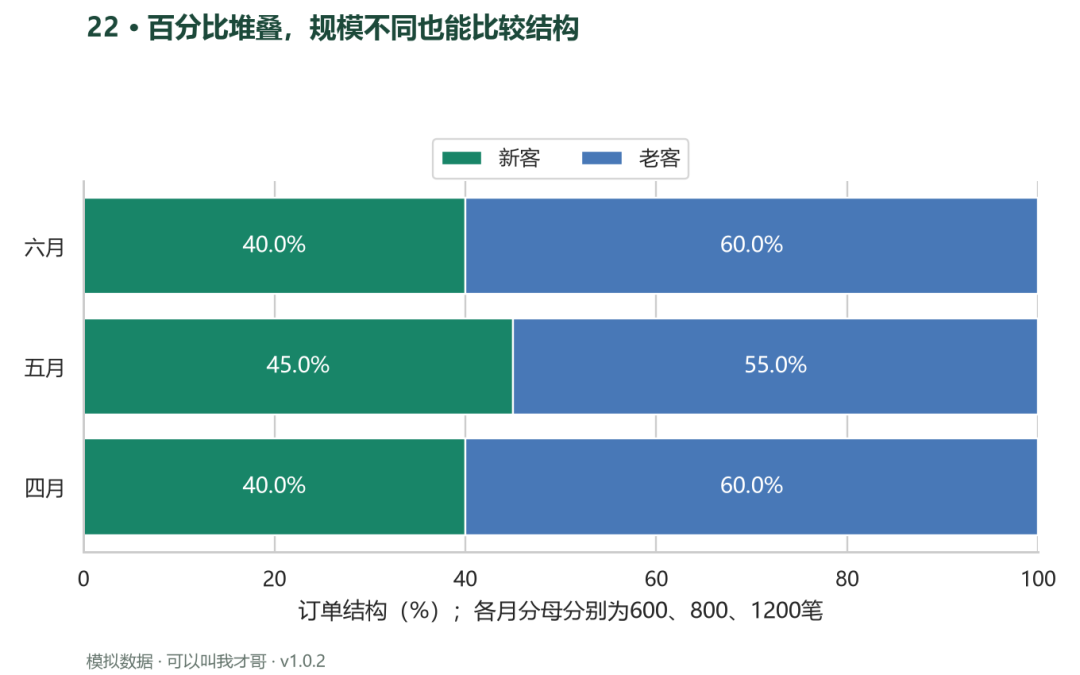
看图结果: 四月、五月、六月的新客占比分别为 40%、45%、40%;六月新客绝对数量却是四月的两倍。
实现思路: 用每行的两项订单量之和作为分母,逐行相除,再乘 100。代码检查每条是否恰好加到 100,并明确标注三个月分别是 600、800 和 1200 笔订单。
"""案例 22:百分比堆叠,规模不同也能比较结构 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(22, "")
df = pd.DataFrame(
    {
        "月份": ["四月", "五月", "六月"],
        "新客": [240, 360, 480],
        "老客": [360, 440, 720],
    }
)
shares = (
    df[["新客", "老客"]].div(
        df[["新客", "老客"]].sum(axis=1), axis=0
    )
    * 100
)
left = np.zeros(len(df))
for c in shares:
    bars = ax.barh(df.月份, shares[c], left=left, label=c)
    ax.bar_label(
        bars,
        labels=[f"{v:.1f}%" for v in shares[c]],
        label_type="center",
        color="white",
    )
    left += shares[c]
assert np.allclose(left, 100)
ax.set(
    xlim=(0, 100),
    xlabel="订单结构(%);各月分母分别为600、800、1200笔",
)
ax.legend(
    ncol=2, loc="upper center", bbox_to_anchor=(0.5, 1.14)
)
finish(22, "百分比堆叠,规模不同也能比较结构", fig, df)
别忽略: 新客占比下降不意味着新客订单下降。本例六月新客 480 笔,高于五月 360 笔,但占比从 45% 降到 40%;结构图必须和原始数量表一起保留。
23|马赛克图:马赛克图同时看分组规模与组内占比
工具:Matplotlib。
三个渠道带来的用户数量不同,付费比例也不同。马赛克图用列宽编码渠道规模,用列内高度编码付费比例,两者相乘后的面积对应联合占比。
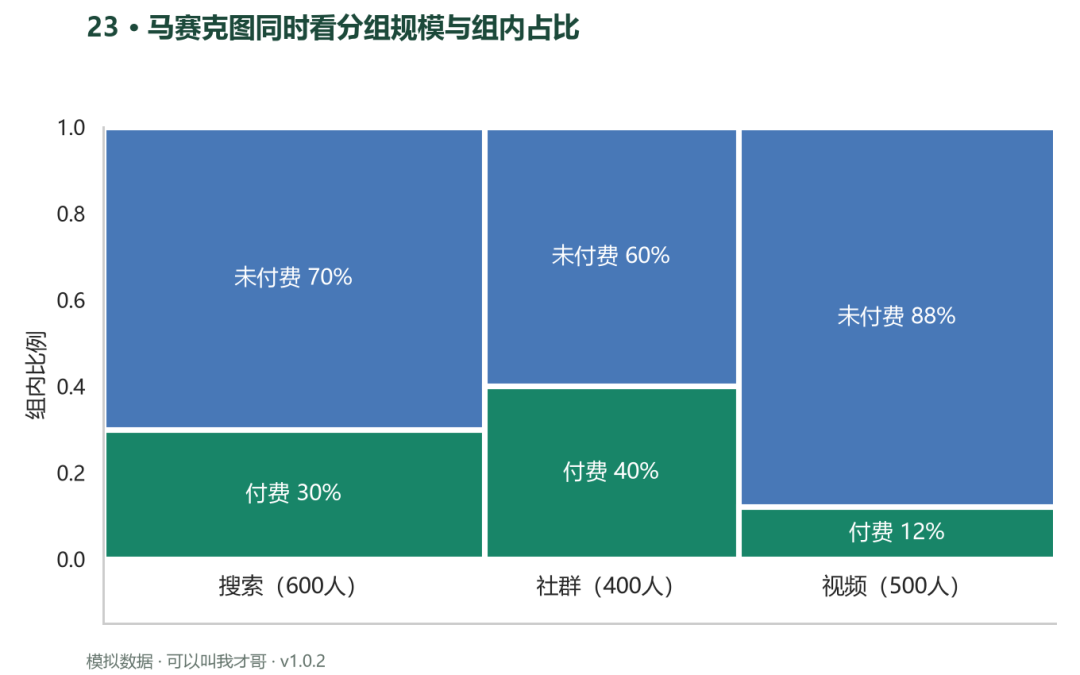
看图结果: 搜索列宽为 600/1500=40%,其中付费高度为 180/600=30%,对应矩形面积为 12% 的全部用户。
实现思路: 先计算渠道人数除以总人数,得到列宽;再计算付费人数除以本渠道人数,得到高度。Rectangle 的位置逐列累加,全部矩形面积的合计应为 1。
"""案例 23:马赛克图同时看分组规模与组内占比 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from matplotlib.patches import Rectangle

rng, fig, ax = start(23, "")
df = pd.DataFrame(
    {
        "渠道": ["搜索", "社群", "视频"],
        "付费": [180, 160, 60],
        "未付费": [420, 240, 440],
    }
)
grand = df[["付费", "未付费"]].to_numpy().sum()
x = 0
area = 0
for row in df.itertuples():
    total = row.付费 + row.未付费
    width = total / grand
    y = 0
    for k, col in enumerate(["付费", "未付费"]):
        value = getattr(row, col)
        height = value / total
        ax.add_patch(
            Rectangle(
                (x, y),
                width,
                height,
                facecolor=COLORS[k],
                edgecolor="white",
                lw=3,
            )
        )
        ax.text(
            x + width / 2,
            y + height / 2,
            f"{col}{height:.0%}",
            ha="center",
            va="center",
            color="white",
        )
        y += height
        area += width * height
    ax.text(
        x + width / 2,
        -0.08,
        f"{row.渠道}({total}人)",
        ha="center",
    )
    x += width
assert np.isclose(area, 1)
ax.set(
    xlim=(0, 1), ylim=(-0.15, 1), xticks=[], ylabel="组内比例"
)
ax.grid(False)
finish(
    23,
    "马赛克图同时看分组规模与组内占比",
    fig,
    df,
    {"总样本": int(grand)},
)
别忽略: 这是两个分母配合工作的图。不能让列宽也表示付费比例,否则面积会把比例平方放大。需要精确比较转化率时,另画点图或条形图通常更轻松。
24|华夫图:华夫图把百分数还原成一百个格子
工具:Matplotlib。
一百项等权任务中,63 项完成、22 项进行中、15 项未开始。把一百个格子分别染色,读者可以把 63% 理解成每一百个里面有六十三个。
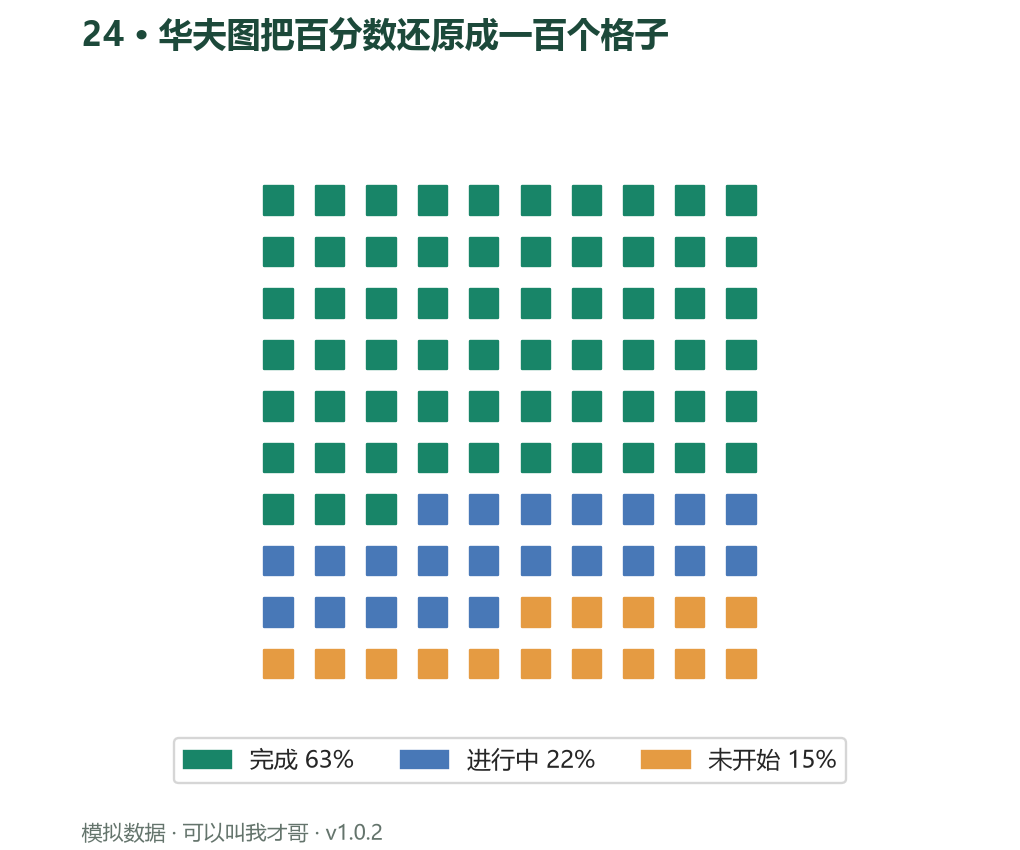
看图结果: 前 63 格表示完成,随后 22 格表示进行中,最后 15 格表示未开始,全部 100 格都被分配。
实现思路: np.repeat 按数量生成类别编号,再用整除与取余把它放进 10 乘 10 的方阵。所有格子完全相同,所以颜色承担状态含义,面积承担比例含义。
"""案例 24:华夫图把百分数还原成一百个格子 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from matplotlib.patches import Patch

rng, fig, ax = start(24, "", size=(6, 5))
df = pd.DataFrame(
    {
        "状态": ["完成", "进行中", "未开始"],
        "百分比": [63, 22, 15],
    }
)
classes = np.repeat(np.arange(3), df.百分比)
k = np.arange(100)
ax.scatter(
    k % 10,
    k // 10,
    c=[COLORS[i] for i in classes],
    s=145,
    marker="s",
)
ax.set(aspect="equal", xlim=(-1, 10), ylim=(-1, 10))
ax.invert_yaxis()
ax.axis("off")
ax.legend(
    handles=[
        Patch(color=COLORS[i], label=f"{r.状态}{r.百分比}%")
        for i, r in enumerate(df.itertuples())
    ],
    loc="upper center",
    bbox_to_anchor=(0.5, -0.02),
    ncol=3,
    fontsize=10,
)
assert len(classes) == 100
finish(24, "华夫图把百分数还原成一百个格子", fig, df)
别忽略: 当前数据刚好是整数百分比,没有舍入问题。面对 63.4% 这类值,要说明取整策略,或者增加格子数量;任务权重不同也不能直接一格一任务解释工作量完成率。
25|漏斗图:漏斗图先确定同一批用户与观察窗口
工具:Plotly。
假设跟踪同一批一万名访问用户,观察七天内有多少人依次注册、激活、付费。漏斗把每个阶段的剩余人数排在一起,帮助定位主要流失环节。
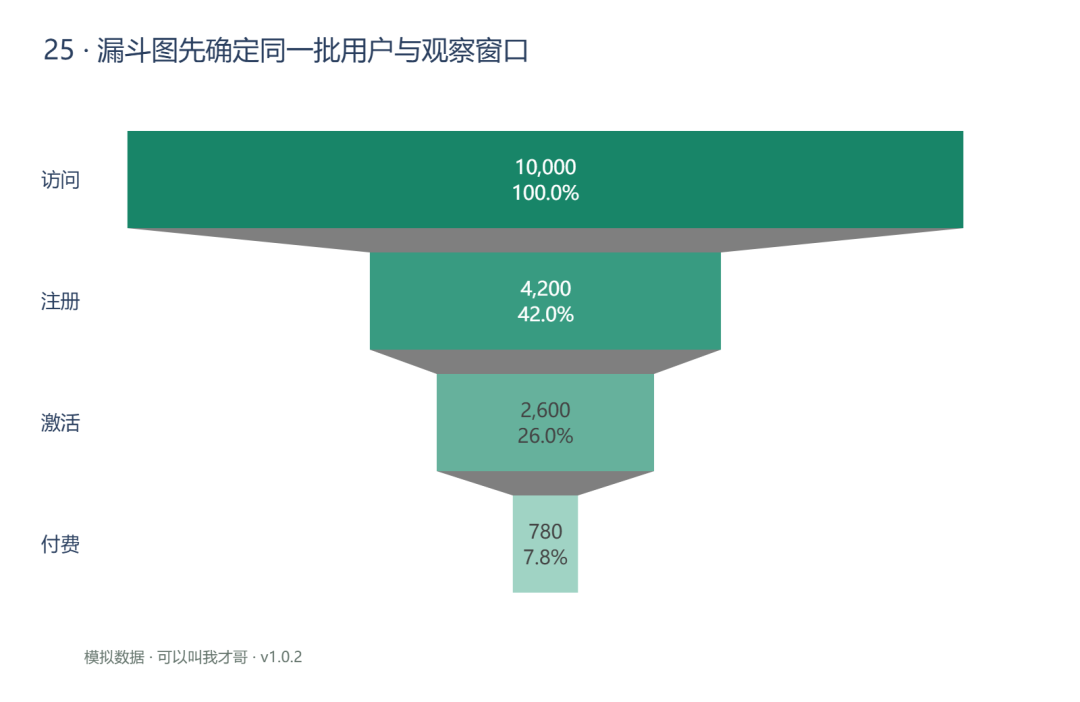
看图结果: 访问到付费是 780/10000=7.8%;激活到付费则是 780/2600=30%,两种比例不能互换。
实现思路: 每层宽度对应人数,图内同时写绝对值与相对最初访问用户的比例。数据要求非递增,代码会先检查这一点,但数量递减本身并不能证明已经正确去重。
"""案例 25:漏斗图先确定同一批用户与观察窗口 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.graph_objects as go

df = pd.DataFrame(
    {
        "阶段": ["访问", "注册", "激活", "付费"],
        "人数": [10000, 4200, 2600, 780],
    }
)
assert (df.人数.diff().dropna() <= 0).all()
fig = go.Figure(
    go.Funnel(
        y=df.阶段,
        x=df.人数,
        texttemplate="%{value:,.0f}<br>%{percentInitial:.1%}",
        marker=dict(
            color=["#188568", "#389B81", "#66B19C", "#A0D3C4"]
        ),
    )
)
fig.update_layout(
    xaxis_title="人数:同一批访问用户,7天转化窗口"
)
finish(
    25,
    "漏斗图先确定同一批用户与观察窗口",
    fig,
    df,
    {
        "总转化率": 0.078,
        "注册到激活": 2600 / 4200,
        "激活到付费": 0.3,
    },
)
别忽略: 总转化率和相邻转化率是两个问题。这里最终付费占初始访问的 7.8%,而激活到付费是 30%;不要把当月注册人数与当月全部老客付费人数直接拼成同一漏斗。
交互版在资料包 outputs/25_v1.0.2.html,可在本地浏览器打开。
理解分布与密度 · 26—34
26|直方图:直方图,先看长尾再谈平均值
工具:Matplotlib。
学习会话时长通常右偏:大多数会话较短,少数特别长。我们用对数正态分布模拟 800 次会话,先观察形状,再决定用什么统计量概括。
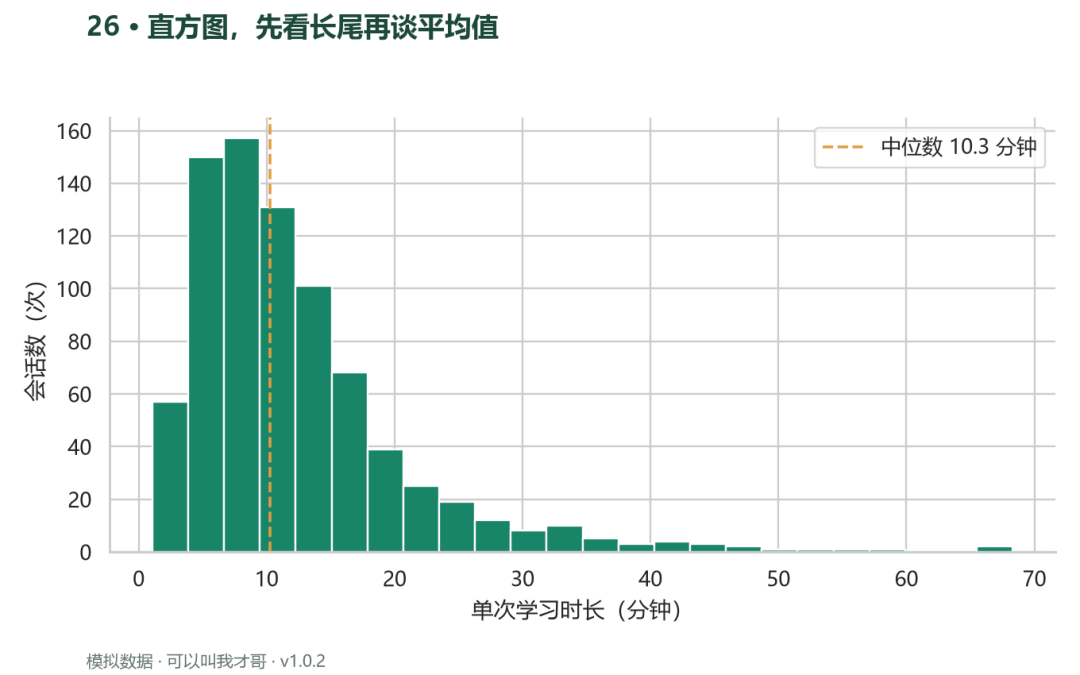
看图结果: 800 次会话的均值为 12.36 分钟,中位数为 10.27 分钟,长尾将均值向右拉。
实现思路: hist 把连续时长切成 24 个等宽区间,柱高表示区间内的会话数量。虚线标中位数,代码核对所有柱子的频数之和是否等于 800,确认没有把尾部悄悄丢掉。
"""案例 26:直方图,先看长尾再谈平均值 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(26, "")
df = pd.DataFrame({"时长": rng.lognormal(2.3, 0.65, 800)})
counts, bins, _ = ax.hist(
    df.时长, bins=24, color=COLORS[0], edgecolor="white"
)
ax.axvline(
    df.时长.median(),
    color=COLORS[2],
    ls="--",
    label=f"中位数 {df.时长.median():.1f} 分钟",
)
assert counts.sum() == len(df)
ax.set(xlabel="单次学习时长(分钟)", ylabel="会话数(次)")
ax.legend()
finish(
    26,
    "直方图,先看长尾再谈平均值",
    fig,
    df,
    {
        "均值": df.时长.mean(),
        "中位数": df.时长.median(),
        "直方图计数": counts.sum(),
    },
)
别忽略: 直方图的横轴是连续区间,不是任意类别。分箱数量会改变外观,解释双峰或断层前应尝试不同箱宽;均值被长尾拉高时,不宜单独用均值描述典型会话。
27|核密度估计:核密度曲线,带宽决定细节尺度
工具:Seaborn。
一组成绩混合了两个水平的样本,我们画三条不同带宽的核密度曲线,看看双峰究竟有多稳定。它是在观测值周围平滑分配密度,不是在统计每个分数的人数。
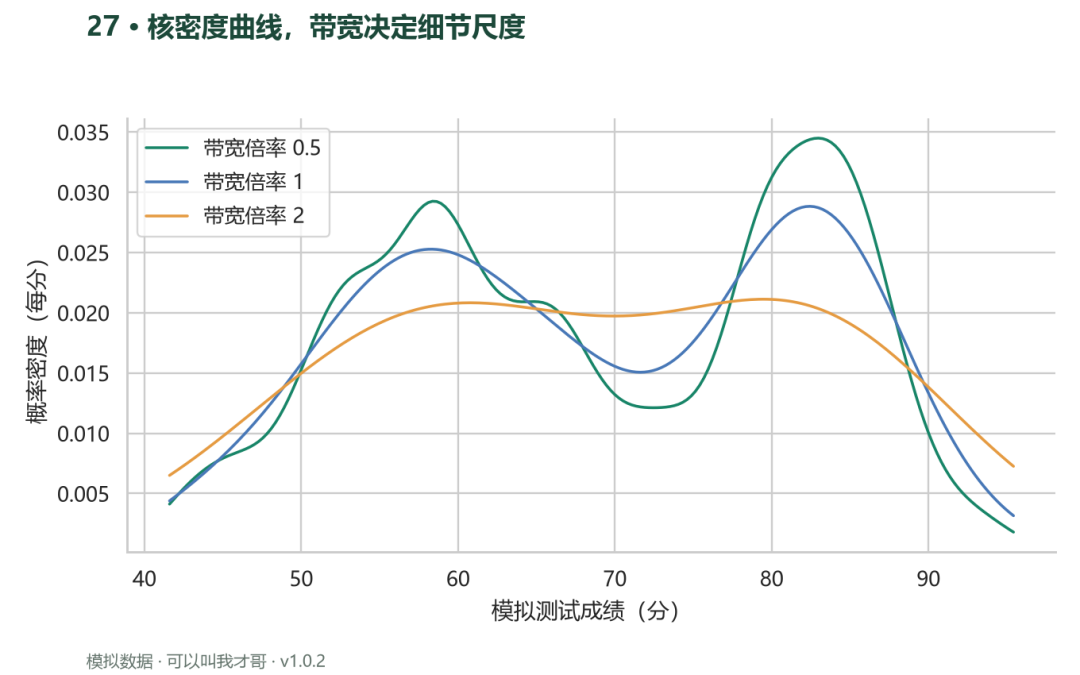
看图结果: 带宽倍率 0.5 保留更明显的局部双峰,倍率 2 将两个群体平滑得更接近一个宽峰。
实现思路: bw_adjust 越小,局部起伏越多;越大,曲线越平滑,也越容易合并两个峰。三条线来自同一份数据,改变的只有平滑参数,这样才能比较参数的影响。
"""案例 27:核密度曲线,带宽决定细节尺度 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(27, "")
df = pd.DataFrame(
    {
        "成绩": np.r_[
            rng.normal(58, 7, 220), rng.normal(82, 5, 180)
        ]
    }
)
for bw, color in zip([0.5, 1, 2], COLORS):
    sns.kdeplot(
        data=df,
        x="成绩",
        bw_adjust=bw,
        cut=0,
        ax=ax,
        label=f"带宽倍率 {bw}",
        color=color,
    )
ax.set(xlabel="模拟测试成绩(分)", ylabel="概率密度(每分)")
ax.legend()
finish(27, "核密度曲线,带宽决定细节尺度", fig, df)
别忽略: 纵轴是概率密度,不是百分比,某个具体分数上的高度不等于该分数的概率。cut=0 只限制绘制范围,不等于边界偏差已被修正;有严格上下界的数据需要额外考虑估计方法。
28|箱线图与异常候选:箱线图保留异常点,不替数据做决定
工具:Seaborn。
三个版本各有 101 次请求,其中包含少量特别慢的观测。箱线图用中位数、四分位数和须线压缩分布,同时保留须线外的点。
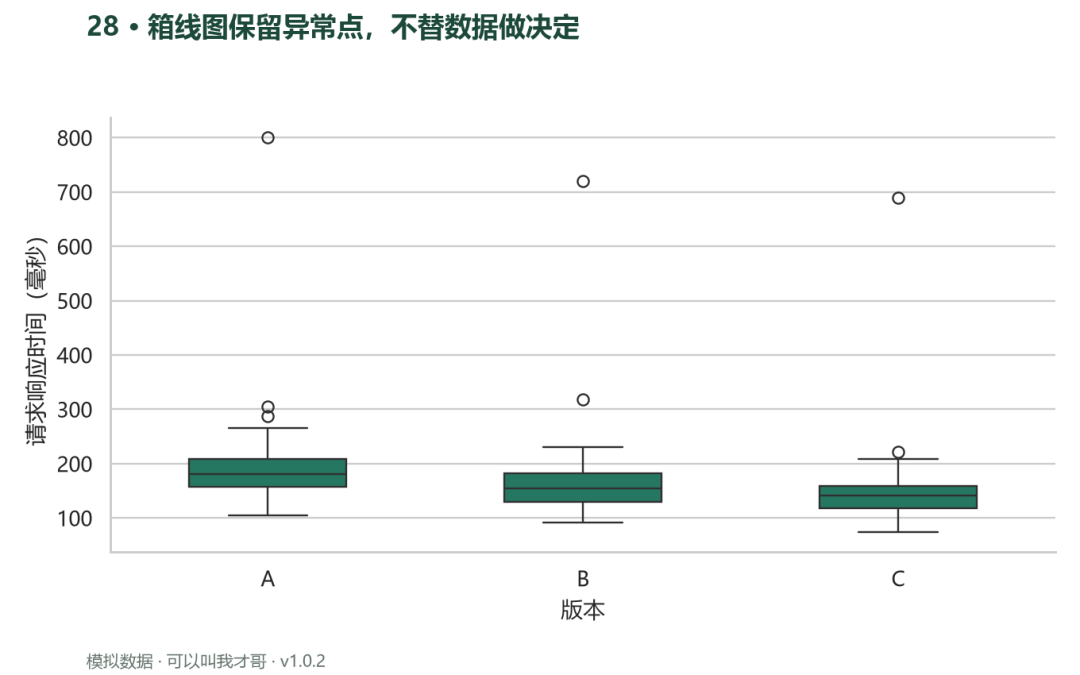
看图结果: 303 条请求全部保留,IQR 规则标出 7 条候选异常。A/B/C 各自的 800、720、690 毫秒观测仍可见。
实现思路: 代码按版本计算 Q1、Q3 和 IQR,将超出 1.5 倍 IQR 围栏的记录标为候选异常。绘图仍使用全部 303 行,并在结果文件里同时写明原始行数、候选数量和删除数量 0。
"""案例 28:箱线图保留异常点,不替数据做决定 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(28, "")
df = pd.DataFrame(
    {
        "版本": np.repeat(["A", "B", "C"], 101),
        "响应": np.r_[
            rng.lognormal(5.2, 0.25, 100),
            800,
            rng.lognormal(5.0, 0.22, 100),
            720,
            rng.lognormal(4.9, 0.2, 100),
            690,
        ],
    }
)
sns.boxplot(
    data=df,
    x="版本",
    y="响应",
    ax=ax,
    color=COLORS[0],
    width=0.5,
    whis=1.5,
    showfliers=True,
)
flags = []
for name, g in df.groupby("版本"):
    q1, q3 = g.响应.quantile([0.25, 0.75])
    iqr = q3 - q1
    flags.extend(
        (
            (g.响应 < q1 - 1.5 * iqr)
            | (g.响应 > q3 + 1.5 * iqr)
        ).tolist()
    )
df["IQR候选异常"] = flags
ax.set(xlabel="版本", ylabel="请求响应时间(毫秒)")
finish(
    28,
    "箱线图保留异常点,不替数据做决定",
    fig,
    df,
    {
        "原始行数": len(df),
        "删除行数": 0,
        "候选异常数": sum(flags),
    },
)
别忽略: 候选异常可能是真实的慢请求,不能为让箱体显得整齐而反复删除。IQR 规则不是显著性检验,箱体分开也不能直接推出版本改动造成了性能改善。
29|小提琴图:小提琴图识别中位数背后的双峰
工具:Seaborn。
两班平均水平可能接近,但甲班集中在中间,乙班混合高分和低分。小提琴图把分布密度展开到左右两侧,能把这个差别显露出来。
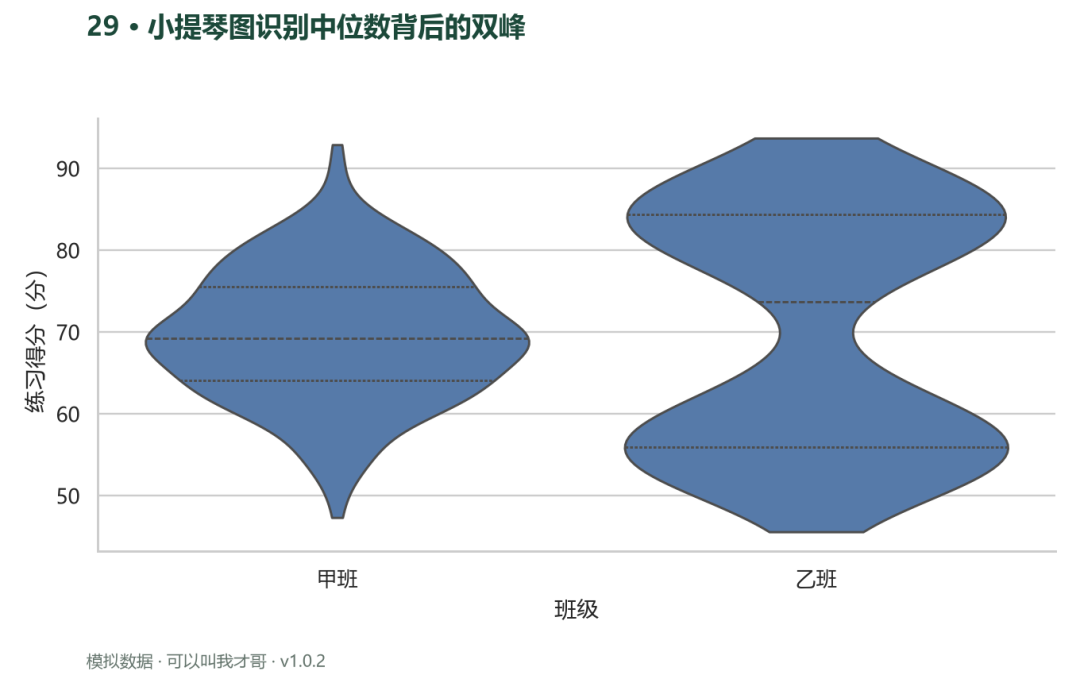
看图结果: 甲班主要集中在 70 分附近,乙班在 56 分和 84 分附近形成两个峰。一个中位数无法说明这两种结构的差别。
实现思路: 本例每班 240 人,内部虚线显示四分位数,cut=0 避免把图形尾部延伸到观测范围之外。density_norm='width' 把最大宽度对齐,方便比较形状。
"""案例 29:小提琴图识别中位数背后的双峰 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(29, "")
df = pd.DataFrame(
    {
        "班级": np.repeat(["甲班", "乙班"], 240),
        "得分": np.r_[
            rng.normal(70, 8, 240),
            rng.normal(56, 4, 120),
            rng.normal(84, 4, 120),
        ],
    }
)
sns.violinplot(
    data=df,
    x="班级",
    y="得分",
    cut=0,
    inner="quart",
    density_norm="width",
    ax=ax,
    color=COLORS[1],
)
ax.set(ylabel="练习得分(分)")
finish(29, "小提琴图识别中位数背后的双峰", fig, df)
别忽略: 宽度归一化之后不能拿两个小提琴的面积比较人数,尤其在样本量不同时。密度形状受带宽影响,最好同时查看原始点、直方图或分位数,而不是只凭轮廓给人群贴标签。
30|蜂群图:蜂群图让小样本逐个露面
工具:Seaborn。
每组只有 35 位参与者时,直接展示每个人的耗时比只给均值更有信息。蜂群图把靠得太近的点横向错开,让重叠值也能被看到。
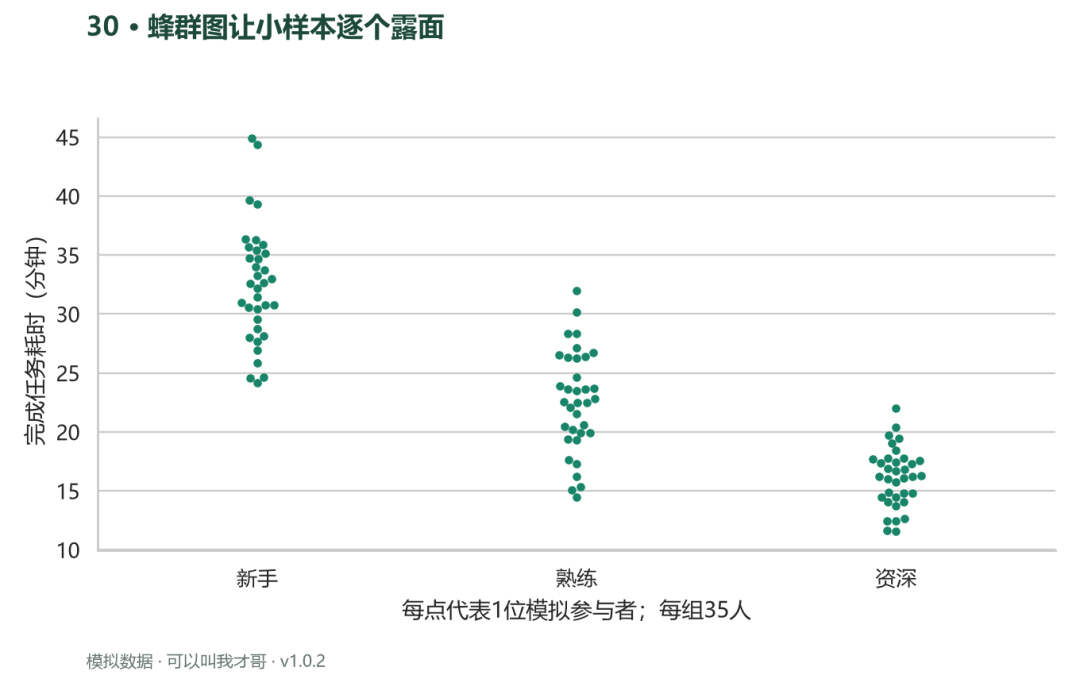
看图结果: 三个组各 35 个点,新手整体耗时较高,但组间仍有重叠,不能将组名视为对个体耗时的确定判断。
实现思路: 纵向位置始终保留真实耗时,横向偏移只是避让布局,不是另一个变量。数据量不大、点尺寸适中时,这种排布能兼顾分组与个体差异。
"""案例 30:蜂群图让小样本逐个露面 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(30, "")
df = pd.DataFrame(
    {
        "组别": np.repeat(["新手", "熟练", "资深"], 35),
        "耗时": np.r_[
            rng.normal(32, 5, 35),
            rng.normal(23, 4, 35),
            rng.normal(17, 3, 35),
        ],
    }
)
sns.swarmplot(
    data=df,
    x="组别",
    y="耗时",
    size=4.5,
    ax=ax,
    color=COLORS[0],
)
ax.set(
    ylabel="完成任务耗时(分钟)",
    xlabel="每点代表1位模拟参与者;每组35人",
)
finish(30, "蜂群图让小样本逐个露面", fig, df)
别忽略: 蜂群并不适合无限增加样本。点太多会出现无法排开的警告,此时应减小点、增加画布或改用透明散点与分布图;不能忽略警告后仍声称每个点都清楚可见。
31|人口金字塔式镜像图:镜像条形图比较两类用户年龄结构
工具:Matplotlib。
把新客放左、老客放右,可以逐年龄段比较两类用户的规模。这里借用人口金字塔的镜像结构,实际展示的是虚构产品用户,而不是人口统计数据。
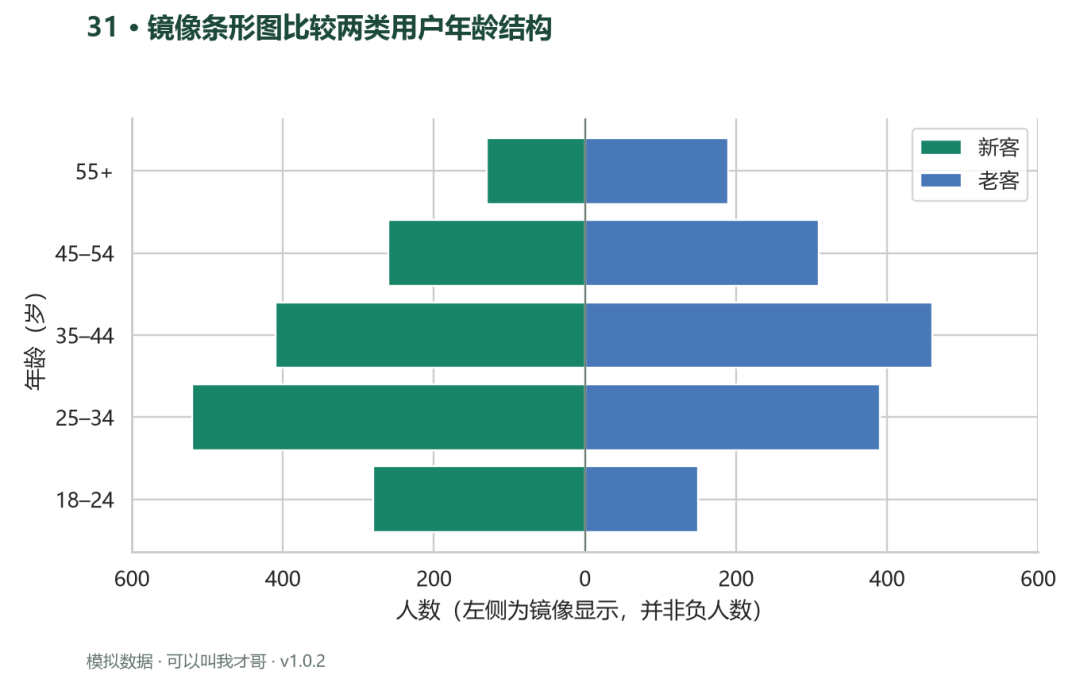
看图结果: 新客 25–34 岁为 520 人,老客同段 390 人;35–44 岁则是老客 460 人多于新客 410 人。
实现思路: 左侧用负坐标完成镜像,但刻度格式化为绝对值,明确说明没有负人数。左右使用相同范围,年龄段按自然顺序排列,避免排序破坏年龄结构。
"""案例 31:镜像条形图比较两类用户年龄结构 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from matplotlib.ticker import FuncFormatter

rng, fig, ax = start(31, "")
df = pd.DataFrame(
    {
        "年龄": ["18–24", "25–34", "35–44", "45–54", "55+"],
        "新客": [280, 520, 410, 260, 130],
        "老客": [150, 390, 460, 310, 190],
    }
)
ax.barh(df.年龄, -df.新客, label="新客")
ax.barh(df.年龄, df.老客, label="老客")
ax.axvline(0, color="#708078", lw=1)
ax.set_xlim(-600, 600)
ax.xaxis.set_major_formatter(
    FuncFormatter(lambda x, pos: f"{abs(x):.0f}")
)
ax.set(
    xlabel="人数(左侧为镜像显示,并非负人数)",
    ylabel="年龄(岁)",
)
ax.legend()
finish(31, "镜像条形图比较两类用户年龄结构", fig, df)
别忽略: 原始人数与组内比例是两种不同问题。本例比较人数,如果新客和老客总量差异很大而目标是比较年龄结构,应先分别归一化,并把两组分母写出来。
32|六边形分箱:六边形分箱,把遮挡变成密度
工具:Matplotlib。
七千个点叠在一起,最密集的区域可能只剩一团实心颜色。六边形分箱把平面划成小格,用颜色表示每格的观测数量,保留密集程度。
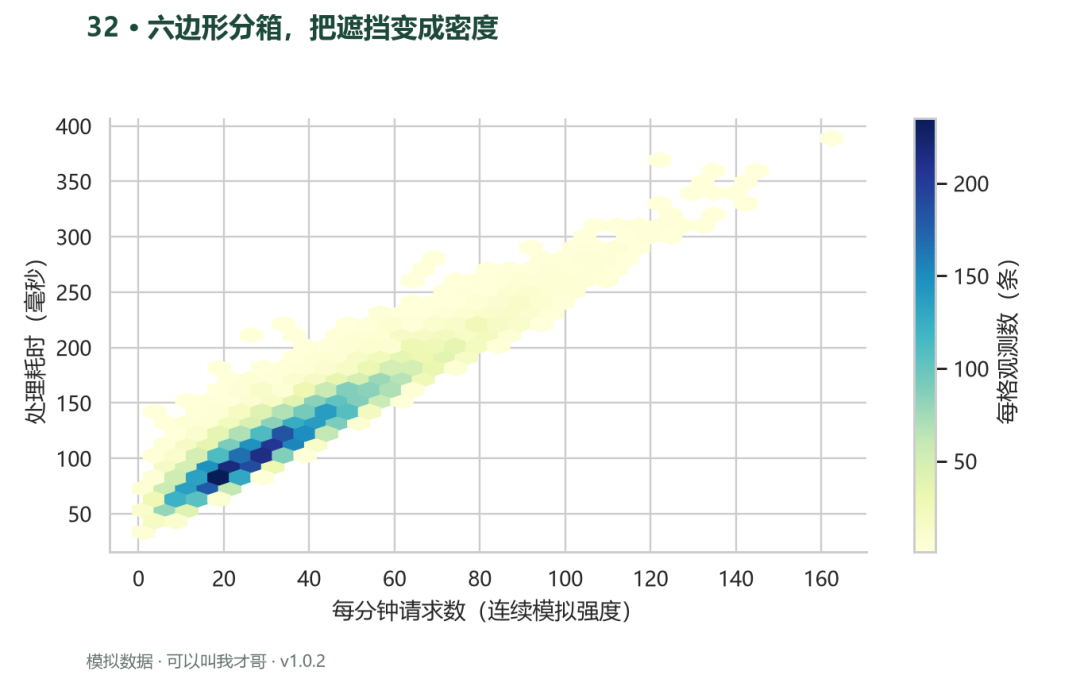
看图结果: 六边形计数之和为 7000,全部处理耗时大于零。密集区与少量高请求强度样本都被保留下来。
实现思路: gridsize 控制分箱精细度,mincnt=1 隐藏空格,颜色条给出实际计数。代码还核对所有格子计数之和等于 7000,确认每条观测都被计入。
"""案例 32:六边形分箱,把遮挡变成密度 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(32, "")
x = rng.gamma(3, 12, 7000)
y = 25 + 2.1 * x + rng.gamma(3, 9, 7000)
assert (y > 0).all()
df = pd.DataFrame({"请求数": x, "耗时": y})
h = ax.hexbin(
    df.请求数, df.耗时, gridsize=32, mincnt=1, cmap="YlGnBu"
)
fig.colorbar(h, ax=ax, label="每格观测数(条)")
assert h.get_array().sum() == len(df)
ax.set(
    xlabel="每分钟请求数(连续模拟强度)",
    ylabel="处理耗时(毫秒)",
)
finish(
    32,
    "六边形分箱,把遮挡变成密度",
    fig,
    df,
    {"分箱计数": h.get_array().sum()},
)
别忽略: 格子越小,局部细节越多,单格计数也越不稳定。本例的横轴是连续模拟的请求强度,不能把它当作整数事件计数;若使用对数颜色刻度,也要在图例中明确标注。
33|二维密度等高线:二维密度等高线,寻找两群样本
工具:Seaborn。
投入与产出的散点看起来分成两个团,我们用二维核密度估计描出高密度区域,再叠加少量透明原始点帮助核对。
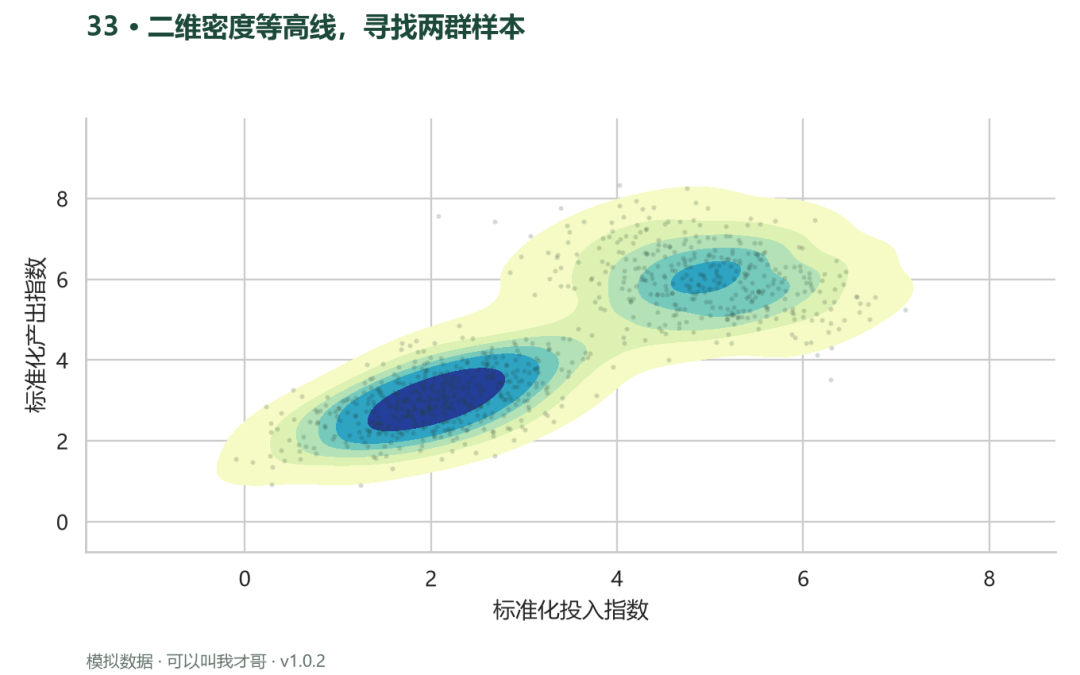
看图结果: 高密度区域大致位于(2,3)与(5,6)附近,与两组模拟分布的中心相符;色阶没有被解释为统计显著性。
实现思路: 等高线连接密度水平相同的位置,填色让不同密度层级更容易辨认。Seaborn 的 levels 参数在这里用于设置等概率质量层级,不能把某条轮廓直接读成回归置信边界。
"""案例 33:二维密度等高线,寻找两群样本 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(33, "")
a = rng.multivariate_normal(
    [2, 3], [[0.6, 0.3], [0.3, 0.6]], 450
)
b = rng.multivariate_normal(
    [5, 6], [[0.6, -0.2], [-0.2, 0.6]], 350
)
df = pd.DataFrame(np.vstack([a, b]), columns=["投入", "产出"])
sns.kdeplot(
    data=df,
    x="投入",
    y="产出",
    fill=True,
    levels=7,
    thresh=0.05,
    cmap="YlGnBu",
    ax=ax,
)
ax.scatter(df.投入, df.产出, s=3, c="#243E35", alpha=0.13)
ax.set(xlabel="标准化投入指数", ylabel="标准化产出指数")
finish(33, "二维密度等高线,寻找两群样本", fig, df)
别忽略: 两个密度峰不等于已经识别出两个真实客户群。带宽、尺度和抽样方式都会影响形状,要建立分群结论仍需要业务字段、稳定性检查及独立样本。
34|三维曲面:三维曲面只用于真实的第三个数值维度
工具:Plotly。
模拟一个二维平面上的温升场,每个 X、Y 位置都有对应的温升值。第三个轴承载真实数值,因此三维曲面在这个场景里有明确用途。
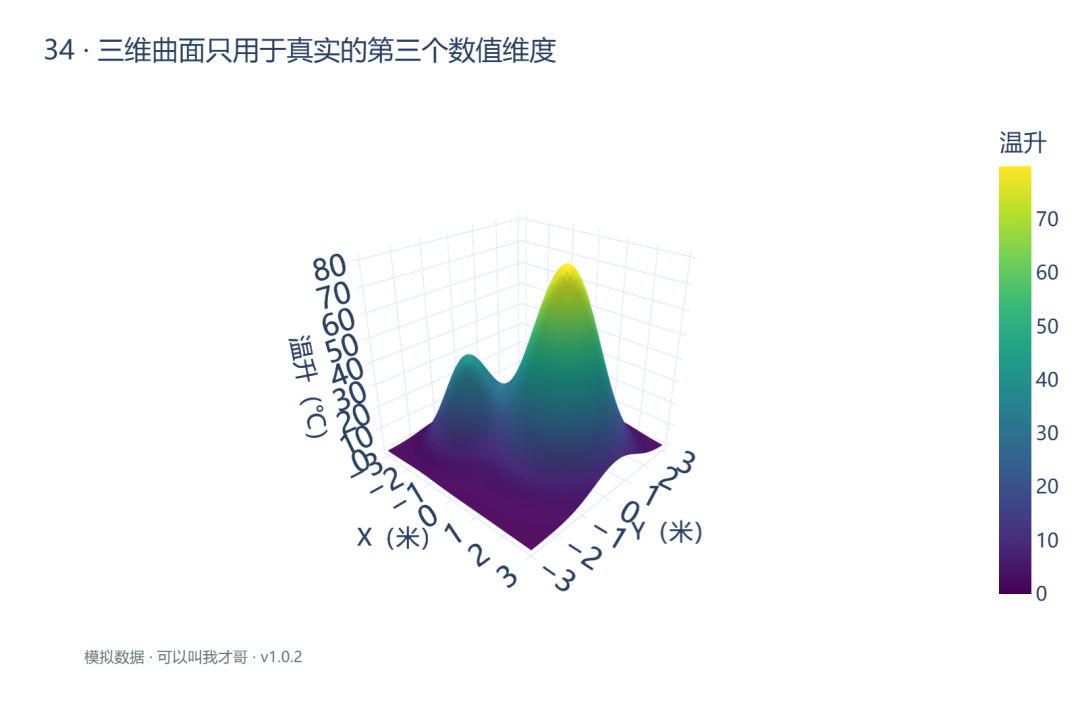
看图结果: 曲面包含两个热源,主峰靠近(1,0.5),另一个峰靠近(-1.4,-1)。高度与颜色都表示同一个温升变量。
实现思路: meshgrid 生成规则网格,两个高斯形状的热源叠加成温升,Surface 把每个网格位置连接成曲面。交互文件可以旋转,PNG 保留固定视角作为文章插图。
"""案例 34:三维曲面只用于真实的第三个数值维度 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.graph_objects as go

x = np.linspace(-3, 3, 55)
y = np.linspace(-3, 3, 55)
X, Y = np.meshgrid(x, y)
Z = 80 * np.exp(
    -((X - 1) ** 2 + (Y - 0.5) ** 2) / 2
) + 40 * np.exp(-((X + 1.4) ** 2 + (Y + 1) ** 2))
df = pd.DataFrame(
    {"X": X.ravel(), "Y": Y.ravel(), "温升": Z.ravel()}
)
fig = go.Figure(
    go.Surface(
        x=X,
        y=Y,
        z=Z,
        colorscale="Viridis",
        colorbar=dict(title="温升"),
    )
)
fig.update_layout(
    scene=dict(
        xaxis_title="X(米)",
        yaxis_title="Y(米)",
        zaxis_title="温升(℃)",
        camera=dict(eye=dict(x=1.6, y=-1.7, z=1.2)),
    )
)
finish(34, "三维曲面只用于真实的第三个数值维度", fig, df)
别忽略: 这是虚构场景的解析模拟,没有真实传感器或地理边界。三维透视会遮挡部分区域,比较精确位置值应配合悬浮提示或二维等高线;普通柱状图不需要额外加一层立体透视。
交互版在资料包 outputs/34_v1.0.2.html,可在本地浏览器打开。
检查变量关联 · 35—39
35|散点与线性拟合:散点与回归线,不把相关写成因果
工具:Matplotlib + SciPy。
练习时长与测试成绩是否一起变化?我们构造 180 个观测,用散点显示每条记录,再用最小二乘直线概括线性关系。
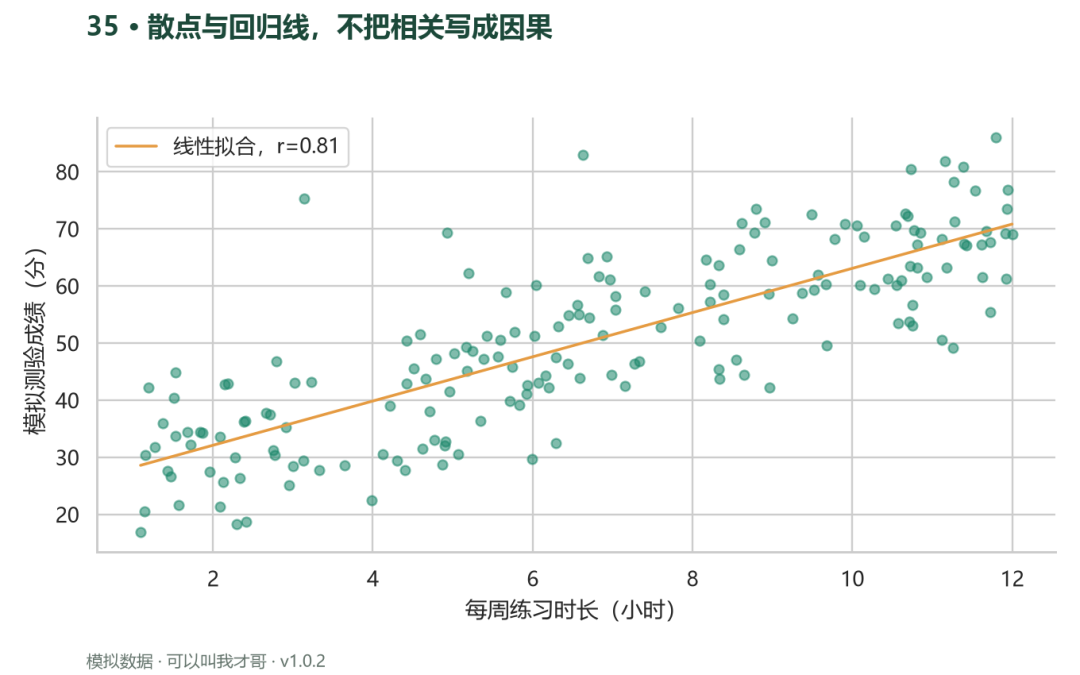
看图结果: 这批模拟样本的 Pearson r 为 0.809,拟合斜率约 3.87 分/小时,只描述当前生成数据的线性关联。
实现思路: linregress 返回斜率、截距和相关系数,图例报告 r。拟合线只覆盖已有数据范围,不把直线随意延长到零小时以下或极高时长处。
"""案例 35:散点与回归线,不把相关写成因果 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from scipy.stats import linregress

rng, fig, ax = start(35, "")
x = rng.uniform(1, 12, 180)
y = 22 + 4.2 * x + rng.normal(0, 9, 180)
df = pd.DataFrame({"练习小时": x, "成绩": y})
fit = linregress(x, y)
ax.scatter(x, y, s=25, alpha=0.55)
xx = np.array([x.min(), x.max()])
ax.plot(
    xx,
    fit.intercept + fit.slope * xx,
    color=COLORS[2],
    label=f"线性拟合,r={fit.rvalue:.2f}",
)
ax.set(
    xlabel="每周练习时长(小时)", ylabel="模拟测验成绩(分)"
)
ax.legend()
finish(
    35,
    "散点与回归线,不把相关写成因果",
    fig,
    df,
    {
        "Pearson_r": fit.rvalue,
        "斜率": fit.slope,
        "说明": "生成机制预设正相关,非实验因果结论",
    },
)
别忽略: 这个正相关是模拟公式主动设置的,不是任何教育效果证据。真实分析还要检查非线性、异常观测、共同原因和样本选择,r 较高也不意味着可以直接宣称练习造成相同幅度的成绩提升。
36|多变量气泡图:气泡图同时看成本、质量和使用规模
工具:Plotly。
比较十二个方案时,质量与成本决定二维位置,用户数决定气泡面积,类型决定颜色。这样可以同时观察高质量低成本区域,以及这些方案当前的使用规模。
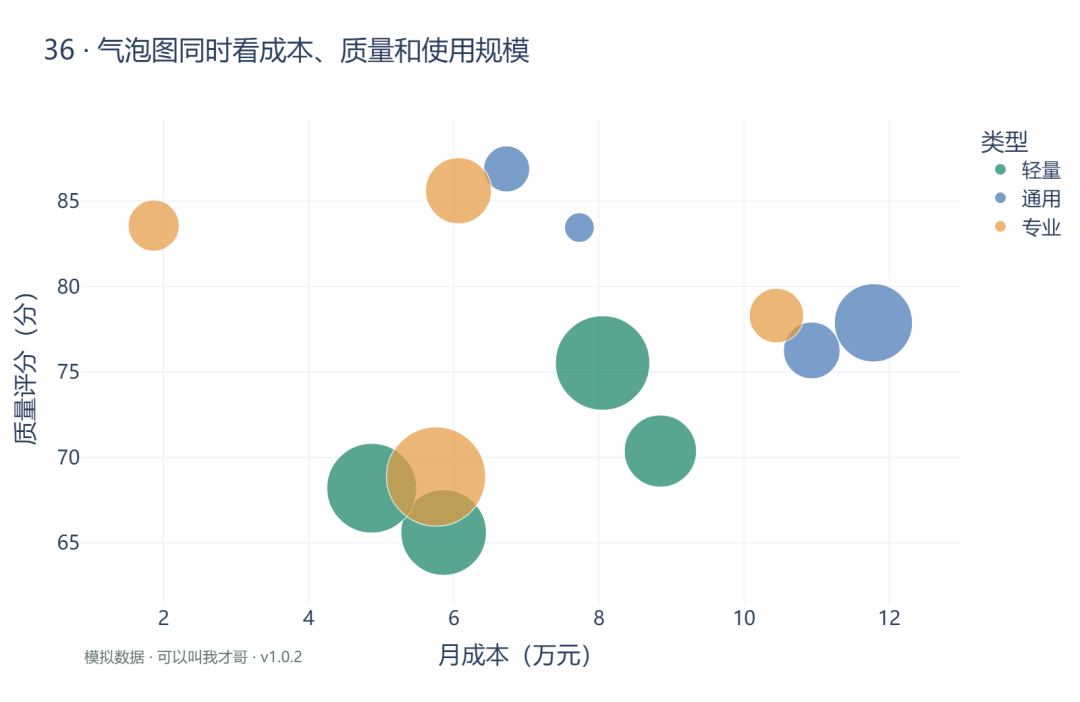
看图结果: 左上角表示相对低成本、高评分的方案,大气泡表示更多用户。三种视觉含义相互独立,不能只追着最大气泡选。
实现思路: Plotly 按 size 字段生成面积映射,代码显式保留 sizemode='area'。方案名称放进悬浮提示,静态图片避免把十二个标签全部压在气泡上。
"""案例 36:气泡图同时看成本、质量和使用规模 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.express as px

rng = np.random.default_rng(20260949)
df = pd.DataFrame(
    {
        "方案": [f"方案{i}" for i in range(1, 13)],
        "月成本": rng.uniform(1, 12, 12),
        "质量": rng.uniform(65, 96, 12),
        "用户数": rng.integers(100, 3000, 12),
        "类型": np.repeat(["轻量", "通用", "专业"], 4),
    }
)
fig = px.scatter(
    df,
    x="月成本",
    y="质量",
    size="用户数",
    color="类型",
    hover_name="方案",
    size_max=65,
    labels={
        "月成本": "月成本(万元)",
        "质量": "质量评分(分)",
    },
    color_discrete_sequence=COLORS,
)
fig.update_traces(marker_sizemode="area", marker_opacity=0.72)
finish(36, "气泡图同时看成本、质量和使用规模", fig, df)
别忽略: 大气泡代表用户多,不代表质量高,也不代表更适合当前需求。面积仍是较难精确比较的通道,具体人数以交互提示和 CSV 为准,颜色类别也不构成优劣排序。
交互版在资料包 outputs/36_v1.0.2.html,可在本地浏览器打开。
37|散点矩阵:散点矩阵快速筛查多变量关系
工具:Seaborn。
有投入、产出、等待、经验四个变量时,可以先用散点矩阵扫描两两关系。对角线显示各变量自身分布,非对角线显示两个变量的联合观测。
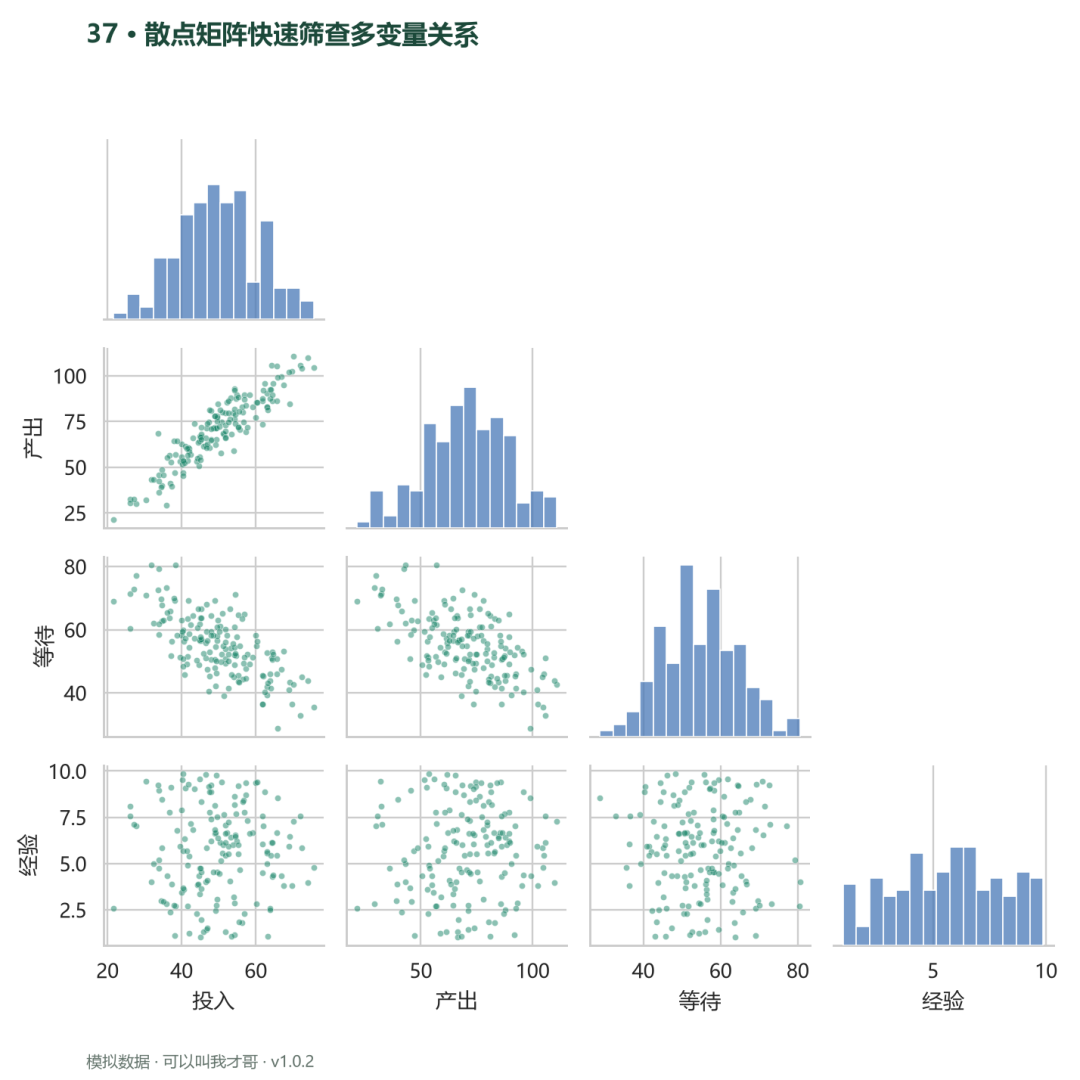
看图结果: 投入与产出呈正相关,投入与等待呈负相关;经验在这些模拟变量中没有被设置明显的关联。
实现思路: corner=True 只保留下三角,减少镜像重复;对角线采用直方图,避免在第一次探索时同时引入过多平滑参数。所有子图来自同一批 160 条完整记录。
"""案例 37:散点矩阵快速筛查多变量关系 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng = np.random.default_rng(20260950)
n = 160
x = rng.normal(50, 10, n)
df = pd.DataFrame(
    {
        "投入": x,
        "产出": 1.4 * x + rng.normal(0, 8, n),
        "等待": 90 - 0.7 * x + rng.normal(0, 7, n),
        "经验": rng.uniform(1, 10, n),
    }
)
g = sns.pairplot(
    df,
    corner=True,
    diag_kind="hist",
    height=2.1,
    plot_kws={"s": 12, "alpha": 0.5, "color": COLORS[0]},
    diag_kws={"bins": 15, "color": COLORS[1]},
)
finish(37, "散点矩阵快速筛查多变量关系", g.fig, df)
别忽略: 矩阵适合找下一步要研究的线索,不适合把每个格子都写成结论。变量一多,手机上会很拥挤,所以正文提供可放大的原图,真正报告时应挑出最关键的两三对关系单独画。
38|相关系数热力图:相关热力图保留正负方向
工具:Seaborn。
在散点筛查之后,用一张矩阵汇总线性相关程度。颜色以零为中点,正相关与负相关分居两侧,每格再写出具体 Pearson 相关系数。
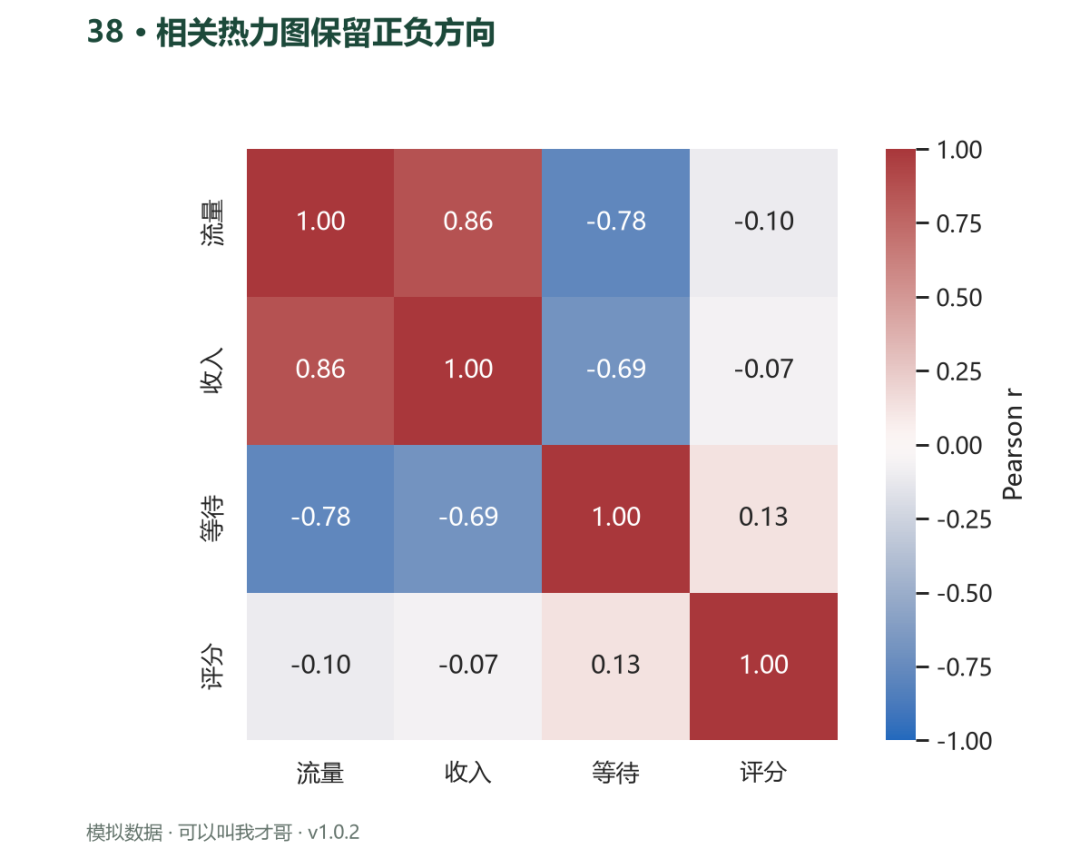
看图结果: 流量与收入的 r 约 0.86,与等待的 r 约 -0.78。固定 -1 到 1 的色阶保留了方向与强度。
实现思路: 固定 vmin=-1、vmax=1,保证不同图之间的颜色可比较;不能每张图根据局部极值拉满色阶,让很弱的相关看起来很强。代码检查矩阵对称、对角线为 1。
"""案例 38:相关热力图保留正负方向 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(38, "", size=(7, 5.5))
x = rng.normal(size=240)
df = pd.DataFrame(
    {
        "流量": x,
        "收入": 0.8 * x + rng.normal(0, 0.5, 240),
        "等待": -0.7 * x + rng.normal(0, 0.6, 240),
        "评分": rng.normal(size=240),
    }
)
corr = df.corr(method="pearson")
sns.heatmap(
    corr,
    ax=ax,
    annot=True,
    fmt=".2f",
    vmin=-1,
    vmax=1,
    center=0,
    cmap="vlag",
    square=True,
    cbar_kws={"label": "Pearson r"},
)
assert np.allclose(corr, corr.T) and np.allclose(
    np.diag(corr), 1
)
finish(
    38,
    "相关热力图保留正负方向",
    fig,
    {"raw": df, "correlation": corr.reset_index()},
)
别忽略: 相关接近零不代表不存在关系,弯曲关系就可能被线性相关遗漏。真实数据还要说明缺失值处理、成对样本数和重复测量,不能只给一张彩色矩阵就省略数据口径。
39|分组揭示辛普森悖论:辛普森悖论,合并后关系为什么反转
工具:Matplotlib。
同一份数据,合在一起呈负相关,拆开后却都呈正相关,这并不矛盾。本例让困难任务投入更久但整体得分更低,同时在每种难度内部保留投入越多得分越高的趋势。
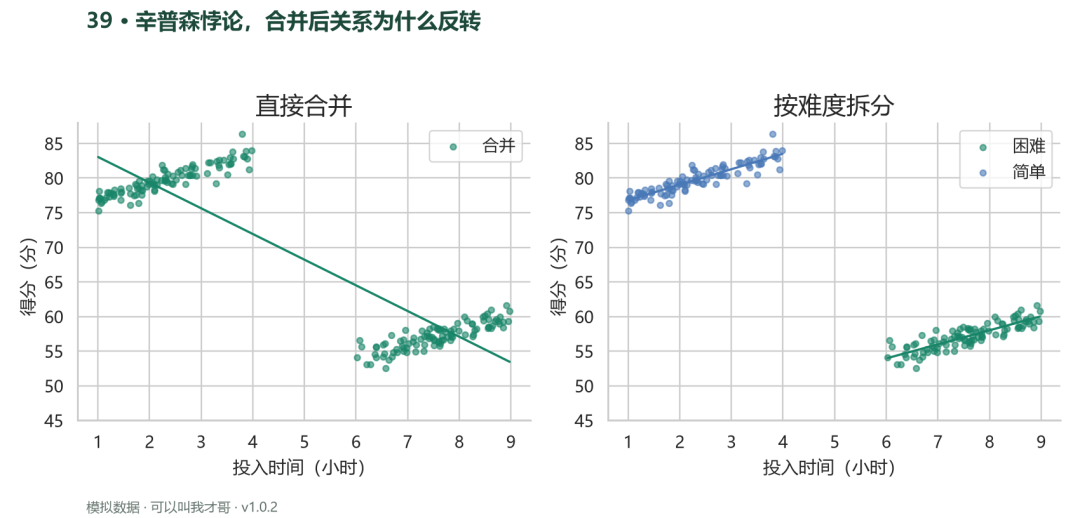
看图结果: 合并 r=-0.895;简单任务 r=0.907,困难任务 r=0.853。关系反转已经在实际输出中核对。
实现思路: 左图把两组混在一起,右图按任务难度分别着色并拟合。代码检查合并相关系数小于零、两个分组相关系数都大于零,确保反转确实发生,而不是只写了一个悖论标题。
"""案例 39:辛普森悖论,合并后关系为什么反转 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, axes = start(39, "", size=(10, 4.8), ncols=2)
x1 = rng.uniform(1, 4, 100)
x2 = rng.uniform(6, 9, 100)
df = pd.DataFrame(
    {
        "投入": np.r_[x1, x2],
        "得分": np.r_[
            75 + 2 * x1 + rng.normal(0, 1, 100),
            42 + 2 * x2 + rng.normal(0, 1, 100),
        ],
        "任务": np.repeat(["简单", "困难"], 100),
    }
)
rs = {}
for ax, split in zip(axes, [False, True]):
    groups = df.groupby("任务") if split else [("合并", df)]
    for name, g in groups:
        ax.scatter(g.投入, g.得分, s=15, alpha=0.6, label=name)
        m, b = np.polyfit(g.投入, g.得分, 1)
        xx = np.array([g.投入.min(), g.投入.max()])
        ax.plot(xx, m * xx + b)
        rs[name] = g.投入.corr(g.得分)
    ax.set(
        xlabel="投入时间(小时)",
        ylabel="得分(分)",
        title="按难度拆分" if split else "直接合并",
        ylim=(45, 88),
    )
    ax.legend()
assert rs["合并"] < 0 and rs["简单"] > 0 and rs["困难"] > 0
finish(39, "辛普森悖论,合并后关系为什么反转", fig, df, rs)
别忽略: 关键是组间差异和组内关系混在了一起。看到关系反转时,应追查分组结构与样本权重;分组本身也不自动解决因果识别问题。
整理层级与流向 · 40—45
40|旭日图:旭日图从业务线逐层看到产品
工具:Plotly。
收入先分为学习和工具两条业务线,再分到六个产品。旭日图把层级放在同心环中,读者从内向外读到更细的产品。
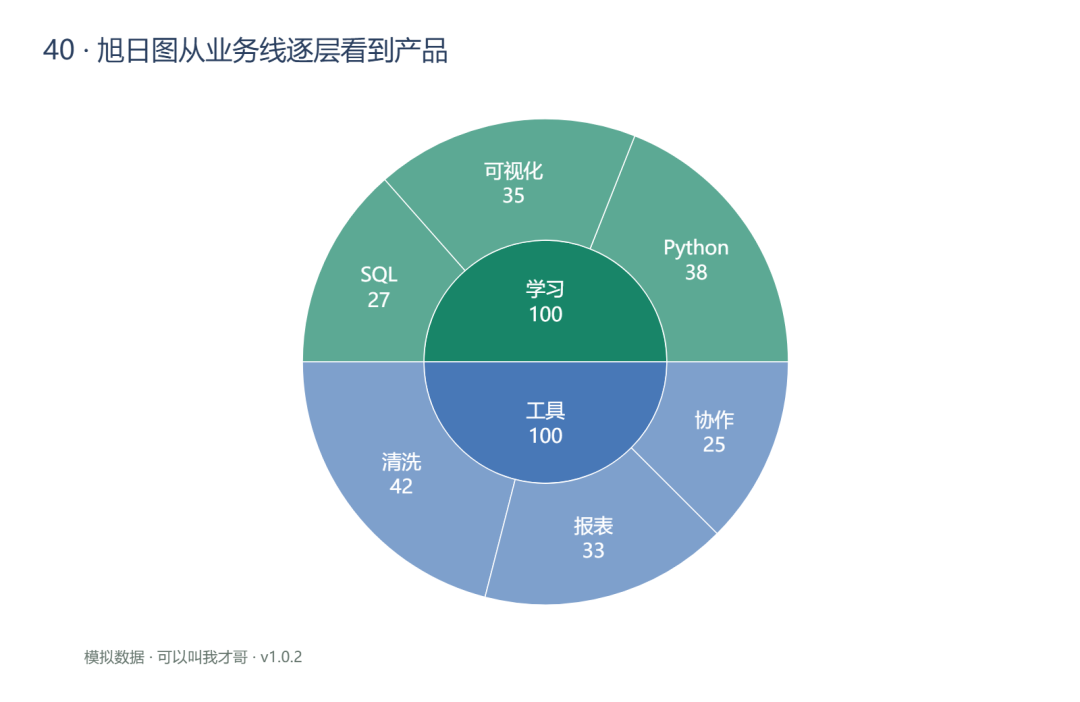
看图结果: 学习与工具业务各 100 万元,六个产品叶子节点合计 200 万元。父级金额来自叶子汇总,没有重复录入。
实现思路: 原始表只存叶子产品收入,path 定义业务到产品的层级,Plotly 据此汇总父级。这样可以避免把父级总额和子级金额放在同一层重复相加。
"""案例 40:旭日图从业务线逐层看到产品 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.express as px

df = pd.DataFrame(
    {
        "业务": [
            "学习",
            "学习",
            "学习",
            "工具",
            "工具",
            "工具",
        ],
        "产品": [
            "Python",
            "SQL",
            "可视化",
            "清洗",
            "报表",
            "协作",
        ],
        "收入": [38, 27, 35, 42, 33, 25],
    }
)
fig = px.sunburst(
    df,
    path=["业务", "产品"],
    values="收入",
    color="业务",
    color_discrete_sequence=COLORS,
)
fig.update_traces(
    textinfo="label+value", insidetextorientation="horizontal"
)
finish(
    40,
    "旭日图从业务线逐层看到产品",
    fig,
    df,
    {"叶子合计": int(df.收入.sum())},
)
别忽略: 每个产品必须有明确上级,重名产品最好使用唯一编号。扇区过小时,不要强塞所有标签;交互版适合展开查看,静态图更适合展示层级较浅、类别较少的结构。
交互版在资料包 outputs/40_v1.0.2.html,可在本地浏览器打开。
41|矩形树图:矩形树图展示空间占用的长尾
工具:Matplotlib + squarify。
服务器空间由日志、图片、视频、模型等目录占用。我们把每个目录画成一个面积与容量成比例的矩形,整个画布代表已列出的目录总量。
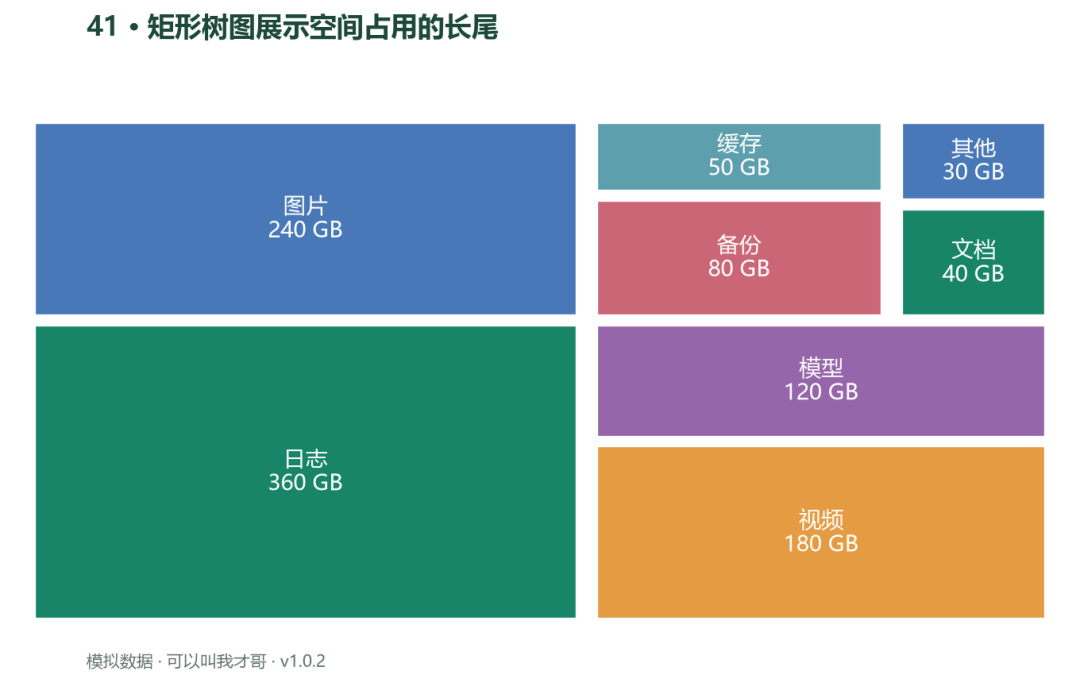
看图结果: 目录合计 1100 GB ,日志 360 GB 约占 32.7%。图片、视频与日志合计 780 GB,是主要空间占用来源。
实现思路: squarify 接收从大到小的正数容量,计算较容易阅读的矩形布局。这里展示单层目录,名称与 GB 数直接写进矩形,不假装存在未建模的多层文件树。
"""案例 41:矩形树图展示空间占用的长尾 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import squarify

rng, fig, ax = start(41, "")
df = pd.DataFrame(
    {
        "目录": [
            "日志",
            "图片",
            "视频",
            "模型",
            "备份",
            "缓存",
            "文档",
            "其他",
        ],
        "容量": [360, 240, 180, 120, 80, 50, 40, 30],
    }
).sort_values("容量", ascending=False)
squarify.plot(
    sizes=df.容量,
    label=[f"{r.目录}\n{r.容量} GB" for r in df.itertuples()],
    color=[COLORS[i % 6] for i in range(len(df))],
    ax=ax,
    pad=True,
    text_kwargs={"color": "white", "fontsize": 12},
)
ax.axis("off")
finish(
    41,
    "矩形树图展示空间占用的长尾",
    fig,
    df,
    {
        "总容量GB": int(df.容量.sum()),
        "最大占比": float(df.容量.max() / df.容量.sum()),
    },
)
别忽略: 颜色只帮助区分目录,不再编码另一个排序。数据必须是非负可加的量,软链接重复统计、父目录与子目录同时求和,都可能让磁盘占用被重复计算。
42|组织树:树图表达唯一上级的组织关系
工具:NetworkX + Matplotlib。
负责人下面分产品、技术、运营,每组再连接两个岗位。树图表达的是从上级到下级的关系,位置只是组织层次的排布。
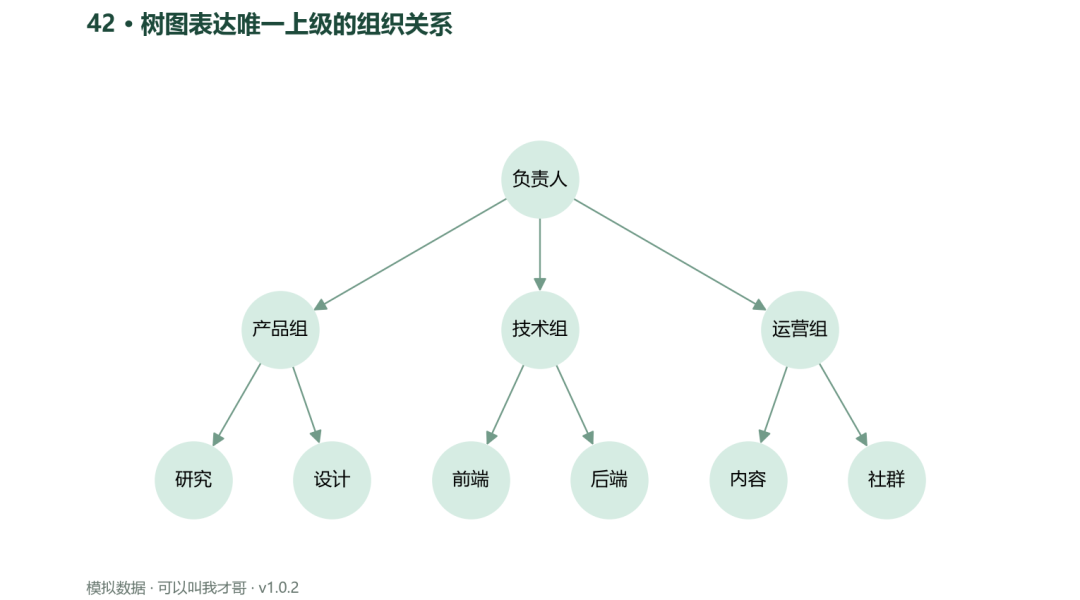
看图结果: 全图有 10 个节点、9 条上级到下级的边,只有负责人没有父节点,满足一棵有根树的结构。
实现思路: 用有向边建立 DiGraph,并检查它是否是有根有向树。布局显式安排每层坐标,节点间距和字体可以独立调整,比默认力导向布局更适合阅读组织结构。
"""案例 42:树图表达唯一上级的组织关系 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import networkx as nx

rng, fig, ax = start(42, "", size=(9, 5))
edges = [
    ("负责人", "产品组"),
    ("负责人", "技术组"),
    ("负责人", "运营组"),
    ("产品组", "研究"),
    ("产品组", "设计"),
    ("技术组", "前端"),
    ("技术组", "后端"),
    ("运营组", "内容"),
    ("运营组", "社群"),
]
df = pd.DataFrame(edges, columns=["上级", "下级"])
G = nx.DiGraph(edges)
pos = {
    "负责人": (0, 0),
    "产品组": (-3, -1),
    "技术组": (0, -1),
    "运营组": (3, -1),
    "研究": (-4, -2),
    "设计": (-2.4, -2),
    "前端": (-0.8, -2),
    "后端": (0.8, -2),
    "内容": (2.4, -2),
    "社群": (4, -2),
}
assert nx.is_arborescence(G)
nx.draw_networkx(
    G,
    pos,
    ax=ax,
    node_color="#D6ECE3",
    node_size=2100,
    font_family=FONT_NAME,
    font_size=11,
    arrows=True,
    arrowstyle="-|>",
    arrowsize=16,
    edge_color="#729B89",
)
ax.margins(0.18)
ax.axis("off")
finish(42, "树图表达唯一上级的组织关系", fig, df)
别忽略: 组织树隐含每个非根节点只有一个父节点。矩阵式汇报、跨部门协作、兼职关系不能不加说明地硬塞进一棵树,应改用一般有向网络或分别表达正式与协作关系。
43|关系网络:关系网络寻找跨团队的连接点
工具:NetworkX + Matplotlib。
两个团队内部紧密协作,通过一个协调节点与第三个小组连接。网络图把成员变成点、协作变成边,观察桥梁位置比把关系塞进名单更清楚。
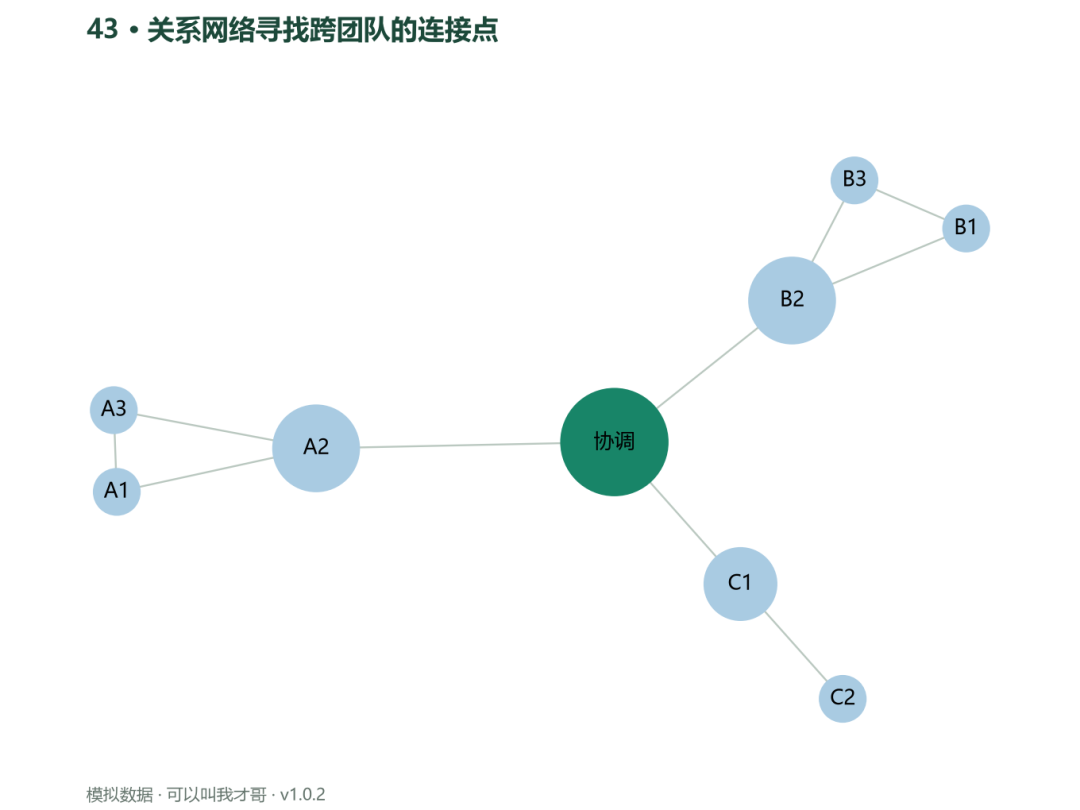
看图结果: 协调节点位于多个团队之间,连接结构使其中介中心性较高;这项图指标不等于对该成员绩效的评价。
实现思路: spring_layout 使用固定种子,让同一数据的布局可复现。节点面积随中介中心性增加,突出位于较多最短路径上的成员;原始边和节点指标分别导出。
"""案例 43:关系网络寻找跨团队的连接点 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import networkx as nx

rng, fig, ax = start(43, "", size=(8, 6))
edges = [
    ("A1", "A2"),
    ("A2", "A3"),
    ("A3", "A1"),
    ("B1", "B2"),
    ("B2", "B3"),
    ("B3", "B1"),
    ("A2", "协调"),
    ("协调", "B2"),
    ("协调", "C1"),
    ("C1", "C2"),
]
df = pd.DataFrame(edges, columns=["成员1", "成员2"])
G = nx.Graph(edges)
centrality = nx.betweenness_centrality(G)
pos = nx.spring_layout(G, seed=43)
nx.draw_networkx(
    G,
    pos,
    ax=ax,
    node_size=[600 + 3500 * centrality[n] for n in G],
    node_color=[
        COLORS[0] if n == "协调" else "#A9CBE2" for n in G
    ],
    font_family=FONT_NAME,
    font_size=11,
    edge_color="#BAC8C0",
)
ax.axis("off")
finish(
    43,
    "关系网络寻找跨团队的连接点",
    fig,
    {
        "edges": df,
        "nodes": pd.DataFrame(
            {
                "成员": list(G),
                "中介中心性": list(centrality.values()),
            }
        ),
    },
)
别忽略: 中介中心性描述图上的结构,不等同于工作绩效、正式权力或实际控制权。边在这里是无向的协作存在关系,没有表示频次,不能从线长推断协作距离。
44|有向邻接矩阵:邻接矩阵还原谁向谁发起协作
工具:Seaborn。
产品、研发、测试、运营、客服之间互相发起协作请求。将发起团队排在行、接收团队排在列,每个格子记录从行到列的次数。
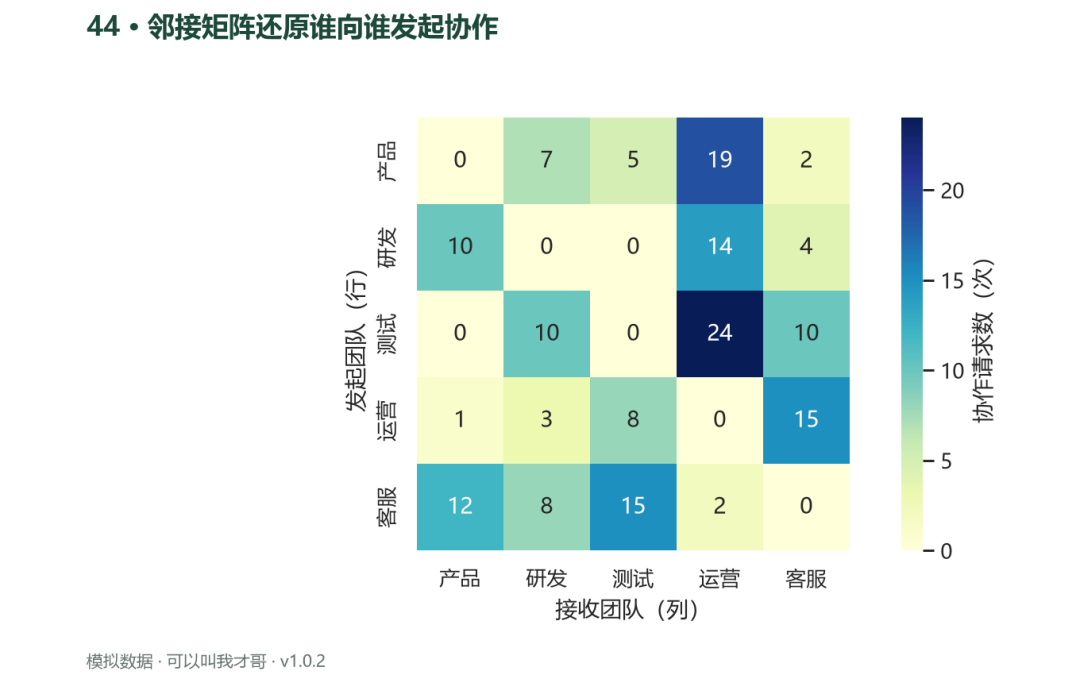
看图结果: 矩阵共记录 169 次跨团队请求;产品到研发为 7 次,研发到产品为 10 次,方向差异得到保留。
实现思路: 矩阵不强制对称,因为产品向研发请求 20 次,不意味着研发也向产品请求 20 次。对角线设为零,表示本例只研究跨团队请求,颜色与格内数字共同表达计数。
"""案例 44:邻接矩阵还原谁向谁发起协作 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(44, "")
names = ["产品", "研发", "测试", "运营", "客服"]
matrix = rng.integers(0, 26, (5, 5))
np.fill_diagonal(matrix, 0)
df = pd.DataFrame(matrix, columns=names, index=names)
sns.heatmap(
    df,
    annot=True,
    fmt="d",
    cmap="YlGnBu",
    ax=ax,
    cbar_kws={"label": "协作请求数(次)"},
    square=True,
)
ax.set(xlabel="接收团队(列)", ylabel="发起团队(行)")
finish(
    44,
    "邻接矩阵还原谁向谁发起协作",
    fig,
    df.rename_axis("发起团队").reset_index(),
    {"总请求": int(matrix.sum()), "有向": True},
)
别忽略: 这不是相关系数热力图,不存在 -1 到 1 的范围。箭头方向已经由行列承担,必须把方向写在轴标题上,避免读者把需求来源与承接对象读反。
45|桑基图:桑基图,流入流出必须对得上
工具:Plotly。
一千名用户从搜索和社群进入,部分注册,注册者再分成付费与未付费。桑基图用连线宽度表示流量,可以把渠道来源与后续去向放进同一条路径。
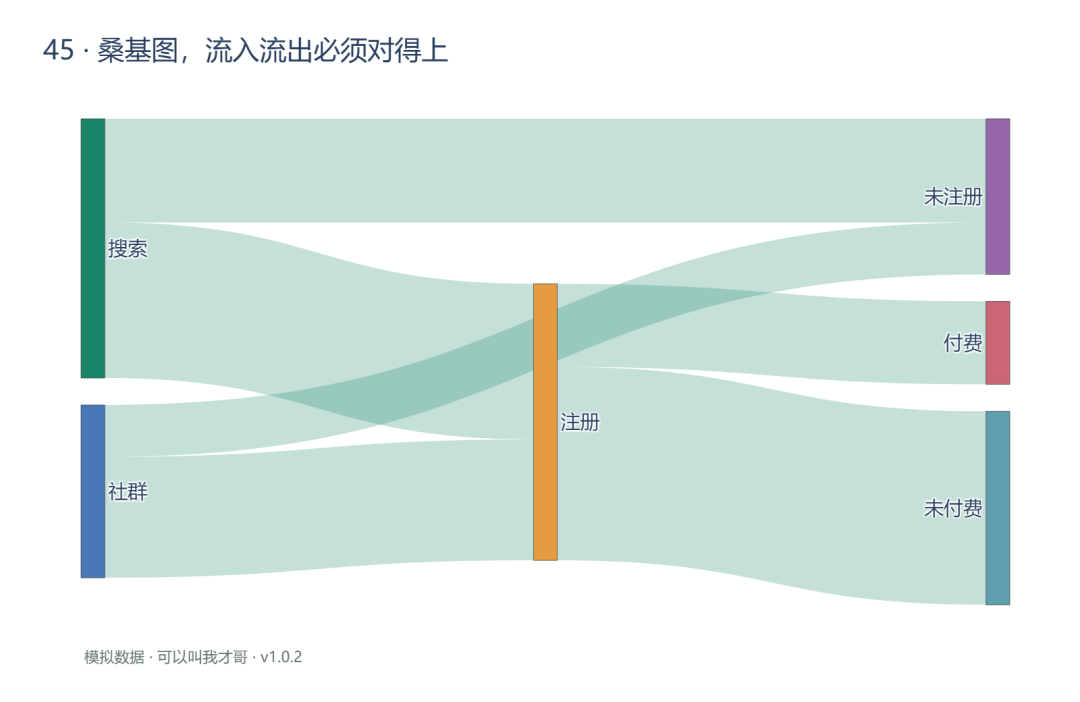
看图结果: 搜索 600 人、社群 400 人;640 人注册后,192 人付费、448 人未付费,另有 360 人在注册前结束路径。
实现思路: 边表使用 source、target 和 value,节点表单独保存编号与名称。注册节点的流入为 360 加 280,流出为 192 加 448,两侧都等于 640,代码会强制核对。
"""案例 45:桑基图,流入流出必须对得上 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

import plotly.graph_objects as go

labels = ["搜索", "社群", "注册", "未注册", "付费", "未付费"]
df = pd.DataFrame(
    {
        "source": [0, 0, 1, 1, 2, 2],
        "target": [2, 3, 2, 3, 4, 5],
        "value": [360, 240, 280, 120, 192, 448],
    }
)
assert (
    df.loc[df.target == 2, "value"].sum()
    == df.loc[df.source == 2, "value"].sum()
)
assert df.loc[df.source.isin([0, 1]), "value"].sum() == 1000
fig = go.Figure(
    go.Sankey(
        node=dict(
            label=labels, pad=25, thickness=22, color=COLORS
        ),
        link=dict(
            source=df.source,
            target=df.target,
            value=df.value,
            color="rgba(24,133,104,0.25)",
        ),
    )
)
finish(
    45,
    "桑基图,流入流出必须对得上",
    fig,
    {
        "edges": df,
        "nodes": pd.DataFrame(
            {"id": range(6), "label": labels}
        ),
    },
    {
        "源头人数": 1000,
        "注册人数": 640,
        "最终付费": 192,
        "守恒": True,
    },
)
别忽略: 未注册与未付费是终点,要作为独立去向保留下来。不能把流失用户直接删掉后仍声称流量守恒;如果每步允许同一个人重复进入,需要明确这里计的是事件而不是独立人数。
交互版在资料包 outputs/45_v1.0.2.html,可在本地浏览器打开。
文本、缺测与不确定性 · 46—50
46|中文词云:词云适合发现主题,不适合精确排名
工具:wordcloud + Matplotlib。
假设一批课程反馈已经分词,我们想快速了解大家常提什么。本例从预设词表模拟 700 个词,统计词频后生成中文词云,不读取他人的评论或歌词。
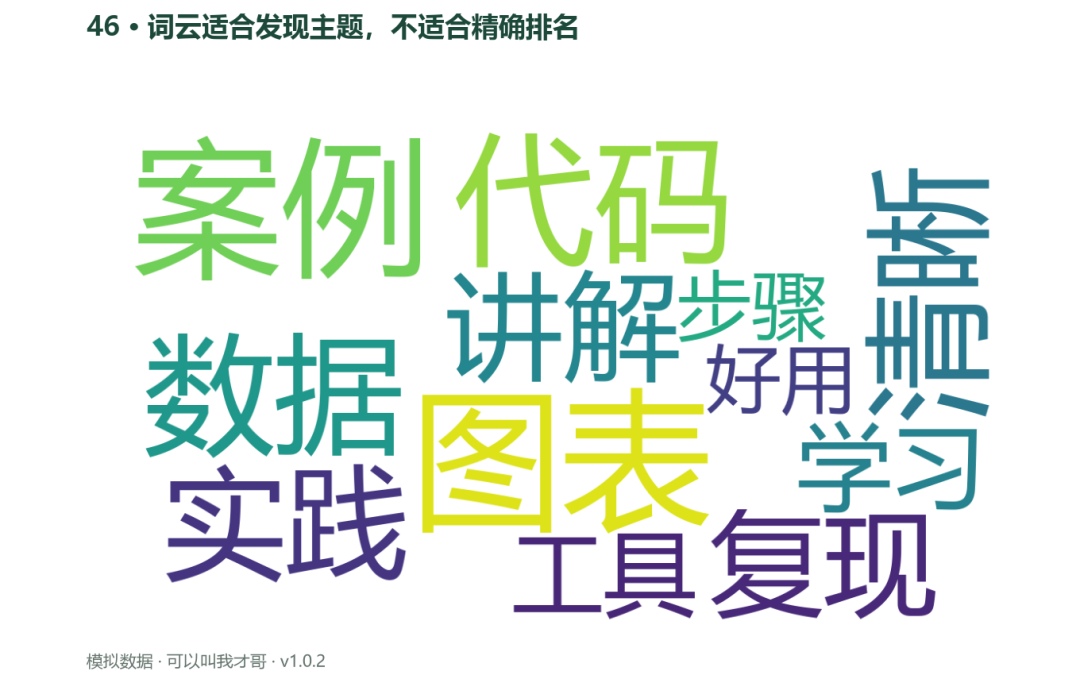
看图结果: 700 个模拟词中,图表出现 96 次。精确排序以导出的词频表为准。
实现思路: Counter 负责计数,WordCloud 通过 generate_from_frequencies 接收词频,指定中文字体和固定随机种子。提供的词序列 CSV 让读者能回溯每个频次的来源。
"""案例 46:词云适合发现主题,不适合精确排名 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from collections import Counter
from wordcloud import WordCloud

rng, fig, ax = start(46, "")
words = [
    "代码",
    "案例",
    "图表",
    "清晰",
    "数据",
    "实践",
    "讲解",
    "复现",
    "学习",
    "工具",
    "好用",
    "步骤",
]
weights = np.array(
    [14, 13, 12, 11, 10, 9, 8, 7, 6, 4, 3, 3], dtype=float
)
tokens = rng.choice(words, 700, p=weights / weights.sum())
counts = Counter(tokens)
df = pd.DataFrame(
    counts.items(), columns=["词", "频次"]
).sort_values("频次", ascending=False)
wc = WordCloud(
    font_path=FONT,
    width=1200,
    height=650,
    background_color="white",
    colormap="viridis",
    random_state=46,
    collocations=False,
).generate_from_frequencies(counts)
ax.imshow(wc)
ax.axis("off")
finish(
    46,
    "词云适合发现主题,不适合精确排名",
    fig,
    {
        "tokens": pd.DataFrame({"分词结果": tokens}),
        "frequency": df,
    },
    {"总词数": len(tokens)},
)
别忽略: 词云的字体大小还受到排布与词长影响,不适合精确比较第一名与第二名。真实中文文本应先完成分词、停用词、同义词和大小写规则处理;词出现得多不自动等于用户态度正面。
47|归一化词频剖面:比较文本偏好,先消除篇幅差异
工具:Matplotlib。
三份语料分别有 2000、8000、5000 个词,直接比较代码一词出现多少次,会把篇幅差异当成内容偏好。我们先把每个关键词的次数转换为每千词出现次数。
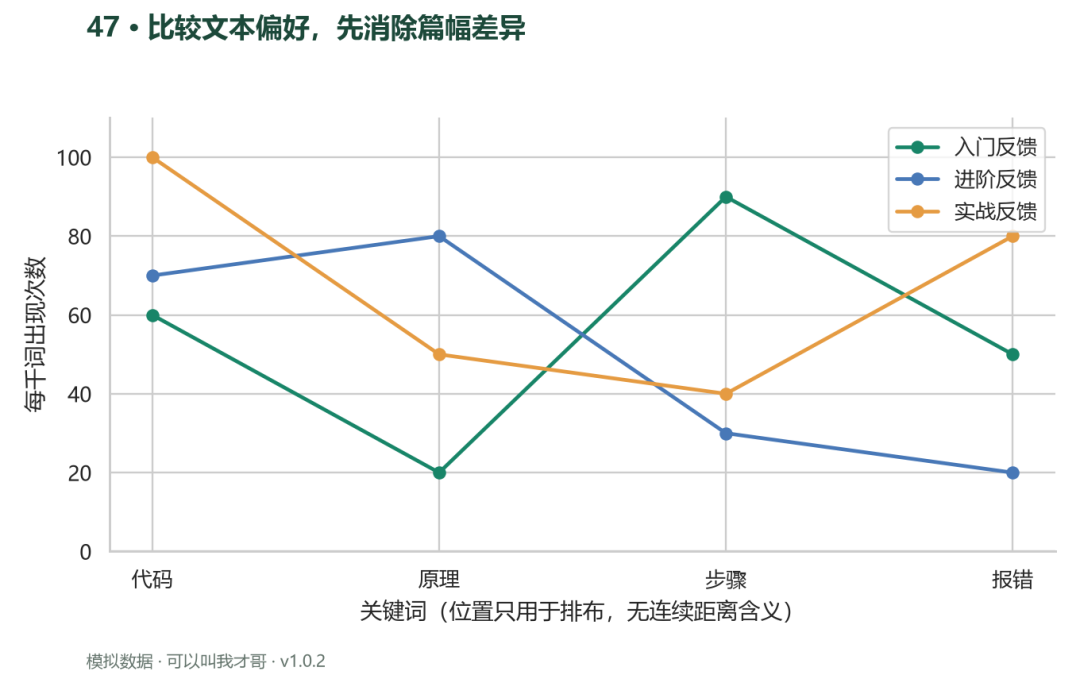
看图结果: 入门语料里"步骤"出现 90 次/千词,实战语料里"代码"出现 100 次/千词。进阶语料更长,但归一化后不再因篇幅直接占优。
实现思路: 分母是各自语料的全部有效词数,不是当前四个关键词的合计。这样四个关键词的值不必相加等于 1000,仍然能在统一尺度上比较相对使用强度。
"""案例 47:比较文本偏好,先消除篇幅差异 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(47, "")
df = pd.DataFrame(
    {
        "语料": ["入门反馈", "进阶反馈", "实战反馈"],
        "总词数": [2000, 8000, 5000],
        "代码": [120, 560, 500],
        "原理": [40, 640, 250],
        "步骤": [180, 240, 200],
        "报错": [100, 160, 400],
    }
)
words = ["代码", "原理", "步骤", "报错"]
norm = df[words].div(df.总词数, axis=0) * 1000
for i, row in norm.iterrows():
    ax.plot(words, row, "o-", label=df.语料.iloc[i], lw=2)
ax.set(
    ylabel="每千词出现次数",
    xlabel="关键词(位置只用于排布,无连续距离含义)",
    ylim=(0, 110),
)
ax.legend()
finish(
    47,
    "比较文本偏好,先消除篇幅差异",
    fig,
    {"counts": df, "per_1000": norm.assign(语料=df.语料)},
)
别忽略: 折线只是帮助识别词频轮廓,词与词之间没有连续距离,不能解读斜率。真实文本比较还应检查文体、抽样时期与分词规则一致性,不能用几条高频词直接概括一个作者的全部风格。
48|情绪与长度四象限:四象限图定位长篇负向反馈
工具:Matplotlib。
反馈很多时,可以先把长篇负向反馈送入人工复核队列。本例横轴是字数,纵轴是直接模拟的情绪指数,200 字和零分是人为设定的两条参考线。
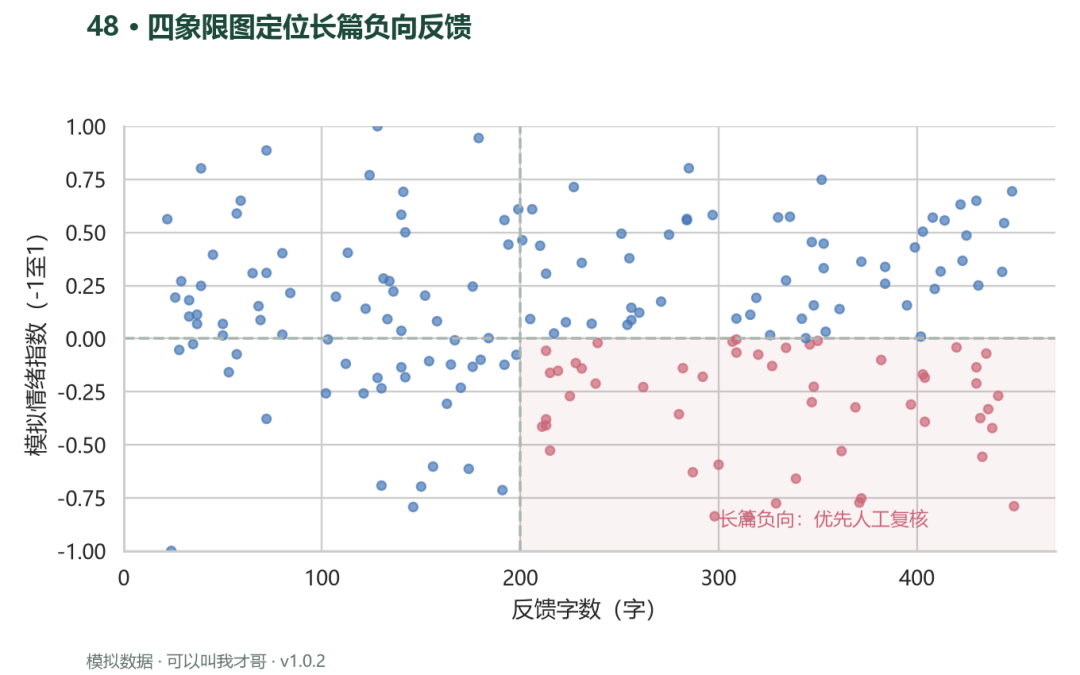
看图结果: 按 200 字与零分两条规则,51 条记录进入优先复核区。这是规则筛选数量,不是投诉识别准确率。
实现思路: 右下区域同时满足字数不少于 200 和情绪指数小于零,代码将这些记录标记并导出。散点保留全部样本,红色只表示需要优先复核,不表示系统已经判定投诉成立。
"""案例 48:四象限图定位长篇负向反馈 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, ax = start(48, "")
df = pd.DataFrame(
    {
        "反馈编号": range(1, 181),
        "字数": rng.integers(20, 450, 180),
        "情绪指数": np.clip(rng.normal(0.1, 0.4, 180), -1, 1),
    }
)
threshold = 200
df["优先复核"] = (df.字数 >= threshold) & (df.情绪指数 < 0)
ax.axvspan(
    threshold,
    470,
    ymin=0,
    ymax=0.5,
    color=COLORS[4],
    alpha=0.08,
)
ax.scatter(
    df.字数,
    df.情绪指数,
    c=np.where(df.优先复核, COLORS[4], COLORS[1]),
    s=22,
    alpha=0.7,
)
ax.axvline(threshold, color="#AAB6B0", ls="--")
ax.axhline(0, color="#AAB6B0", ls="--")
ax.set(
    xlabel="反馈字数(字)",
    ylabel="模拟情绪指数(-1至1)",
    xlim=(0, 470),
    ylim=(-1, 1),
)
ax.text(
    300,
    -0.88,
    "长篇负向:优先人工复核",
    fontsize=10,
    color=COLORS[4],
)
finish(
    48,
    "四象限图定位长篇负向反馈",
    fig,
    df,
    {
        "人工设定长度阈值": threshold,
        "优先复核条数": int(df.优先复核.sum()),
        "指数来源": "直接模拟,未调用情感模型",
    },
)
别忽略: 这里没有调用情感模型,也没有宣称具备真实识别准确率。换成模型分数后,需要检查标注集、阈值和讽刺表达等错误;分数为负也不意味着反馈没有建设性。
49|覆盖率伴随的月均趋势:日数据汇总为月均值,缺测不能当零
工具:Matplotlib + pandas。
一年日数据中,六月整月缺失,九月前 16 天缺失。如果先填零再求月均,就会制造一场并不存在的骤降;如果只画有值月份,还会把缺口悄悄连起来。
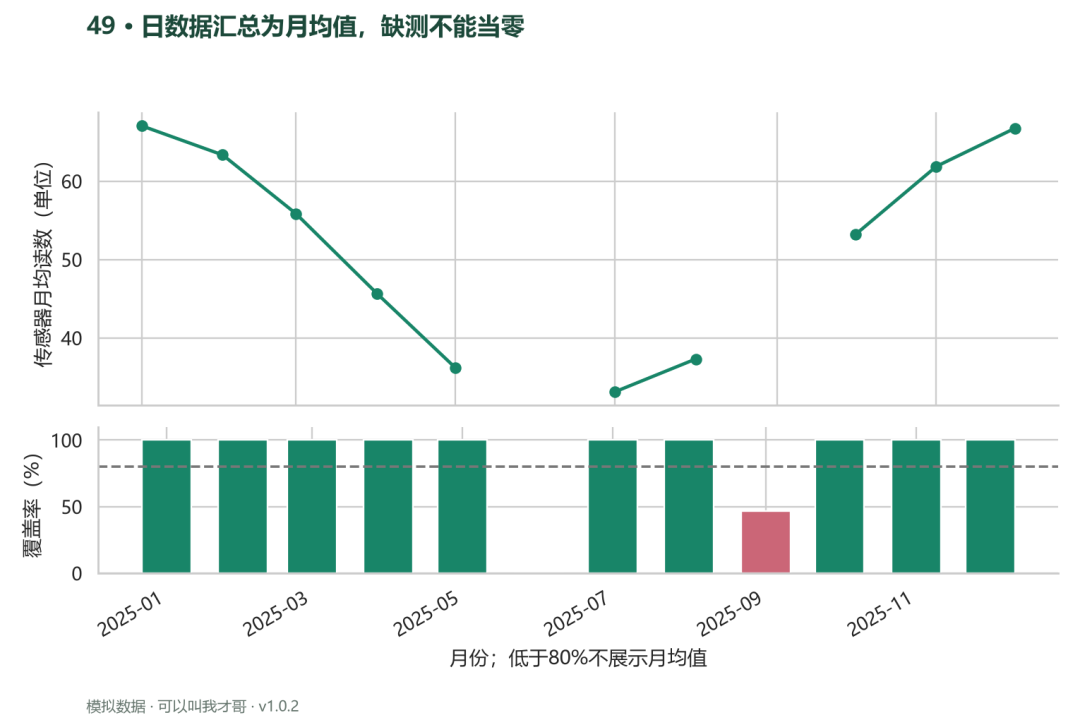
看图结果: 六月覆盖率 0%,九月为 14/30≈46.7%,两个月都不显示月均值;其余月份保留完整观测。
实现思路: 先按月分别计算均值、有效天数和预期天数,再得到覆盖率。本例约定低于 80% 不展示月均值,上图保留断点,下图显示覆盖率,让读者知道为什么有些月份看不到趋势点。
"""案例 49:日数据汇总为月均值,缺测不能当零 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

rng, fig, axes = start(
    49,
    "",
    size=(9, 6),
    nrows=2,
    gridspec_kw={"height_ratios": [2, 1]},
)
dates = pd.date_range("2025-01-01", "2025-12-31")
n = len(dates)
df = pd.DataFrame(
    {
        "日期": dates,
        "读数": 50
        + 18 * np.cos(np.arange(n) / 365 * 2 * np.pi)
        + rng.normal(0, 6, n),
    }
)
df.loc[df.日期.dt.month == 6, "读数"] = np.nan
df.loc[
    (df.日期.dt.month == 9) & (df.日期.dt.day < 17), "读数"
] = np.nan
monthly = (
    df.set_index("日期")
    .resample("MS")
    .读数.agg(["mean", "count", "size"])
)
monthly["coverage"] = monthly["count"] / monthly["size"]
monthly["shown"] = monthly["mean"].where(
    monthly.coverage >= 0.8
)
assert monthly.loc["2025-06-01", "count"] == 0 and pd.isna(
    monthly.loc["2025-06-01", "shown"]
)
axes[0].plot(monthly.index, monthly.shown, "o-", lw=2)
axes[0].set_ylabel("传感器月均读数(单位)")
axes[1].bar(
    monthly.index,
    monthly.coverage * 100,
    width=20,
    color=np.where(
        monthly.coverage >= 0.8, COLORS[0], COLORS[4]
    ),
)
axes[1].axhline(80, ls="--", color="#777777")
axes[1].set(
    ylabel="覆盖率(%)",
    ylim=(0, 110),
    xlabel="月份;低于80%不展示月均值",
)
fig.autofmt_xdate()
finish(
    49,
    "日数据汇总为月均值,缺测不能当零",
    fig,
    {"daily": df, "monthly": monthly.reset_index()},
)
别忽略: 80% 是演示阈值,不是通用统计标准。日记录不等于全天均值,如果原始数据按小时采样,还需要核对每天覆盖情况;缺测若有系统性,即使覆盖率高,均值也可能有偏。
50|均值及95%置信区间:均值之外,补上不确定性的范围
工具:Matplotlib + SciPy。
四组各抽 40 个独立样本,均值点旁边再加上 95% t 置信区间,帮助读者区分估计位置与估计精度。横向误差棒比高高的均值柱更节省视觉空间。
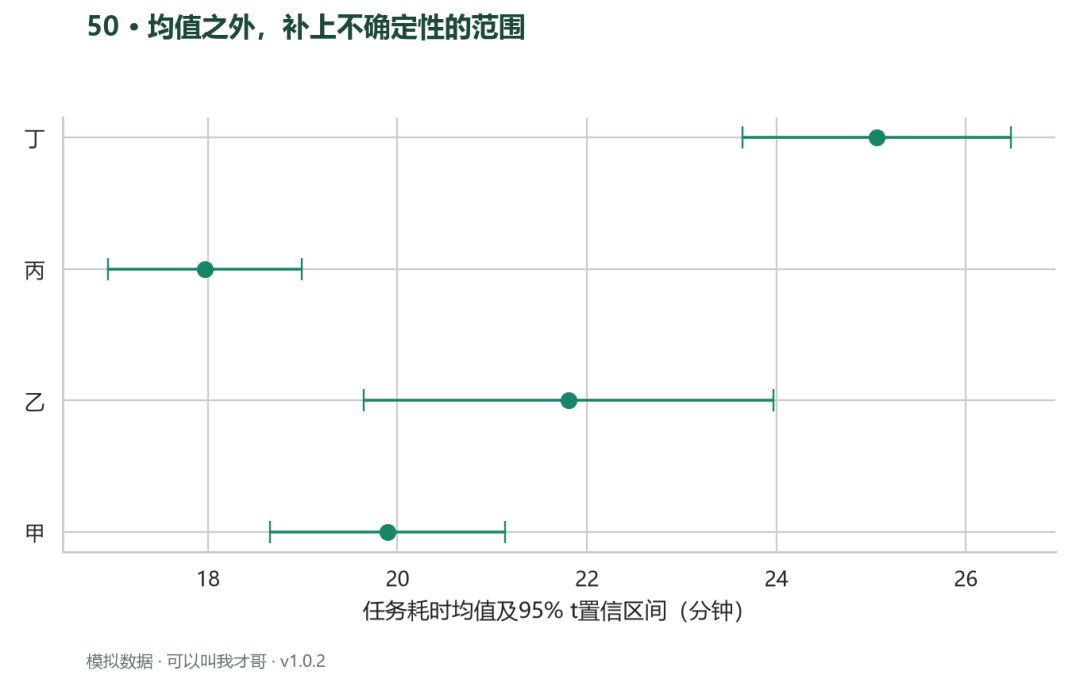
看图结果: 误差棒围绕各组均值展开,较大的样本波动会带来更宽区间。每组都是 40 个独立模拟样本,区间对象为总体均值。
实现思路: 区间半宽为 t 分位数乘以样本标准差再除以样本量平方根。代码使用自由度 n-1,明确区间针对总体均值,并用 SciPy 的 sem 计算结果交叉核对。
"""案例 50:均值之外,补上不确定性的范围 | v1.0.2 | 才哥AGI | 全部为模拟数据。"""

from common_v1_0_2 import *

from scipy.stats import t, sem

rng, fig, ax = start(50, "")
df = pd.DataFrame(
    {
        "组别": np.repeat(["甲", "乙", "丙", "丁"], 40),
        "耗时": np.r_[
            rng.normal(20, 4, 40),
            rng.normal(22, 7, 40),
            rng.normal(19, 3, 40),
            rng.normal(24, 5, 40),
        ],
    }
)
summary = df.groupby("组别", sort=False).耗时.agg(
    ["mean", "std", "count"]
)
summary["halfwidth"] = (
    t.ppf(0.975, summary["count"] - 1)
    * summary["std"]
    / np.sqrt(summary["count"])
)
for name, g in df.groupby("组别", sort=False):
    assert np.isclose(
        summary.loc[name, "halfwidth"],
        t.ppf(0.975, len(g) - 1) * sem(g.耗时),
    )
ax.errorbar(
    summary["mean"],
    np.arange(4),
    xerr=summary.halfwidth,
    fmt="o",
    capsize=6,
    ms=8,
    color=COLORS[0],
)
ax.set(
    yticks=np.arange(4),
    yticklabels=summary.index,
    xlabel="任务耗时均值及95% t置信区间(分钟)",
)
finish(
    50,
    "均值之外,补上不确定性的范围",
    fig,
    {"raw": df, "summary": summary.reset_index()},
    {
        "置信水平": 0.95,
        "区间对象": "总体均值",
        "每组独立样本": 40,
        "重复测量": False,
    },
)
别忽略: 95% 描述的是在相同抽样机制下反复构造区间的长期覆盖率,不是 95% 的个体落在这根误差棒内。区间重叠也不能直接替代组间差异检验,重复测量或强偏态数据需要调整估计方法。
三、把示例换成自己的数据
第一步:保留字段含义,替换数据来源
先看案例 CSV 的列名和单位,再把代码中的模拟部分替换成 read_csv、read_excel 或数据库查询。不要只让新表的列名碰巧相同:订单数是否去重、收入是否退款后、时间属于哪个时区,都决定图究竟表达什么。
例如堆叠收入图要求同一季度的三类收入互斥;桑基图要求节点编号与边表对应;组织树要求每个下级只有一个正式上级。数据类型对了,业务含义仍可能不对。
第二步:把绘图前检查留住
比例求和、余额恒等式、价格上下界和流量守恒都可以写成断言。它们不是为了把错误藏起来,而是让脚本在数据不满足前提时停下来。
缺失值与异常值应分别处理:缺失表示没有观测,异常表示有观测但值得复核。不要因为都影响图形外观,就统一填零或直接删除。第 28 例与第 49 例可以作为这两种问题的起点。
第三步:检查表达是否超过证据
看到了正相关,就写当前样本存在正相关;看到了长篇负向反馈,就写进入人工复核队列。把"证明有效""找到了原因""识别准确"留给有相应设计与验证的数据。
不确定性也要说清对象。标准差描述个体离散程度,标准误与置信区间描述估计的不确定性,不能因为它们都能画成误差棒就互换含义。Seaborn 误差棒说明对这两类用途有清楚区分。
第四步:最后再调整排版
先确认图名与图形结构一致,再调整标题、字号和颜色。类别颜色保持稳定,连续值使用有顺序的色阶,有正负方向时才使用以零或目标值为中心的发散色阶。
本指南使用静态图作为正文插图。手机上遇到散点矩阵、网络和三维曲面,请点开原图或查看配套交互版;如果只挑其中一图放进日常报告,最好围绕那一个问题重新放大标签与注释。
以上就是这次的 50 个案例。建议先选一张与你手头问题最接近的图,跑通以后再换数据;确认计算与含义没有变化,再考虑配色和排版。能把一个问题说明白,比再收藏十张图更有用。如果你在实践过程中有新的思考、改进了某个案例的写法,也欢迎分享到云栈社区的技术论坛,和大家一起讨论。
附录:公共模块完整实现
下面文件保存为 cases/common_v1_0_2.py,与 50 个案例脚本放在同一目录。 start 创建独立随机数生成器与画布,finish 保存 CSV、图像与指标。它不替代案例中的数据生成和绘图逻辑。
"""v1.0.2 | 才哥AGI | 2026-09-13 | 统一导出与中文字体。"""

from pathlib import Path
import os, json
import numpy as np
import pandas as pd
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import font_manager
import seaborn as sns

ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "outputs"
OUT.mkdir(exist_ok=True)
FONT = None
for name in [
    "Microsoft YaHei",
    "Noto Sans CJK SC",
    "SimHei",
    "PingFang SC",
]:
    try:
        FONT = font_manager.findfont(
            name, fallback_to_default=False
        )
        break
    except ValueError:
        pass
if FONT is None:
    raise RuntimeError(
        "请安装 Noto Sans CJK SC 中文字体后重新运行。"
    )
FONT_NAME = font_manager.FontProperties(fname=FONT).get_name()
COLORS = [
    "#188568",
    "#4878B7",
    "#E59B42",
    "#9566AA",
    "#CB6677",
    "#5D9FAD",
]
sns.set_theme(style="whitegrid", font=FONT_NAME, palette=COLORS)
plt.rcParams.update(
    {
        "axes.unicode_minus": False,
        "font.size": 12,
        "axes.titlesize": 16,
        "axes.labelsize": 12,
        "figure.dpi": 150,
        "savefig.dpi": 170,
        "svg.fonttype": "path",
        "axes.spines.top": False,
        "axes.spines.right": False,
    }
)
(
    os.environ.setdefault(
        "BROWSER_PATH",
        r"C:\Program Files\Google\Chrome\Application\chrome.exe",
    )
    if os.name == "nt"
    else None
)

def start(n, title, size=(8, 5), **kwargs):
    rng = np.random.default_rng(20260913 + n)
    fig, ax = plt.subplots(figsize=size, **kwargs)
    return rng, fig, ax

def finish(n, title, fig, df, metrics=None):
    stem = f"{n:02d}_v1.0.0"
    if not isinstance(df, dict):
        df = {"data": df}
    tables = []
    for key, table in df.items():
        filename = f"{stem}_{key}.csv"
        table.to_csv(
            OUT / filename,
            index=False,
            encoding="utf-8-sig",
            float_format="%.9g",
        )
        tables.append(filename)
    if hasattr(fig, "write_image"):
        fig.update_layout(
            template="plotly_white",
            width=1000,
            height=650,
            title=dict(text=f"{n:02d} · {title}", x=0.04),
            font=dict(family=FONT_NAME, size=18),
            colorway=COLORS,
            margin=dict(t=110, b=90, l=75, r=65),
        )
        fig.add_annotation(
            text="模拟数据 · 可以叫我才哥 · v1.0.2",
            x=0,
            y=-0.13,
            xref="paper",
            yref="paper",
            showarrow=False,
            font=dict(size=14, color="#64746C"),
        )
        fig.write_html(
            OUT / f"{n:02d}_v1.0.2.html",
            include_plotlyjs="directory",
            auto_open=False,
        )
        fig.write_image(OUT / f"{n:02d}_v1.0.2.png", scale=1.6)
        fig.write_image(OUT / f"{n:02d}_v1.0.2.svg")
    else:
        fig.suptitle(
            f"{n:02d} · {title}",
            x=0.08,
            ha="left",
            fontweight="bold",
            color="#1C493A",
        )
        fig.text(
            0.08,
            0.012,
            "模拟数据 · 可以叫我才哥 · v1.0.2",
            fontsize=9,
            color="#64746C",
        )
        fig.tight_layout(rect=(0, 0.04, 1, 0.94))
        fig.savefig(OUT / f"{n:02d}_v1.0.2.png")
        fig.savefig(OUT / f"{n:02d}_v1.0.2.svg")
        plt.close(fig)
    record = dict(
        case=n,
        title=title,
        seed=20260913 + n,
        synthetic=True,
        tables=tables,
        metrics=metrics or {},
    )
    (OUT / f"{stem}_metrics.json").write_text(
        json.dumps(
            record,
            ensure_ascii=False,
            indent=2,
            allow_nan=False,
            default=lambda v: v.item(),
        ),
        encoding="utf-8",
    )
    print(f"PASS {n:02d}{title}", flush=True)
 发表于 7 天前
|
查看: 1|
回复: 0


