在刚开始做网络相关工作的时候,我对于 DNS 的理解其实相当简单:输入一个网址,DNS 把域名换成 IP,浏览器再拿着这个 IP 去访问服务器。书上这么写,面试时也这么答,我一直以为这件事已经说清楚了。
后来用 Wireshark 真正去抓包,才发现里面有不少以前完全没注意到的细节。
有一次到现场排查访问慢的问题,用户反复说网页打开特别慢。我一开始把方向放在出口带宽和服务器负载上,结果抓完包才发现方向是错的——TCP 连接本身建立得很快,慢的是前面的 DNS 查询环节。
从那一次以后,我就习惯把"输入一个网址"这件事拆开来看。
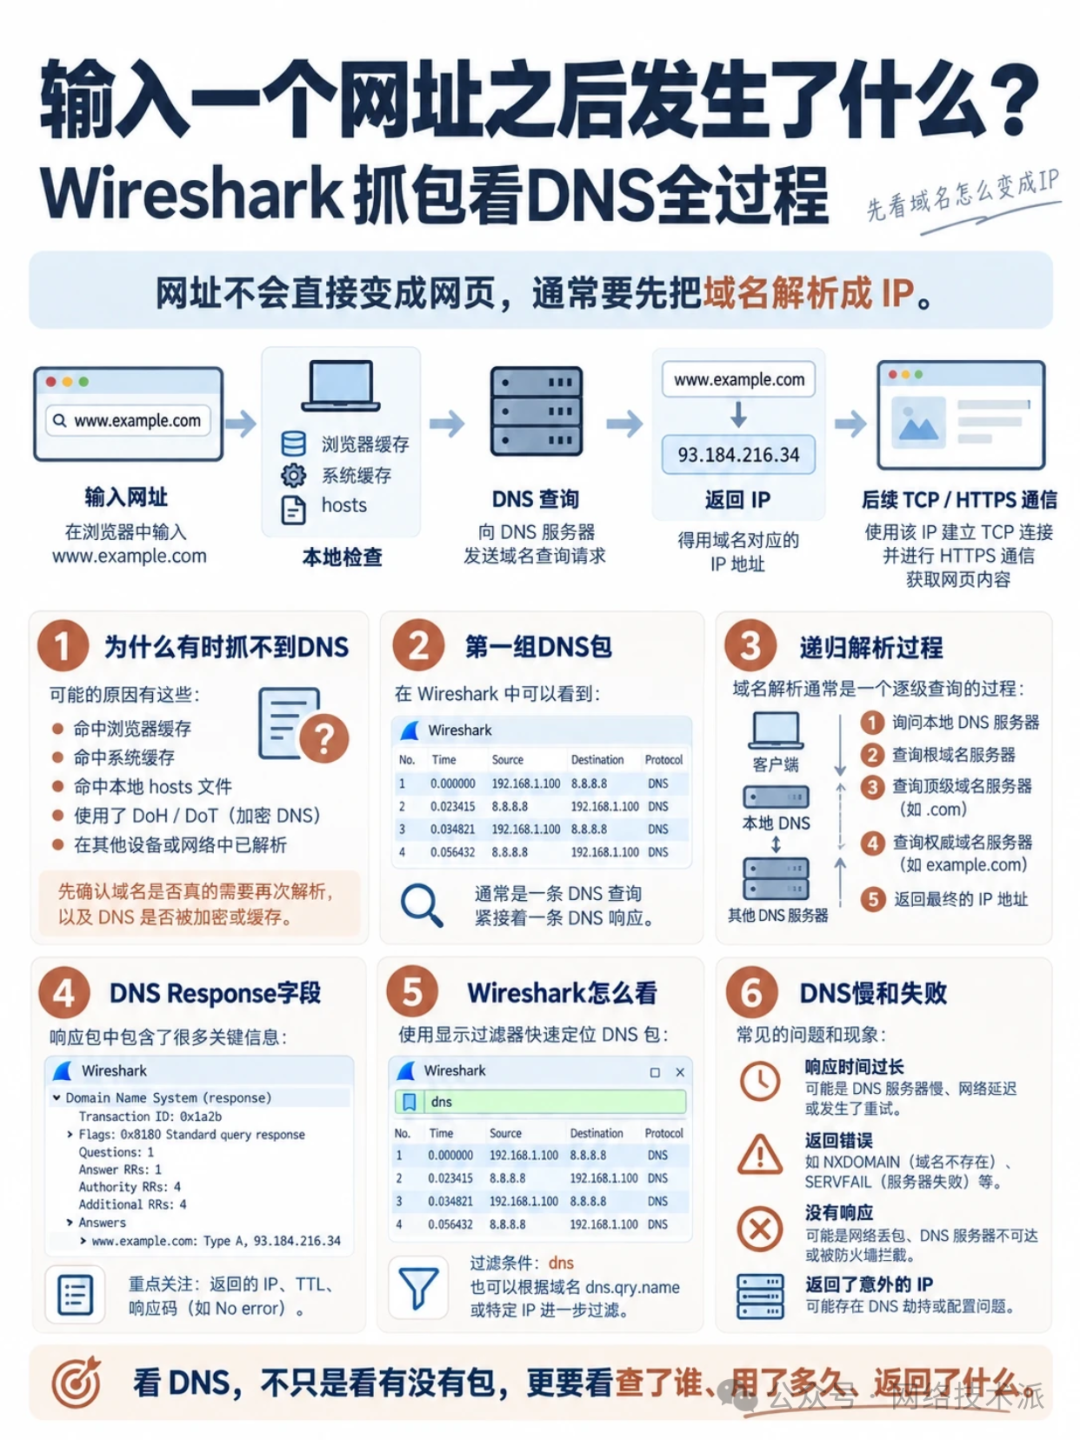
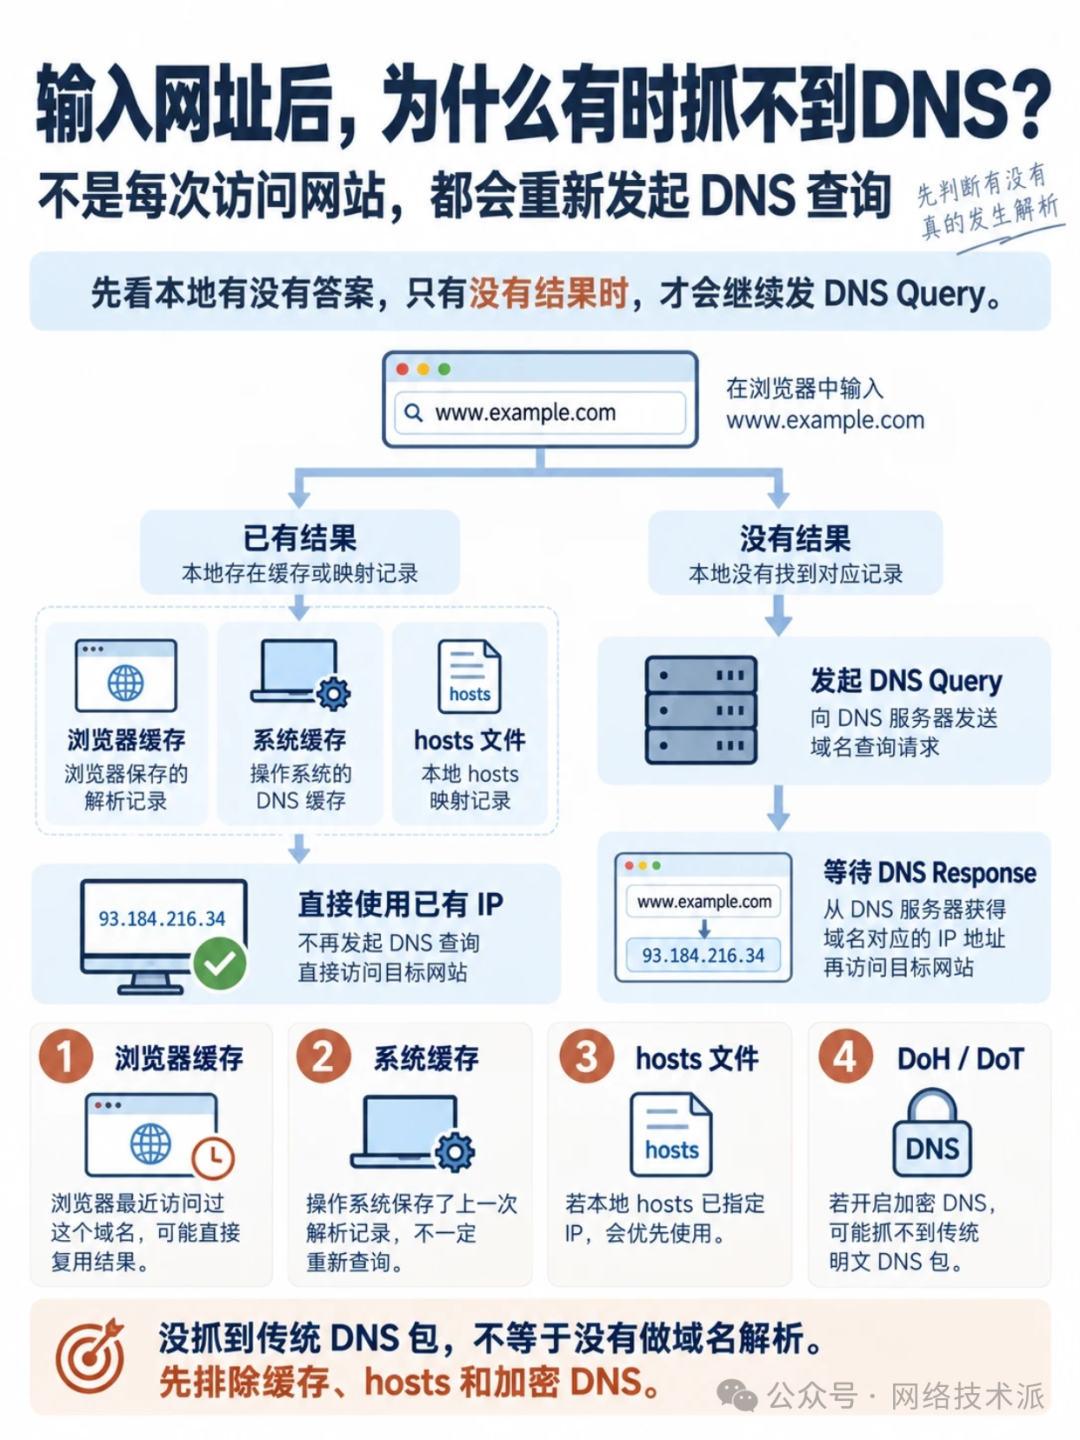
在浏览器里敲下 www.example.com ,并不一定马上就会发出 DNS 包。浏览器可能会先翻一下自己的缓存,操作系统也可能存着解析结果,本地 hosts 文件里甚至已经把对应关系写死了。只有在没有现成答案的时候,才会真正发出一次 DNS Query。
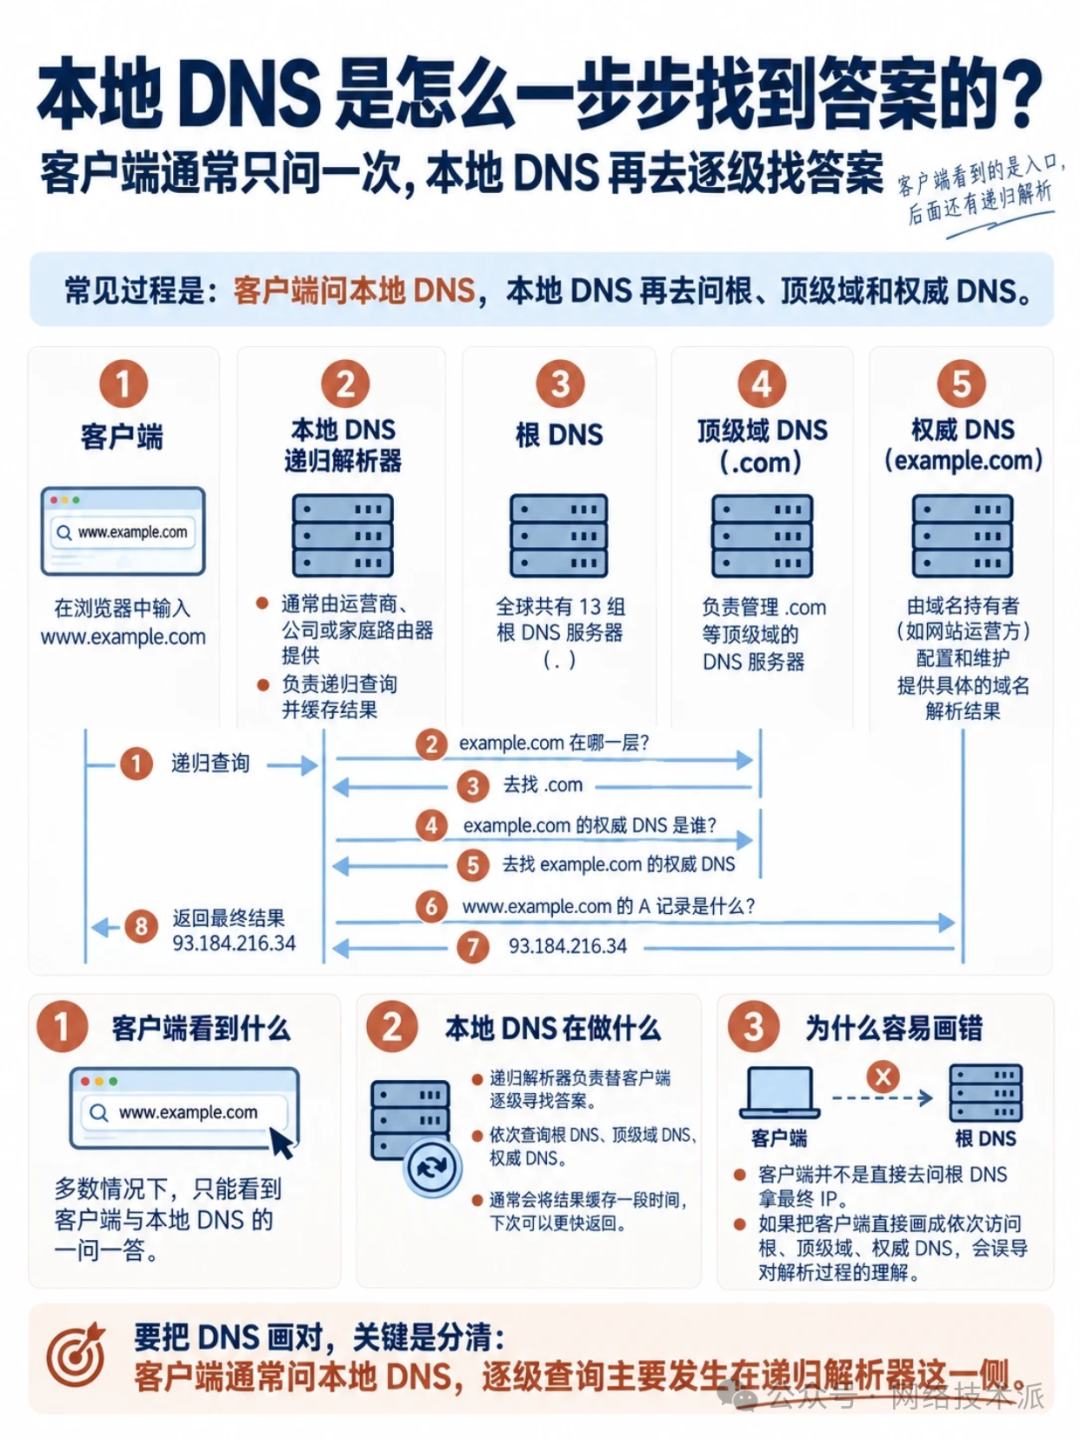
查到本地 DNS 这里其实还没完。它自己如果也没有缓存,就要替客户端继续找答案:先问根 DNS,再去问这个域名对应的顶级域 DNS,然后是权威 DNS,最后才把那条 A、AAAA 或者 CNAME 记录拿回来。
这个逐级查询的过程,用 Wireshark 来看就非常直观。
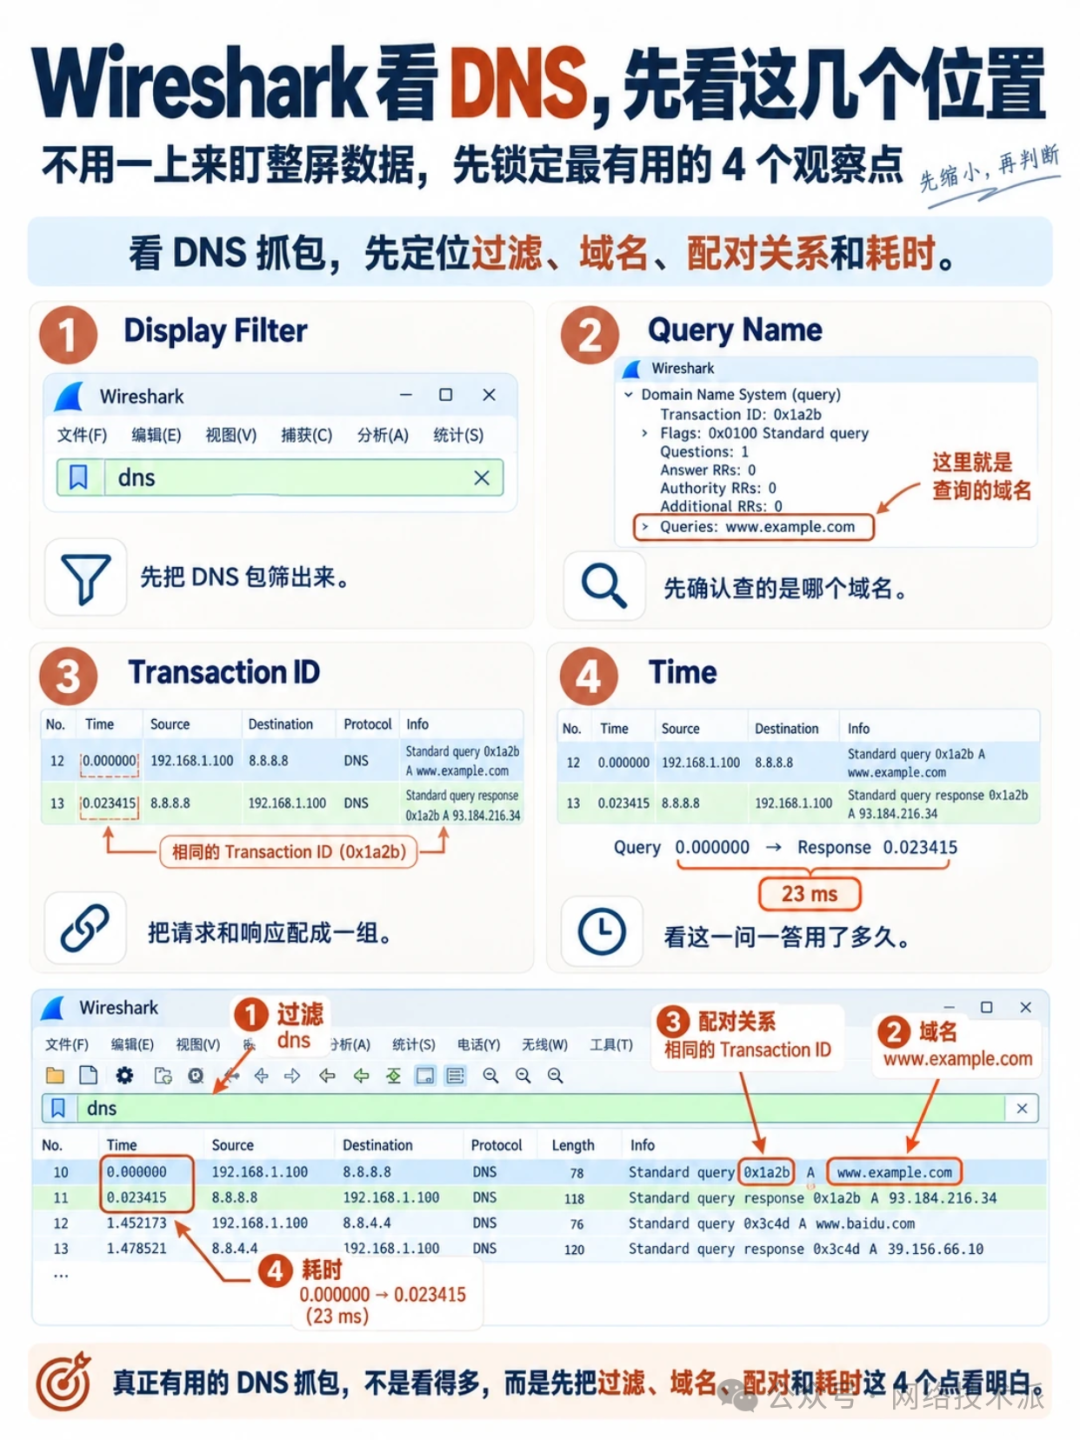
屏幕上同时躺着 Query 和 Response:你能看到问的是哪个域名,Transaction ID 是怎么把一问一答配成一对的,从发出到回来中间隔了多少毫秒。
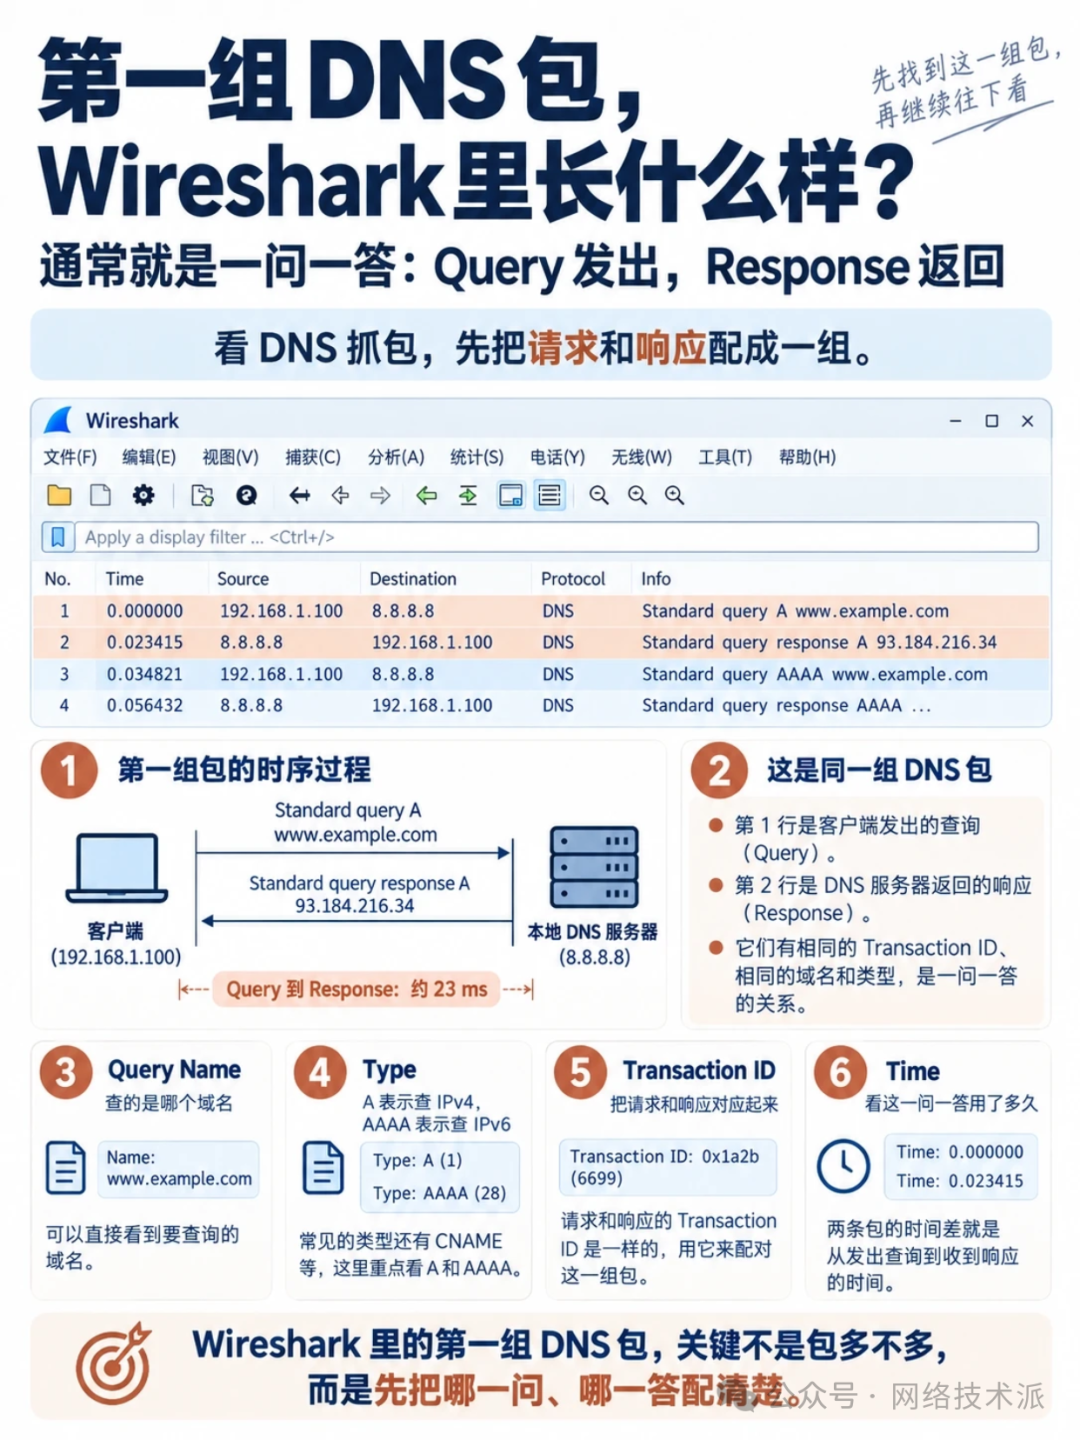
把这些过程放进 Wireshark 里面去看,可以先从几个位置入手:过滤条件、查询域名、配对关系和耗时。把 DNS 包筛出来,再确认 Transaction ID 对不对得上,最后看一问一答花了多久。
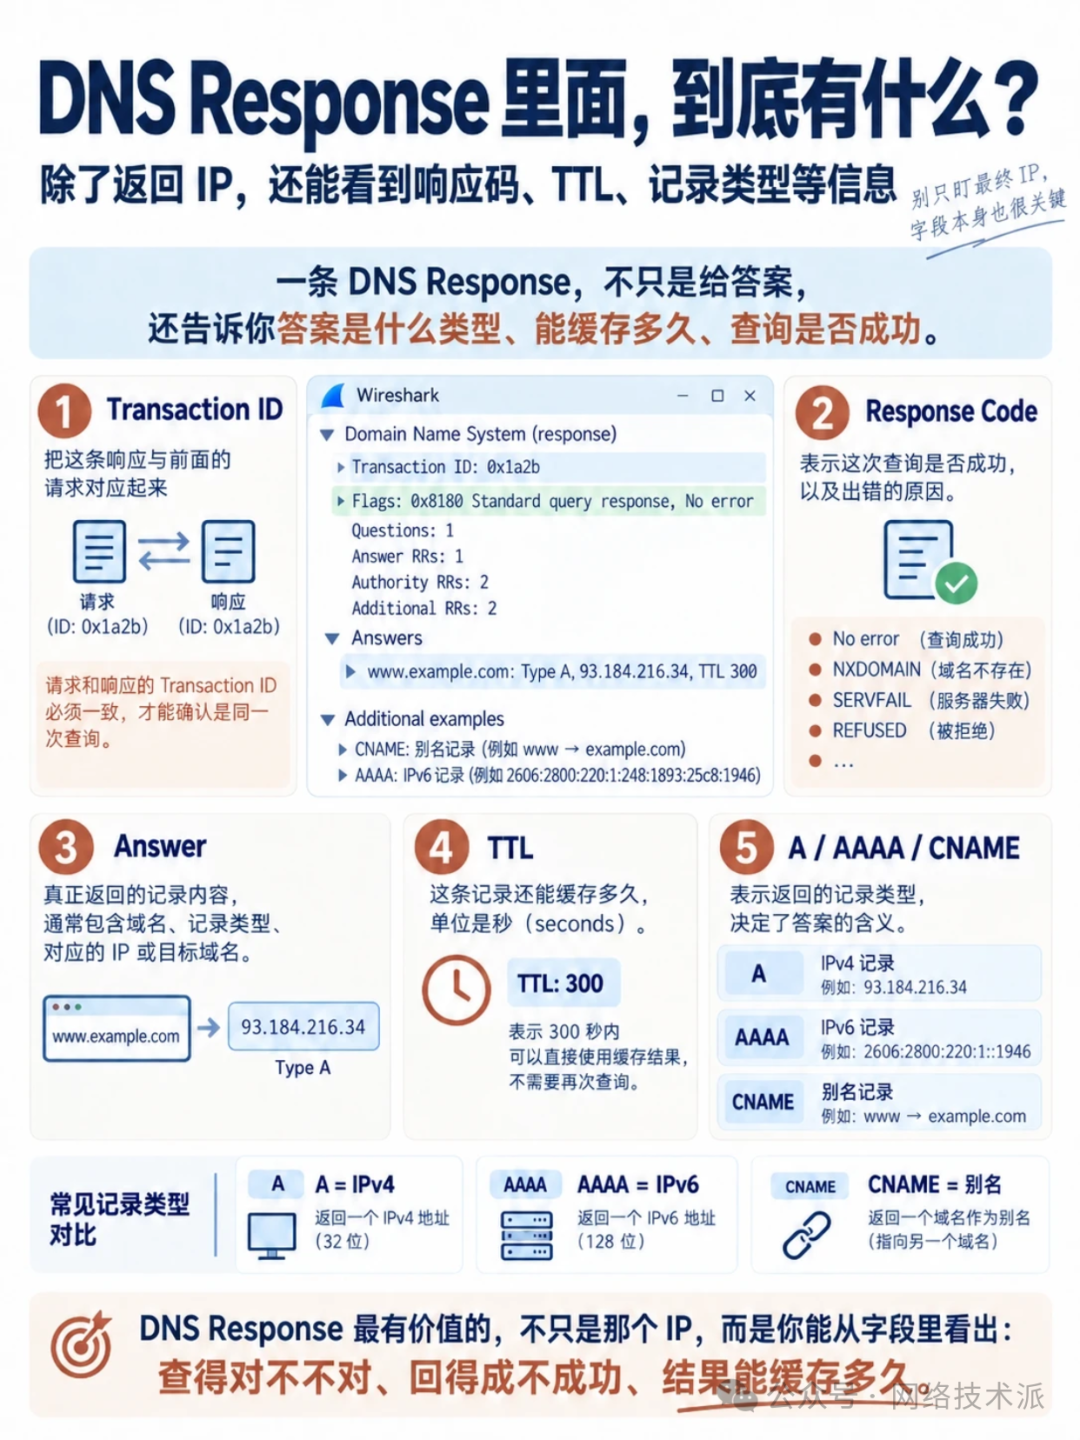
Response Code 那一栏会告诉你是 NXDOMAIN 还是 SERVFAIL,TTL 则说明了这个结果还能被缓存多久。重点从来不只是那个返回的 IP,而是从字段里看出:查得对不对、回得成不成功、结果能缓存多久。
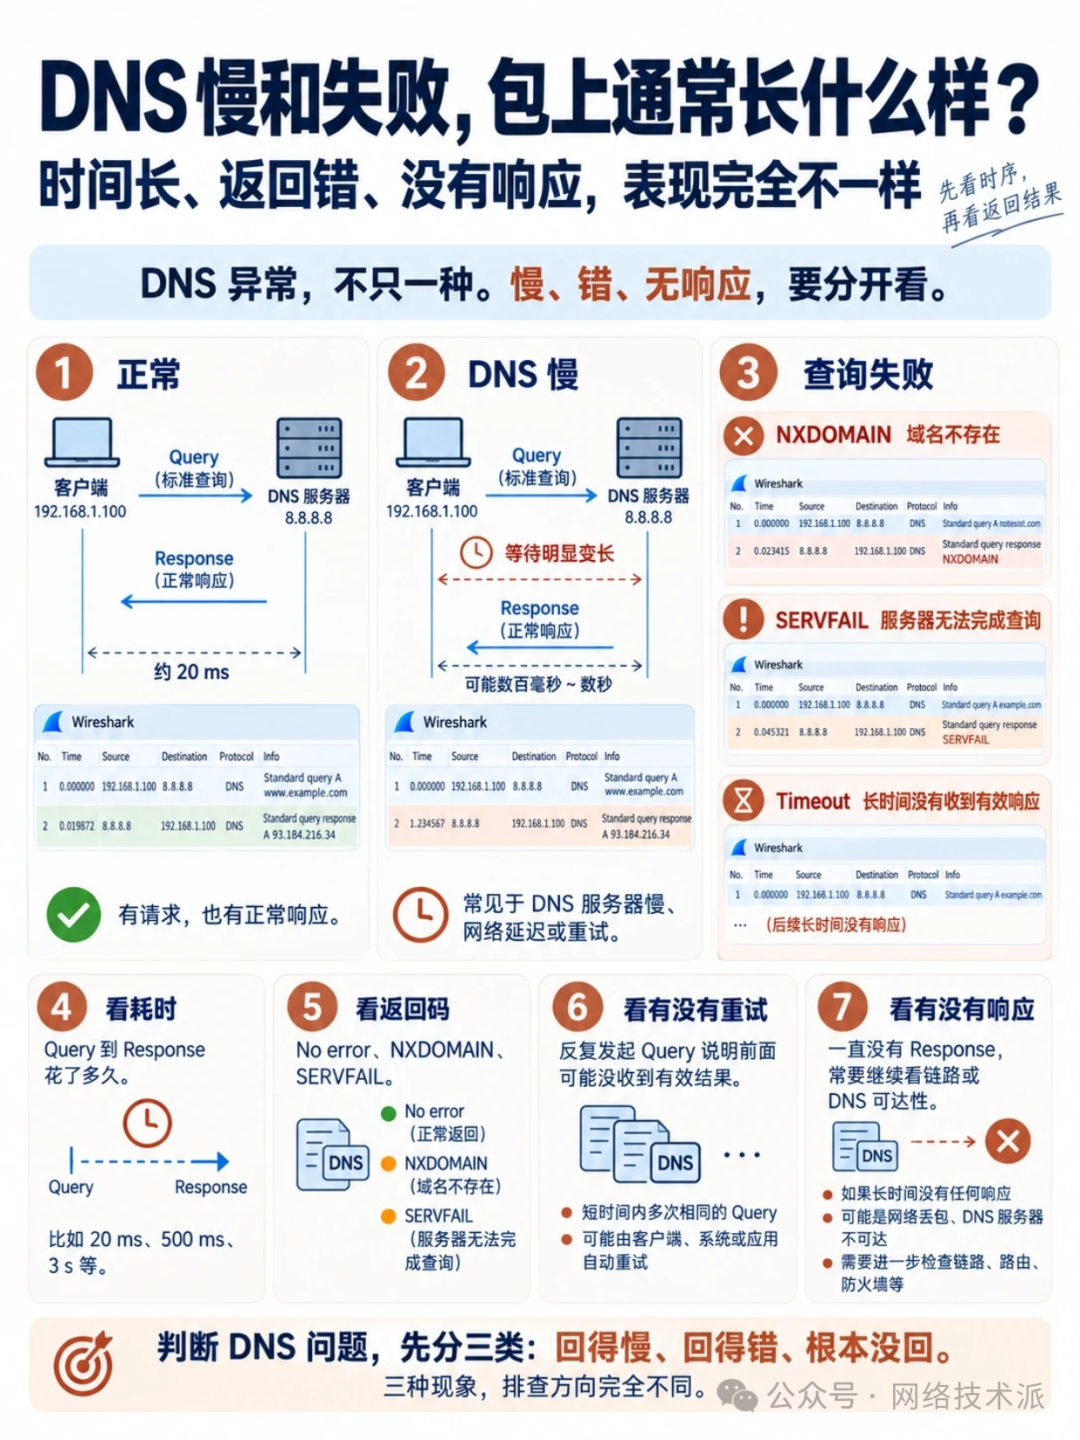
所以现在我再看 DNS,很少只问一句能不能解析。我更想知道的是:到底有没有真的发出查询,查的又是谁,等了多久,最后返回了什么。DNS 慢和失败在包上表现完全不同——回得慢、回得错、根本没回,三种现象的排查方向是完全不一样的。
这里有一点需要特别提醒:如果浏览器开了 DNS over HTTPS,DNS 查询就会走加密通道,在 Wireshark 里看到的只是一串 HTTPS 流量,解析不出 DNS 报文。真要分析 DNS,先到浏览器设置里把 DoH 关掉,或者把抓包点放到更靠外的位置。
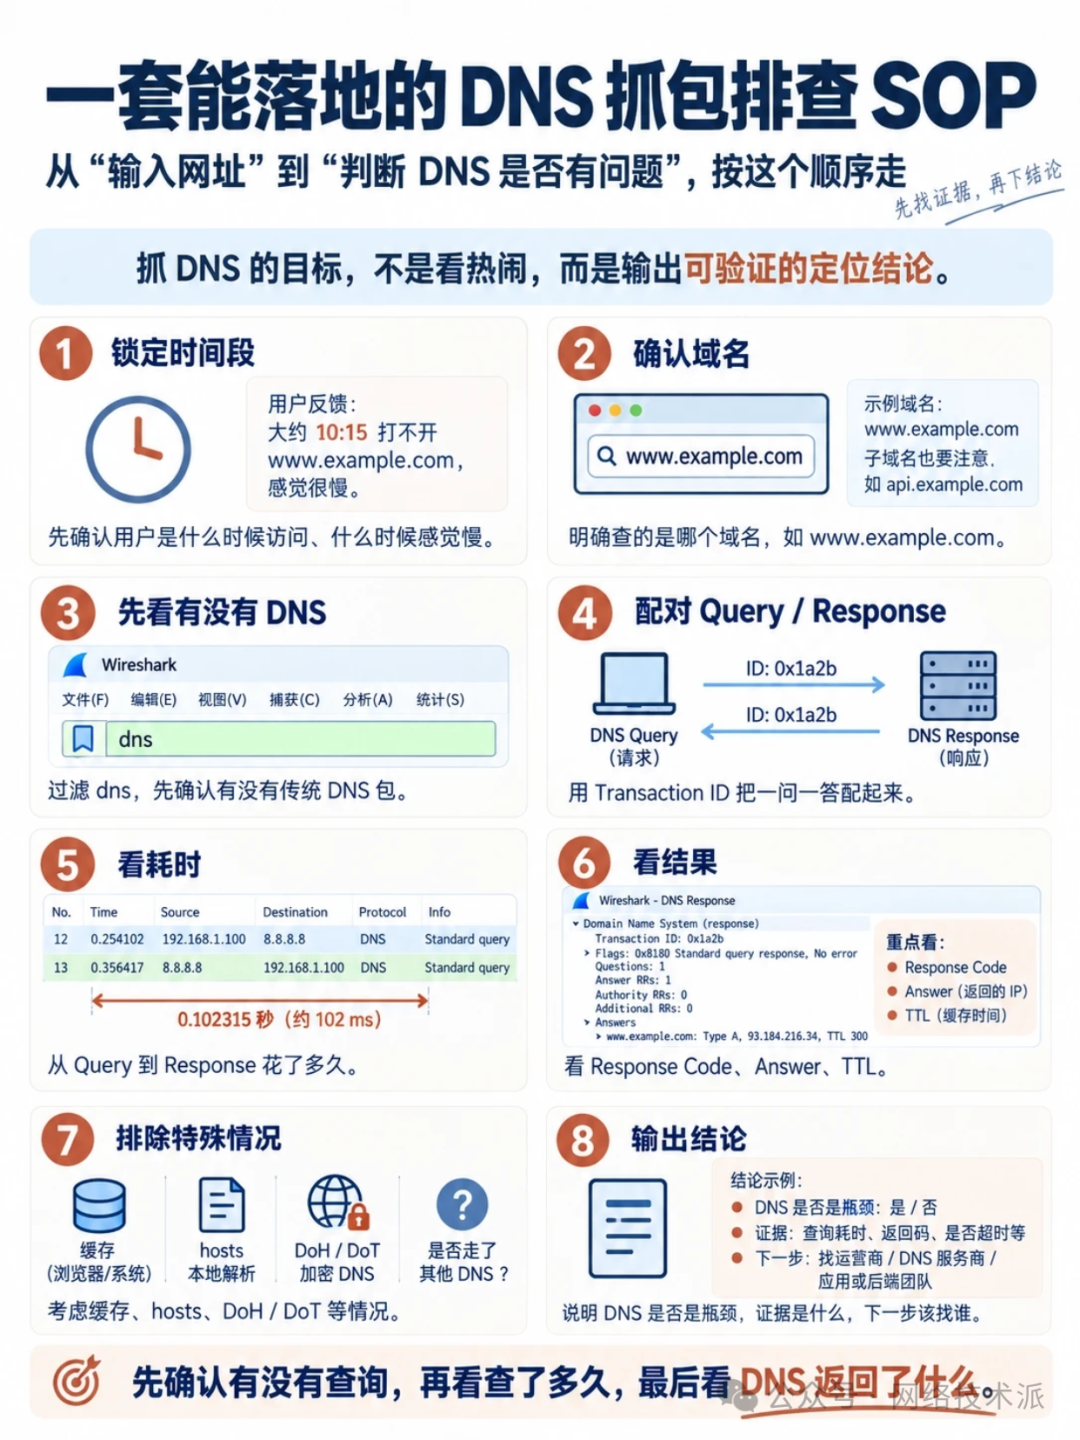
这一篇内容里,我把平时用 Wireshark 看 DNS 的思路整理成了一套可以落地的排查顺序:先锁定时间段,确认具体域名,再判断有没有 DNS 包,然后配对 Query / Response,看耗时,分析返回结果,最后排除缓存、hosts、DoH / DoT 等特殊情况,输出结论。
我在后来越来越习惯用抓包、日志以及脚本来分析问题,这跟自己的工作经历有关。刚做网工的头几年,时间基本都花在交换机、路由器、VLAN、端口和现场故障上面。命令背得越来越多,但有一件事越来越让人别扭——有些活光靠手工根本做不完。
我最开始写脚本,就是因为重复的事情实在太多了。几十个 IP 需要测试连通性,一个一个 ping 太慢,那就写个循环批量跑;几万行日志要找出异常 IP、状态码和时间段,用 Python 过一遍比翻屏幕快得多;资产表、告警表、扫描结果需要去重、匹配、归类,就交给 pandas。
再往后,日志里的字段用正则抠出来,接口的数据用 requests 去拉,返回的 JSON 直接解析,一个工具的输出就能喂给下一个工具。用下来我有一个很深的感受:Python 对网工、运维以及安全岗位的价值,跟写软件其实没什么关系。它管的是另一类事情——把原来只能手工做一遍的动作,变成能批量跑、能重复跑、能自动跑的流程。
这些工具摆在一起之后,它们之间的关系就慢慢清楚了。Wireshark 出的是流量上的证据,Linux 那边给出的是主机当前的状态,Nmap 负责快速把资产和服务理出来,日志记录的是系统里发生过什么。Python 站在最后面,把这些散落的数据收拢起来、清洗一遍、再做比对,最后输出一个能直接看的结果。
走到这一步之后,我所做的事情,就从操作网络设备变成了分析问题、处理数据、写脚本以及做自动化。
如果你现在也在做网工或者运维方面的工作,并且觉得工作越来越重复,那下一步很值得往工具这方面补上一块。网络基础留着,Python 可以排得靠前一些,再配合 Linux、Wireshark、Nmap、Shell、日志分析以及数据库一起来学。懂协议、知道故障现场长什么样,再加上脚本和自动化,以前只能靠经验一点一点摸的问题,就能用数据和工具更快地定位。
这也是我越做越确定的一件事:方向不一定非得是换一个岗位。先把能力从"会配设备"扩展到"把网络、系统、数据和工具串起来",路自然也就宽了。
 发表于 5 天前
|
查看: 1|
回复: 0


