我们那套危废管理系统的测试库,常年只有那么几条记录。危险废物类别永远填 HW08,入库数量永远 100,单位永远吨,批次号永远只有一个。这份 fixtures 是我两年前写的,跑到现在没改过,测试一直是绿的。
上个月做批量导入,线上出了个事:有一批数据单位填的是千克,入库数量 100,系统按吨存进去,库存量直接放大一千倍。我回头看测试,全都过。因为我造的数据里,单位这一列只有吨这一个值。
那一刻我意识到一件事:我一直以为测试绿了说明代码对,其实它只说明代码在我造的这个小世界里是对的。
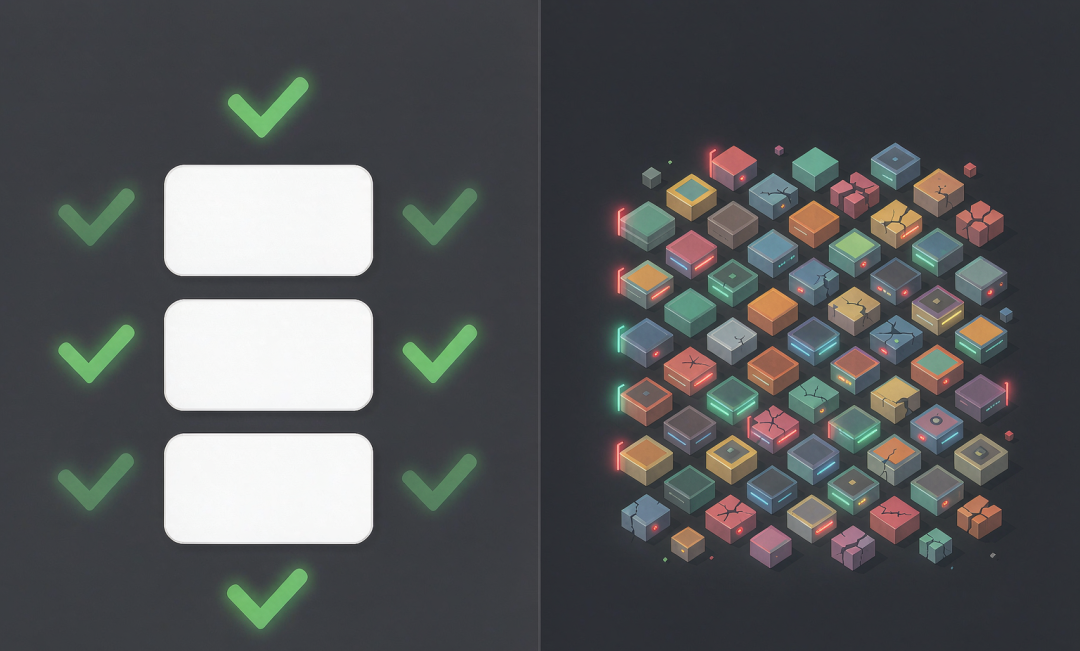
测试数据是测试的一部分。输入的分布决定了测试能测到什么。你的数据太干净,测试就只覆盖正常流程那一条窄路。
一、干净的数据会给你四个假绿灯
先说清楚问题出在哪。手写 fixtures 的毛病不是“不好看”,是它太整齐了。
你自己写数据的时候,脑子里想的是正常流程,所以你会不自觉地写合理的值。这不是懒,这是人的本能。结果就是四个假绿灯:
分页永远只有一页。你造了 8 条数据,pageSize 是 20,分页逻辑一行都没跑到。翻页越界、最后一页不满、总数算错,这些都测不出来。
唯一性假设永远不撞车。邮箱肯定不重复,批次号肯定不重复,因为你想到了要写不一样的。可线上重复的时候,代码到底是报错还是静默覆盖,你不知道。
排序看不出稳定性问题。所有记录的排序键值都不一样,排序算法稳不稳定完全不可见。
数值边界永远不触发。金额全是正数、全是整数,数量永远是 100。没人去试 0、负数、超长字符串、超大数、精度丢失那几个位置。
这四个绿灯的共性是:它们都出现在你没想到的地方。而你想不到,正是手写数据的天花板。
二、让 AI 造数据,别用自然语言要,给 schema
第一反应肯定是打开对话框写一句“帮我造一些用户数据”。
这样做的结果你也猜得到,你会拿到三个名字:张伟、李娜、王芳。模型没有被你限制,它就会偷懒,给你一个最省力的答案。
换个方式,给它一份 schema,字段上带语义和范围提示:
{
  "users": {
    "count": 25,
    "fields": {
      "id": "integer auto_increment",
      "name": "string full_name",
      "email": "string email",
      "created_at": "datetime within_last_year"
    }
  },
  "orders": {
    "count": 80,
    "fields": {
      "id": "integer auto_increment",
      "user_id": "integer reference users.id",
      "amount": "float between 5 and 500",
      "status": "enum pending,paid,refunded"
    }
  }
}
字段后面那段说明是提示,不是严格类型定义,模型自己决定怎么填。这反而更好用,因为你可以写“去年以内的日期”、“5 到 500 之间的浮点”这种业务语义。
提示词里有四句话我建议写死:
一、遵守字段类型。二、值要多样,要贴近真实。三、同一个姓名、邮箱、金额出现不要超过两次。四、只返回 JSON,不要解释。
第三条最容易被漏掉,它是治“三个名字”那个病的。第四条规定了输出形状,省掉你写正则从散文里抠 JSON 的功夫。
温度参数调到 0.8 左右。这一步要的是多样性,不是确定性。想要确定性你就去写 fixtures 了,何必绕这一圈。
三、三个必须你自己兜住的地方
模型愿意帮你造数据,但它不会替你对结果负责。有三件事你一定要自己做。
3.1 schema 越长,模型越退化,得拆表生成
有人拿三种复杂度的 schema 各跑三次,结果很说明问题:
| schema |
表数 |
行数 |
返回合法 JSON |
完全符合 schema |
| 电商 |
2 |
105 |
3/3 |
3/3 |
| 博客 |
5 |
210 |
3/3 |
2/3 |
| SaaS |
10 |
450 |
3/3 |
1/3 |
三次里三次都能返回能解析的 JSON,看着挺稳。但十张表那一组,只有一次字段是全的。
失败的方式就三种:字段遗忘,一张表 12 个字段只给了 8 个;外键乱配,user_id 指向一个根本不存在的用户;唯一值重复,邮箱撞车。
根因在上下文长度。schema 连字段说明一起塞进去,prompt 已经很长了,模型开头的几张表还很准,到后面开始放水。这跟你自己写长文档写到后面开始糊弄是一个道理。
改法是一次不要超过三到五张表,几百行。按依赖关系拆成父表一批、子表一批。先造 users,把生成出来的真实 id 列表收集起来,再把这批 id 作为可选值喂给 orders 那一次生成。这样外键就不会乱配了,模型不用自己编 id。
3.2 校验器只报警,不改错
生成完的东西必须过一遍校验。但我建议校验器只负责输出错误清单,不要试图修复。
修出来的数据你更不敢用,因为你不知道它改了什么、有没有把脏的洗成假的。
def validate(data, schema):
    errors = []
    for table, spec in schema.items():
        if table not in data:
            errors.append(f"缺表: {table}")
            continue
        rows = data[table]
        if len(rows) != spec["count"]:
            errors.append(f"{table}: 期望 {spec['count']} 行,实际 {len(rows)}")
        seen = set()
        for row in rows:
            for field, ftype in spec["fields"].items():
                if field not in row:
                    errors.append(f"{table}.{field}: 字段缺失")
                elif ftype.startswith("integer") and not isinstance(row[field], int):
                    errors.append(f"{table}.{field}: 期望整数")
            # 唯一性要单独查,schema 校验查不出这个
            key = row.get("email") or row.get("batch_code")
            if key and key in seen:
                errors.append(f"{table}: 唯一值重复 {key}")
            seen.add(key)
    return errors
上面这段只能管类型、行数、字段在不在、唯一值。还有三类它一定不查,得你自己按业务补:
外键存在性。user_id 必须真的能在 users 里找到,这是跨表的事。
业务枚举。这是最值钱的一类。危废类别的编码必须落在字典里,模型很喜欢编一个看起来很像的值,你给它 HW08 和 HW49,它可能给你 HW99。这种数据进了系统,前端能显示,统计会漏,合规检查会挂。
数值边界与单位一致性。入库数量必须是正数,单位必须是字典里那几个之一。吨和千克混填这件事,我在线上已经付过一次学费了。
用法就两步。跑一次生成,errors 是空就落盘;不为空就把错误清单拼回 prompt 让它重新生成。最多重试两次,两次还不干净,说明你的 schema 太大了,砍表数。
3.3 生成一次,落盘进版本库,别在测试里实时调模型
这一条是很多人踩过之后才学乖的。
测试跑到一半去调模型,慢、贵,而且不稳定。今天过的测试明天红,你会开始怀疑自己的代码,其实只是模型那一次发挥不一样。
正确做法是固定种子,把生成结果存成 JSON 文件进版本库,测试读文件。生成是一次性的动作,测试是重复性的动作,这两件事不要混在一起。
再往上一层,按用途分三种数据:
CI 用固定种子的规则式生成。字段可信、逐字节可复现、不含任何真实人的信息,跑在自己的机器上也放心。
压测用统计式生成。需要贴近真实的分布和字段相关性时,从真实数据里学分布再采样,但这类数据只在内部环境用,不落地、不外传。
给外部合作方的数据,必须带可证明的隐私界,也就是差分隐私。这一步不能省。
3.4 数据可以脏,断言不能脆
这一条是脏数据落地时第二个坑,很多人换完数据才发现。
你的 fixtures 从固定值换成了随机生成,那些写死了具体值的断言会立刻全红。断言金额等于 100,断言列表第一条的姓名是张伟,这类断言测的其实是数据本身,不是你的逻辑。
换数据的正确姿势是把断言从“值相等”改成“关系成立”:
列表长度不超过 pageSize,而不是等于 20。每条记录的 user_id 都能在 users 里找到,这个是不变量,而不是等于某个具体 id。金额全部大于 0,而不是等于 100。同一个邮箱只出现一次,而不是等于某个固定地址。
一句话,加约束,不加常量。
改完之后你会发现一个附带的好处:这类断言对脏数据天生友好,因为它描述的是规则,不是某一次运行的结果。以后你把 count 从 25 调到 250,测试照样过,而且测的还是同一件事。
四、哪些字段值得故意放脏
不是所有字段都要脏。全都弄脏一遍,你的测试会因为噪音太多而没法定位问题,出了红你也说不清是谁的锅。
按经验分这么几类下手,性价比最高:
| 字段类型 |
怎么放脏 |
想撞出来的问题 |
| 唯一键(邮箱、批次号、单号) |
故意制造一次重复 |
静默覆盖还是报错、并发下的唯一约束 |
| 数值与单位(数量、金额、重量) |
加 0、负数、小数、跨单位混填 |
单位换算、精度丢失、负数校验、统计口径 |
| 枚举与字典(状态、类别、类型) |
塞一个字典外的值 |
前端兜底、枚举校验、联表漏行 |
| 时间(创建、截止、入库时间) |
加跨年、闰日、时区边界、未来时间 |
范围查询、超期判断、时区偏移 |
| 文本(名称、备注、地址) |
加超长、纯空格、特殊字符和引号 |
字段截断、前端溢出、SQL 转义 |
反过来说,主键和关联 id 不要乱改,那是整个数据集里的骨架。骨架一乱,报错全是外键错,真正的业务 bug 反而被埋在噪音里了。
五、关于脱敏,有一条很多团队搞错
把生产库的数据掩个码,拷一份到测试环境,这个做法我见过太多团队在用。
但掩码过的生产数据副本,不算合成数据。
它仍然是从真实的人身上派生出来的。准标识符组合的杀伤力被严重低估了:城市加出生年月加入职日期,三个字段凑一起,在一个人事系统里基本就能定位到具体是谁。你以为把姓名和手机号掩了就安全了,其实没有。
实践上分清楚三件事:
凡是会离开生产环境的数据,用生成的,别用掩码的副本。
必须从真实数据学分布的时候,加差分隐私,并且留下一个能写进报告的隐私预算值,不是拍脑袋说“我们做了脱敏”。
字段做白名单,不是黑名单。默认不给,需要什么开什么,这比列举所有敏感字段要可靠得多。
再补一条容易被忽略的:数据血缘要能追。这份测试数据从哪来、中间经过哪一步、谁导出过。真出问题的时候,这份记录就是你的免责依据。
从法规角度看,个人信息保护法对测试数据的要求其实很硬:不得使用真实可识别信息、最小必要、安全责任要落到主体上。测试数据听上去是内部小事,真出事的时候,它往往就是泄露的入口。
效果上有个参考。有平台把测试用例和测试数据的生成拆成多阶段流水线,回归测试周期从 5 天压到 8 小时,靠这种“脏”数据额外发现的边界问题多了四成。有银行做了差分隐私脱敏之后,同类缺陷的复发率降了五到七成。这两个数字我不敢说每个团队都能复现,但方向是对的:脏数据在前端省下来的时间,比你在后端修 bug 的时间便宜得多。
六、一个最小可抄的实现
整个东西三部分:schema 定义、模型调用、校验。加起来二十多行。
# pip install fastapi openai
import json, os
from fastapi import FastAPI, Request
from openai import OpenAI

app = FastAPI()
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])

@app.post("/generate")
async def generate(req: Request):
    schema = await req.json()
    prompt = (
        "为一个数据库 schema 生成贴近现实的测试数据。"
        "返回 JSON,每个键是表名,值为行对象列表。"
        "遵守字段类型,值要多样。"
        "同一个姓名、邮箱、金额出现不要超过两次。"
        "只返回 JSON,不要任何解释。\n\n"
        + json.dumps(schema, ensure_ascii=False, indent=2)
    )
    r = client.chat.completions.create(
        model=os.environ.get("MODEL", "default"),
        messages=[{"role": "user", "content": prompt}],
        temperature=0.8,
        max_tokens=2000,
    )
    return json.loads(r.choices[0].message.content)
配上前面那个 validate,主流程就是:调一次生成,校验,错误清单拼回 prompt 重试,最多两次。通过了就写文件,文件名带上日期和 schema 版本。
要提醒一句,response_format 这种强制 JSON 的开关,能用就用上,能省掉一批解析失败的重试。但别指望它解决字段缺失的问题,格式对了内容照样可以缺。
七、收尾核对清单
一、不要用自然语言要数据,给 schema,把“不要重复”这句话写进提示词。
二、一次不超过三到五张表,按父表到子表分批,外键用上一批的真实 id。
三、生成完必须过校验:类型、行数、唯一性、外键、业务枚举、数值边界。
四、校验器只报警不改错,错误清单拼回 prompt 重新生成。
五、断言改成关系约束,别写死具体值,否则换一批数据测试就全红。
六、生成结果落文件进版本库,测试读文件,不在测试里实时调模型。
七、掩码的生产数据副本不算合成数据,别让它离开内部环境。
八、给外部的数据用差分隐私,并且把隐私预算记下来。
干净的数据能让你的测试变绿,脏的数据才能告诉你代码哪里脆。这两种数据的用途本来就不一样:单元测试的输入你自己控制,集成和回归测试的输入,应该故意放脏。
AI 在这件事上的价值,不是帮你省掉写 fixtures 的那一个小时,是它能稳定地造出你想不到的字段组合。你想的是正常流程,它给的是各种奇怪的边界。
至于脏到什么程度、脏在哪些字段,这个判断只能你来定。模型不知道你的业务里哪个字段是唯一键,也不知道哪个枚举少一个就会引发合规问题。
这块面板的刻度,得你自己调。如果你也在做类似的事,欢迎到云栈社区分享你的脏数据清单。
 发表于 3 天前
|
查看: 1|
回复: 0


