六篇连载写下来,提示词模板陆续攒了六份。这份合集把散落在各篇文末的嵌入式 AI提示词模板 全部收拢到一处,用的时候不用再往回翻。从环境配置到代码审查,一条链拿走。
这六份模板全部面向嵌入式开发。芯片型号、时钟树、引脚复用、寄存器配置——这些恰恰是 AI 最容易凭训练数据乱编的地方,模板的作用就是逼它少猜多查。
先看全景图,再逐份拆解。每份都标注了来源篇章,想深入可以回对应那篇细读。
01 六份模板,一张图看清
从环境到审查,六份提示词模板排成一条链。
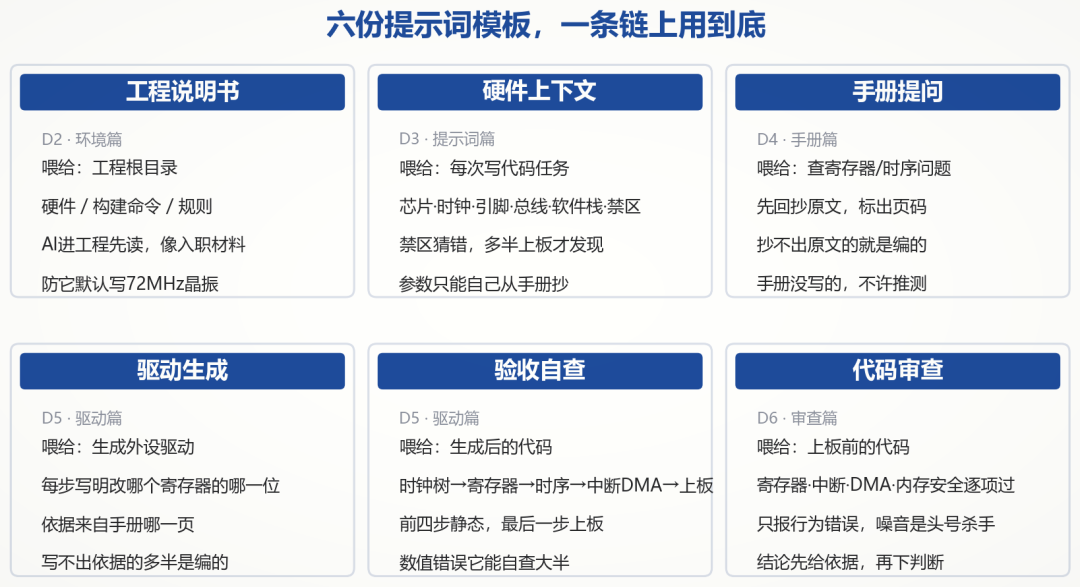
▲ 六份模板对应六个场景,从环境到审查(自绘)
第一份喂工程环境,第二份喂任务上下文,第三份喂芯片手册。后三份依次是:驱动生成、结果验收、代码审查。
按这个顺序走下来,恰好覆盖一个外设从配置到验证的完整周期。
02 第一份:工程说明书
环境篇的模板最基础,也是需要长期驻留在工程里的一份。Cursor、Claude Code、Codex 各自认不同的规则文件,叫法虽然不一样,作用完全一致:AI 每次进入工程先读它,相当于新员工入职材料。
内容压缩到最短只有四块:硬件是什么、构建命令是什么、哪些文件别碰、什么才算合格。
# 硬件
- 芯片:STM32F103C8T6(Cortex-M3)
- 晶振:8MHz HSE,SYSCLK 72MHz
- 烧录:ST-Link / SWD

# 构建
- 命令:headless-build.bat -import . -cleanBuild Demo/Debug
- 产物:Debug/Demo.elf

# 规则
- 用户代码在 Core/Src、Core/Inc,HAL 库目录别动
- 禁止修改链接脚本 *.ld
- 编译通过 ≠ 能上板:涉及时钟、时序先说明再改
我之所以记住先把说明书喂进去,是因为某天让 AI 动时钟配置时被结结实实坑过一回。没喂之前,它照着训练数据里最常见的开发板来写,8MHz 晶振、72MHz 主频。而我的板子不是这个组合,编译一个错没有,烧进去之后外设死活不转。
03 第二份:硬件上下文
第二份模板要填的是硬件上下文,一共六样:芯片型号、时钟配置、引脚分配、总线参数、软件栈、禁区。前五样填错,编译器当场就会报错,改起来很快;唯独禁区这一项填错,往往要拖到上板运行时才会露馅。
禁区这条最棘手。AI 看不见你的原理图,团队针对这块板子定下的规矩、踩过的坑,它更是两眼一抹黑。
# 项目
- 芯片:STM32F103C8T6,Cortex-M3,无硬件FPU
- 时钟:外部晶振8MHz,PLL×9,SYSCLK 72MHz

# 本次任务(只做这一步)
- 只写SPI1初始化,不写屏幕逻辑

# 接线
- SPI1:PA5 SCK,PA6 MISO,PA7 MOSI
- 片选:PA4,软件控制

# 从机
- ST7789,SPI最大时钟15MHz,模式0,MSB先行

# 约束(逐条遵守)
- 时钟树按现有配置,不要改
- 片选必须软件拉低,禁止用硬件NSS
- 中断里不加延时函数
- 只改 Core/Src/spi.c 与 Core/Inc/spi.h

# 输出要求
- 给出完整函数,标注关键寄存器位的作用
- 说明怎么验证:读回哪个寄存器、预期值是多少
模板本身不长,麻烦全在把括号里的参数填对。那几个参数只能由你亲自从芯片手册和原理图上抄,抄错一个,它就顺着错误一路往下写。
04 第三份:手册提问
手册提问的模板规则只有一条:让它回抄原文,不许概括。
抄得出页码的才算真查过,抄不出的多半是编的。单这一条就能挡掉大半寄存器层面的幻觉。
# 手册片段
[粘贴 SPI 章节的寄存器表,含表头、脚注与页码]

# 芯片
STM32F103C8T6,外部晶振8MHz,SYSCLK 72MHz

# 本次只回答一个问题
SPI1 的波特率怎么设

# 输出要求
- 先回抄手册里相关的原文句子,标出页码
- 再给配置步骤,每一步写明改的是哪个寄存器的哪一位
- 手册里没写清楚的,直接说没写,不要推测
- 这次不要给完整初始化代码
这份模板管的是「怎么问」。手册的切分则是另一道工序:按外设切分、整表保留、带前置信息、留页码,D4 那篇有完整做法。
05 第四、五份:生成与验收
驱动生成模板的关键句在生成要求里:每一步初始化都要写明改了哪个寄存器的哪一位,依据来自芯片手册的哪一页。
它给不出依据的,大概率就是编的。
# 目标
[芯片型号,如STM32F103C8T6,外部晶振8MHz,SYSCLK 72MHz]
[外设与需求,如USART1,115200波特率,8N1]

# 生成要求
- 用HAL库或寄存器方式均可,先说明你选哪种
- 每一步初始化,写明改了哪个寄存器的哪一位,依据来自手册哪一页
- 时钟使能、GPIO复用、中断配置分开列出
- 手册里没写的,直接说没写,不要推测

# 输出后自查
- 逐行核对寄存器赋值与手册
- 重算波特率与分频值
- 检查中断与DMA方向
生成之后别急着上板。先过一遍验收流程,五步走完再烧录:时钟树、寄存器逐行核对、时序、中断与 DMA、上板验证。
前四步不接电也能做,白天顺手就能核完。最后一步必须板子在手,烧录之后实际验证。
这五步同样可以拼成一份验收提示词,直接丢给 AI:
# 目标
[待验收代码]

# 自查顺序(逐项)
- 时钟树:主频、外设挂哪条总线、使能位在RCC哪个寄存器
- 寄存器:地址、位域、复位值、读写属性,逐行对手册
- 时序:波特率、分频值、采样时序,重算一遍
- 中断与DMA:优先级、使能位、回调、方向与宽度
- 上板:串口回环、GPIO翻转看波形、定时器实测频率
丢进去让它自己先过一遍,多数数值错误它自己能挑出来。剩下的,才轮到你人工复核。
06 第六份:代码审查
代码审查模板最要紧的规矩只有一条:不许乱报。
只报会导致行为出错的缺陷,风格、命名、格式问题一律跳过。报告里噪音一多,它说什么你都得先掂量一下。
怀疑度不到一半的也列出来,标「疑似」。漏掉一条真错误,代价比多看十条噪音高得多。
# 目标
[芯片型号、主频、外设清单,附参考手册页数]
[待审查代码]

# 审查要求
- 只报会导致行为错误的缺陷,风格、命名、格式问题一律跳过
- 按顺序逐项过:寄存器、中断、DMA、内存安全
- 每条结论先给依据(寄存器地址、位域、手册页码),再下判断
- 确定错和疑似错分开列,疑似错标注怀疑点
- 怀疑度不足一半的也列出,标「疑似」
- 手册里查不到的,直接说查不到,不要推测

# 输出格式
- 每条:位置|问题|依据|风险等级(高/中/低)
- 查不出问题的部分,明确说「未发现问题」
给不出依据的高风险项,我一般不让它动。等翻完手册确认之后,再决定动不动手。硬逼它改也没用,编出来的依据照样是错的。
07 一份工程里怎么串起来
六份模板是一条流水线,不是六个彼此独立的工具。新工程开工,先喂工程说明书,让 AI 读工程、跑通编译;写驱动时,把硬件上下文和生成模板合并起来发送;代码出来之后,验收模板过一遍;上板之前,审查模板再兜最后一圈。顺序不能反过来——环境都跑不通就别谈生成,编译都过不了的代码,送去审查也是白搭。
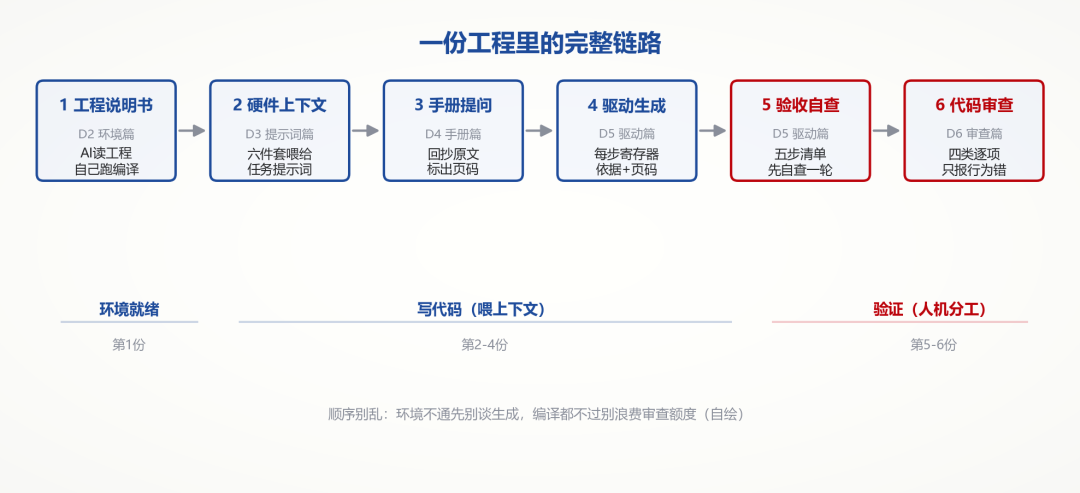
▲ 六份模板在工程里怎么串(自绘)
08 三个提醒
模板可以随便抄,参数栏必须自己填。芯片型号、晶振频率、寄存器地址,每一样都得翻你自己的手册,逐一对照填写。
版本给错同样麻烦。拿 F1 系列的写法套 F4,函数名看着全对,参数含义已经是两码事。
模板也管不了所有事。它能把提问方式固定下来,但查手册、核页码、上板验证这些活,还得你自己上手。
这六份模板整理自本连载前六篇:环境搭建(D2)、提示词基础(D3)、手册问答(D4)、驱动生成与验收(D5)、代码审查(D6)。前几篇引用的基准数据,如 EmbedAgent(arXiv:2506.11003)、CR-Bench(arXiv:2603.11078)、BitsAI-CR(arXiv:2501.15134)等,均来自公开论文,并非本号实测。模板按我个人操作习惯整理,仅供参考。封面配图由 AI 技术生成。
六份模板都在这里了,存下来,下次写代码时直接翻出来用。
下篇换个话题,聊聊补全型和 Agent 型工具。它们在嵌入式开发里到底怎么分工,AI Agent 能不能自己调编译器,到时候细说。
 发表于 3 天前
|
查看: 0|
回复: 0


