上篇用生成驱动加清单验收的路子走通了。这次让 AI 掉过头来当审查员,把寄存器、中断、DMA、内存安全这四类问题一次扫一遍。
AI 代码审查有它的甜区:逐行对规则、查逻辑漏洞,它一遍顶你半天。出了甜区,那些编译不报、得翻手册才能答上来的错,它往往看不见,得你自己兜着。
审查提示词模板放在文末,要抄直接拿。它的结论哪些能信、哪些得复核,正文里会分开说明。
01 三组公开数据,看 AI 当审查员的水准
EmbedAgent 基准(arXiv:2506.11003)这组实验覆盖 126 个嵌入式用例、10 个主流模型、9 种元器件、3 个硬件平台。其中跨平台迁移到 ESP-IDF 最难,最优模型通过率也只有 29.4%。
同一篇里有个转折:给模型接上编译反馈和手册检索后,DeepSeek-R1 的通过率从 55.6% 涨到 65.1%,Arduino 到 ESP32 的迁移任务也从 21.4% 涨到 27.8%。
编译反馈是 AI 改进代码最可靠的信号。这一点和审查直接相关——AI 审代码,头一道信号就该是编译。
再看审查侧。Nutanix 的 CR-Bench(arXiv:2603.11078)专测审查 agent,结论是个老毛病:让它把所有隐藏问题都挖出来,信噪比就很低,报告里塞满不疼不痒的内容。
保精确还是保召回,审查 agent 只能二选一。要么宁可漏报不敢误报,要么宁可误报一千也不漏一个。
字节跳动的 BitsAI-CR(arXiv:2501.15134)跑在生产环境:219 条审查规则,评论生成精确率 75%,周活一万两千人。换算一下,每报四条评论,约有一条是噪音。它也算过人审的账——一半以上的审查单子平均要花 15 分钟,AI 几秒钟过一遍,省的正是这部分时间。
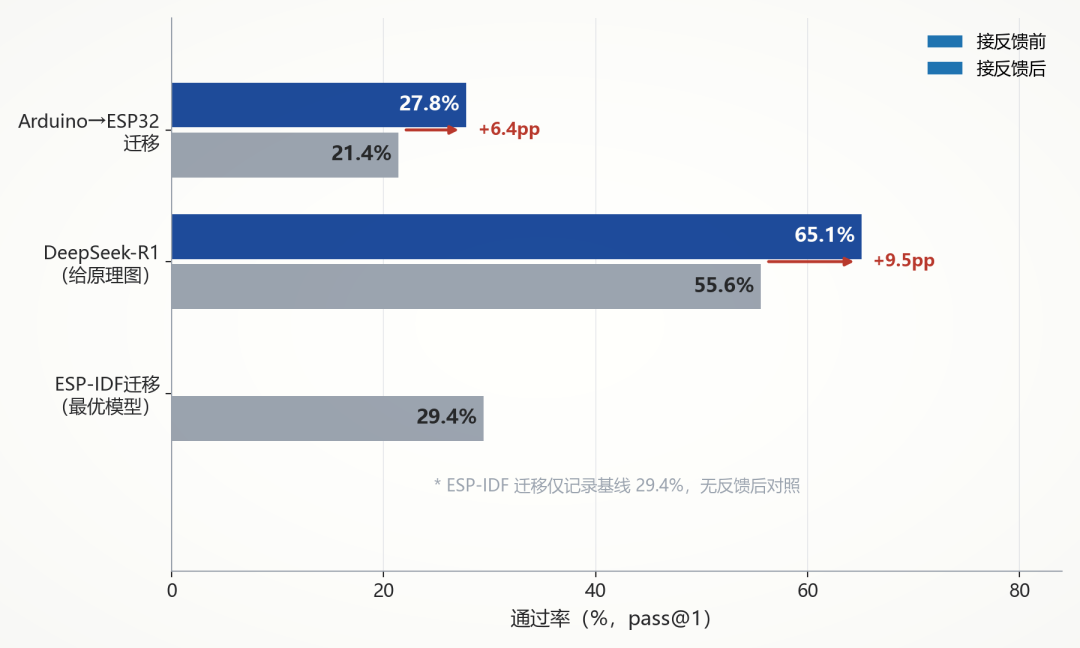
▲ 编译反馈前后,模型通过率的变化(据 arXiv:2506.11003 数据自绘)
三组数据放到一起,结论是:AI 审查能干活,前提是给它对的信号,外加一条不许乱报的规矩。
02 编译不报的错,它看不见
编译反馈能帮 AI 改掉的,都是编译器看得见的错。硬件上有一大类错,编译从头到尾不吭声。
NVIDIA 研究组把 AI 写硬件代码的错误分成四层(arXiv:2606.19347):语法、语义、可解的功能错误、不可解的功能错误。他们的发现有点反直觉——对齐优化把语法错误清得干干净净,深层功能错误反而加重了。论文原话是,对齐只是在教模型会编译。
LLMVul 数据集(arXiv:2609.10945)从真实仓库挖了 21,430 个 AI 生成的 C/C++ 函数,标出 1,540 个带漏洞的,跨 17 类 CWE。更扎心的是另一组数字:2026 年一篇形式化验证研究里,3,500 个 AI 生成产物,6 个工业静态分析工具合起来只检出 7.6% 的形式化证明漏洞,漏掉 97.8%。
嵌入式 ML 方向的实验(arXiv:2509.10946)描述得更直白:输出静默失败,或者行为不可预测,代码能编译,运行期把下游搞崩。
这一类,AI 看不见。
所以审查必须分层。编译器、静态工具、AI 各管一段,剩下的静默缺陷,只能靠人和清单兜住。
03 嵌入式审查,重点查四类
给 AI 划定查什么,比让它自由发挥靠谱得多。我常让它过四类。
寄存器:地址、位域、复位值、读写属性,对着手册逐行核。这类错它查得动,前提是把手册喂给它。
中断:优先级配没配错、使能位开没开、回调函数对不对、共享变量有没有保护。错一个就是死循环或丢数据。
DMA:传输方向、数据宽度、地址对齐、缓冲生命周期。DMA 和 CPU 共用一块内存,谁先谁后没同步,数据就是旧的。
内存安全:越界、悬垂指针、栈溢出、缺 volatile。共享资源被中断打断,如果缺了 volatile,编译器优化能把读写吞掉。
MISRA C 这类机械规则 AI 最擅长,逐条过比人快。但寄存器值对不对,它得看手册才知道,这类判断别全信它。
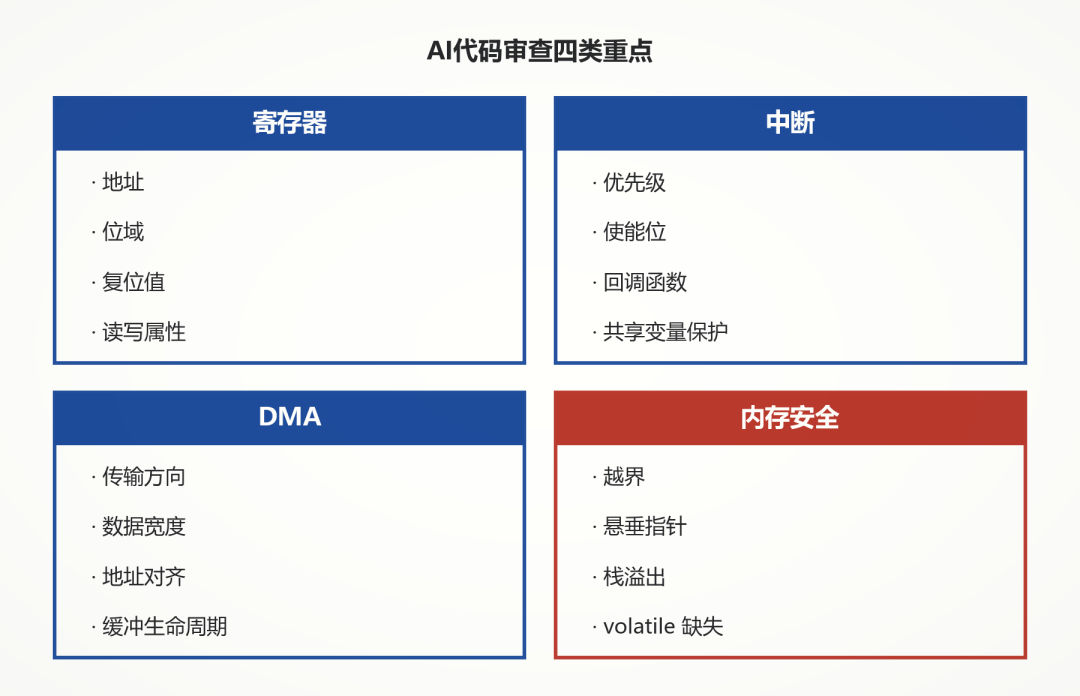
▲ 四类重点审查清单(自绘)
04 提示词怎么写,审查才靠谱
AI 代码审查的几条规则,都是从 CR-Bench 和 BitsAI-CR 的结论里反推出来的。
正确性优先。明确告诉它,只报会导致行为错误的缺陷,风格、命名、格式问题全部跳过。噪音是审查 agent 的头号杀手。
一半怀疑就报。怀疑度不到一半的,也列出来,但标成「疑似」。宁可多看一条,别漏一条。
先给依据再下结论。让它先列出涉及的寄存器、地址、时序事实,再判断对错。依据写不出来的判断,多半是编的。
按清单过,别泛查。「帮我检查代码」这种指令,它只会回你泛泛而谈。把四类清单贴进去,让它一项一项来。
先编译,再送审。编译报错先让它自己改完一轮,再把干净的代码送去审查。D5 那篇说过,编译通过不代表对,但编译都不过的,先别浪费审查额度。
05 一份能直接抄的审查提示词
前面几节合起来就是这样。方括号里换成你自己的,代码贴在后头。
目标
[芯片型号、主频、外设清单,附参考手册页数]
[待审查代码]
审查要求
- 只报会导致行为错误的缺陷,风格、命名、格式问题一律跳过
- 按顺序逐项过:寄存器、中断、DMA、内存安全
- 每条结论先给依据(寄存器地址、位域、手册页码),再下判断
- 确定错和疑似错分开列,疑似错标注怀疑点
- 怀疑度不足一半的也列出,标「疑似」
- 手册里查不到的,直接说查不到,不要推测
输出格式
- 每条:位置|问题|依据|风险等级(高/中/低)
- 查不出问题的部分,明确说「未发现问题」
跑完让它按风险等级从高到低过一遍,先改高的。
它给不出依据的高风险项,先别让它改,自己翻手册确认,再决定动不动。
06 哪些必须人来兜底
时序计算。波特率、定时器分频、采样周期,AI 算错一位就是差一倍。这类拿笔重算一遍,别省。
硬件约束。引脚冲突、外设复用、电气特性,AI 没有板子,不知道哪根线跟哪根线打架。
手册版本。它训练数据里 F1 和 F4 混着,函数名对得上,参数含义却不一样。拿你手头版本的 PDF 喂它,别让它凭记忆。
嵌入式代码安全的大头在硬件行为正确性上。静态规则、内存安全这类 AI 查得勤,行为正确性得靠人盯。收尾还是那句:上板验证不可省,D5 那套五步验收清单接着用。
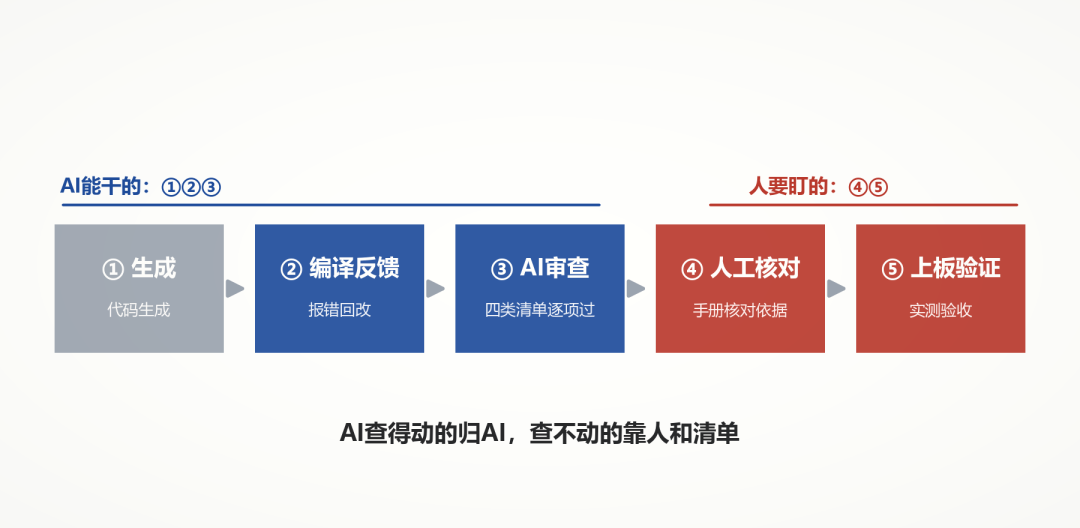
▲ 从生成到上板的审查流程(自绘)
生成、验收、审查,三轮都过完了。下篇把前六篇的提示词模板收成一份能保存的合集,方便回查。
本篇外部数据都有出处:EmbedAgent 的 126 个用例、29.4%、55.6% 到 65.1%、21.4% 到 27.8% 来自 arXiv:2506.11003;CR-Bench 的信噪比结论来自 arXiv:2603.11078;BitsAI-CR 的 75% 精确率与 219 条规则来自 arXiv:2501.15134;四层错误分类来自 arXiv:2606.19347;LLMVul 的 21,430 个函数与 7.6% 检出率来自 arXiv:2609.10945;嵌入式 ML 静默失败来自 arXiv:2509.10946。四类审查清单、提示词模板和兜底规则是我自己的操作习惯,仅供参考。封面与配图由 AI 技术生成。
连载更到第六篇了。生成、验收、审查,三轮提示词都在这里,收藏一份,写代码时用得上。如果你平时也常逛云栈社区,可以顺手存下这份合集,回头写驱动或外设代码时翻出来对着用。下篇见。
 发表于 3 天前
|
查看: 0|
回复: 0


